高风险 PR 强制深审:用 Jev 给代码变更做风险初判
原创
高风险 PR 强制深审:用 Jev 给代码变更做风险初判
原创
gavin1024
发布于 2026-09-24 13:28:28
发布于 2026-09-24 13:28:28
代码评审如果所有 PR 一视同仁,评审精力很容易被大量低风险变更稀释,真正危险的改动反而没被重点看。这一周我用 Jev 给 PR 变更做风险初判,把高风险的挑出来强制深审。这篇讲清楚落地:痛点、适配、实战流程、效果对比。文中官方口径数据可核实,整体效果为方案性测算,非某项目真实业绩,Jev 仍处早期访问阶段。
Jev 是 TypeSafe AI 推出的高速低成本 AI 判断器,区别于 ChatGPT、Claude 这类生成式大模型,它不做自由问答、文案创作和代码编写,核心定位是软件或 AI 系统中的专用判断组件:输入当前状态加上固定候选选项或评判标准,输出确定性选择(Choice)、量化打分(Score)或真伪概率(Noul)。核心优势是决策 70~500ms、输入 0.042 美元每百万 token 且输出免费、专注封闭式判断规避幻觉、承接大模型琐碎判断从而降本增效。
一、行业痛点拆解
所有 PR 走同样的评审流程时,低风险变更(文档、小改动)和高风险变更(核心逻辑、支付链路)混在一起,评审者要自己在大量 diff 里识别哪些危险。精力被摊薄,高风险改动可能没得到足够深入的审查,这是团队里常见的风险敞口。
二、Jev 适配逻辑
"这个变更属于哪个风险档"是从固定风险等级里选一个,标准的 Choice 判断:核心逻辑变更、普通功能变更、文档修改。判定标准由团队预先定义,Jev 毫秒级、低成本地对每个 PR 或每段 diff 做初判。它承接的正是这种高频、封闭的分级判断,把评审精力导向真正高风险的代码。
下面这张图对照了两种方案:
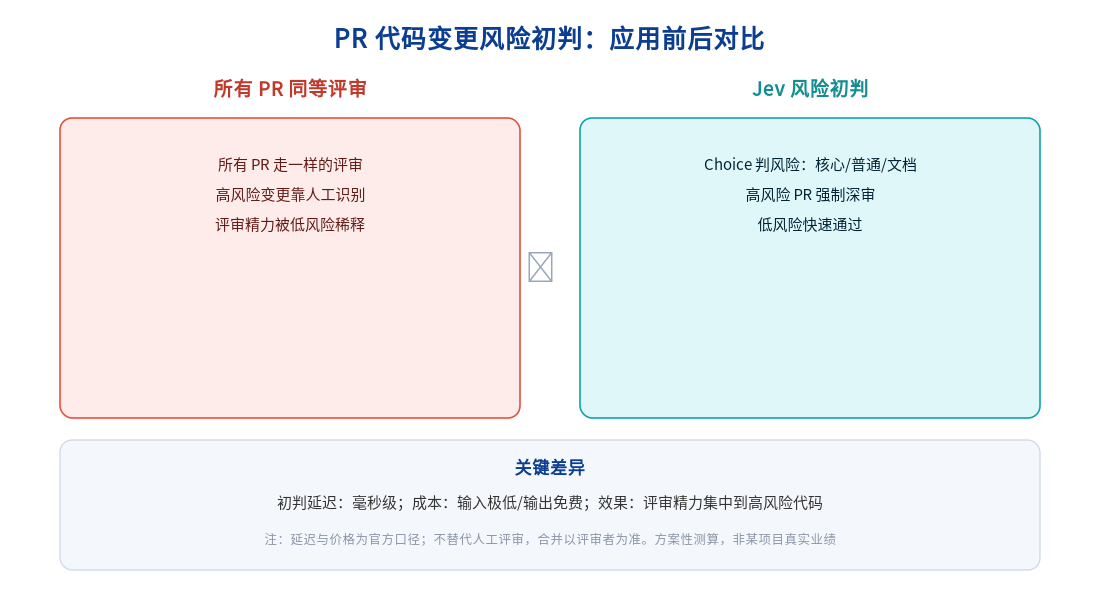
PR 代码变更风险初判:应用前后对比
三、实战落地流程
五步:输入状态(代码 diff 变更片段加所属模块信息组成 state)→ 固定候选(高风险/普通/文档三档作为 Choice 候选,并配判定标准,如涉及支付、鉴权、核心逻辑判高风险)→ Jev 决策(Choice 定风险档、Score 可选给风险强度打分)→ 输出结果(返回档位加置信度)→ 落地执行(高风险 PR 强制人工深度评审,普通走常规评审,文档走快速通道)。
四、效果数据佐证
延迟:Jev 官方口径 70~500ms,初判即时完成,不阻塞提交流程。成本:Jev 输入 0.042 美元每百万 token、输出免费,可对每个 PR 都跑初判。效果:评审精力从"平均分配"变成"按风险分配",高风险变更不易漏过。准确率上实测与大模型大致持平。整体评审效率提升属方案性测算,需自测。
五、避坑与生产落地建议
边界:Jev 不做计数、精确计算、日期换算、开放式创作和无边界推理。它做的是风险分级初判,不理解完整业务逻辑,绝不替代人工评审,尤其涉及安全和资金的代码,最终必须人工把关,代码是否合并永远由评审者决定。被判低风险的 PR 也不能免除基本评审。生产接入:优先影子运行,先只给风险标签、不改变流程,比对准确性;基于自身代码库校准判定标准和阈值(阈值不等于真实准确率);低置信度默认按高风险处理,保守兜底。风险初判交 Jev、评审决定权留人、复杂分析交大模型,代码评审才能抓大放小又不失守。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号