OCR 界的“超级小钢炮”!LightOnOCR-2-1B 发布:1B 参数,千页成本不到 7 分钱!

OCR 界的“超级小钢炮”!LightOnOCR-2-1B 发布:1B 参数,千页成本不到 7 分钱!
开源星探
发布于 2026-03-16 19:50:39
发布于 2026-03-16 19:50:39
OCR(光学字符识别)领域这两天迎来了一个极其硬核的“小钢炮”。
长期以来,为了追求极致的 OCR 效果(特别是处理复杂的数学公式、多栏排版和表格),我们往往不得不使用庞大的多模态模型。效果是好了,但推理成本和速度也上去了。
但 LightOnAI 最新发布的一款端到端 OCR 模型 LightOnOCR-2-1B 彻底打破了这个僵局。
它是 LightOnOCR 系列的旗舰级 OCR 模型,对外宣称其为这个系列的最佳 OCR 模型。
虽只有 1B 参数,却在各项基准测试中,把规模比它大 9 倍的模型按在地上摩擦。每千页的处理成本不到 0.01 美元(约7分钱),速度快到飞起。
它的核心逻辑非常简单粗暴:输入 PDF 或图片,直接输出完美的 Markdown 格式文本。
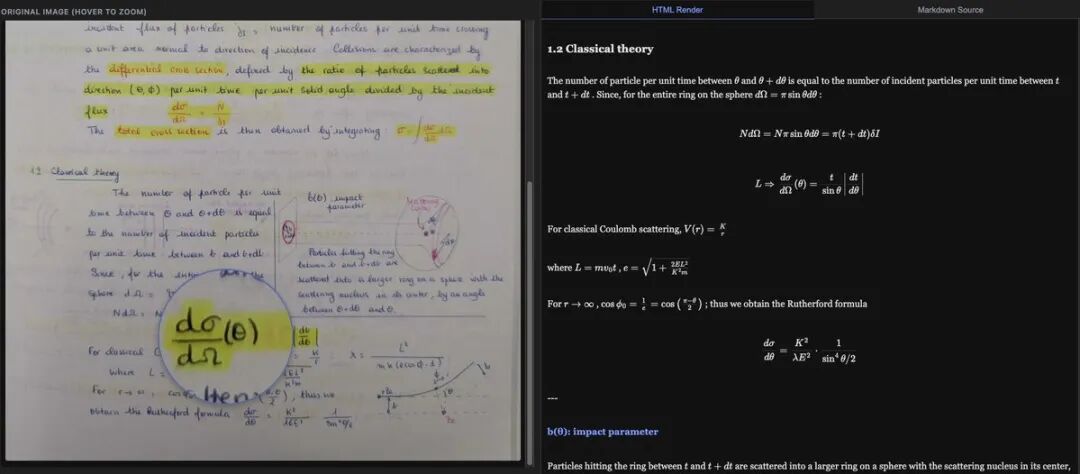
最离谱的是它的效能比。LightOn 用 1B 的参数量,实现了 SOTA(当前最佳)的效果,在速度和精度上双双碾压了众多高参数量的竞争对手。
核心亮点
1、越级挑战 1B > 9B
在权威的 OlmOCR-Bench 测试中,LightOnOCR-2-1B 拿下了 83.2 ± 0.9 的高分。
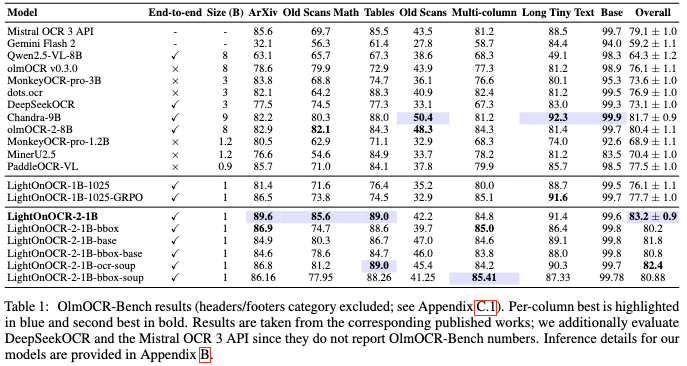
这意味着它在处理复杂文档时,表现优于许多参数量是它 9 倍的模型。
特别是在以下场景中表现尤为突出:
- • ArXiv 学术论文:复杂的双栏排版。
- • 数学公式:包含大量公式的旧扫描文档。
- • 表格识别:结构复杂的统计表格。
2、极致速度与低成本
这是工程化落地最看重的指标。在单张 H100 80GB 显卡上(配合 vLLM 推理框架):
- • 吞吐量:达到 5.71 页/秒。
- • 成本:处理 1000 页文档,电费+算力成本不到 0.01 美元。
速度对比:
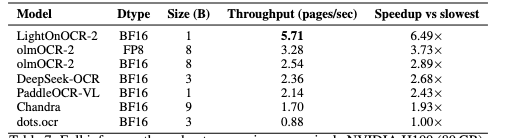
如果你需要大规模处理企业归档文件或图书数字化,这个速度和成本优势是碾压级的。
3、黑科技加持:RLVR 技术
为什么这么小的模型能这么强?秘密在于 RLVR(基于验证反馈的强化学习)。
LightOnOCR团队在训练中引入了特殊的奖励机制:
- • KaTeX 奖励:专门针对数学公式渲染进行优化,让输出的 LaTeX 代码更规范、可渲染。
- • 压缩奖励机制:惩罚模型的“复读机”行为。让模型的重复率降低了 50% 以上,解决了小模型容易陷入死循环的通病。
主要功能
- • Markdown 结构化输出:它不是吐出一堆乱糟糟的文字,而是带有标题、列表、代码块的整洁 Markdown。
- • 复杂元素处理:
- •
表格:能够还原表格结构。 - •
数学公式:完美识别 LaTeX/KaTeX。 - •
多栏布局:自动处理报纸、论文的分栏阅读顺序。
- •
- • 多功能变体:它还有一个 bbox 变体版本,不仅能识别文字,还能预测图片的边界框。这意味着它能告诉你文档里的插图具体在什么位置,方便你做图文对应的切片。
快速入手
官方在抱抱脸平台也部署了可体验的 LightOnOCR-2-1B Space。
Demo:
https://huggingface.co/spaces/lightonai/LightOnOCR-2-1B-Demo
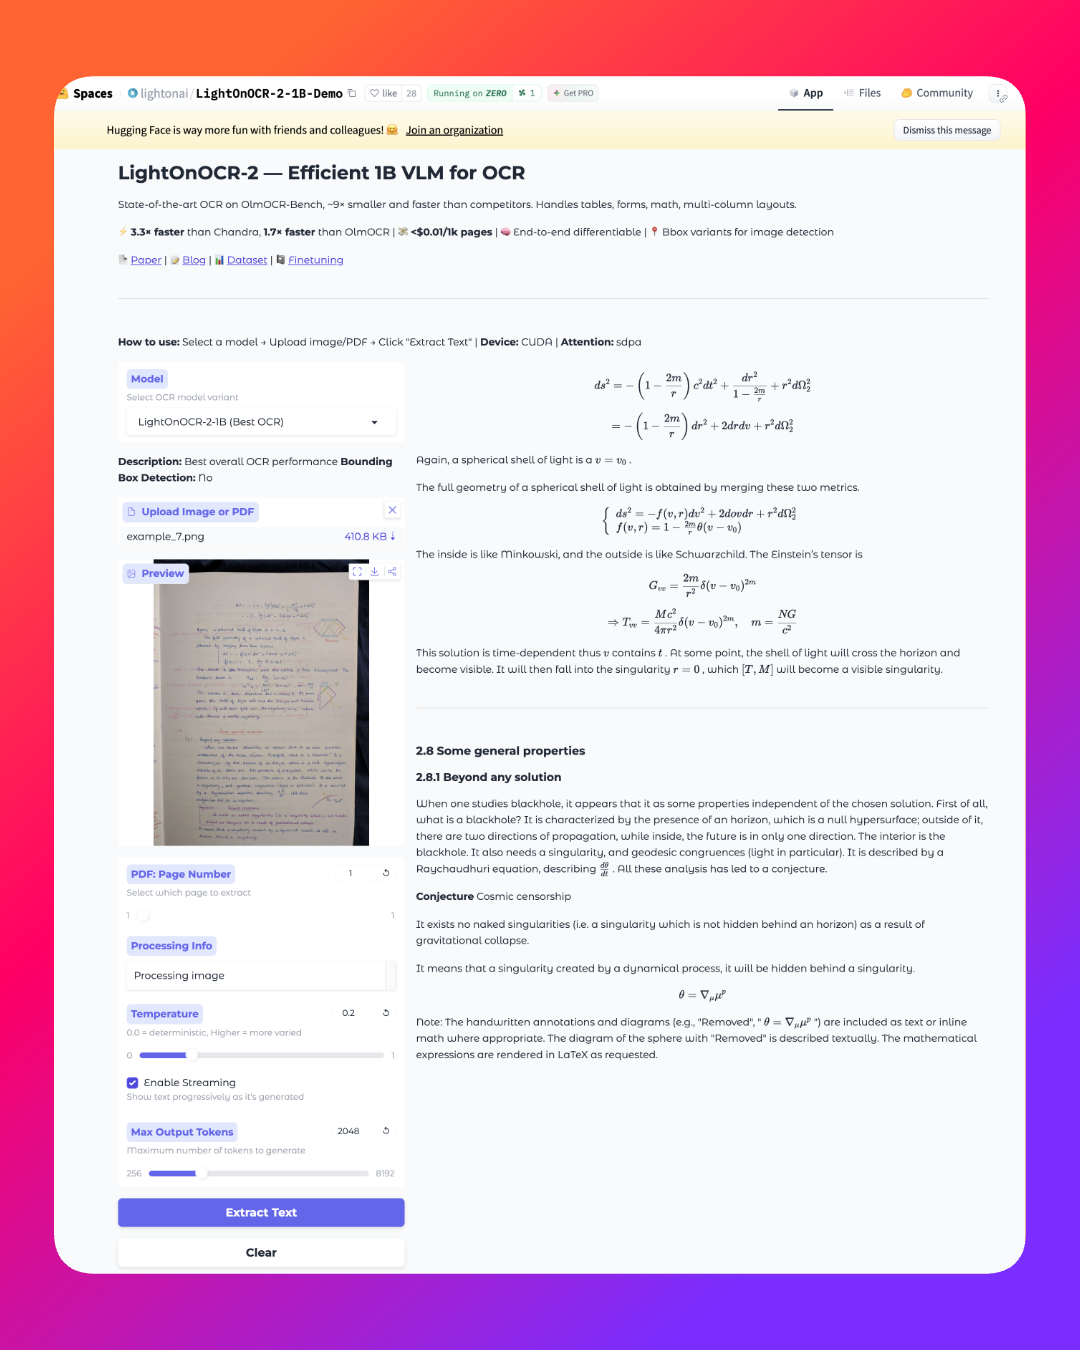
只需上传 PDF 文档或图片即可快速解析。
如果想在 Python 代码中调用,先要安装:
uv pip install git+https://github.com/huggingface/transformers
uv pip install pillow pypdfium2
代码示例:
import torch
from transformers import LightOnOcrForConditionalGeneration, LightOnOcrProcessor

device = "mps" if torch.backends.mps.is_available() else "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.float32 if device == "mps" else torch.bfloat16

model = LightOnOcrForConditionalGeneration.from_pretrained("lightonai/LightOnOCR-2-1B", torch_dtype=dtype).to(device)
processor = LightOnOcrProcessor.from_pretrained("lightonai/LightOnOCR-2-1B")

url = "https://huggingface.co/datasets/hf-internal-testing/fixtures_ocr/resolve/main/SROIE-receipt.jpeg"

conversation = [{"role": "user", "content": [{"type": "image", "url": url}]}]

inputs = processor.apply_chat_template(
    conversation,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
)
inputs = {k: v.to(device=device, dtype=dtype) if v.is_floating_point() else v.to(device) for k, v in inputs.items()}

output_ids = model.generate(**inputs, max_new_tokens=1024)
generated_ids = output_ids[0, inputs["input_ids"].shape[1]:]
output_text = processor.decode(generated_ids, skip_special_tokens=True)
print(output_text)
与 vLLM 一起使用:
vllm serve lightonai/LightOnOCR-2-1B \
    --limit-mm-per-prompt '{"image": 1}' --mm-processor-cache-gb 0 --no-enable-prefix-caching
代码示例:
import base64
import requests
import pypdfium2 as pdfium
import io

ENDPOINT = "http://localhost:8000/v1/chat/completions"
MODEL = "lightonai/LightOnOCR-2-1B"

# Download PDF from arXiv
pdf_url = "https://arxiv.org/pdf/2412.13663"
pdf_data = requests.get(pdf_url).content

# Open PDF and convert first page to image
pdf = pdfium.PdfDocument(pdf_data)
page = pdf[0]
# Render at 200 DPI (scale factor = 200/72 ≈ 2.77)
pil_image = page.render(scale=2.77).to_pil()

# Convert to base64
buffer = io.BytesIO()
pil_image.save(buffer, format="PNG")
image_base64 = base64.b64encode(buffer.getvalue()).decode('utf-8')

# Make request
payload = {
    "model": MODEL,
    "messages": [{
        "role": "user",
        "content": [{
            "type": "image_url",
            "image_url": {"url": f"data:image/png;base64,{image_base64}"}
        }]
    }],
    "max_tokens": 4096,
    "temperature": 0.2,
    "top_p": 0.9,
}

response = requests.post(ENDPOINT, json=payload)
text = response.json()['choices'][0]['message']['content']
print(text)
使用技巧: 将 PDF 文件渲染为PNG或JPEG格式,目标最长边为1540 像素。 保持宽高比以保持文本几何形状 每页使用一张图;vLLM 支持批量处理
应用场景
- • 学术论文/arXiv 文献数字化
- • 老档案、扫描书籍 OCR
- • 企业文档中台/RAG 数据清洗
- • 数学、工程、科研知识库构建
- • 财务票据、复杂报表结构化
写在最后
LightOnOCR-2-1B 是开源 OCR 领域的一个重要里程碑。
它证明了在特定领域任务上,通过高质量的数据清洗和先进的强化学习技术,小模型完全可以战胜大模型。
如果你在做文档理解、知识库、RAG、AI 助教、科研工具,那必须关注这个 OCR 模型。
模型(Hugging Face):
https://huggingface.co/lightonai/LightOnOCR-2-1B

如果本文对您有帮助,也请帮忙点个 赞👍 + 在看 哈!❤️
在看你就赞赞我!
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-01-22,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号