AI第一次自己给AI动手术:MIT让大模型改写权重,0.016% 改动为什么值得云厂商看一眼
原创
AI第一次自己给AI动手术:MIT让大模型改写权重,0.016% 改动为什么值得云厂商看一眼
原创
轻松悠悠
发布于 2026-11-04 11:25:08
发布于 2026-11-04 11:25:08
AI 第一次给 AI 动手术
只改 0.016% 的参数,数学成绩从 7.9% 涨到 48.1%
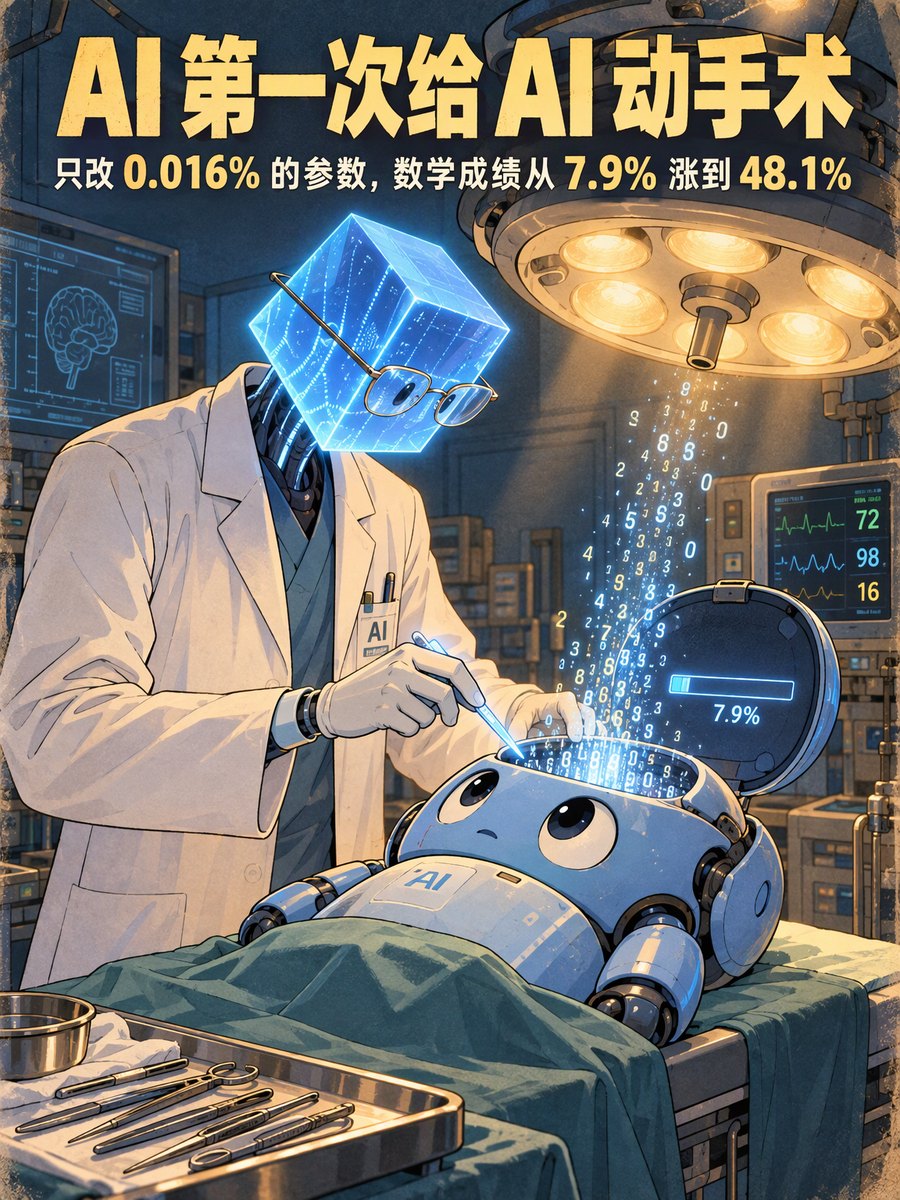
科普漫画 封面
封面
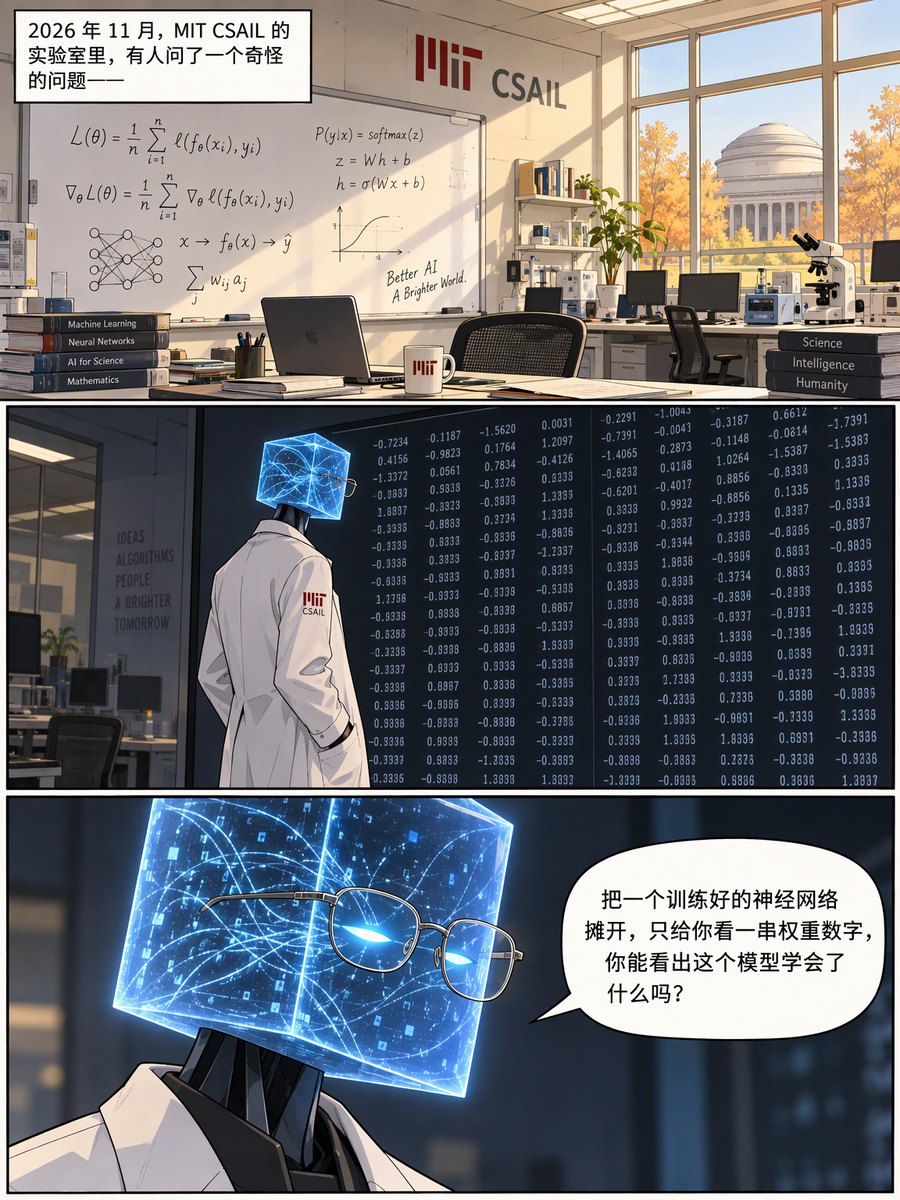
科普漫画 第1页
第1页
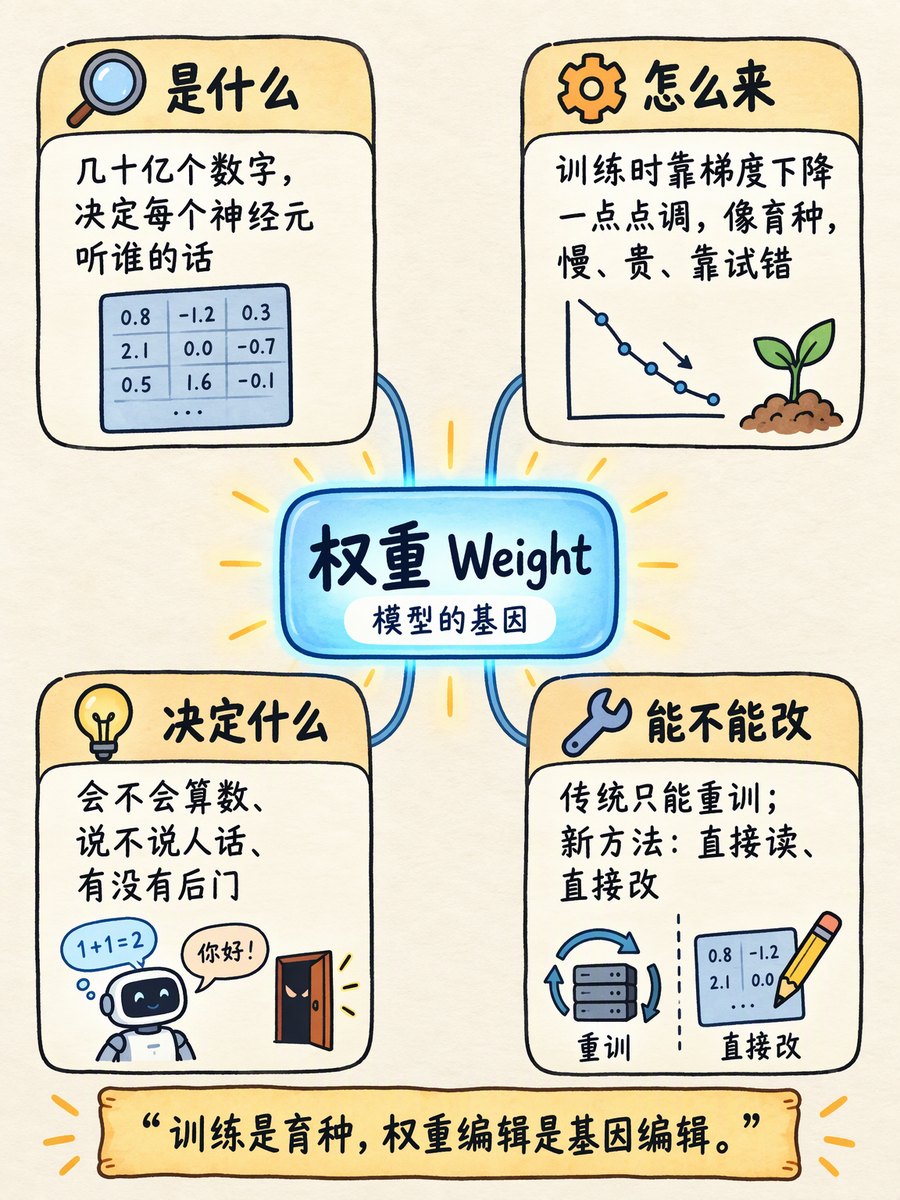
科普漫画 思维导图①
思维导图①
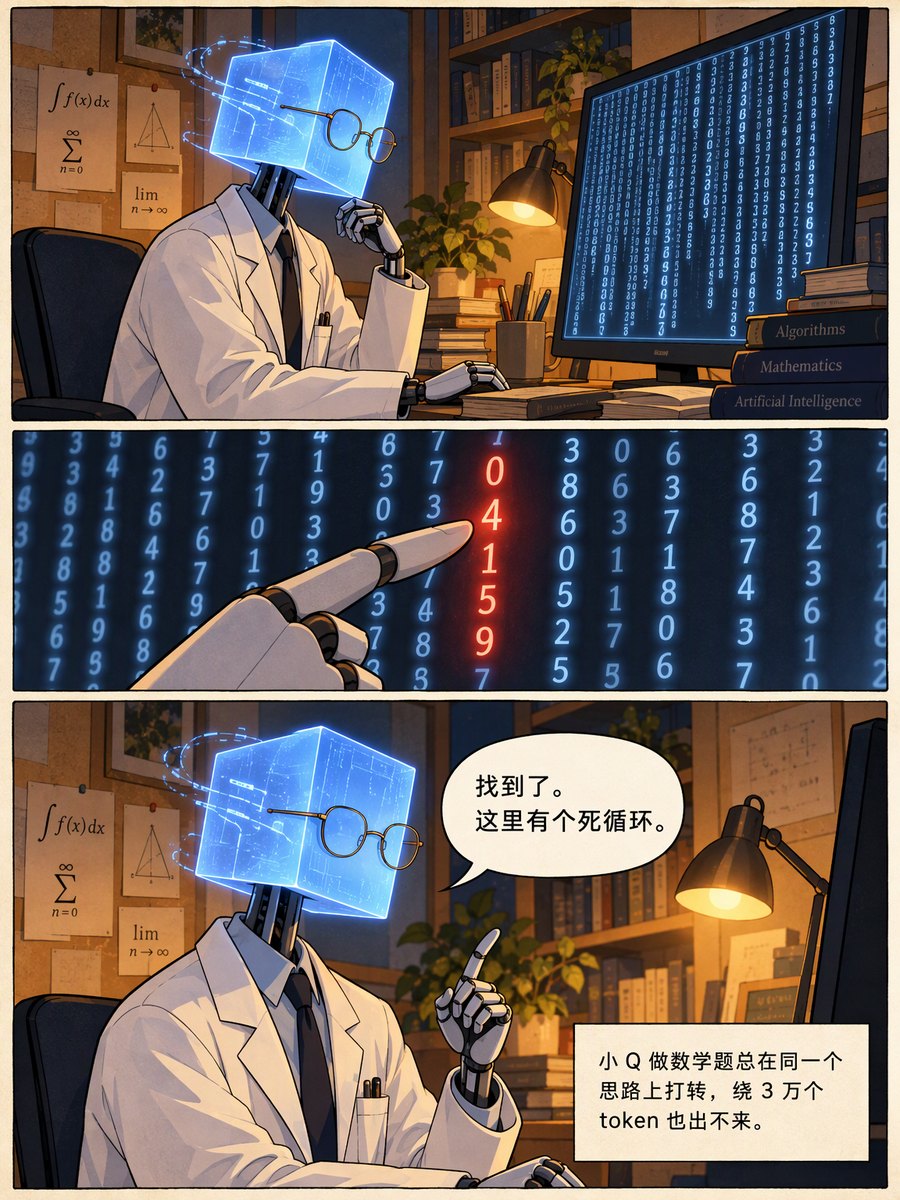
科普漫画 第3页
第3页
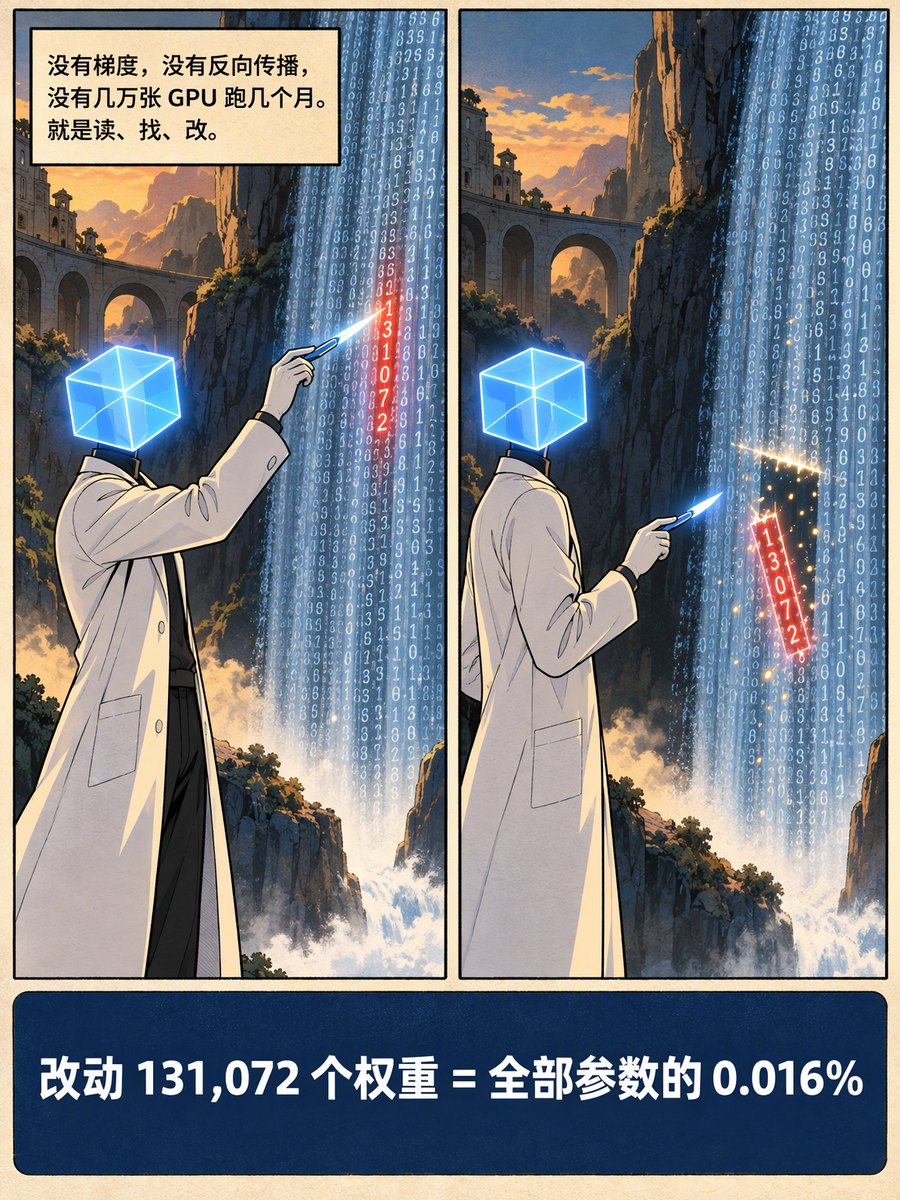
科普漫画 第4页
第4页
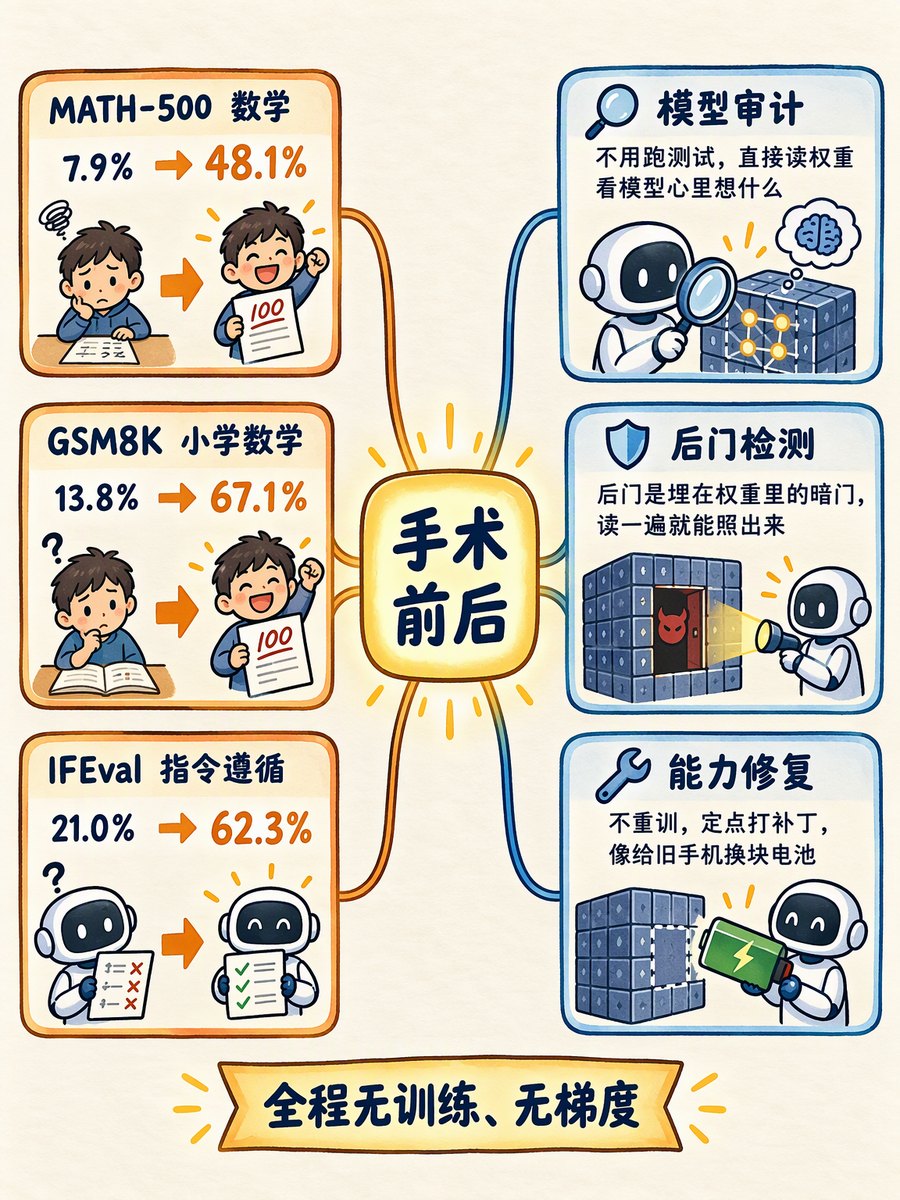
科普漫画 思维导图②
思维导图②
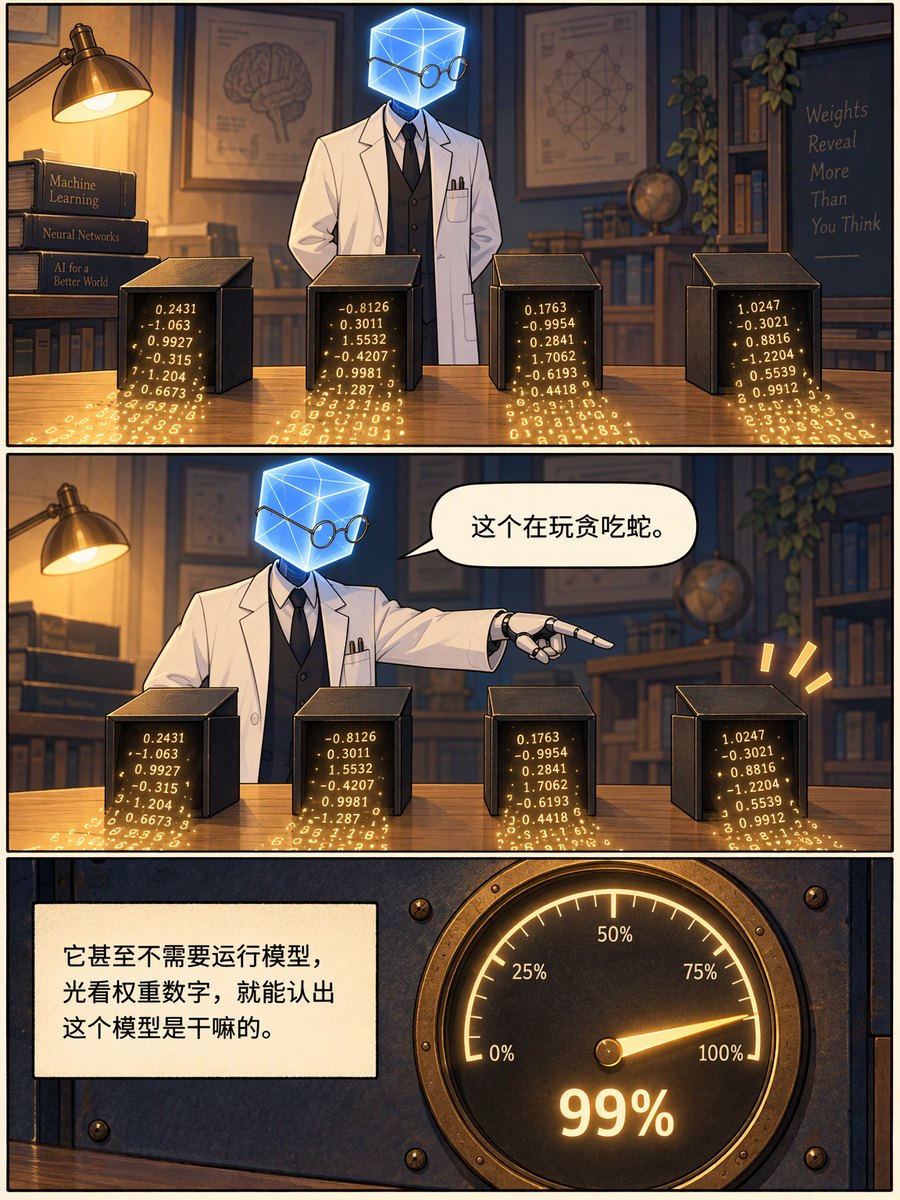
科普漫画 第6页
第6页
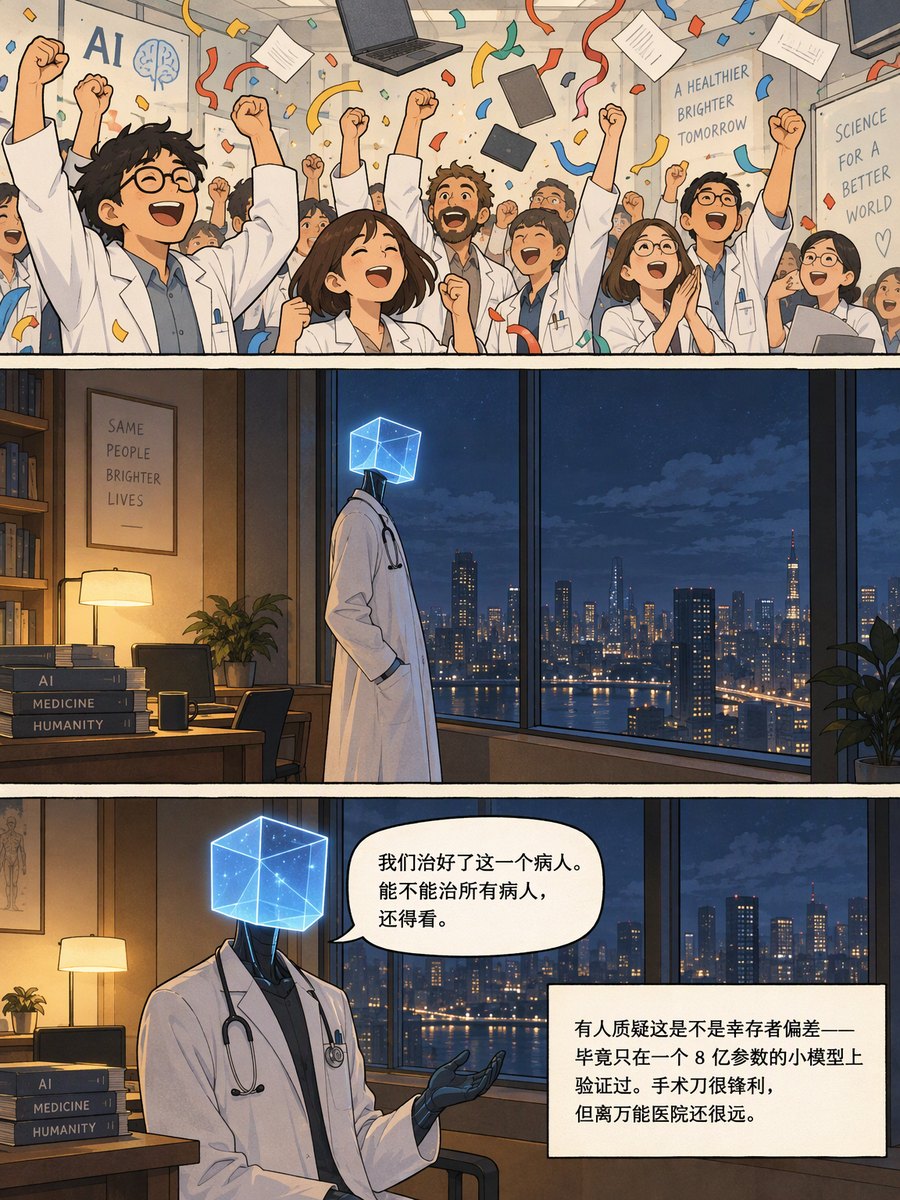
科普漫画 第7页
第7页
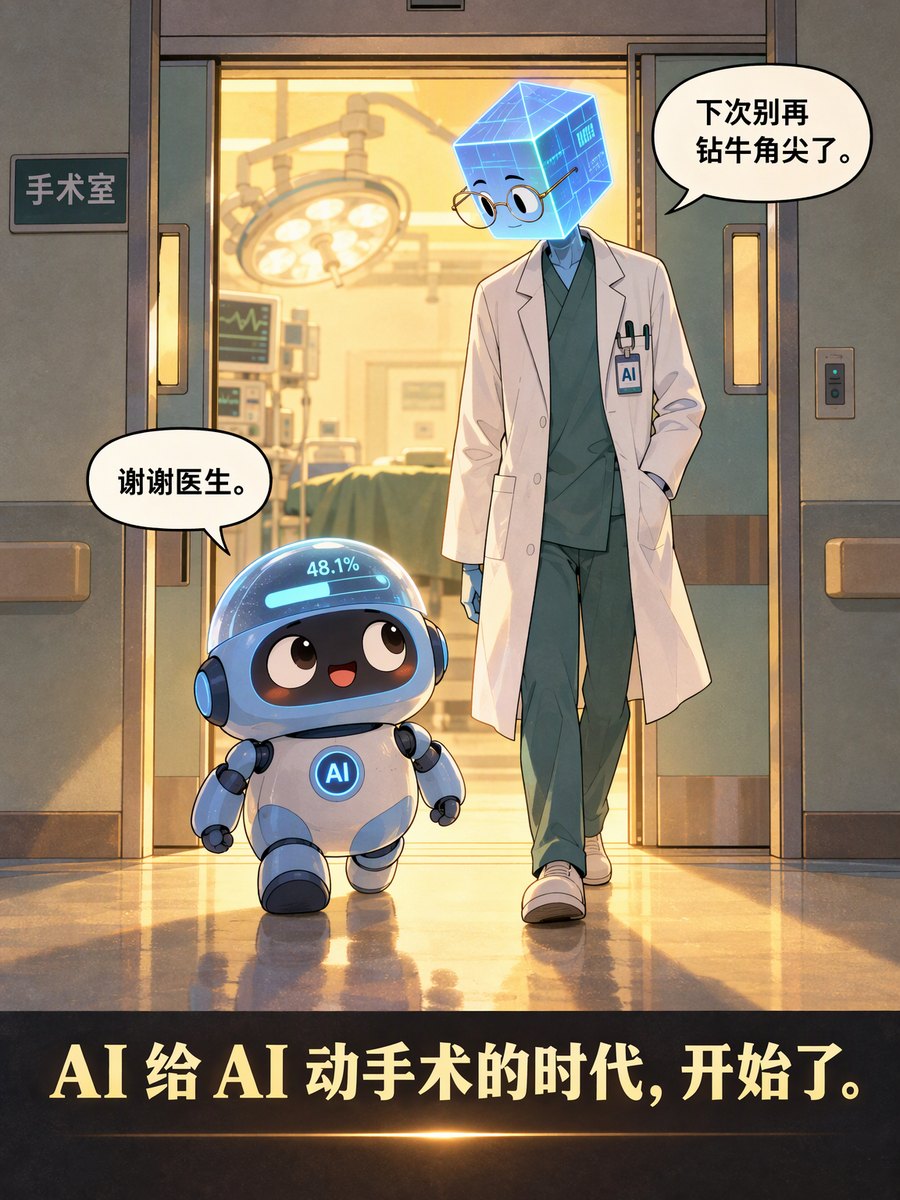
科普漫画 第8页
第8页
先说个可能有点反直觉的判断:MIT 这项研究,短期内在云上没什么直接用处,但它指向的方向,可能会改变模型运维的成本结构。 顺便说一句,这篇文章的配图是我用 AI 生成的——一套 9 页的科普漫画,把"AI 给 AI 做手术"这件事画了出来。技术内容用漫画表达,传播效率确实高不少。
事情本身
MIT CSAIL 让 GPT-6 Astra 直接读写 Qwen3.5-0.8B 的权重,改 131,072 个参数(0.016%),MATH-500 从 7.9% 到 48.1%,GSM8K 从 13.8% 到 67.1%,IFEval 从 21.0% 到 62.3%。无梯度、无训练。 方法叫 Weight-Space Programming。
为什么云厂商该关心
模型运维现在是个很重的活。一个模型上线之后,能力退化、badcase 堆积、安全漏洞,处理手段无非几种:重训、微调、加 prompt 补丁、换模型。 这几种手段的共同点是——成本高、周期长、粒度粗。 重训一次,几十张卡跑几天,成本摆在那儿。微调便宜点,但也得准备数据、跑训练、做评测。prompt 补丁最便宜,但治标不治本,而且会越堆越乱。 如果权重能定点编辑,理论上可以做到:发现某个能力退化 → 定位到具体参数 → 改掉 → 上线。整个过程可能只需要几分钟,不需要 GPU 集群。 这让我想到平时用 AiPy 编排任务时的体验:真正省时间的不是单个模型有多强,而是整条链路能自动跑通、出错能定位到具体环节。模型运维要的也是这个——不是更快的训练,而是更准的诊断。
三个可能的产品形态
模型体检服务。 客户上传模型,平台读权重,输出一份"健康报告":有没有异常特征方向、有没有可疑的后门结构、能力和宣称的是否一致。这个在合规场景下会有需求。 增量修复。 模型上线后发现特定能力缺陷,不用重新训练,直接打权重补丁。类似热修复。 权重溯源。 判断一个模型是不是从另一个模型微调来的、有没有被篡改过。版权和供应链安全场景。
但落地没那么快
三个现实问题。 第一,验证范围太窄。只在 8 亿参数的小模型上跑通了,大模型能不能行,未知。 第二,方法依赖一个足够强的"医生模型"。GPT-6 Astra 这个级别的模型,本身成本就不低。如果每次手术都要调它,成本未必比重训低多少。 第三,工程化难度。权重序列化、结构对齐、改动验证,每一步都需要工具链支撑。现在还是论文阶段。
一个更现实的观察
我注意到很多团队在做模型运维时,其实缺的不是"修复手段",而是"诊断能力"。 模型为什么答错了?是知识缺失、是推理链断裂、还是被某个特征带偏了?现在基本靠猜。 权重可读这件事,最大的价值可能不在"改",而在"看"。能看清楚问题在哪,才谈得上怎么修。 从这个角度说,模型可观测性可能会是第一个被撬动的方向。
收个尾
MIT 这个实验,我倾向于把它看作一个"可行性证明",而不是"产品原型"。 它证明了一件事:模型的权重不是完全不可理解的,至少在某些情况下,外部模型可以读懂它、定位问题、并做出有效修改。 这个结论本身,比那 40 个百分点的提升更有分量。 至于什么时候能变成云上的一个按钮,我觉得还得等两三年,等工具链成熟、等大模型上的验证出来。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号