177 个候选号码一次跑完:我把"选号凭感觉"做成了可复算的表
原创
177 个候选号码一次跑完:我把"选号凭感觉"做成了可复算的表
原创
爱品茶的老刘
修改于 2026-09-22 11:17:21
修改于 2026-09-22 11:17:21
公司在筹备一条新的售后号,候选号码先拿到一批 97 个,隔天又补了 80 个,一共 177 个。
这事如果按老办法做,结局大概率是这样的:拉个表,几个负责人各自看一遍,最后拍板的那个人说"我觉得带 8 的那批听着顺",然后定稿。说不清为什么,也说不出为什么不选别的。
我不想这样。不是我信不信这套东西的问题,而是"选号"这件事一旦进了公司流程,它就必须能被复算、被质疑、被复盘。 于是我把它做成了一套可复跑的脚本工具:口径写在代码里,每一分都能从明细倒推回公式。
这篇把完整过程写下来——含权重表、结果、以及过程中踩到的 5 个真实的坑(其中两个是工具本身的 bug,已经修掉)。
一、先定规矩:400 号码的"取数"不是平均的
这一步是关键设计,也是最容易被做错的地方。
400 是工信部指定的服务热线号段,所有 400 号码前三位都一样,没有区分度,所以不参与吉凶判断。 真正有意思的是后面 7 位,其中最后四位权重最高——传统号码数理里公认的"主数"。
我用了三套体系交叉验证,取值逻辑各不相同:
体系 | 取数方式 | 判读依据 |
|---|---|---|
八十一数理 | 后四位数值 ÷ 80 取余(余 0 记 80) | 对照 1–81 数理表 |
数字能量学 | 后四位相邻两位成组,得 3 组 | 八星磁场分布 |
周易象数 | 后四位配先天八卦,成上下卦 | 六十四卦卦象 + 动爻 |
另外还加了全号磁场序列(去掉固定的 400,剩下 7 位相邻成组,6 组)作为修正项。
⚠️ 一个必须先说清的规则:八星磁场体系里,含 0 或 5 的组合不作八星论(记作"辅助")。0 和 5 在这套体系里是"无磁场"的过渡数。这条规则会直接影响结果——后四位含 0/5 的号码,能判的组数不足 3 组,分数天然失真。我这批里 只有 76/177 个号码后四位能判满 3 组,剩下 101 个的后四位分数是"不完整"的,必须单独标注。
二、评分模型:权重表全公开
总分公式:
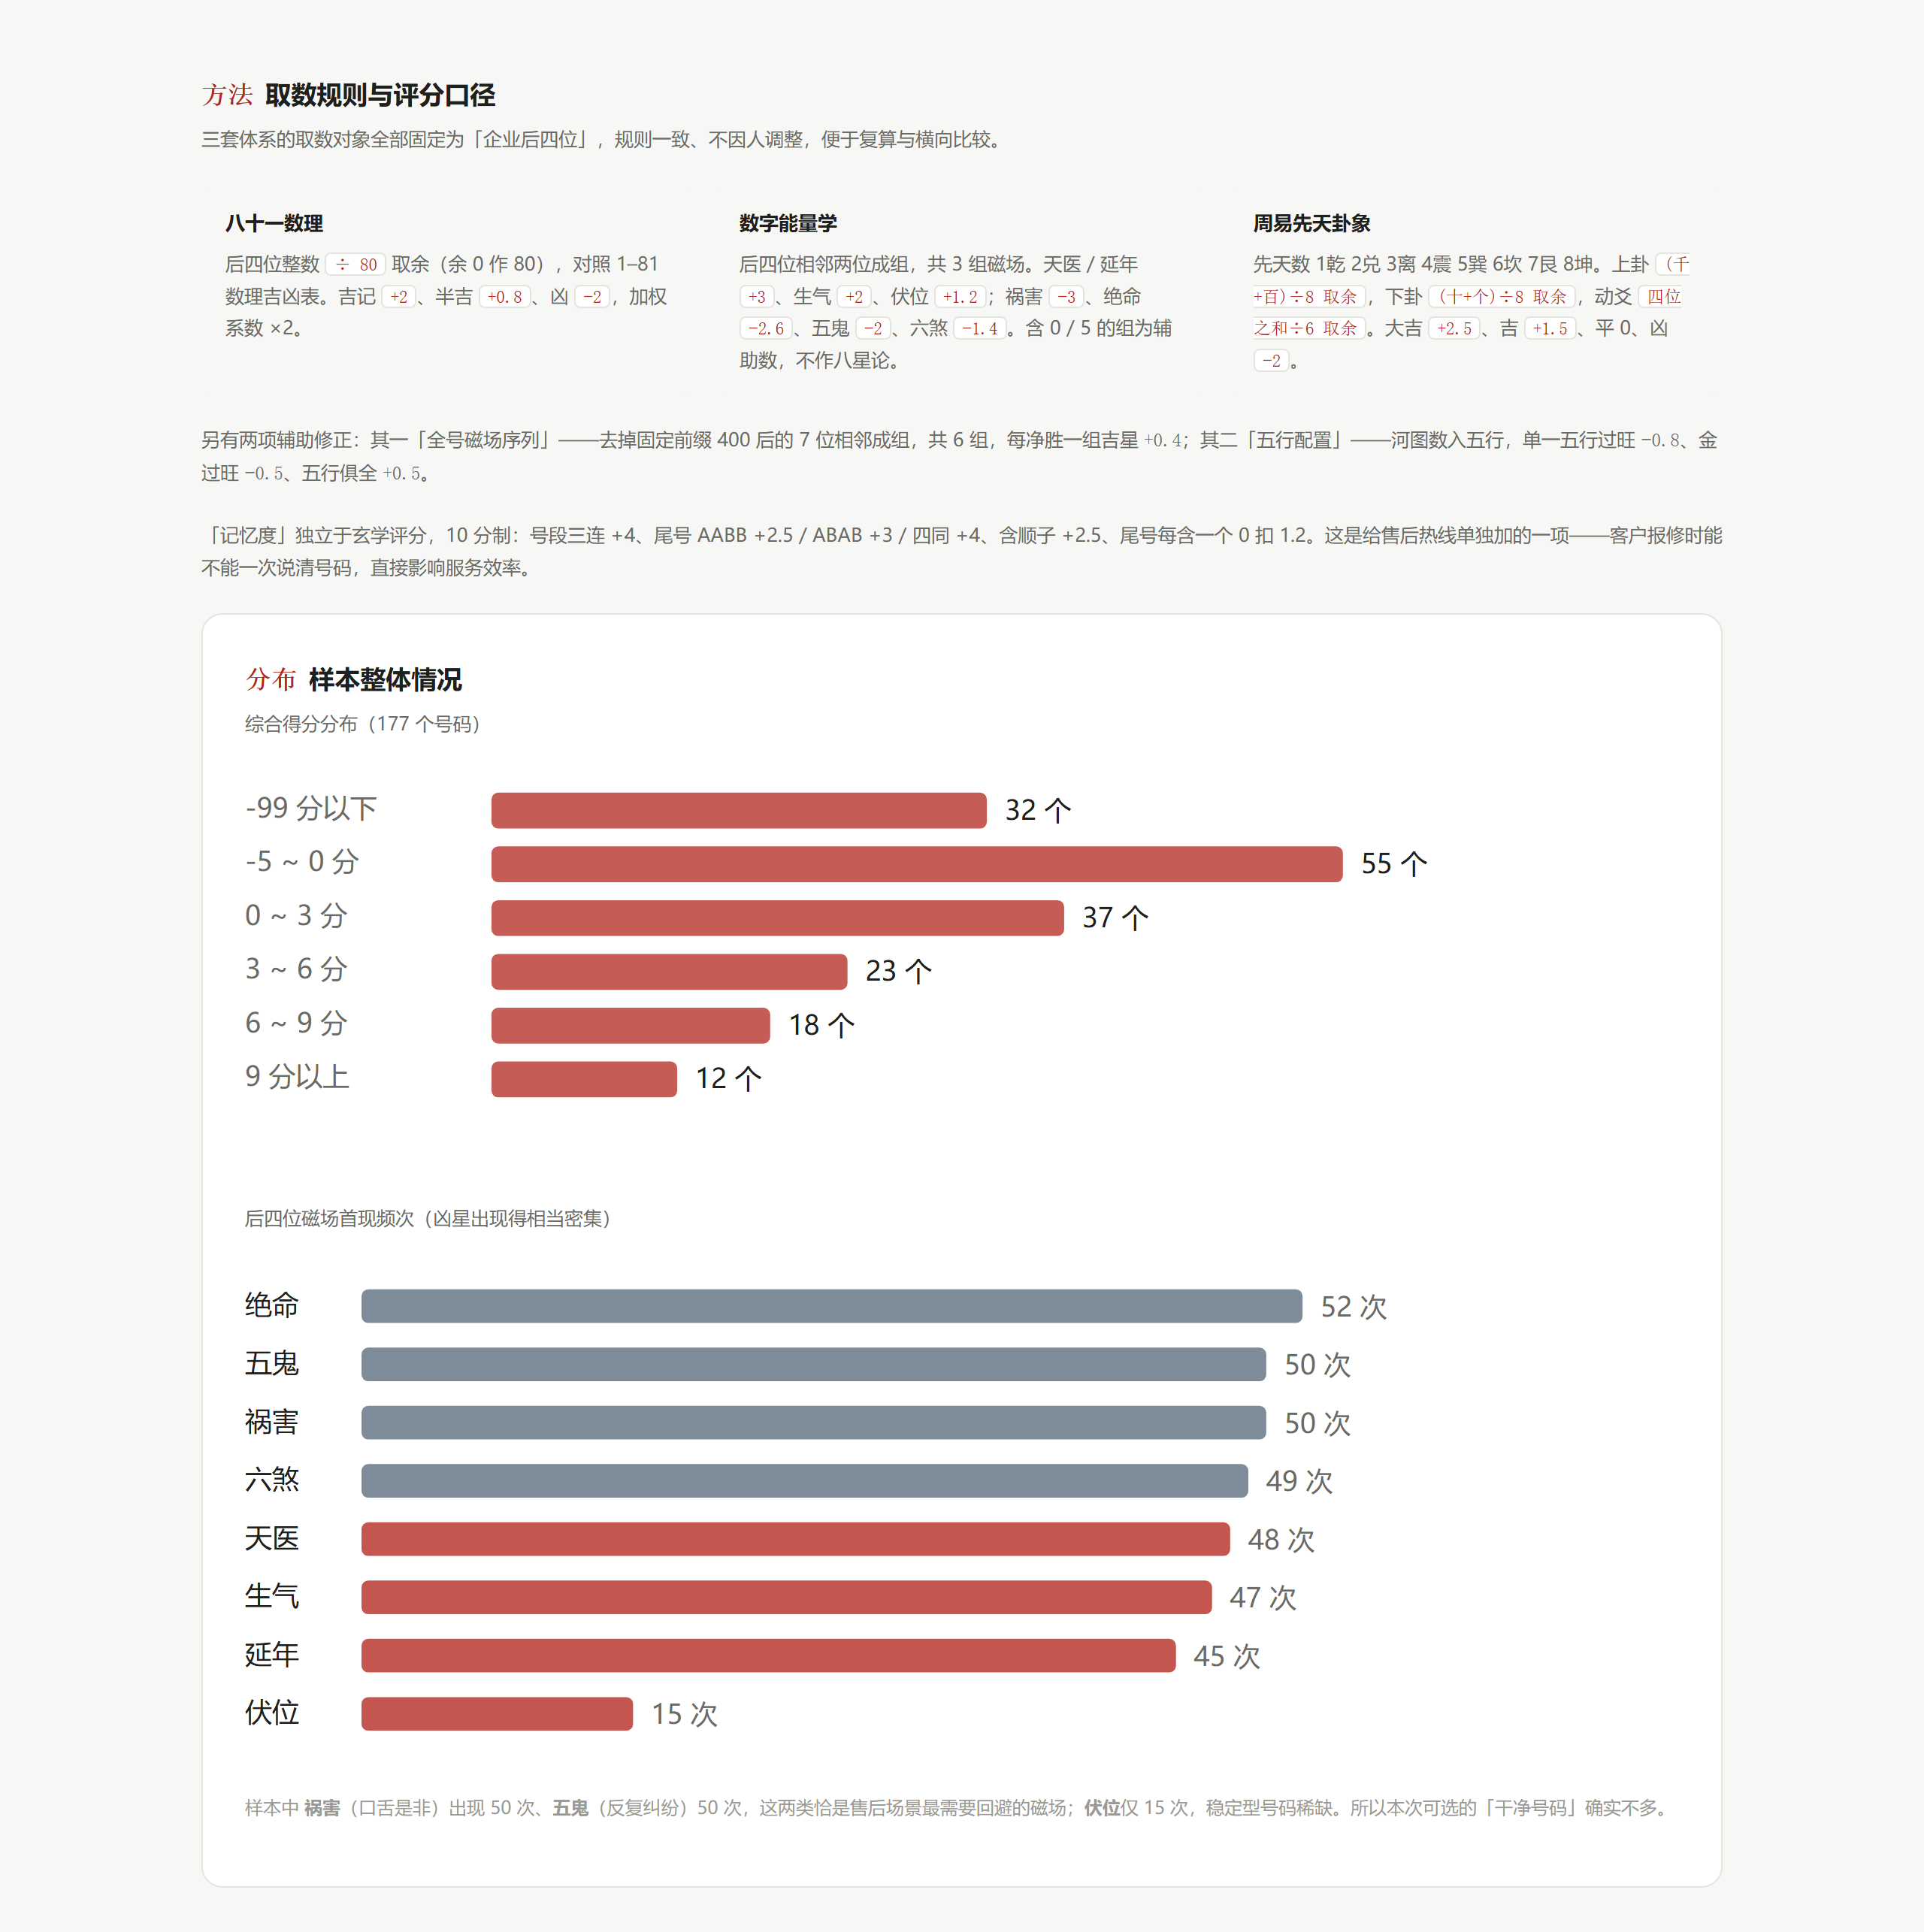
八十一数理(后四位 ÷ 80 取余):吉 +2.0 / 半吉 +0.8 / 凶 −2.0,权重 ×2(它是主判据,所以给了双倍权重)。
数字能量学八星——这里有个重要的场景化设计:我按"售后客服"这个用途重新赋权,而不是用通用权重。售后重稳定、重专业、重化解纠纷,忌口舌、忌对立、忌反复纠缠,所以:
星 | 分 | 星 | 分 |
|---|---|---|---|
天医 | +3.0 | 祸害 | −3.0 |
延年 | +3.0 | 绝命 | −2.6 |
生气 | +2.0 | 五鬼 | −2.0 |
伏位 | +1.2 | 六煞 | −1.4 |
同一批号码换成"门店引流"或"个人使用",这张表就该变——用途不同,权重必须不同,这是不能省的一步。
周易卦象:大吉 +2.5 / 吉 +1.5 / 平 0 / 凶 −2.0。动爻取后四位数字和 mod 6。
五行(河图数:1/6 水、2/7 火、3/8 木、4/9 金、5/0 土):全号单一五行 ≥5 次 −0.8(过旺);五行俱全 +0.5;金 ≥5 次 −0.5(刚硬)。
全号序列修正:0.4 ×(吉组数 − 凶组数)。
三、加一个传统体系里没有的维度:记忆度
这一项不在任何传统体系里,是搭这套流程时单独加的,但对企业服务热线来说是刚需:
客户打电话时能不能一次把号码说清、说对?
一个客户报错一位数字,就多一次转接、多一段等待、多一分不满。所以记忆度按"口述成本"建模:
- 基准 3.0 分
- 中段三连号(三位相同数字)+4.0,含重号 +2.0
- 尾号结构:四同 +4.0 / ABAB +3.0 / AABB +2.5 / 三连 +2.0 / 双连 +1.0
- 含顺子 +2.5
- 尾号每含一个 0,−1.2(0 在电话口述时最易被误听,属于按误听经验取值)
- 尾号四位全不相同 −0.5
- 上下限 [0, 10]
这一项一加进来,排名立刻发生变化——因为一批号码在玄学上"整体不差"和"有一个特别好的"完全是两件事。
四、从"一次性脚本"到"可复跑的流水线"
这是我认为整套流程里最值钱的一步。
第一版是写死号码的脚本:把 97 个号码粘进源码里的一个字符串,跑完输出报告。能用,但下次换一批就得改代码,而且改代码的过程本身就会引入错误。
第二版改成数据驱动:
- 号码从外部文件读(
NL_NUMBERS环境变量指定),不再写进源码; - 用途从
NL_USECASE读,权重表随用途切换; - 输出目录从
NL_OUTDIR读; - 整个流程(测评 → 汇总 → 生成 HTML 报告 + 明细 CSV)固化成一条一键复跑的流水线。
效果:第二批 80 个号码进来时,一条命令出报告——不用再调一次逻辑,也不用担心两次运行的模型口径不一致。
顺带说一句,这里有个我特别在意的性质:两批号码的分数是可比的。因为分数是绝对分(由固定权重表算出),不是"批内相对分"。所以第二批跑完之后,我可以直接把它和第一批合并成一张 177 行的榜排序,而不是各排各的。很多"批量打分"工具在这一步会翻车——它是排完序再归一化,导致跨批次不可比。
五、跑出来的结果
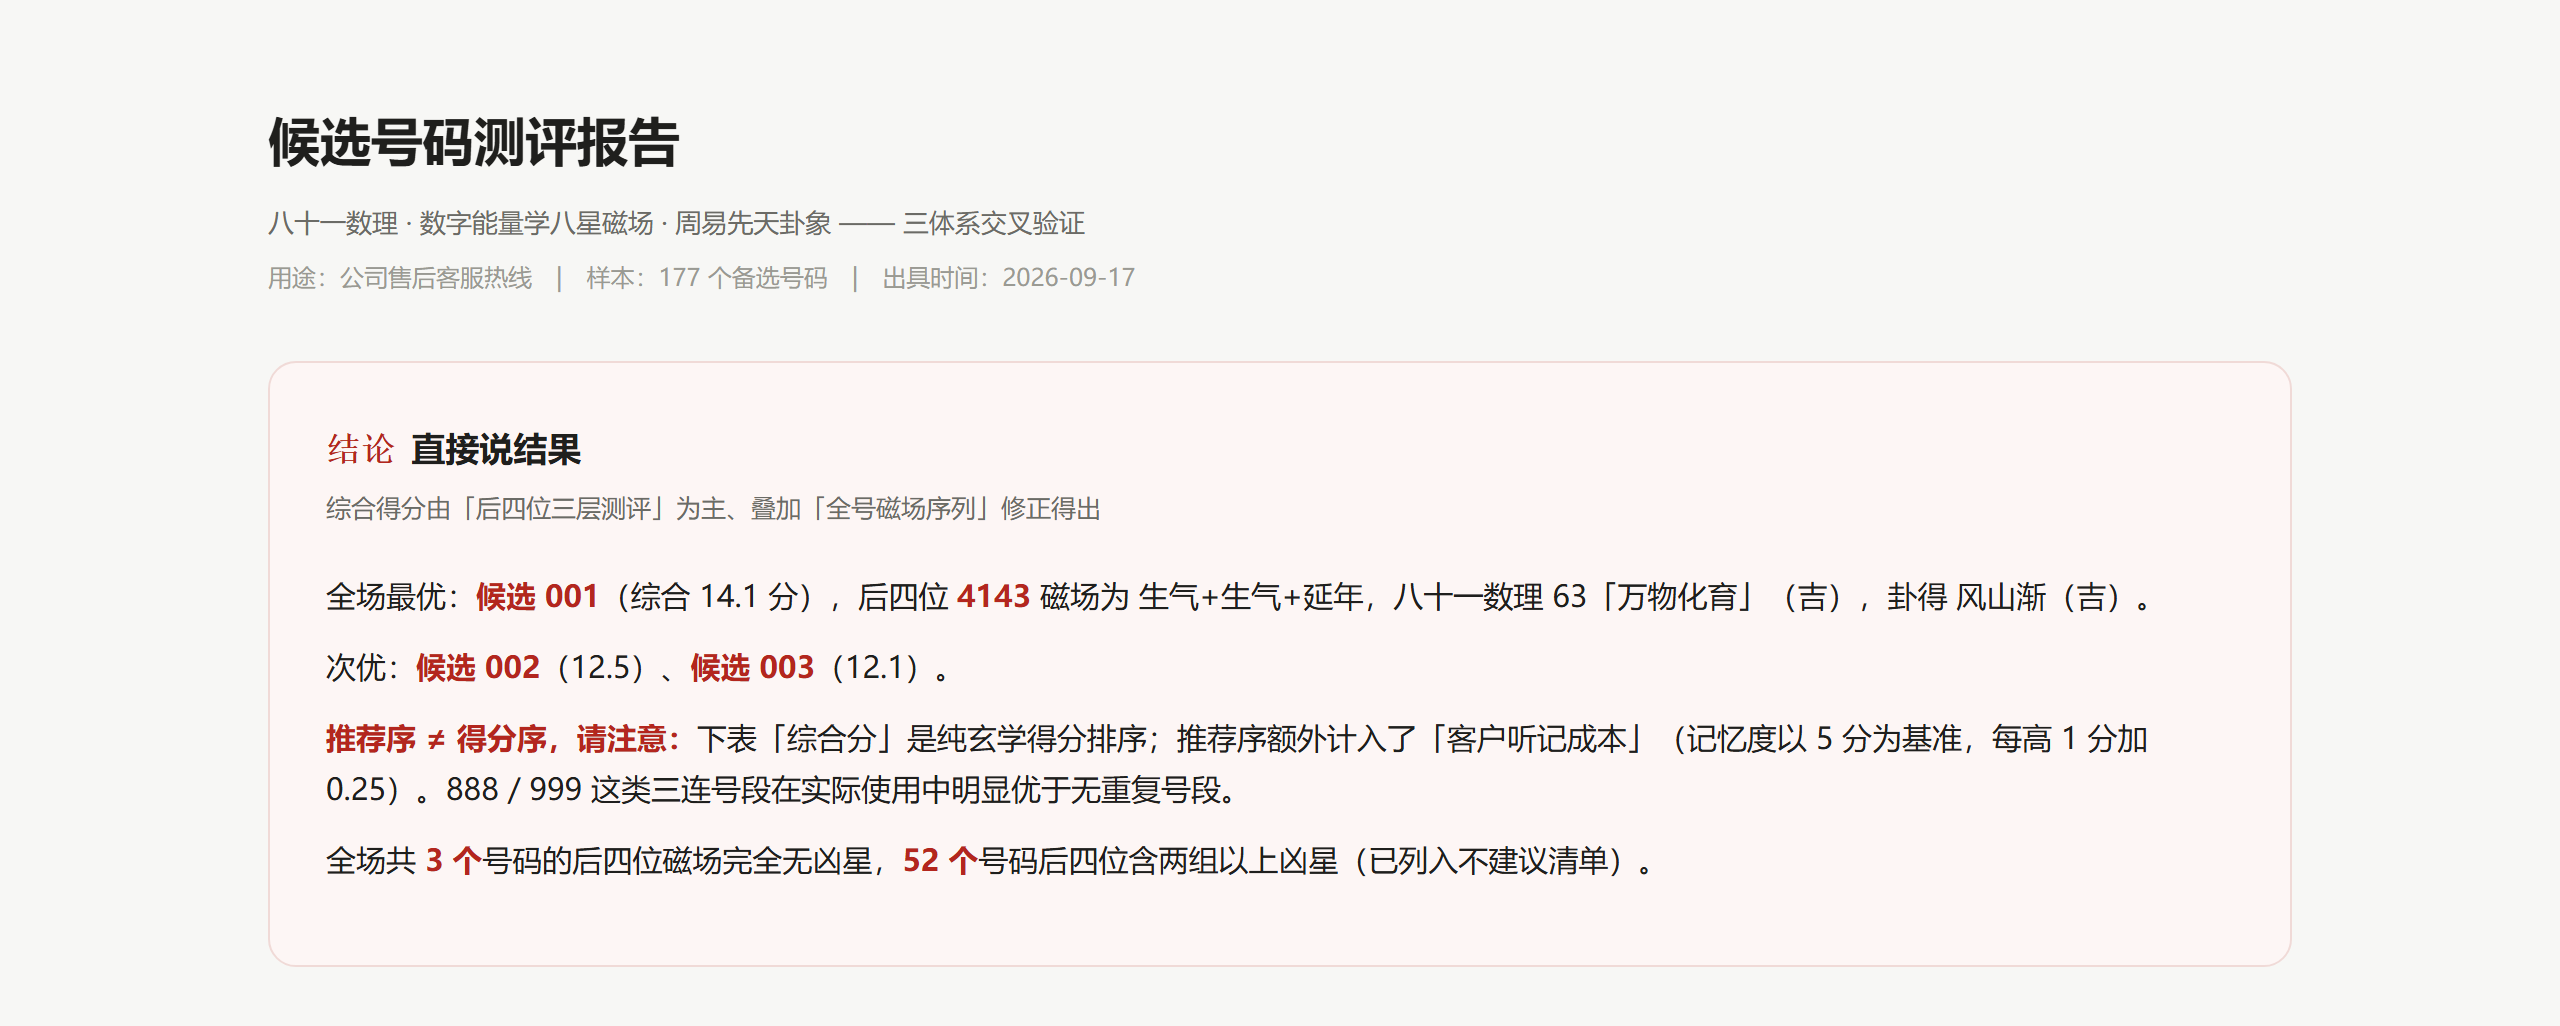
177 个号码,去重后仍是 177 个(无重复)。关键统计:
指标 | 数值 |
|---|---|
综合分区间 | −13.4 ~ 14.1 |
综合分均值 / 中位 | 0.27 / 0.2 |
记忆度区间 / 均值 | 0.6 ~ 8.0 / 4.58 |
后四位可判满 3 组磁场 | 76 / 177(其余 101 个含 0/5 辅助组) |
后四位含 ≥2 组凶星 | 52 / 177 |
后四位无凶星(可判号码中) | 32 / 169 |
后四位收口(最后一组可判磁场)吉 / 凶 | 74 / 95(8 个号码后四位全为辅助,无法判断收口) |
后四位凶星出现总次数 | 201 次(绝命 52 / 五鬼 50 / 祸害 50 / 六煞 49) |
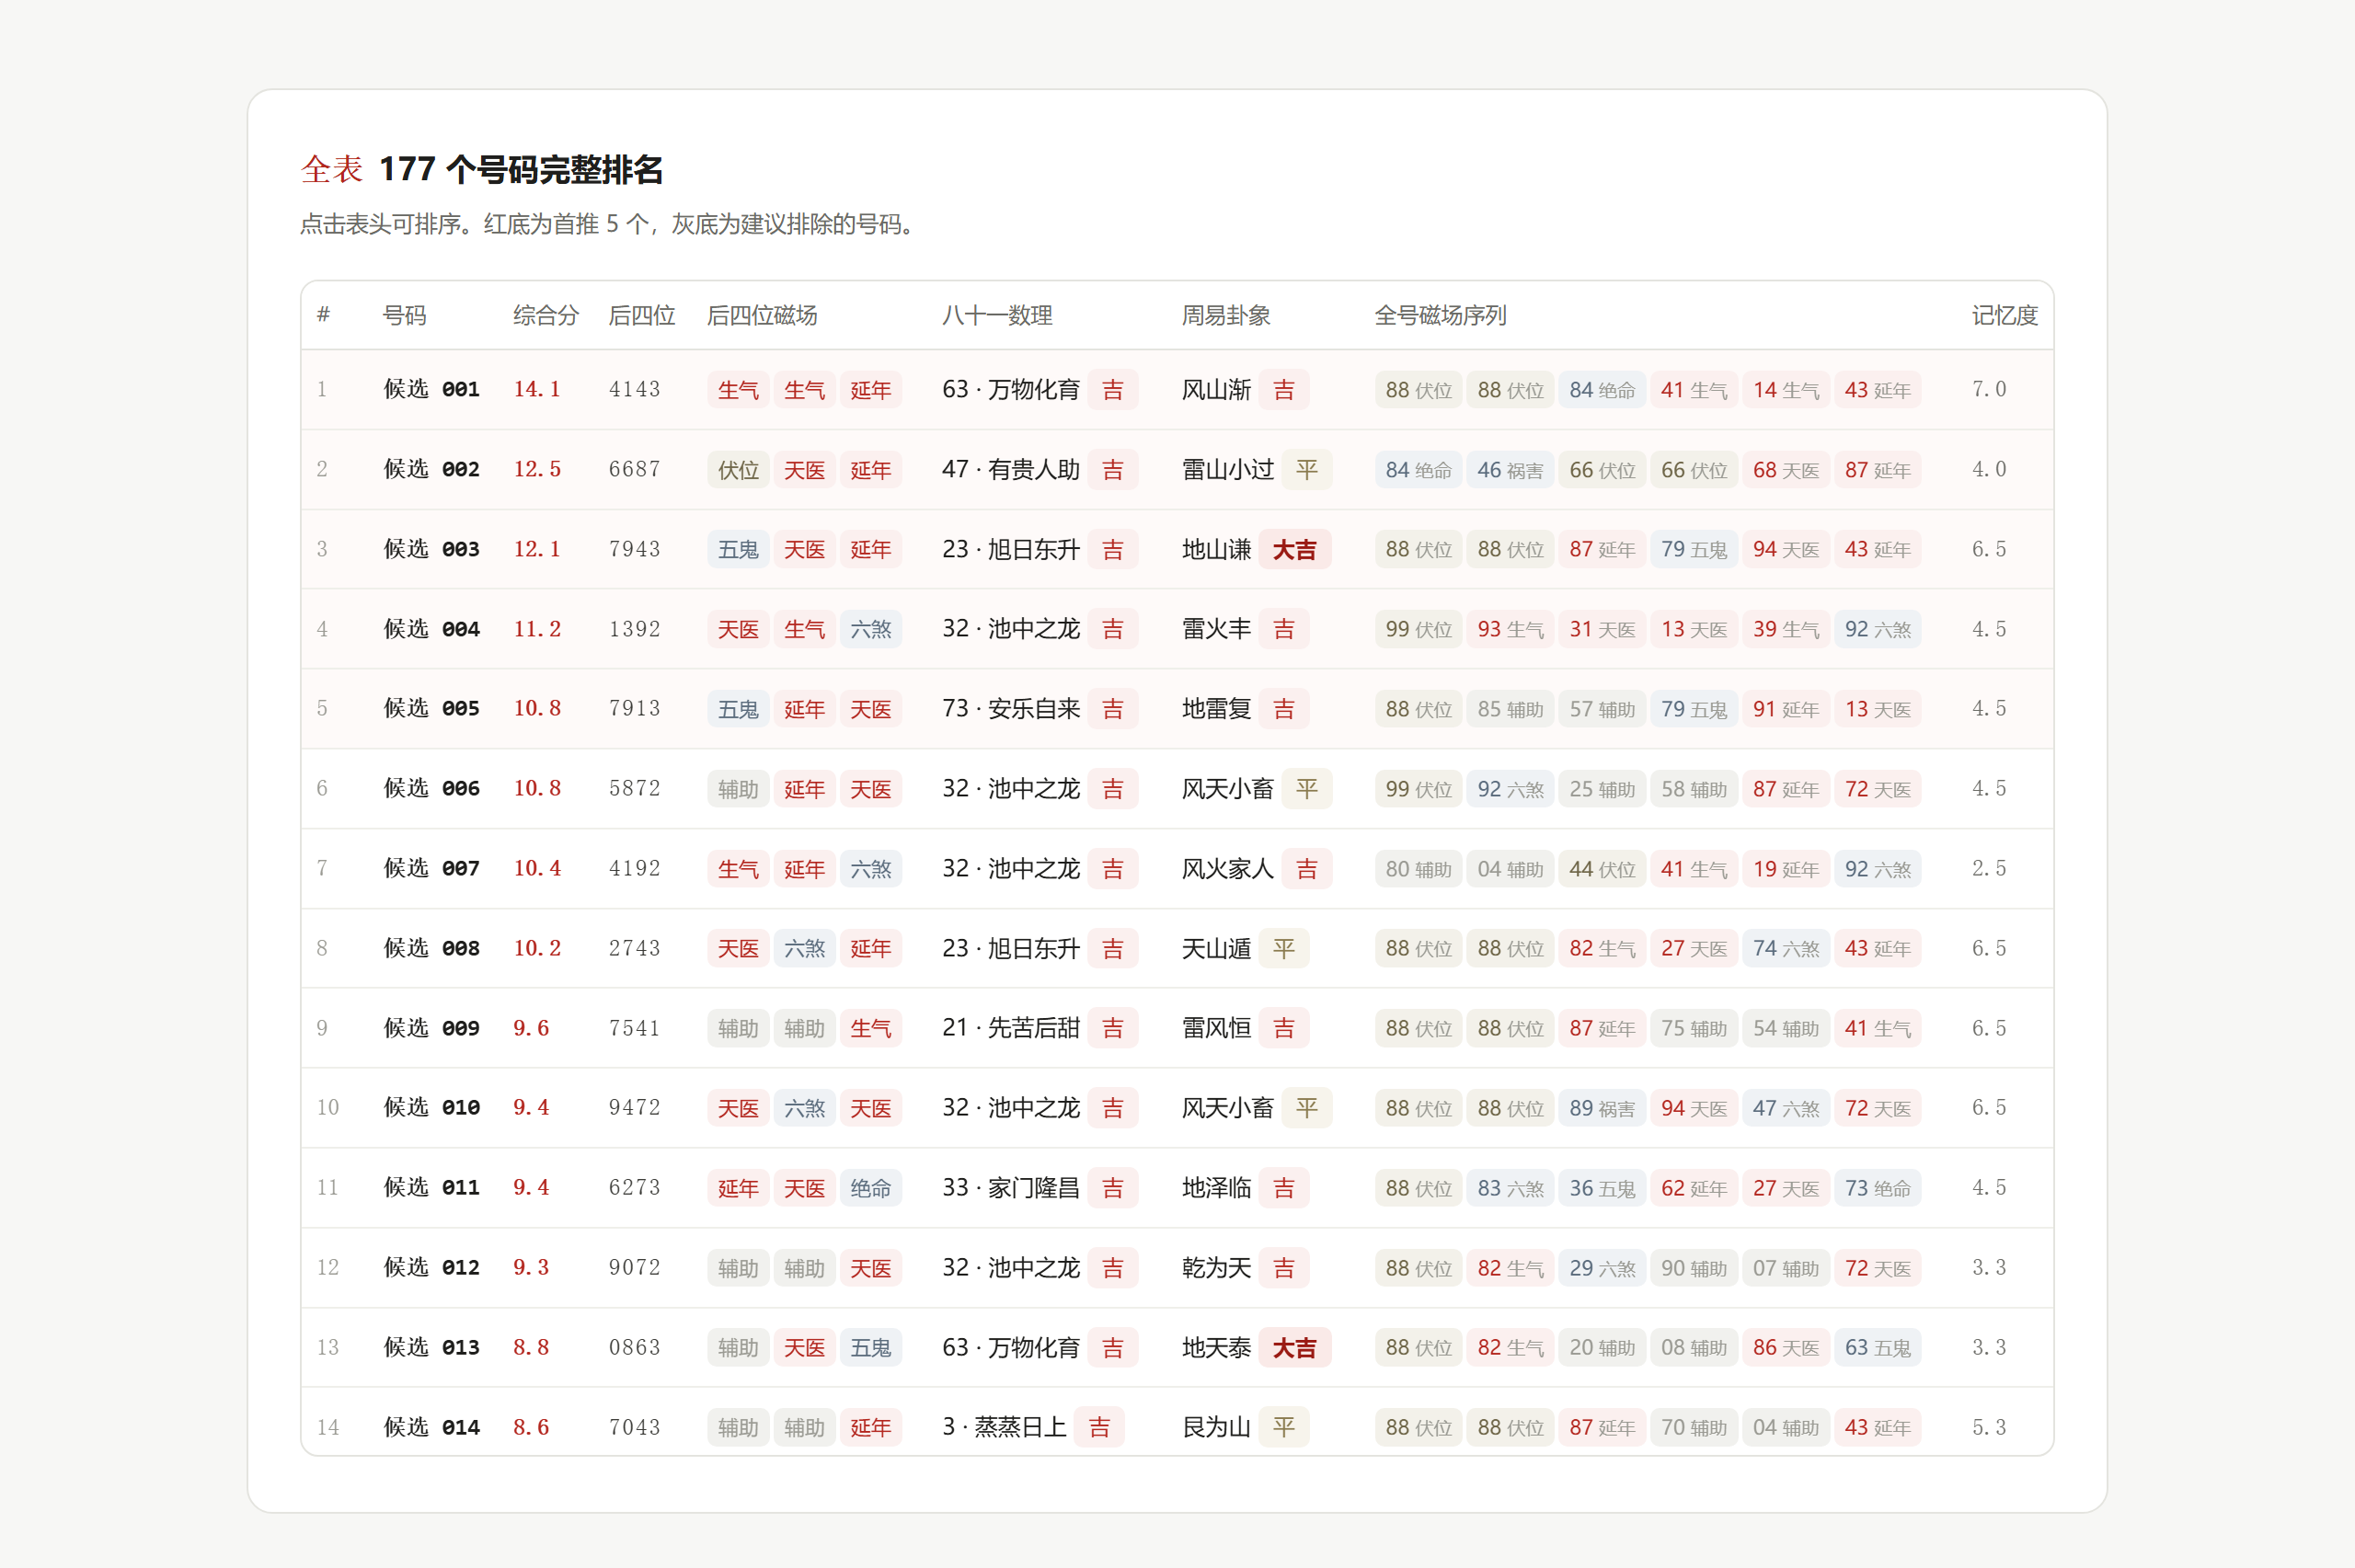
综合分 TOP 5:
位次 | 候选编号 | 综合分 | 后四位磁场 | 数理 | 卦象 | 记忆度 |
|---|---|---|---|---|---|---|
1 | 候选 001 | 14.1 | 生气 + 生气 + 延年 | 63 万物化育 吉 | 风山渐 吉 | 7.0 |
2 | 候选 002 | 12.5 | 伏位 + 天医 + 延年 | 47 有贵人助 吉 | 雷山小过 平 | 4.0 |
3 | 候选 003 | 12.1 | 五鬼 + 天医 + 延年 | 23 旭日东升 吉 | 地山谦 大吉 | 6.5 |
4 | 候选 004 | 11.2 | 天医 + 生气 + 六煞 | 32 池中之龙 吉 | 雷火丰 吉 | 4.5 |
5 | 候选 005 | 10.8 | 五鬼 + 延年 + 天医 | 73 安乐自来 吉 | 地雷复 吉 | 4.5 |
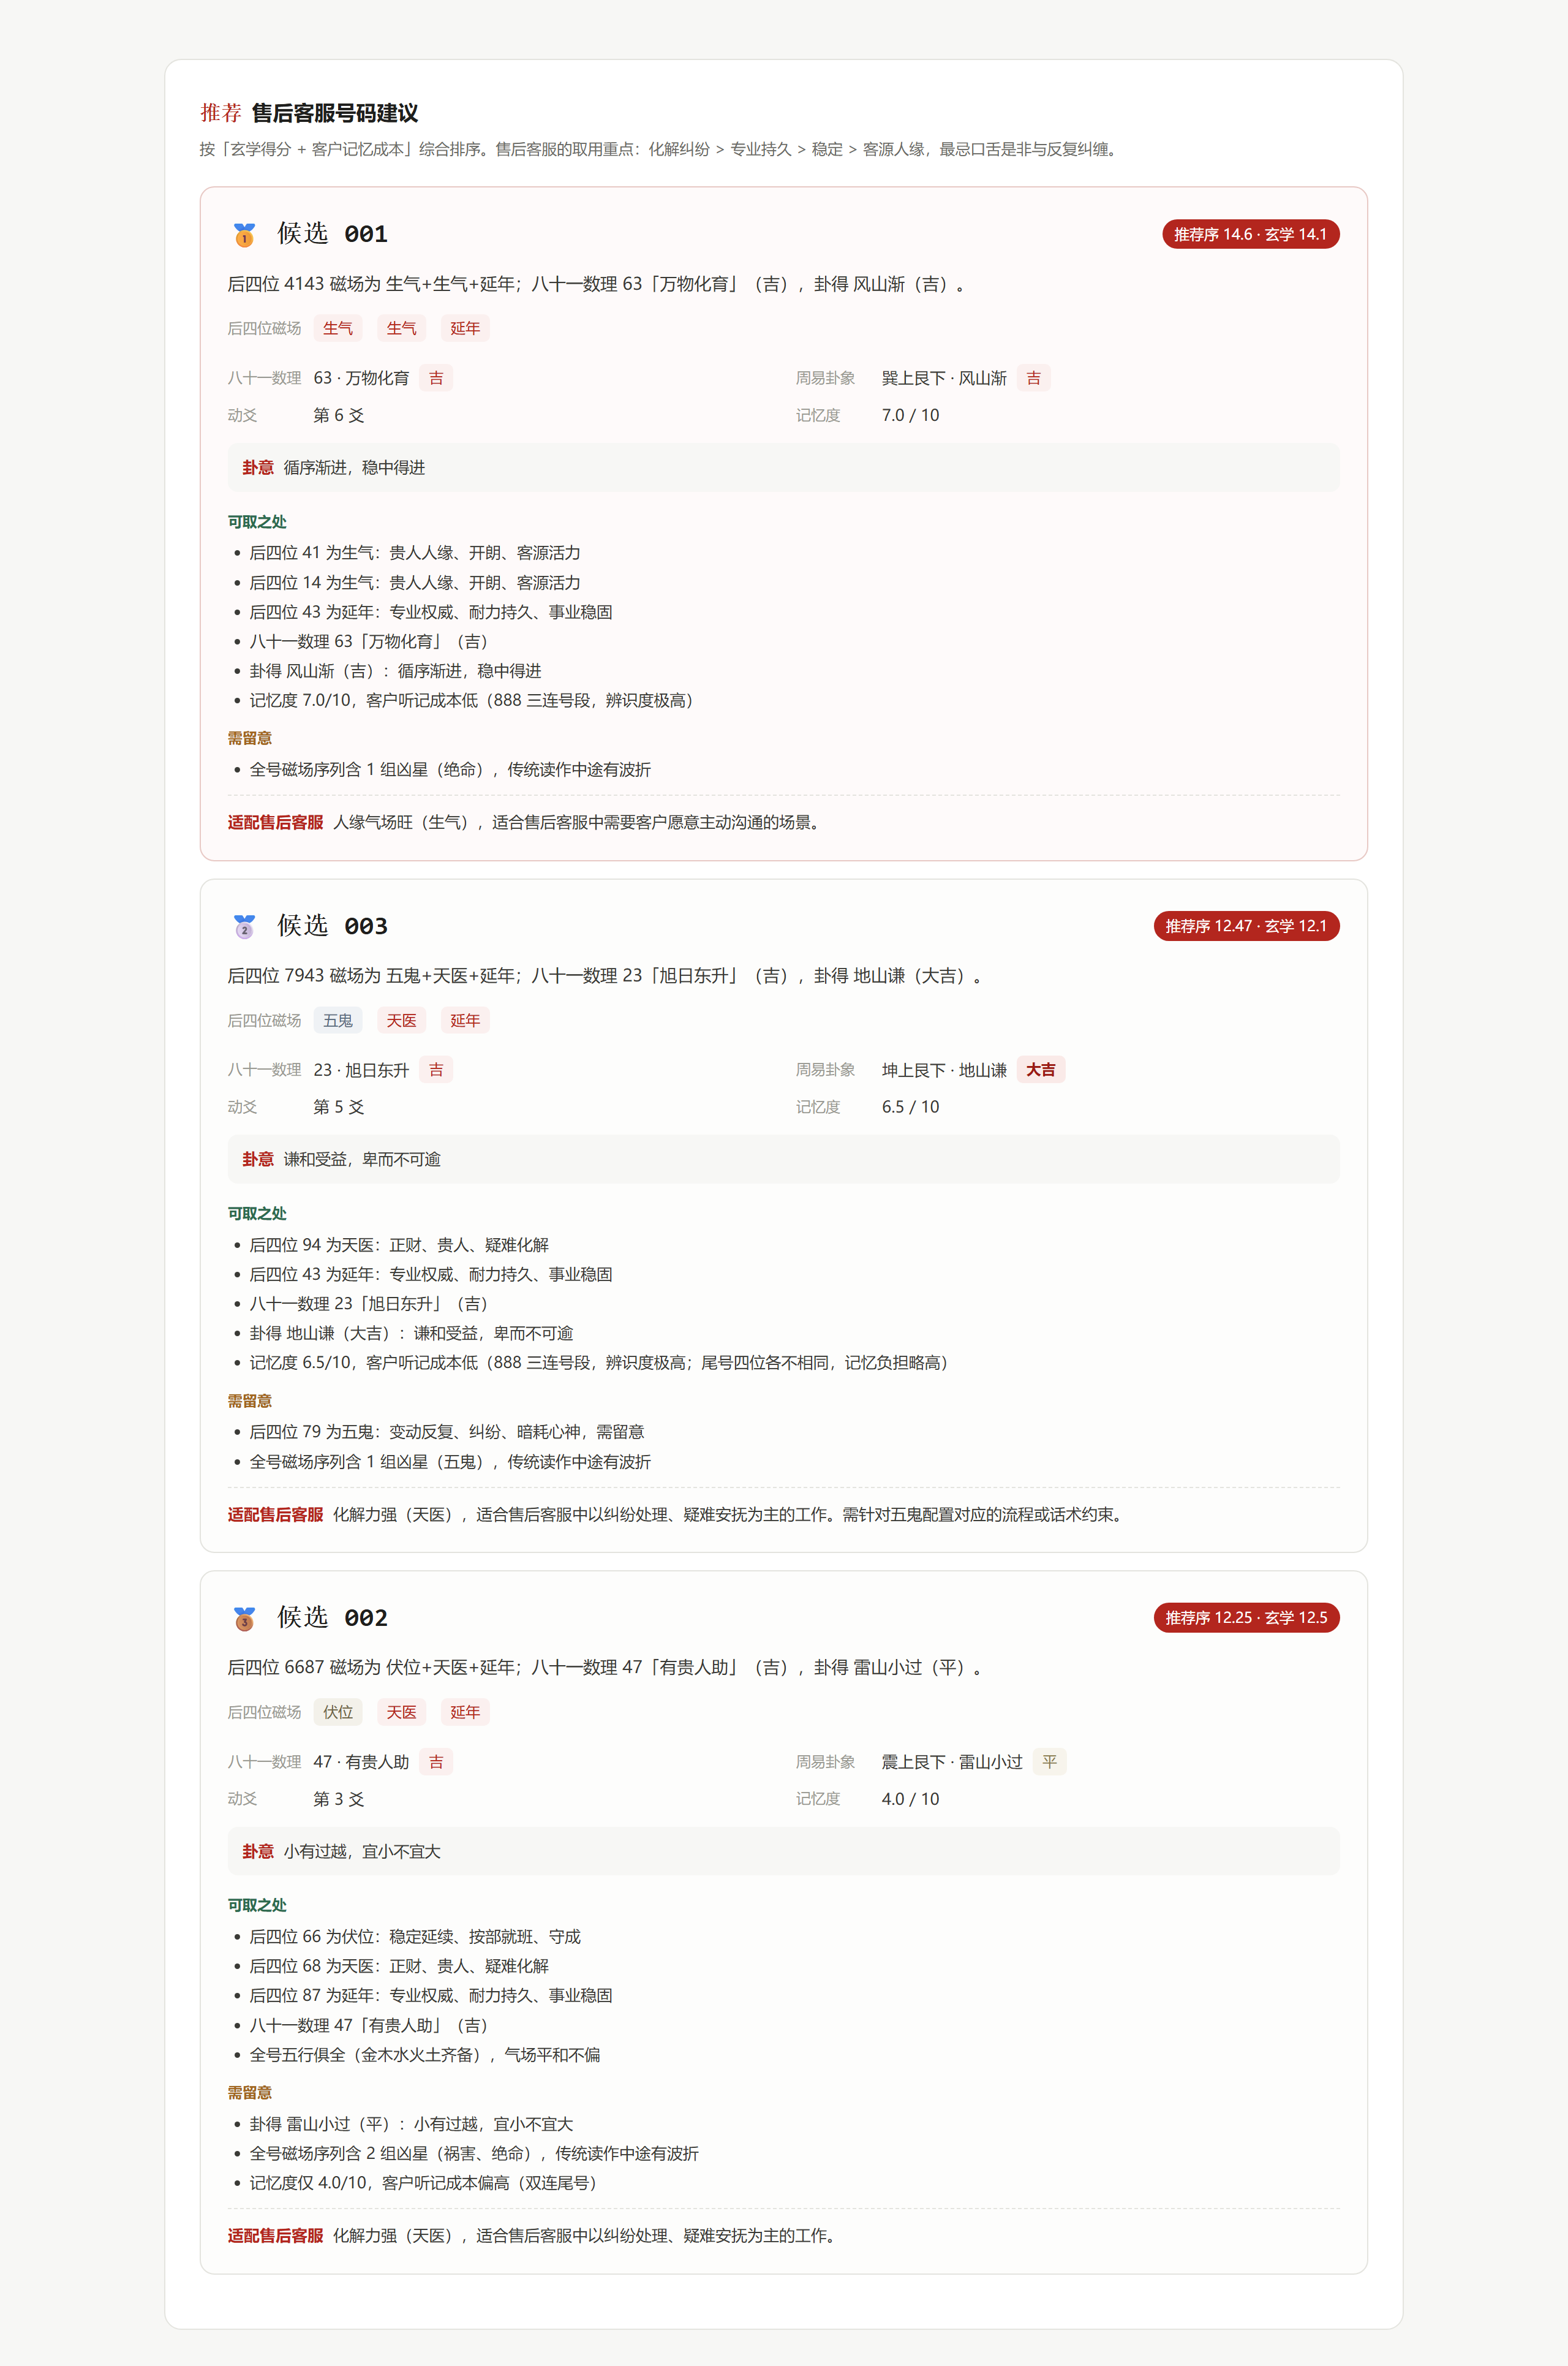
第一名值得单独说一下:后四位含两个「生气」的号码全场只有两个,而其中只有它同时带「延年」;它也是 32 个后四位无凶星的号码里分数最高的。生气主客源人缘(客户更愿意开口说问题),延年主专业持久(事能跟到底)——恰好是售后最需要的两件事。卦得风山渐,"循序渐进",也很贴售后的性子。短板是双生气偏柔、五行缺火,需要用制度和话术补刚性。
第二名值得单独说一下:候选 002 的玄学基础分(11.7)和第一名(12.5)差距很小,后四位是零凶星的"伏位 + 天医 + 延年"——售后最需要的三件事(稳定守成、化解疑难、专业持久)全占了。它排第二有两个原因:
- 全号序列修正分低(+0.8,第一名 +1.6)。看 6 组的吉凶构成对照就清楚了:
- 候选 001:伏位、伏位、绝命、生气、生气、延年 → 5 吉 1 凶
- 候选 002:绝命、祸害、伏位、伏位、天医、延年 → 4 吉 2 凶
这里藏着一个结构性的发现:中段三位相同的号段,前两组磁场固定是"伏位 + 伏位",等于天然把号码前段的凶星密度压低了;而候选 002 这种无重复数字的号段,开头两组恰好落在"绝命 + 祸害",一出手就丢两组。这不是玄学问题,是号段本身的结构差异——也就意味着"三连号号段更好"这件事,有一部分是可以用纯结构解释的。
- 记忆度只有 4.0——该号段没有任何重复数字,客户在电话里听记成本明显更高。
两项叠加,把两者的总分差从 1.6 分拉到了 2.35 分。这正是我不只按玄学分排序、而是把记忆成本并入推荐序的原因。
关于脱敏:本文与配图中的号码一律脱敏为"候选编号"(编号即综合分排名,候选 001 = 第一名),不出现任何完整号码。低分号码我同样不点名——它们仍在候选池中,给具体号码挂公开的"差评"没有意义。这套东西的分数服务于"我方在若干候选中排序",不该被当成对某个号码的公共评价。
六、踩到的 5 个坑(都修了)
这部分我觉得比结果更有价值,因为它才是"让 AI 干活"的真实样子。
坑 1:环境变量在 import 之后才设,等于没设。 引擎在模块导入期就读取号码清单。第一次搭外层脚本时,先用默认值 import 了模块、才去设环境变量——结果脚本"成功运行"了,跑出来的还是上一批的旧数据。没有任何报错。 这是最危险的一类 bug:静默错误。修法是把 os.environ 的设置提到所有 import 之前。
坑 2:命令行输出抓不到,就必须落盘再读。 在 PowerShell 里直接跑 Python 脚本,标准输出经常拿不到。稳定做法是 *>&1 | Out-File xxx.log 把 stdout 和 stderr 一起重定向到文件再读。不要在看不到输出的情况下假定脚本成功了。
坑 3(真 bug):排行榜排序方向反了。 "不建议清单"原本取的是 bad_mags ≥ 2 的前 12 条——但列表已经按降序排过,取前 12 条等于取"坏号码里分数最高的 12 个",恰好是最不该被点名的。正确做法是按分数升序取最差的 12 个。这个 bug 让第一版报告里的清单完全反了。
坑 4(真 bug):图表标签硬编码错了。 得分分布图最高一档的标签被写成了固定的"99 分以上"——而实际分数区间是 −13.4 ~ 14.1,这个标签从头到尾就没对过。修法是把标签改成由区间上下界动态生成。
坑 5:扩展名和真实格式不一致。 交付的"CSV 明细"文件,扩展名是 .csv,实际字节是一个 xlsx 包(文件头是 PK\x03\x04,内含 xl/workbook.xml)。Excel 双击会弹"格式与扩展名不符"的警告,程序化读取则直接失败。修法是交付前用魔数校验一次文件真实类型,而不是相信扩展名。现在这份是货真价实的 UTF-8 BOM CSV;那个被误命名的文件已改名为 .xlsx 另存。
这 5 个坑里,坑 1、坑 2、坑 5 有一个共同点:它们都不报错。 脚本"成功运行"、输出"看起来正常"、文件"确实生成了"——但结果是错的。这也是我现在坚持"交付前必须校验内容"的原因:不要相信文件名,也不要相信退出码。
七、两个必须说清的边界
写这类工具,有两句话我坚持放在报告里,也放在这里。
第一,这套体系是文化体系,不是物理规律。 它"准"的机制和天气预报"准"的机制完全不同。它的断语足够宽("主变动、需注意反复来电"),哪家公司都能对上;它也没有对照组——从没统计过"号码分低的那批公司后来过得怎样"。所以它的分数适合用作决策纪律和品牌意象,不适合用来预测经营结果。我把权重全公开,很大一部分原因就是这个:能被复算的东西才能被质疑,能被质疑的东西才不至于变成迷信。
第二,真正的杠杆不在号码上。 客服号的实际效果取决于接通率、响应时效、工单闭环。而且如果某个号码在业务上已有沉淀(客户熟悉、物料已印制),更换成本应当优先于数理评分来考量——这条比任何分数都重要。
八、怎么复用到你自己的场景
这套流程不只适用于 400 号码。同一套骨架换个评测表就能用:
- 手机号 / 固话 / 门店号:换权重表即可;
- 批量命名规则校验、客户号段分层、编码合规检查:把"打分函数"换成你的业务规则;
- 任何"几百个候选、需要排序、且排序理由必须能向人解释"的任务。
关键心得就三条,跟具体业务无关:
- 把口径写进代码,而不是写进话术。 权重表公开、可复算、可质疑。
- 数据驱动 + 流程固化。 一次性脚本的价值只在那一次;固化成流水线后,第二次的成本是第一次的一小部分。
- 交付前校验,不要相信扩展名和"看起来成功了"。
本文所述方法属传统文化与民俗象数范畴的应用实践,结论仅供选号与品牌意象参考,不构成对经营结果的预测。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号