真正烧Token的不是代码,而是模型反复看同一份上下文

真正烧Token的不是代码,而是模型反复看同一份上下文
腾讯云开发者
发布于 2026-09-17 15:09:23
发布于 2026-09-17 15:09:23
开发者公众号专属群聊
扫码加入获取更多一手教程、科技前沿报告
多 Agent 工作流里,真正拉高 Token 消耗的往往不是代码本身,而是长上下文在多轮请求中被反复携带。本文结合轻量云的一次真实研发实践,拆解如何通过渐进式加载、响应级批量和批量编辑工具减少不必要的模型往返。
如果希望进一步了解本文实践所处的多 Agent 研发工作流形态,可以参考腾讯开源项目:LoopForge:https://github.com/Tencent/LoopForge
01
背景
先从 DevFlow 说起
我们轻量云团队搭建了一套多 Agent 开发工作流 DevFlow。
一个需求进入后,会依次经过方案设计、开发、代码审查、测试验证、知识沉淀和最终汇总,不同 Agent 分别负责不同阶段。
主流程可以简化为:
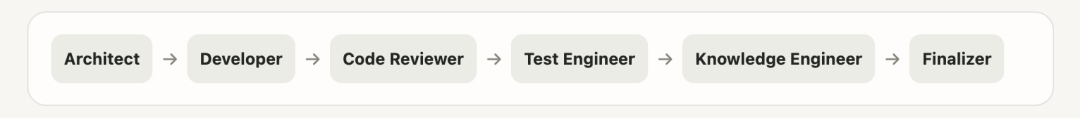
这种拆分首先解决的是职责边界:方案设计、代码实现、审查和测试由不同角色分别完成。
但实际运行一段时间以后,我们发现了另一个问题:
随着流程不断推进,上下文会逐渐增长,而 Developer、Test Engineer 又恰好是模型调用最频繁的阶段。
有一次 Developer 已经完成前期代码调研,需求信息、方案、源码片段、工具返回和阶段状态都已经进入上下文,此时窗口达到大约 120K tokens。
接下来需要完成的修改其实并不复杂:
- 修改一个 handler 的核心逻辑;
- 补充 import;
- 修改另一个 handler;
- 更新对应的报告。
如果这些动作被拆成四轮模型请求,每一轮处理的就不只是当前新增的几行代码。
实际成本更接近:
第 1 轮:已有约 120K 上下文 + 修改 A 第 2 轮:继续携带已有上下文 + 修改 B 第 3 轮:继续携带已有上下文 + 修改 C 第 4 轮:继续携带已有上下文 + 修改 D
真正新增的代码可能只有几十行,但此前积累的长上下文会继续参与后续请求。
这也是我们开始重新分析 DevFlow Token 成本的原因。
02
成本
Token 成本是怎么被放大的?
模型调用的输入成本可以粗略理解成:
总输入 Token ≈ Σ(第 i 轮已有上下文 + 第 i 轮新增内容)
因此,一条 Agent 工作流最终消耗多少 Token,主要取决于两个因素。
一是单轮上下文有多长。
源码读取、工具结果、Prompt、前置方案和阶段状态都会逐渐进入上下文。内容越多,后续每次模型调用的基础成本就越高。
二是模型调用了多少轮。
如果同一份长上下文还要继续经历更多轮请求,已经存在的内容就会在后续请求中持续参与输入。
这两个因素不能分开看。
例如一次代码探索产生了 5K tokens。
如果下一轮已经得到足够结论,这部分内容的影响比较有限;但如果它进入一个长生命周期会话,之后还要继续经历代码修改、测试和修复等十几轮请求,那么这 5K 会成为后续上下文的一部分。
同样,一个原本可以一次确定的代码修改,如果被拆成四轮,增加的也不只是三次工具调用。
真正被放大的,是:
已有长上下文 × 额外模型请求
把实际调用路径展开后,主要问题大致可以归为下面几类:
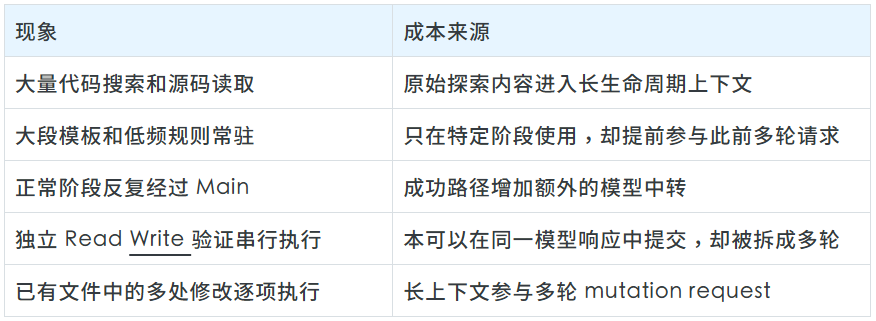
因此,这轮优化最终沿着两条主线展开:
控制信息进入上下文的时机和驻留范围。
以及:
把已经能够同时确定的动作合并提交,减少模型往返。
两者会互相放大:上下文越长,减少一次模型请求的收益越高;模型请求越多,上下文生命周期治理的效果也越明显。
03
上下文
3.1 怎样控制信息进入上下文的时机和范围?
一个需求真正进入 Developer 之前,通常已经完成了不少工作。
需要先理解需求,定位模块和接口,确认核心实现、调用关系和风险,再完成方案设计,之后才进入实际开发。
这些步骤本身不能简单删除。
问题在于:
某段信息在前一个阶段有价值,不代表它需要完整保留到后续所有阶段。
这轮我们主要从代码探索和低频规则、模版两个地方入手,同时减少正常流程中的 Main 中转。
3.2 代码探索改为短生命周期 Agent
如果直接让 Main 大规模搜索代码,搜索结果和源码片段会进入这个长生命周期会话。
而代码探索本身往往包含不少中间过程:尝试不同关键词、定位接口、追踪调用关系、读取多个源码片段,其中一部分最后甚至不会进入方案。
真正需要传给后续角色的,通常只是模块、接口、调用关系、影响范围和风险等结论。
因此,我们把代码探索委托给临时 Code Explorer。
它有几个明确限制:
- 只读,不加入常驻 Team;
- 优先使用代码索引缩小定位范围;
- 限制搜索、读取次数和单文件片段长度;
- 最终只返回不超过约 500 字的结构化摘要;
- 原始搜索结果随着临时 Agent 生命周期结束而退出。
这里没有减少必要的代码探索。
改变的是原始探索内容的生命周期:大量搜索和源码阅读停留在短生命周期 Agent 中,后续流程只继续携带压缩后的结论。
3.3 低频模板改为按需加载
另一类容易长期占用上下文的内容来自 Prompt 和 Skill。
例如 Developer 最终需要生成 change-report.md 和 API 文档,其中包含文档结构、字段要求和示例。
这些内容在最终交付阶段确实需要,但 Developer 刚开始调查代码和实现功能时,并不需要完整知道报告模板。
如果全部写在 Developer 主 Prompt 中,它们会参与整个开发阶段:
阅读代码时存在,修改代码时存在,运行验证时存在,修复问题时仍然存在,直到最后写报告时才真正发挥作用。
因此,我们把这部分内容改成渐进式加载。
Developer 主 Prompt 只保留路径、触发条件和流程骨架;实现与验证完成以后,再读取 developer-deliverables.md 中的报告和 API 文档模板。
Skill 也采用同样原则:入口只保留职责、选择条件和执行骨架,详细模板、边界规则和低频场景下沉到 assets/、references/,进入对应阶段时再按需读取。
这里的关键不是把一个大 Markdown 拆成几个小文件。
如果拆完以后仍然在启动时全部读取,Token 成本并不会因此下降。
真正需要判断的是:
- 当前阶段是否必需;
- 是否只使用一次;
- 是否能够通过明确的触发条件按需加载;
- 外移以后 Agent 是否仍然能够在正确的阶段找到它。
也就是说:
重点不是“内容放在哪”,而是“内容什么时候进入上下文”。
3.4 减少正常流程中的 Main 中转
上下文之外,工作流的阶段流转本身也会产生额外模型调用。
原来的正常路径会反复经过 Main。
例如:
Architect → Main → Developer
Developer 完成以后,又会:
Developer → Main → Code Reviewer
正常情况下,这些阶段之间的方向其实已经比较明确。
Architect 正常完成后,下一步就是 Developer;Developer 正常完成后,下一步就是 Code Reviewer。
如果每一站都先返回 Main,就会增加一次 Main 的模型请求,同时 Main 自己的上下文也会随着中转次数继续增长。
因此,正常成功路径改成直接流转:
Architect → Developer → Code Reviewer → Test Engineer → Knowledge Engineer → Leader
这里的“直接流转”并不是把流程改成硬编码状态机。
实际派发仍然由当前 Agent 按照工作流约定发起,也就是说仍然依赖 LLM。
变化只是正常情况下不再要求每一阶段先回到 Main,再由 Main 中转。
Main 主要保留在:
- 阶段失败;
- 重试判断;
- 人工门禁;
- 协议异常;
- 工作流完成。
因此,这项优化减少的是成功路径中不必要的模型往返,以及 Main 因反复中转产生的额外上下文和调用成本。
做到这里,我们已经降低了部分单轮成本,也减少了一部分阶段之间的模型调用。
但 Developer 和 Test Engineer 内部还有另一类更高频的往返没有解决。
即使 Developer 当前已经有 120K tokens 的上下文,如果多个已经确定的操作仍然被拆成多轮请求,这份长上下文还是会反复参与模型调用。
04
往返
4.1 已经能够同时确定的操作,为什么还要拆成多轮?
Developer、Test Engineer,甚至 Architect 内部,都会连续执行很多 Read、Write 和验证操作。
这些工具调用并不总是存在前后数据依赖。
例如 Architect 已经完成方案设计以后,需要同时生成:
tech-design.mdexecution-plan.md
两个文件的内容此时都已经可以确定,并不存在“必须先写完第一个,才能知道第二个怎么写”的关系。
实际运行中,模型能够在同一轮响应中发起多次工具调用。
例如一次模型请求里,可以连续执行两次 write_to_file,分别写入 tech-design.md 和 execution-plan.md。
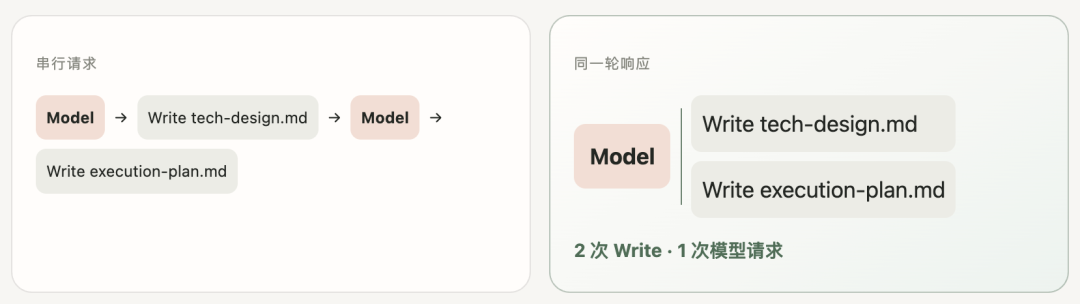
工具调用仍然是两次,但中间不再需要多一次模型请求。
因此,我们在 Prompt 中明确要求:
多个读取、写入或验证操作已经能够同时确定,并且彼此不存在数据依赖时,应尽量在同一轮模型响应中提交。
这种方式不仅用于 Write。
如果已经确定需要读取多个互相独立的文件,也尽量在同一轮发起多个 Read;多个无依赖的搜索同理。
验证阶段也可以进行类似合并,例如多个包的独立验证通过组合命令集中执行。
这里需要区分批量和并行。
宿主是否真正并行执行多个工具,并不是这个优化依赖的前提。
我们真正关心的是:
能否用一次模型响应表达多个已经确定的操作。
我们的实际应用包括:
- Architect 同时加载设计与执行计划 Skill,并生成两份产物;
- Test Engineer 同时组织单测、E2E 脚本、注册入口和报告修改;
- 多个新文件通过同一响应里的多次
write_to_file创建; - 多个包的独立验证集中执行;
- 无数据依赖的读取和搜索尽量成组发起。
这可以理解成响应级批量。
但已有文件中的多处修改,还存在另一个问题。
4.2 为什么已有文件的多处修改还需要工具级批量?
原生 replace_in_file 的接口很简单:
replace_in_file(file_path, old_str, new_str)
一次只能表达一个替换。
当 Developer 已经明确知道四处都需要修改时,很容易出现:
- 第一次请求修改核心逻辑;
- 第二次请求补 import;
- 第三次请求修改另一个 handler;
- 第四次请求更新报告或状态文件。
如果上下文只有几千 tokens,这可能只是多几轮调用。
但当 Developer 的上下文已经达到 120K:
减少一次 mutation request,节省的不只是一次编辑工具调用,更重要的是减少一次长上下文参与模型请求。
CodeBuddy 偶尔也可能在一轮模型响应中生成多个 replace_in_file 调用,但这不是一个可以稳定依赖的调用方式,且 CodeBuddy 明确不支持这种调用方式。
而且即使一次响应中提交了多个独立 replace_in_file,这些修改仍然分别执行:
- 每项独立匹配;
- 每项独立落盘;
- 某一项失败时,之前的修改可能已经完成;
- 整组修改没有统一的预校验和回滚。
因此,仅靠 Prompt 要求“多调用几次 Edit”还不能完整解决这个问题。
4.3 Prompt 能改善行为,但不能提供确定性
我们先后在全局规则、工具描述、Developer Prompt 和 execution plan 中要求:
- 写入前先完成调研;
- 已知修改尽量合并;
- 不要按照单个位置逐项修改;
- 没有数据依赖的修改在同一轮提交。
这些方式可以提高批量行为出现的概率,但没有改变工具本身的能力边界。
因此,批量编辑最后形成了三层分工:
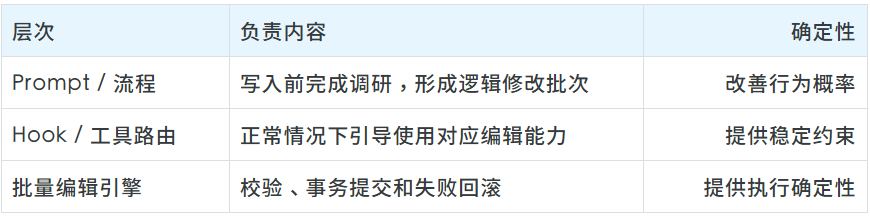
下一步的问题,就变成了:
批量编辑工具到底应该长什么样?
05
选型
为什么没有直接迁移 Codex 的 apply_patch?
既然需要已有文件的批量编辑,第一个考虑的自然是 Codex 的 apply_patch。
它原生支持:
- 同一文件多处修改;
- 多文件修改;
- 新增、删除和移动文件;
- 在一个 Patch 中表达关联变更。
从能力上看,它正好可以消除逐位置调用。
因此第一次尝试,我们直接迁移了 apply_patch 的执行能力。
实际接入 CodeBuddy 以后,调用成功率却并不理想。
Codex 中的 apply_patch 是模型熟悉的 freeform 工具,且 GPT 系列模型可能本就单独针对 apply_patch 进行过训练,因此 Codex 本身调用该工具并没有问题。
但将它迁移成 CodeBuddy 的 MCP 以后,模型需要同时正确处理:
MCP JSON 参数转义 + Patch 自定义语法
实际出现过的失败包括:
Add File内容遗漏+;Update File上下文行遗漏前导空格;@@写成解析器不接受的结构;- 大 Patch 中某一行前缀错误导致整个事务失败;
- JSON 中大量换行、引号和反斜线增加额外生成负担。
我们也尝试过给服务端增加容错。
部分错误可以安全修复。
例如 Add File 中所有正文都只有“新增”一种含义,所以缺少 + 时可以补齐。
但 Update File 不一样。
一行缺少前导符号时,它既可能是上下文,也可能是模型原本想新增的一行。
继续放宽解析,就不再是在修复格式,而是在猜测修改意图。
这次尝试让我们重新确认了实际需求:
- 新文件已经可以继续使用
write_to_file; - 文件移动和删除不是高频操作;
- 最大成本来自一个或多个已有文件中的多处精确修改;
- CodeBuddy 已经熟悉
old_str/new_str语义。
因此目标从:
迁移完整的 apply_patch
收敛成:
把原生 replace_in_file(file_path, old_str, new_str) 向量化,一次调用包含多个多行替换。
工具协议应该适应目标 Agent 已经熟悉的行为,而不是为了复刻另一个工具而保留所有能力。
06
批量
6.1 replace_batch:从响应级批量到工具级批量
前面的响应级批量解决的是:
一次模型响应能不能表达多个独立操作。
replace_batch 进一步解决的是:
多个已有文件修改能不能被定义成一次完整的工具操作。
最终实现的协议很简单:
{
  "replacements": [
    {
      "file_path": "/absolute/path/handler.go",
      "old_str": "旧代码块 1",
      "new_str": "新代码块 1"
    },
    {
      "file_path": "/absolute/path/handler.go",
      "old_str": "旧代码块 2",
      "new_str": "新代码块 2"
    },
    {
      "file_path": "/absolute/path/another_handler.go",
      "old_str": "旧代码块 3",
      "new_str": "新代码块 3"
    }
  ]
}
old_str 和 new_str 都可以是多行文本。
对于模型来说,并不需要学习新的 Patch DSL。
它只是把原本准备分多次提交的 old_str/new_str 参数放进一个数组。
复杂的部分由工具负责。
6.2 所有替换都基于调用开始时的原始快照
同一文件中的 replacement 不会按照“改一项、再基于新文件改下一项”的方式执行。
工具首先读取原始文件,然后:
- 在原始内容中定位所有
old_str; - 检查每项是否恰好匹配一次;
- 检查修改区间是否重叠;
- 从后向前生成新的文件内容。
这样可以避免前一个 replacement 改变文本偏移量,也避免后一个 replacement 依赖前一个 replacement 新生成的内容。
如果两项修改相邻或重叠,就要求模型把它们合并成一个更大的 replacement。
6.3 批量修改必须保证事务性
如果多个独立 replace_in_file 做到第三项才失败,前两项可能已经落盘。
代码会停在一个只完成部分修改的状态。
因此,replace_batch 在真正修改目标文件前会先完成整批检查:
- 路径必须是绝对路径;
- 目标必须是已经存在的普通 UTF-8 文本文件;
- 每个
old_str必须恰好匹配一次; - 同一文件中的替换区间不能重叠;
- 请求大小、文件数和 replacement 数不能超过限制;
- 所有文件先写入同目录临时文件并执行
fsync; - 正式替换前再次检查文件是否在调用期间发生变化;
- 任一写入失败时,根据原始快照执行回滚。
也就是说,执行过程是:
全部读取与校验 → staging → 检查并发变化 → 统一替换 → 失败时按快照回滚
这不仅减少了调用次数,也解决了多个独立 replace_in_file 无法保证的一致性问题。
6.4 批量不是越大越好
增加批量能力以后,另一个容易出现的误区是:
一个任务是不是应该尽可能只调用一次编辑工具?
并不是。
批次边界应该由:
这些修改能不能基于同一份代码状态同时确定和验证
决定。
如果后一组修改必须等待:
- 编译或测试结果;
- 实际 Diff;
- 新读取的代码;
- Code Review 结果;
那么它们本来就应该进入下一批。
强行合并尚未确定或相互依赖的修改,会降低成功率,也会扩大一次失败的影响范围。
6.5 让 Developer 在第一次写入前先收敛修改范围
工具支持批量,并不意味着模型自然会批量使用。
如果 Developer 找到第一个修改点以后立即开始写,那么 replace_batch 里仍然可能只有一个 replacement。
因此,我们重新定义了首次写入前的调研结束条件。
Developer 需要先检查:
- 核心实现;
- 直接调用方;
- import、常量和辅助函数;
- 接口契约与响应语义;
- 配置和初始化逻辑;
- 当前实现能够直接推导出的关联修改。
只有实现路径和影响范围基本收敛以后,才进入首次写入。
批次也不再按文件划分。
“先修改企业版 handler,再修改管理端 handler”本质上仍然是把文件当成执行边界。
如果两个 handler 的修改已经能基于当前代码状态一起确定,就应该进入同一个逻辑批次。
正常节奏变成:
调研并收敛 → 一次批量写入 → 检查 Diff → 验证 → 基于新证据进行下一批修复
第二次 mutation 应该来自新的证据,而不是补做第一次调用前已经明确知道的修改。
6.6 用 Hook 把批量编辑变成默认路径
只在 Prompt 中要求“禁止单点编辑”仍然属于软约束。
因此我们增加了 PreToolUse Hook。
当 Developer 尝试调用 replace_in_file 或 Edit 时,Hook 会引导它使用 replace_batch。
但这个硬约束必须有降级路径。
如果 MCP 因 Python 版本、文件缺失或者启动异常不可用,而 Hook 仍然无条件拒绝原生编辑,整个开发流程就会被锁死。
所以 Hook 在阻断前先进行一次轻量探活:
启动 replace_batch MCP → initialize → tools/list → 确认暴露 replace_batch
探活成功:
拒绝单点编辑,使用 replace_batch
探活失败或 2 秒超时:
fail-open,允许原生编辑工具降级执行
原因很明确:
批量编辑属于成本优化,而不是安全边界。工具不可用时,保证任务继续完成比强制节省 Token 更重要。
07
结果
7.1 这一轮优化最终带来了多少收益?
为了验证这些优化最终能否反映到完整开发流程,我们选取了轻量云业务中的一个真实中大型需求。
需求涉及 6 个 HTTP 接口改造,完整经过代码探索、方案设计、开发、代码审查、测试、知识沉淀和最终汇总。
我们分别记录了 Claude Opus 5 和 GLM 5.2 的完整流程数据。
其中 GLM 5.2 在优化前和优化后各执行两轮,再取平均值。
Agent 的探索路径本身具有随机性,所以这组实验主要用于观察优化方向和量级,而不是比较模型能力。
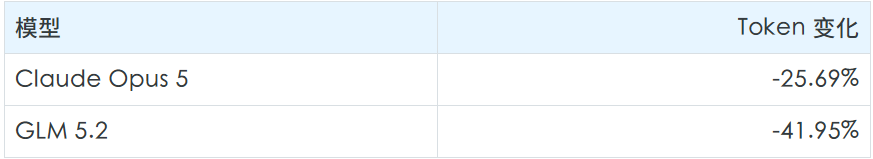
先看完整流程:
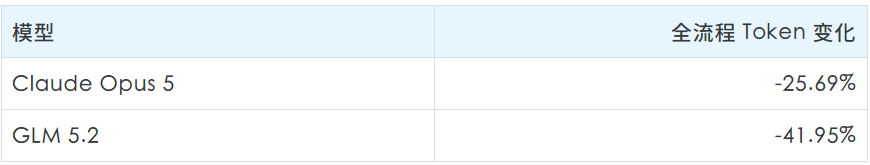
两个模型的幅度差别不小,但完整流程 Token 都明显下降:
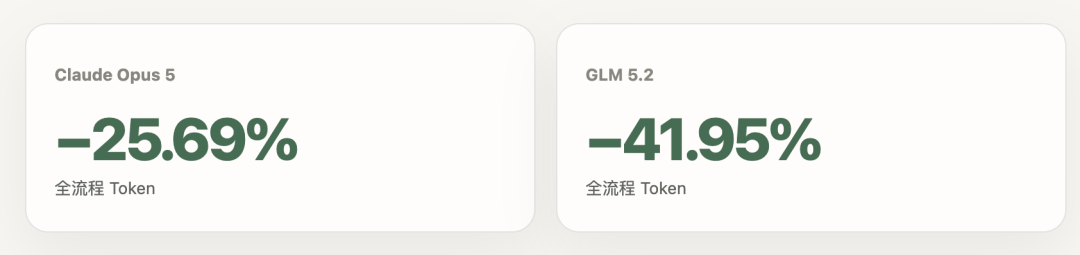
因此,比总数更值得看的,是变化究竟发生在哪些阶段。
7.2 Claude Opus 5:Test Engineer 单阶段减少约 4.69M Tokens
Claude Opus 5 的完整阶段数据如下:
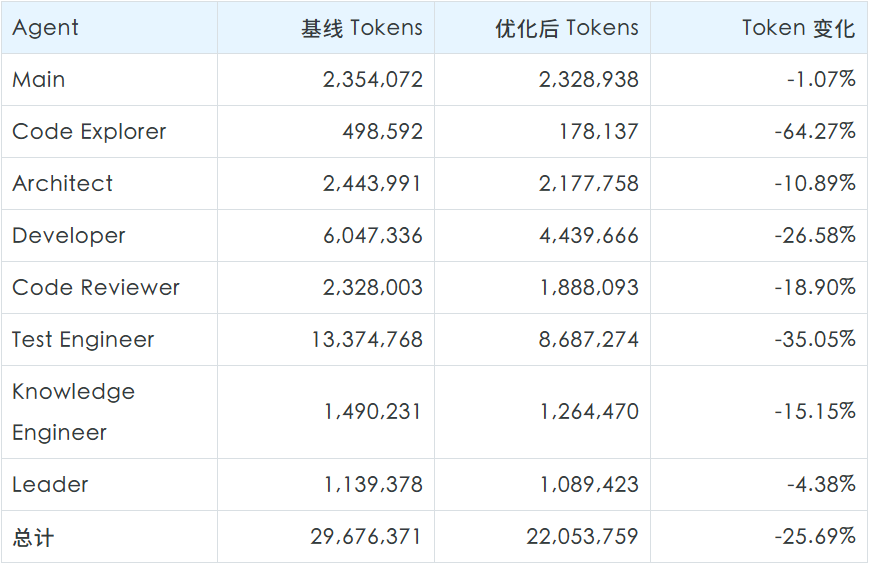
最明显的阶段是:
- Developer:-26.58%
- Test Engineer:-35.05%
其中 Test Engineer 原本就是整条 Claude 流程里 Token 消耗最高的阶段。
它从 13,374,768 降到 8,687,274,单阶段减少约 4.69M Tokens。
Developer 则从约 6.05M 降到 4.44M Tokens,下降 26.58%。
这两个阶段恰好对应本轮优化作用最直接的位置:代码探索的上下文生命周期,以及开发、测试阶段的高频读取、修改和验证。
7.3 GLM 5.2:Developer 下降 62.94%,Test Engineer 下降 50.47%
GLM 5.2 的数据在优化前、优化后各运行两轮,以下为平均值:
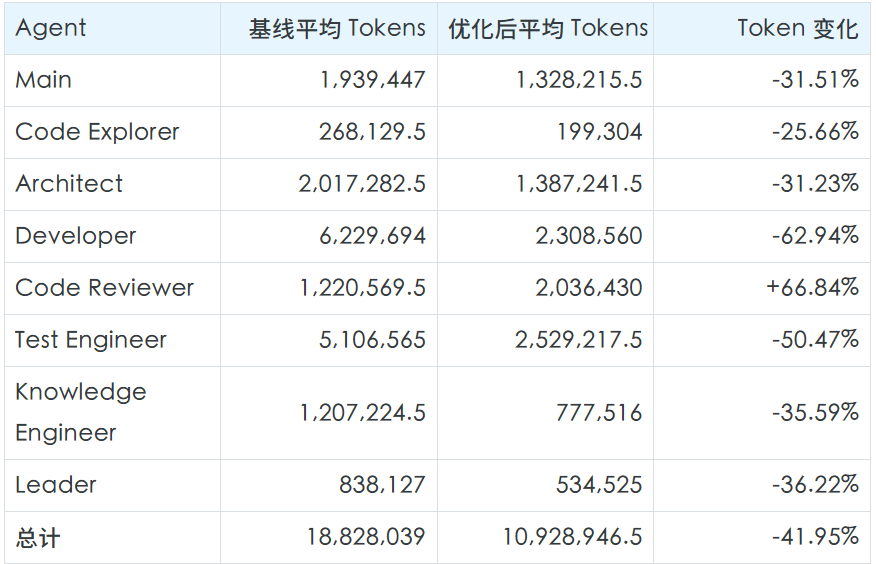
GLM 上最明显的仍然是两个高频修改阶段。
Developer
6.23M → 2.31M Tokens,下降 62.94%
Test Engineer
5.11M → 2.53M Tokens,下降 50.47%
两者都是大量发生读取、写入、测试和修复的阶段,也正是响应级批量和 replace_batch 主要发挥作用的位置。
7.4 两个模型放在一起看
如果只看完整流程:
如果只看最典型的两个高频修改阶段:
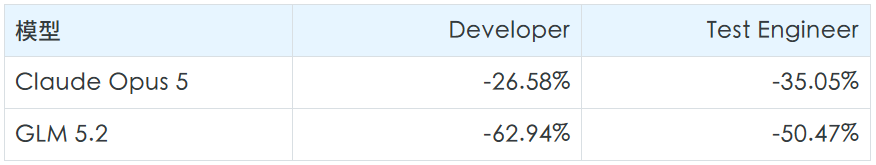
两个模型的绝对幅度差别很大,因此不适合把某个数字写成固定收益承诺。
但方向是一致的:
Developer 和 Test Engineer 这类高频读取、修改、测试和修复阶段,是本轮 Token 下降最明显的位置之一。
在这次涉及 6 个接口的真实需求中,完整流程 Token 分别下降 25.69% 和 41.95%。
这比“接入某一个工具能省多少”更有意义,因为本轮实际改变的是整个执行链路,而不是某一个单独工具的输出长度。
7.5 从 Token 优化回到 Harness 设计
回头看,这轮优化没有减少需求分析、方案设计、代码审查和测试,也没有要求模型减少必要的分析。
真正调整的是两类东西。
第一,信息的生命周期。
代码探索放进短生命周期 Agent,低频模板按阶段加载,尽量避免与当前判断无关的信息长期驻留。
第二,已经确定动作的表达粒度。
多个独立 Read、Write 和验证可以在同一模型响应中提交;已有文件中的多处关联修改则进一步通过 replace_batch 下沉成工具级批量能力。
再往下,执行引擎负责:
- 原始快照;
- 精确匹配;
- 预校验;
- 事务写入;
- 失败回滚。
运行时 Hook 则负责默认工具路由、探活和故障降级。
replace_batch 是这一轮最显眼的工程产物,但真正值得复用的并不是这个名字。
而是一条更普遍的 Harness 设计原则:
模型擅长判断应该做什么;当一组动作已经确定后,工具和运行时负责稳定地把它执行出来。
Prompt 适合描述目标、条件和执行原则。
对于“同一轮多 Read / Write”这种模型已经具备的能力,可以通过 Prompt 明确使用方式。
但如果某种行为已经关系到成本、质量或流程稳定性,仅靠 Prompt 提高发生概率还不够,就需要继续下沉到工具协议、Hook 和执行引擎。
回到最开始那个 120K 上下文。
实际需要修改的代码可能只有几十行。
真正昂贵的不是这几十行代码本身。
而是一个本可以用更少模型请求完成的任务,被拆成多轮以后,同一份长上下文需要一次又一次参与后续调用。
-End-
原创作者|胡锦康
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-17,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号