2.4K Star!BrowserAct 团队开源了一套 Skill,让 AI Agent 真正「上网」!

2.4K Star!BrowserAct 团队开源了一套 Skill,让 AI Agent 真正「上网」!
开源星探
发布于 2026-06-23 17:46:33
发布于 2026-06-23 17:46:33
最近,BrowserAct 团队开源了一套 Skill,专门解决 AI Agent 自动化操作浏览器或抓数据时,经常被各种反爬机制拦截,比如验证码、人机验证等。
这个 SKill 把这些问题串起来做成了一个完整的流水线。
项目简介
BrowserAct Skills 是由新加坡 ECOCREATE TECHNOLOGY PTE. LTD. 旗下 BrowserAct 团队开源的一套 AI Agent 浏览器技能工具集,主打为各类大模型 AI 智能体赋能真实浏览器操控能力。
目前项目在 GitHub Star 已突破 2.4K,发展速度相当快。
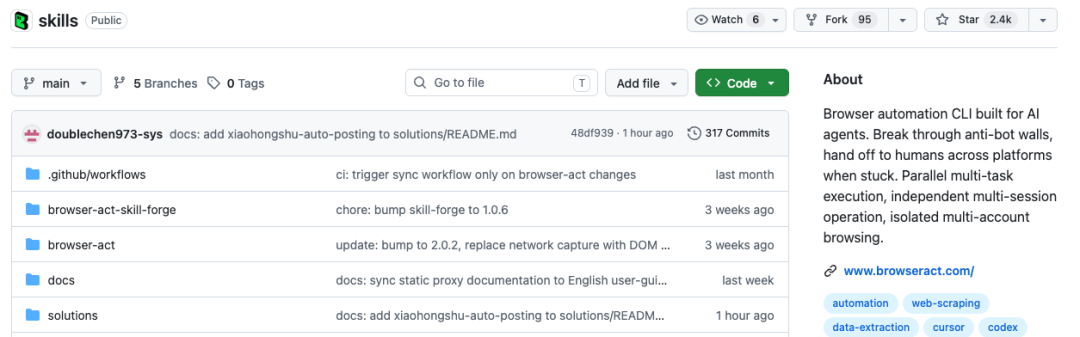
项目整体拆分为两大独立可安装的子组件:
- •
browser-act:即时浏览器执行模块,充当 AI Agent 的"浏览器手脚",内置 50+ 标准化浏览器操作指令 - •
browser-act-skill-forge:技能工厂生成模块,面向周期性重复网页任务,实现"单次调试、永久复用"
核心解决的行业痛点很明确:传统 AI Agent 只能读取静态文本,无法操作带登录态、反爬校验、动态渲染的网页。
BrowserAct 让 Claude Code、Cursor、OpenCode、OpenClaw、Gemini CLI、Codex 等主流代码型、对话型 AI Agent,依靠自然语言指令就能直接操控实体浏览器完成网页交互任务。
区别于传统 Puppeteer、Playwright 需要人工编写代码实现自动化,BrowserAct 以自然语言驱动 + 浏览器原生会话复用 + 技能沉淀复用为产品内核,把复杂的浏览器操作封装为标准化 Skill 指令,大幅降低了 AI 上网自动化的开发与使用门槛。
核心亮点
这是 BrowserAct 最有辨识度的设计。它不是只做一件事,而是把反爬做成了渐进式的三层防御体系,一层解决不了就自动进入下一层:
层级 | 能力 | 作用 |
|---|---|---|
环境层 | 指纹伪装 + TLS 轮换 + 代理切换 | 让 90% 以上的反爬检测根本不触发 |
执行层 | solve-captcha 自动破解 + stealth-extract 零配置提取 | 真遇到验证码也能自己过 |
人类层 | remote-assist 生成一个可访问链接 | AI 搞不定时,让人类扫码/手动完成,Agent 无缝继续 |
这种设计思路很聪明。它不追求 AI 自己搞定一切 ——那在目前技术条件下既不现实也不安全——而是承认 AI 有解决不了的问题,把人类作为最后一层安全网融入到自动化流程中。
功能特性
1)三种浏览器模式,按需选用
不是所有场景都需要"隐身模式"。BrowserAct 根据真实使用场景提供了三种模式:
① chrome 模式(复用本地 Chrome 登录态)
适合需要登录的后台任务场景。Agent 连接到你本地正在运行的 Chrome 实例,继承你的真实用户代理、GPU 渲染、浏览历史,还有最重要的——cookie、登录态、浏览器扩展。你的 Gmail 会话、LinkedIn 登录态、公司 SSO token,都能直接用。
这解决了一个核心痛点:AI Agent 启动的新浏览器会话从 0 开始,什么登录态都没有,后台系统根本进不去。
② stealth 隐私模式(每次会话全新指纹 + 代理轮换)
适合批量爬取、不想留下任何痕迹的场景。每次启动一个全新指纹,配合代理轮换,会话结束后零残留。
③ stealth 固定身份模式(稳定指纹 + 稳定 IP + 稳定账号身份)
适合多账号并行运行的场景。保持账号身份稳定但又不被识别为机器人,同时实现多账号隔离。
2)零干扰并发
多浏览器并行时,每个任务的 cookie、指纹、代理完全隔离,网站无法关联不同账号。同浏览器多会话时,共享登录态但独立执行,任务之间不阻塞。
这在批量跑数据时特别重要。以前你同时开几个窗口跑,网站一看 cookie 和指纹都是同一份,直接认定是同一个人,轻则限流重则封号。现在每个任务有独立的"身份",相互之间不干扰。
3)为大模型优化的输出格式
BrowserAct 不把整份 HTML 丢给 LLM,它返回的是带索引的精简文本格式,比传统 JSON/HTML 省好几倍 Token。这是官方测试的数据:
页面类型 | 原始 HTML Tokens | 经过 Skill 后 | 节省率 |
|---|---|---|---|
Amazon 商品页 | ~55,000 | ~2,500 | 95% |
LinkedIn 资料 | ~35,000 | ~2,000 | 94% |
SaaS 仪表盘 | ~40,000 | ~3,500 | 91% |
交互方式也做了优化。state 命令返回一个带编号的可交互元素列表,然后 click 3 或者 input 2 "内容" 就能直接操作,完全不需要 DOM 解析。这对 AI Agent 来说太友好了——它不需要理解复杂的 HTML 结构,只需知道编号就行。
4)50+ 标准化浏览器操作指令
browser-act 模块内置了 50+ 指令,覆盖了全场景网页交互需求:
- • 基础页面操作:打开/关闭标签页、页面跳转、元素点击、文本输入、页面滚动、悬停选择、全页/局部截图、PDF 导出
- • 数据捕获能力:抓取 XHR/Fetch 异步接口、捕获 HAR 网络日志、结构化清洗页面数据、过滤广告/冗余 DOM 节点
- • 会话与登录管理:复用本地 Chrome 原生 cookie、账号登录态、浏览器扩展配置
- • 反爬与验证码处理:三层反检测架构绕过网站 Bot 拦截、自动解析滑块/图形验证码、
remote-assist远程扫码辅助登录 - • 多标签管控:标签命名分组、自由切换标签、隔离独立浏览器会话
5)Skill Forge:让 AI 自动探索网站,生成可复用的抓取脚本
browser-act-skill-forge 是另一个很实用的组件。它的逻辑是这样的:
- 1. 你告诉 AI:"帮我做一个从 LinkedIn 抓取职位的 Skill,要提取标题、公司、薪资、URL,以后我要跑 300 个关键词。"
- 2. Skill Forge 自动探索一次该网站结构,发现它的 API 和数据模式
- 3. 生成一个可部署的 Skill 包,以后批量跑数据不用重新探索
也就是说,它把"探索-验证-固化"做成了流水线。第一次跑是发现,之后都是稳定执行。
官方已经用 Skill Forge 生成了 30+ 预制 Skill,覆盖 Amazon、Google Maps、YouTube、Reddit、微信、知乎等主流平台,装上就能用。
安装方式
告诉 AI Agent 安装(推荐方式,因为是设计给 Agent 用的):
"Install browser-act. Skill source: https://github.com/browser-act/skills/tree/main/browser-act. Verify it works after installation."
如果要安装 Skill Forge:
"Install browser-act-skill-forge. Skill source: https://github.com/browser-act/skills/tree/main/browser-act-skill-forge. Verify it works after installation."
也可以手动安装:
# 克隆仓库
git clone https://github.com/browser-act/skills.git
cd skills
零配置使用,一行命令搞定:
browser-act stealth-extract https://example.com完整浏览器自动化流程:
# 启动一个命名会话(命名确保并发时不冲突)
browser-act --session my-task browser open <id> https://example.com

# 查看可交互元素(返回带索引的列表,不需要解析 DOM)
browser-act --session my-task state

# 按编号点击 / 输入(对 AI Agent 友好,不需要理解 HTML 结构)
browser-act --session my-task click 3
browser-act --session my-task input 2 "hi"
写在最后
BrowserAct 让 AI Agent 的浏览器自动化能在真实的 web 环境中稳定跑通。
项目还在快速发展中,目前 GitHub 已获 2400+ stars。如果你也被反爬和验证码困扰过,不妨可以尝试一下。
GitHub:https://github.com/browser-act/skills
如果本文对您有帮助,也请帮忙点个 赞👍 哈!❤️
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-06-13,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号