腾讯混元 & 东京工业大学 无损 KV 缓存压缩至2% ,护航大型语言模型推理!

腾讯混元 & 东京工业大学 无损 KV 缓存压缩至2% ,护航大型语言模型推理!
未来先知
发布于 2024-12-27 20:05:46
发布于 2024-12-27 20:05:46
大型语言模型在多个领域都改变了数据处理方式,其中在扩展上下文推理方面的能力得到了显著认可。 为了加速推理,保持一个关 Key-Value (KV)缓存内存是必要的。 然而,对KV缓存内存的需求不断增长,这对高效的实现带来了巨大挑战。 本工作介绍了一种新颖的架构,即跨层潜在注意力(CLLA),旨在将KV缓存压缩到原大小的不到2%,同时保持可比的性能水平。 CLLA将KV缓存压缩的多个方面,包括注意力头/维度减少、层共享和量化技术,集成到一个一致的框架中。 作者的广泛实验表明,CLLA在大多数任务上实现了无损性能,同时使用了最小的KV缓存,这标志着在实际KV缓存压缩方面的重大进步。
1 Introduction
大型语言模型(LLMs)已在各个领域广泛应用并得到验证,改变了作者收集和处理信息的方式,并影响了作者的日常生活。Driess等人(2023年);Zhang等人;Zhu等人;Wang等人(2024年)。最近,LLM的长文本推理和理解能力逐渐被认为对其能力至关重要,引起了越来越多的关注。开源和闭源LLM现在都在努力适应更长的 Token 长度,Achiam等人(2023年);DeepSeek-AI(2024年)。然而,这种长度扩展对LLM提出了关键的效率挑战,特别是与日益增长的键值(KV)缓存内存问题,这给更强大的LLM的部署带来了巨大的障碍。KV缓存技术,涉及从解码器仅有的Transformer多头自注意力(MHA)块(Vaswani等人,2017年)中缓存和重用已计算的键值向量,在大多数解码器仅有的LLM中广泛采用,以加速模型推理速度。
然而,这种方法以增加GPU内存使用为代价,被认为是大多数解码器仅有的LLM的默认配置。解决日益增长的KV缓存问题可以为其他高性能但内存密集的技术释放GPU内存,或减轻与关键参数(如批处理大小和 Token 长度)相关的限制,这对部署更有效的LLM至关重要。
随着LLM大小的快速增长,许多研究开始关注KV缓存扩展的问题,并提出各种解决方案。KV缓存总体大小与多个因素有关,包括注意力头数量、层数、每个头维数以及序列长度。为了提高Transformers中的MHA效率,Shazeer等人(2019年)提出了多 Query 注意力(MQA)以及Ainslie等人(2023年)提出的组内 Query 注意力(GQA)等方法,通过减少KV头数量来降低KV缓存需求。此外,多头潜在注意力(MLA)已经开发出来,通过低秩KV联合压缩来缓解性能退化,如DeepSeek-AI。这些方法主要关注注意力头和维数方面。相反,另一组方法专注于减少参与KV缓存的层数。YOCO等人提出了一种解码-解码架构,线性注意力压缩缓存到单层。类似地,CLA等人(2024年)和MLKV等人(2024年)在相邻层之间共享KV激活,重用较早层的KV缓存。此外,KV量化技术引起了广泛关注,如Hooper等人(2024年)和Liu等人(2024年)。
尽管取得了这些进展,但现有的解决方案在面临显著的KV缓存压缩比时,往往会导致LLM性能降低。此外,大部分研究都倾向于关注KV缓存压缩的单个方面,而不是有效地将多种策略集成到一个连贯的架构中,这在实践中既高效又非同寻常。
在这项工作中,作者提出了一种名为 Cros-Layer Latent Attention (CLLA) 的架构,用于LLM中的KV缓存压缩。作者的目标是将KV缓存压缩到不到其原始大小的2%,同时保持可比性能水平。在CLLA中,作者探讨了将各种KV缓存压缩方法的方面集成到一个统一和稳定的框架中的潜力。具体而言,作者通过注意力头/维度方面、层方面和量化方面共同解决KV缓存压缩,并探索各种可能的组合以实现无损KV缓存压缩。
广泛的结果证明了作者的CLLA-quant:LLMs可以在大多数任务上实现无损性能,同时仅使用不到2%的原生KV缓存。作者对不同CLLA变体的探索进行了深入分析。
本工作的主要贡献如下:
- 作者提出了CLLA和CLLA-quant,这是一种用于KV缓存压缩的新颖架构,它智能地将头/维度、层和量化方面集成在一起。
- 作者探索了CLLA的各种变体以获得更好的性能。据作者所知,CLLA是第一个实现无损压缩比低于2%的KV缓存压缩比架构。
- 作者对各种KV缓存压缩方法的深入探索和分析进行了广泛研究,这可能对未来研究和实际应用产生启示。
- 作者希望作者的简单而有效的CLLA能促进LLM社区的发展。
2 Related Works
Large Language Models
最近,由于其在各种领域(包括自然语言处理和多模态任务)的强大性能,基于 Transformer 的模型引起了广泛关注。例如,OpenAI 等人(2023)的 GPT-4 和 AI@Meta 公司的 LLaMA3 等大型语言模型在自然语言处理任务上取得了显著的成果。
然而,传统的解码器架构在训练和在线推理过程中产生了巨大的成本。为了解决这个问题,Palm Chowdhery等人(2023)和StarCode Li等人(2023)利用MQA Shazeer(2019),其中所有注意力头共享一组KV。这种方法旨在减少与注意力机制相关的计算开销。LLaMA2 Touvron等人(2023)在其注意力块内采用了一种不同的策略,通过将 Key 和Value (GQA)分组(Ainslie等人,2023),在推理过程中最小化KV缓存。同时,它增加了 FFN 的隐层大小,以保持模型性能。FlashAttention Dao 从GPU I/O操作的角度优化了训练和推理效率。这种方法特别针对GPU架构中数据移动和计算的 Bottleneck 。Mixture-of-Experts模型Jiang等人(2024);Muennighoff等人;Wang等人利用稀疏架构实现了性能的提升。
KV Cache Compression
过去的研究利用了减少注意力头维度和采用低秩矩阵近似等技术来提高模型效率。一些最近的工作通过降低层维度来减少KV缓存,如Wu和Tu(2024);Zuhri等人(2024);He和 Wu ;Liu等人(2024)。值得注意的是,Yu等人通过最小化MHA到GQA转换中的错误有效压缩了模型,同时保持了与RoPE(Su等人,2023)的兼容性。一些研究努力集中在通过减少序列长度来降低KV缓存需求,采用如token dropping;Li等人;Xiao等人;Shi等人和 prompt compression;Chuang等人(2024)等方法。然而,这些方法通常会导致性能显著下降。
最近,许多研究努力都采用了量化压缩来减少KV缓存,从而提高推理效率。Banerjee等人、Wu等人、Yang等人(2024年)、He等人(2024年)和 Liu 等人的研究工作都主要关注推理。
相比之下,作者提出了CLLA-quant方法,在训练和部署期间使用4位整数对KV缓存进行量化。Kang等人(2024年)利用低秩矩阵和低精度量化实现了近无损的4位KV缓存压缩。Coupled Quantization(Zhang等人,2024年)将多个KV通道编码到低位代码中。KIVI(Liu等人,2024年)分别对通道和 Token 维度上的 Key和Value 进行量化。
这些工作主要集中在推理方面。相比之下,作者提出了CLLA-quant方法,在训练和部署期间使用4位整数对KV缓存进行量化。
3 Methodology
Preliminary of KV Cache
目前,Transformer模型是最常见的LLM架构。它由多个堆叠在一起的区域组成。每个区域包括一个注意力层和一个MLP层。多头自注意力(MHA)(Vaswani等人,2017)是注意力层的一个典型设计。给定序列隐藏状态 ,每个 Head 的计算如下:
, , 和 是头 的权重矩阵,其在 中。 表示头的数量。 表示计算缩放点积注意力(Vaswani等人,2017年)。
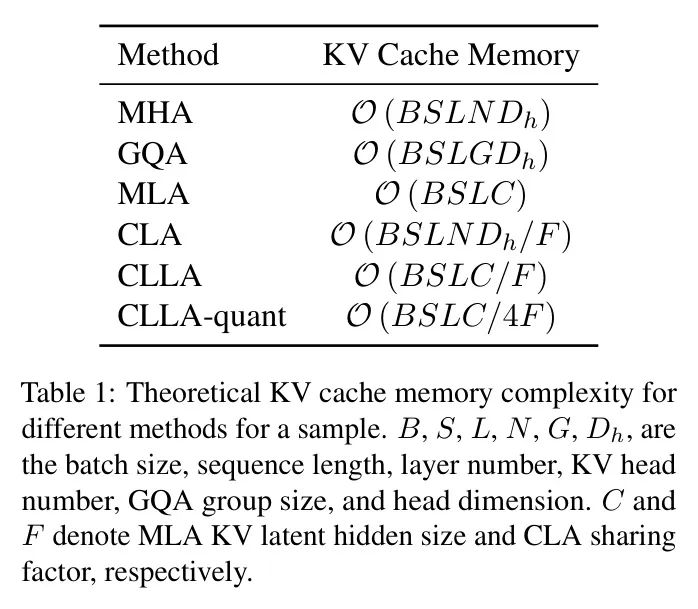
为了提高自回归解码的速度,必须存储前一次输入隐藏状态的关 Key和Value 向量(和)。在Transformer中,KV缓存所需的内存受到多个参数的影响:批量大小(),层数(),序列长度(),注意头数(),以及每个头()的维度。这种依赖关系可以表示为:
经典方法如GQA(Ainslie等人,2023年)、MLA(DeepSeek-AI,2024年)和CLA(Brandon等人,2024年)通常从、和方面压缩KV缓存,如表1所示。在本工作中,作者努力同时考虑所有这些方面以实现性能无损的KV缓存压缩。
CLLA: CLA Meets MLA
CLLA 涉及将 KV 缓存压缩成低秩潜在状态,并允许多个层共享这些状态。该研究的关键要点在于如何有效地跨层共享压缩后的潜在状态。
首先,作者将注意力层的输入隐藏状态投影到低秩潜在状态,用表示:
这一方法可以实现显著的压缩,因为只需要缓存潜在状态,而不是整个 Key 和值向量。在注意力计算期间,作者将潜在状态恢复为标准的 Key -值表示。
后续,作者计算 Query 向量以进行注意力计算。为了方便使用RoPE,作者创建了两个额外的较小 Query 向量和键向量,如下所示,
最后,作者将包含RoPE信息的向量 incorporated into the query 和 value vectors,并继续进行注意力计算。
"where MH denotes the operation that implements the multi-head mechanism." 的简体中文翻译为:
"其中,MH 表示实现多头机制的操作。"
CLLA变体。在整合MLA和CLA策略时,必须考虑多种变体和复杂性。与直接共享KV激活的简单CLA方法相比,作者在图2中描述了三种变体。左边的变体被作者作为最终的CLLA架构所采用。它只在不同层之间共享潜在向量,同时允许每个层都有自己的KV投影矩阵来重建KV激活。这种变体在其他变体中表现优越,详细实验见第5.2节。正式地,对于共享因子为2的CLLA,方程定义如下,
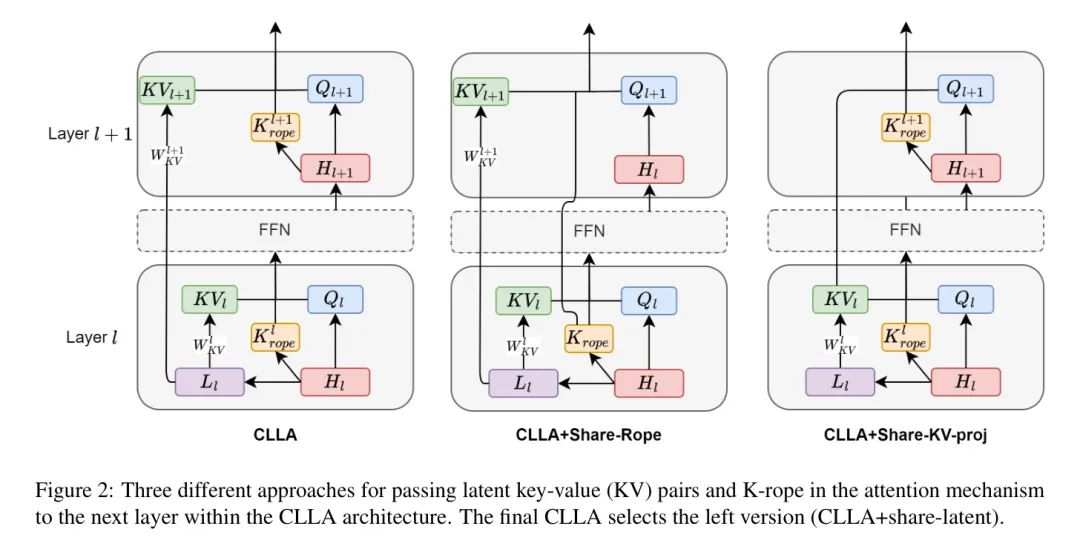
在这种表示方法中,作者共享潜在向量,而每个层使用其自己的RoPE向量作为键。对于使用来自前一层的潜在向量的层,特定线性层被用来将共享的潜在向量投影回和。然后,与进行MHA计算,同时与和相加。
当前CLLA选择的解释。虽然与共享KV激活但不共享潜在向量的变体相比,这种方法需要更多的计算资源,但作者认为这种权衡得到了其相对于其他方法优越性能的合理性。作者假设这种改进源于每个投影矩阵可以将潜在向量投影到特定KV激活,这些激活包含该层相关信息的层。此外,作者还发现,仅共享潜在向量在结合量化技术时,性能显著提高,因为量化是在潜在向量 Level 应用的。关于特定投影层减轻量化损失的类似推理。
CLLA-quant: Latent Quantization
为了进一步降低与KV缓存相关的内存开销,作者在潜在状态上实现低位量化,将16位浮点值转换为较低位整数,使用对称量化(Nagel等人,2021)。量化函数可以表示如下:
这里表示潜在状态,表示它们作为位整数存储的量化版本。表示取整运算符,而作为缩放因子。潜在状态被缩放到限制范围,该范围设置为。只有在计算过程中需要时,才会将量化潜在状态解量化。解量化函数定义如下:
然后利用恢复的潜在状态进行计算。作者采用4位用于CLLA-量化。
量化配方。 为了进一步减小量化误差,作者采用了子通道分量化的量化技术(Gholami等人,2022),其中每个个元素分组,每个组共享一个缩放因子。在量化之前,潜在状态使用RMSNorm(Zhang和Sennrich,2019)进行归一化。在训练和部署阶段都应用了量化和解量过程。在训练模式中,与量化相关的梯度使用直线估算器(STE)(Bengio等人,2013)进行近似。
4 Experiments
Datasets and Experimental Settings
训练数据集由作者内部收集,它是一个经过清洗的中英双语数据集的组合。作者在3000亿个 Token 上训练了所有模型。在评估阶段,作者的目标是实现英语和中文中多个领域的稳健结论。作者进行了涉及7个英语任务(包括MMLU、Hellaswag、ARC-C、Winogrande、Bool、PIQA和SIAQ)以及8个中文任务(包括CMMLU、CEval、CLUEWSC2020、Thuc-news、OCNLI、C3、FewCLUE-CHID和CMNLI)的综合评估。更多详细信息请参见附录B。
为了确保公平的比较,作者调整了前馈神经网络(FFN)的中间维数,以保持所有模型之间的可比较激活参数。附录详细阐述了每个模型的实现细节。训练过程使用64块NVIDIA H800 GPU进行,推理评估也使用了相同的硬件资源。训练配置的详细信息请参见附录。
Competitors
对于每个竞争者,作者都使用相同的1.44亿激活参数,采用Mixture of Experts(MoE)架构(Fedus等人,2022年;Lepikhin等人,2020年)。具体而言,作者使用一个1Bx16的MoE配置的模型,总共包含近11亿参数,以确保公平的比较。以下方法进行了评估:
MHA: 基础 Transformer 架构(Vaswani等人,2017年;Radford等人,2019年)类似于Llama2模型(Touvron等人,2023年)。它使用SwiGLU(Shazeer,2020年)作为前馈层的激活函数,并利用RoPE(Su等人,2023年)进行相对位置的嵌入。所有后续模型都是这个基础模型的变体。
GQA (Ainslie等人,2023年):GQA将 Query 头分组,使每个组可以共享 Key和Value 。作者在总共16个 Query 头中设置了8个KV头,以减少KV缓存的一半。
在MLA(DeepSeek-AI,2024)中,KV缓存被映射到低秩空间。该低秩空间的潜在维数为512。
CLLA: 作者的方法结合了MLA和CLA(Brandon等人,2024年)的设置,同时遵循上述共享配置。
CLLA-quant:作者在原始CLLA上应用了32个分组的int4标量量化来压缩潜在状态。
在每个模型中,隐藏层大小设置为1536,有32层,以及16个注意力头。作者在MoE层中引入了17个专家,包括一个共享专家和16个专家,从中选择top-1进行路由。为了确保各种方法之间的激活参数和总参数的对齐,作者根据需要调整了 FFN (FFN)的扩展比例以进行公平比较。关于训练和模型超参数的更多详细信息,请参阅附录A。
Main Results
在预训练300万亿个 Token 之后,作者在涵盖各种任务的15个基准测试上评估了所有模型。所有模型都在相同的 Token 器和解数据中进行比较。在表2中显示的英语基准上,MLA与GQA Baseline 具有可比性。提出的模型CLLA和CLLA-quant在更高的压缩比下取得了更好的结果。作者可以在表3中呈现的中国基准上得出类似的结论。此外,表4中展示了每个模型每个KV缓存内存字节的使用情况。从这些表格中,出现了一些有趣的观察结果,关于作者的方法在实现高KV缓存压缩比的同时不降低性能的有效性:
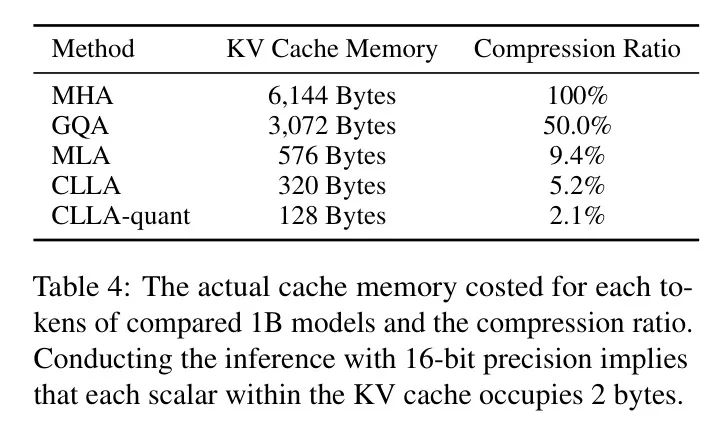
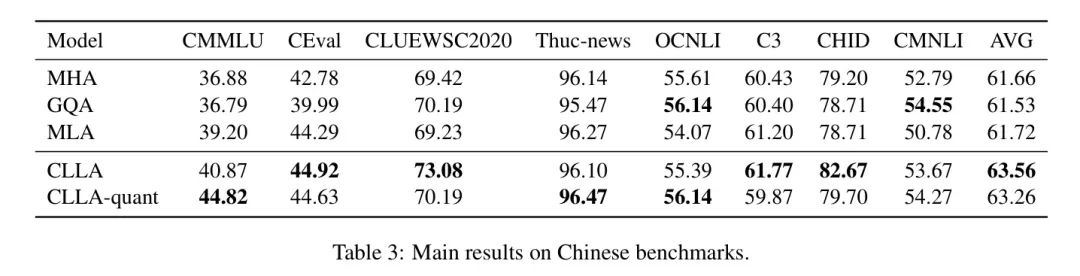
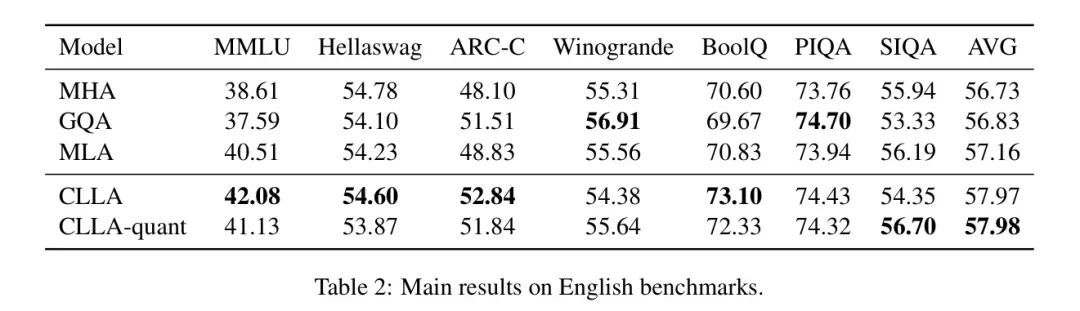
首先,CLLA在性能上显著超过了MHA,同时实现了近95%的内存使用减少。对于英语任务,CLLA的性能比MHA高约1.24个点,对于中文任务也显示了类似的提升。这种改进可能归因于作者的模型设计。在相同数量的激活参数下,作者能够利用从CLLA方法节省的参数来增加FFN隐层大小,这可能有助于改善结果。
第二,CLLA-quant在压缩KV缓存内存方面实现了与CLLA相当的结果,同时将内存使用率降低了四倍。这些结果验证了作者的CLLA-quant方法在15个基准测试中,将KV缓存内存压缩到2%,相较于MHA实现了性能损失很小这一惊人结论。作者推测,量化对性能的影响最小,原因在于其应用在预训练阶段,使得整个模型能够适应量化的KV缓存。量化可能增强了KV缓存中存储的表示的鲁棒性,确保了微小的精度损失不会损害模型的性能。
深度分析模型在CLLA从不同方面压缩KV缓存并非易事,包括层、维度和位 Level 。在本节中,作者对不同的(成功或失败)策略进行了深入探讨,并报告了作者在实验中发现的洞察,希望有助于未来的研究。
Intra-layer vs. Inter-layer Sharing
为了更深入地理解将CLA与MLA相结合的策略,作者对内层和外层共享方法进行了全面的分析。目前的研究中,关于外层共享方法(如CLA)与内层共享策略(如MQA和GQA)之间的优劣存在矛盾的结论。在Brandon等人(2024)的研究中,作者声称,通过适当的设计,内层和外层策略的结合可以在某些情况下使外层共享优于内层共享。然而,后续的一项研究(Zuhri等人,2024)发现,内层策略通常优于外层策略。为了探索这些设计选择,进行了一系列实验。实验模型与作者的主要实验设置相同,只是作者只训练了50B个 Token 进行快速的验证语义相似性比较。结果如表5所示:
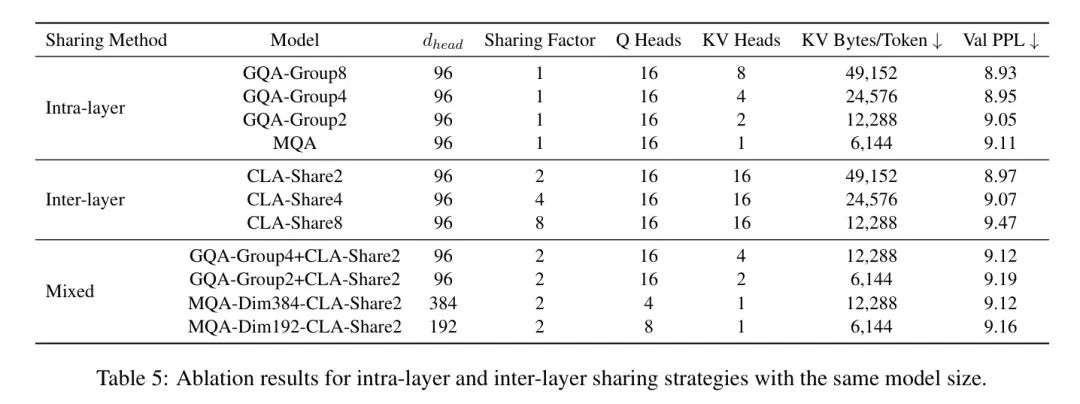
内层策略在相同内存预算下,始终比外层策略在验证 Perplexity 上实现更低的性能。
具体来说,与 CLA-Share2 相比,GQA-Group8 的内层策略在验证 Perplexity 上始终优于外层策略;与 CLA-Share4 相比,GQA-Group4 的内层策略在验证 Perplexity 上始终优于外层策略;
与 CLA-Share8 相比,GQA-Group2 的内层策略在验证 Perplexity 上始终优于外层策略。此外,即使内存减少幅度相同,与 GQA 策略相比,CLA 策略带来的性能损失显著更大。
这一结论得到了在不同共享因子 CLA 配置和不同组大小 GQA 配置之间的比较的支持。
(2) 无论是将GQA和CLA策略相结合,还是调整 Head 尺寸,都没有提高性能。具体来说,当作者将这两种策略相结合时,作者观察到GQA-Group2+CLA-Share2的性能比MQA差,而GQA-Group4+CLA-Share2则不如GQA-Group2。此外,在保持总隐藏维数不变的同时调整 Head 尺寸,无法超越简单的层内共享策略。这一点从MQA-Dim192-CLA-Share2与MQA以及MQA-Dim384-CLA-Share2与GQA-Group2的比较中可以看出。
根据这些观察,作者可以提出一个利用内层和层间共享来节省KV-cache内存的设计策略。首先,如果仅通过内层方法就能满足KV-cache内存预算,则应优先考虑内层策略。其次,只有在内层内存策略(如MQA和MLA)显著压缩后,且需要进一步减少时,才应采用层间策略。
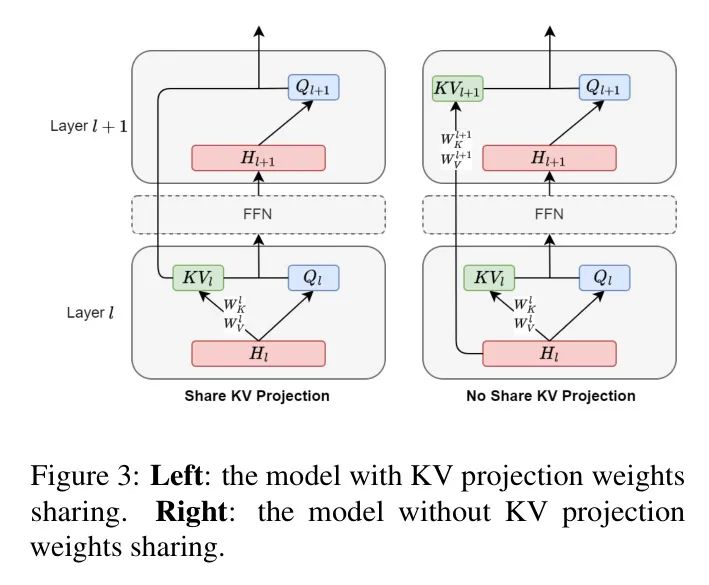
除了上述的消融实验外,受MLA启发,作者探索了注意力模块输入隐藏状态共享的可能性,而非KV头。这种方法在推理时需要缓存输入隐藏状态,而实时计算KV头。作者可以将MLA策略视为这种概念的LoRA变体。当应用CLA时,作者必须确定是否像图3那样共享KV投影权重。作者的发现表明,允许每层都有自己的KV投影权重比共享KV投影略好,验证的困惑度为8.97而不是8.99。尽管这个决定对于CLLA至关重要,但在这种情况下,差异并不大。
CLLA Cross-layer Sharing Strategies
在分解MLA策略中的可跨层共享组件时,作者确定了三个要素:KV潜在向量、K绳向量以及KV投影矩阵。这三个配置如图2所示。作者最终的设计决策倾向于第一个配置,因为其性能优越。第二个配置提供了额外的KV缓存节省,但由于K绳向量相对于KV潜在向量的大小相对较小,所以节省幅度有限。第三个配置可能会降低计算和模型参数。
作者基于相同的实验设置,使用与主要实验中相同的方法评估了这三个模型在下游任务上的表现。结果呈现在表6中,显示了英中两项任务的平均得分。所有英中任务的具体结果见附录C。
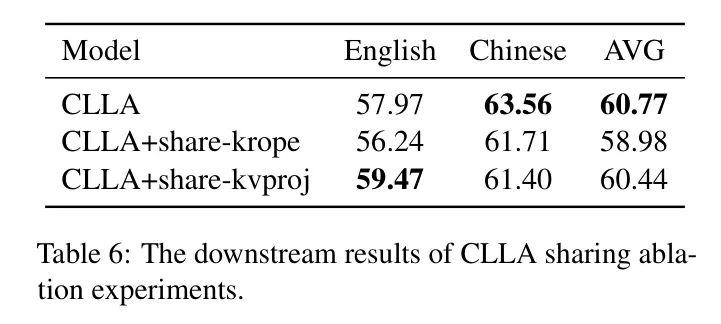
作者的分析表明,仅共享KV潜在向量的CLLA实现了最佳性能。共享K绳向量的策略对性能影响很小,且没有明显的好处。尽管KV投影共享策略在英语任务上产生了更好的结果,但总体性能较低。然而,这种方法在训练和推理过程中可以通过消除一半的KV投影计算和矩阵来实现中等改进。鉴于作者主要关注下游性能,因此作者选择第一个配置作为作者的CLLA策略。选择这个配置的另一个原因是它与量化技术的交互良好。
CLLA Quantization Strategies
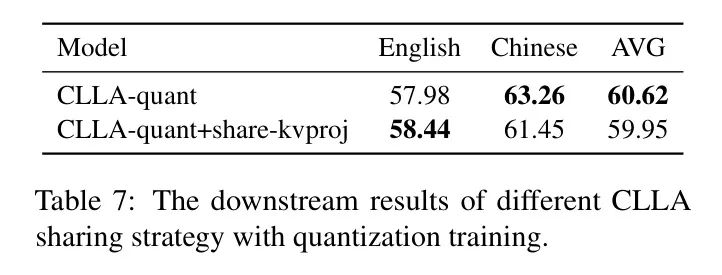
根据作者之前的发现,作者选择了CLLA和CLLA+share-kvproj进行潜在量化训练,并比较了它们的下游性能,结果如表7所示。所有实验设置与主要实验中使用的一致。作者的结果表明,不共享KV投影矩阵的策略在与量化技术结合时,实现了显著更高的性能。观察到的差异可能归因于具有多个KV投影可以更好地补偿量化损失,而不仅仅依赖于共享KV投影。
6 Conclusion and Future Work
在这项工作中,作者提出了CLLA和CLLA-quant,两种有效的KV缓存压缩技术。这两种方法在保证性能的同时,实现了KV缓存大小的显著减少,其中CLLA-quant的内存使用率低至2%,同时保持了与基准相当的表现。
作者确定了最优的设计选择,有效地结合了注意力头/维度减少、层共享和量化技术,这一结论得到了广泛的实验和分析的验证。
尽管CLLA简单易用,但它成功地确认了无损大比例KV缓存压缩的可行性,这有望成为高效LLM推理的优越基本组成部分。
在未来,作者将会在更大的LLM规模上探索CLLA系列,以验证其普适性。还将进行更多实验,以发现LLM的KV缓存不同组件更高效的参数分配方法。
参考文献
[0]. Lossless KV Cache Compression to 2%.
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2024-12-26,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号