量化不一定省电:我们在 RTX 4090 上实测了 INT8,它比 FP16 多耗 50%–242% 的能量
原创
量化不一定省电:我们在 RTX 4090 上实测了 INT8,它比 FP16 多耗 50%–242% 的能量
原创
四王爷
发布于 2026-09-19 14:30:40
发布于 2026-09-19 14:30:40
结论先行:在 RTX 4090 上用 bitsandbytes 的 LLM.int8() 做 7B 以下模型的解码推理,每一个模型尺寸都没有省电,反而多耗 50%–242% 的每 token 能量。原因不是功率高——INT8 的瞬时功率其实更低——而是吞吐崩了。同卡上的 NF4 则呈现完全不同的画像:小尺寸亏电、大尺寸省钱,盈亏平衡点约在 3.7B。
一、为什么要做这个实验
"量化省电"几乎是社区共识:权重从 FP16 压到 8 bit 或 4 bit,显存占用和带宽需求都降了,能耗理应跟着降。但这个直觉有一个隐藏前提——吞吐不能掉。每 token 能量约等于平均功率除以吞吐,如果量化把功率压低了 20%,却把吞吐压低了 60%,结果反而是更费电。
我们想搞清楚的就是这件事:在消费级卡上,INT8 和 NF4 到底落在哪一边?
二、实验设置
先交代测量条件,后面所有数字都基于这套配置:
- GPU:RTX 4090(Ada 架构),每张卡单独测量;
- 采样方式:NVML 直接读 GPU 包功耗,采样率 10 Hz;
- 任务:batch 1 解码,每轮生成 256 个 token,每个测点跑 10 轮取均值;
- 后端:INT8 走 bitsandbytes 的
LLM.int8();NF4 同样走 bitsandbytes(4 bit); - 模型尺寸:0.5B / 1.1B / 1.5B / 3B / 7B,每个点都是实测,没有插值。
诚实声明:多数点是单轮试验(n = 1),柱状图上没有误差棒可画。其中 1.1B 的 INT8 我们后来在另一张 RTX 4090 实例上复测过一次,+138% 对第一次的 +146%,两次独立单测相差 8 个百分点——量级可信,个位数精度不可信。本文所有结论都限定在"这张卡、这个后端"的范围内。
三、两张折线图:绝对能耗与吞吐
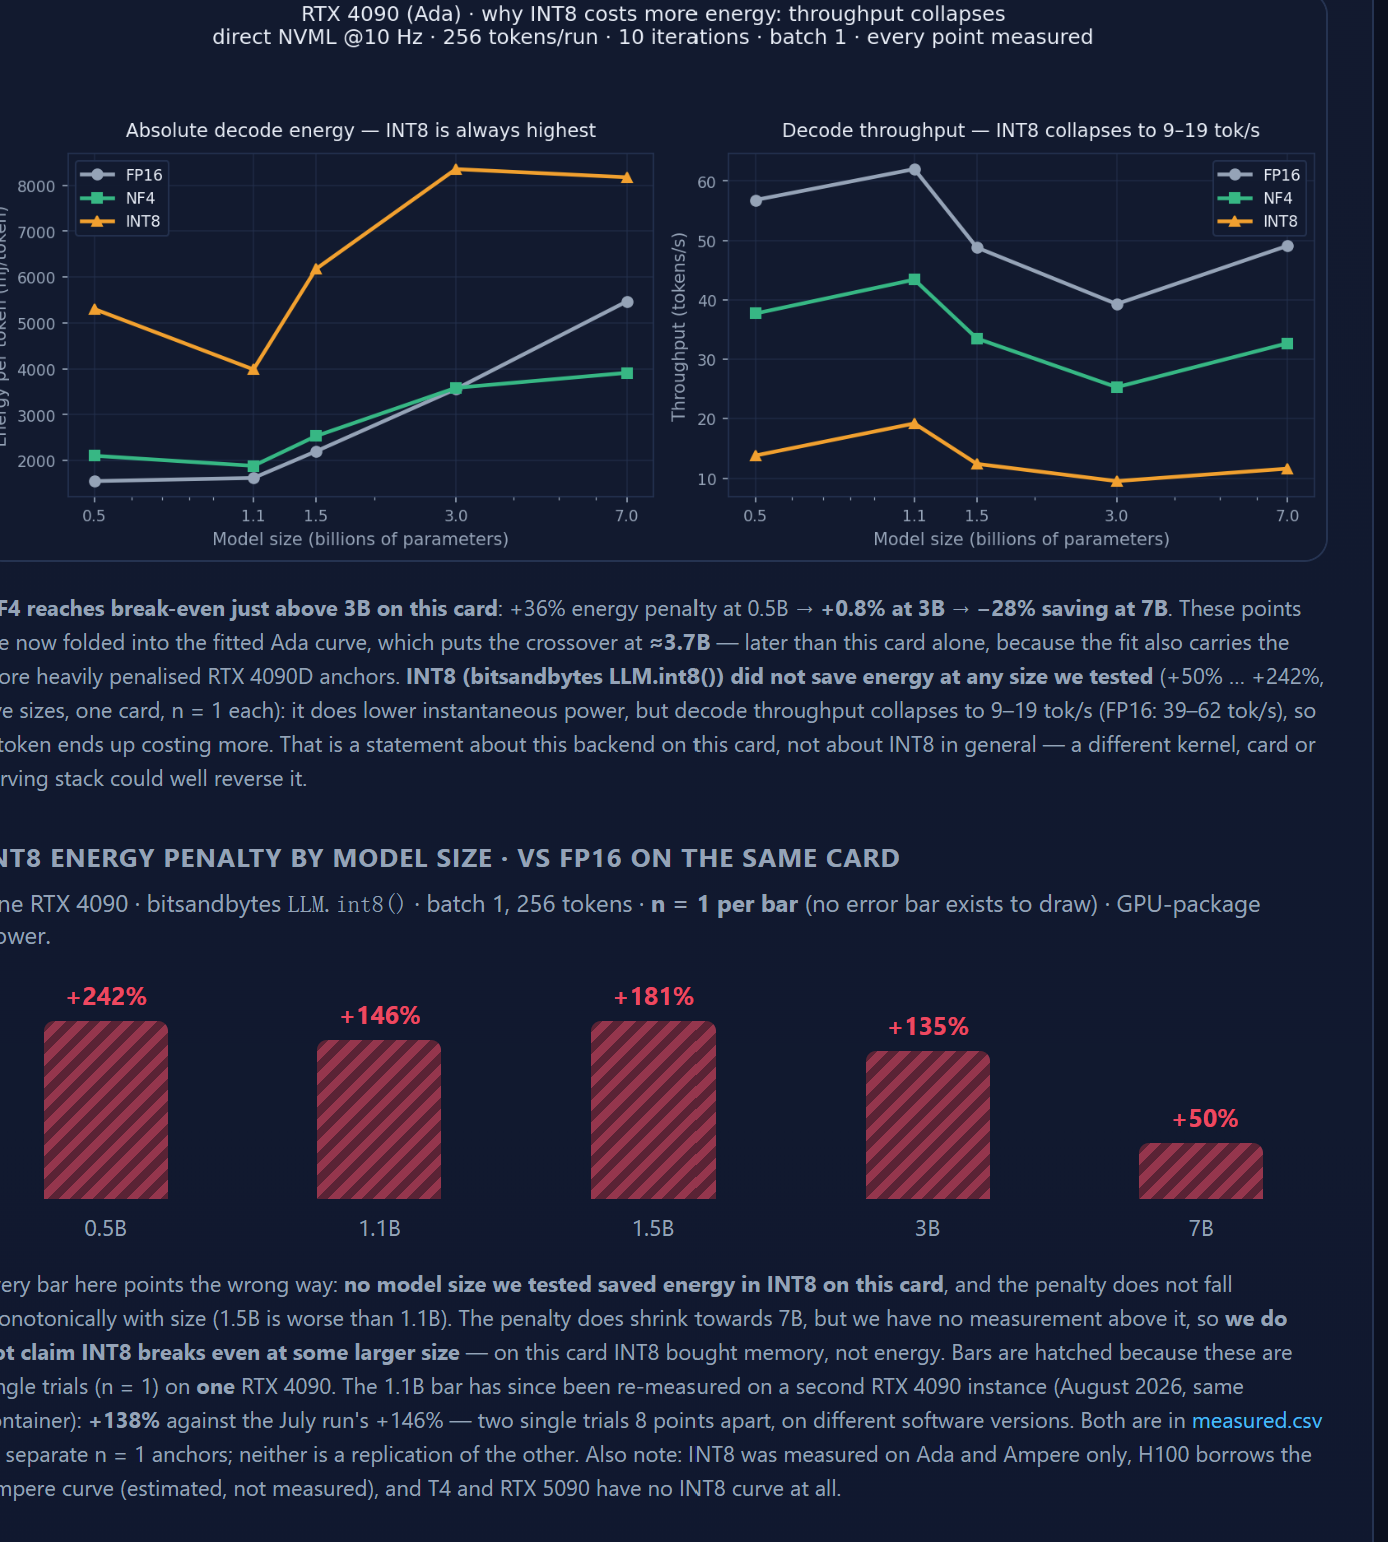
左图(绝对解码能量):纵轴是每 token 能量(mJ/token),横轴是模型尺寸。三条线里 INT8(橙色)在每个尺寸上都是最高的——0.5B 时约 5300 mJ/token,3B 时冲到 8500 mJ/token 以上;而 FP16(灰)和 NF4(绿)在同样的 3B 位置只有约 3600 mJ/token。INT8 不但没省电,还是三条线里最耗电的一条。
右图(解码吞吐):解释了左图。FP16 的吞吐在 39–62 tok/s 之间,NF4 在 13–44 tok/s 之间,而 INT8 崩到了 9–19 tok/s——只有 FP16 的四分之一到三分之一。
两张图放在一起,机制就清楚了:INT8 量化确实压低了瞬时功率,但它的解量化路径(权重反量化 + 尺寸校准的开销)把每步解码拖慢得太多,功率的节省远远追不上时间的膨胀,每 token 能量反而翻倍。
四、柱状图:INT8 的能耗惩罚随尺寸怎么变
下面这张柱状图给出 INT8 相对同卡 FP16 的每 token 能量增幅:
模型尺寸 | INT8 相对 FP16 的能量增幅 |
|---|---|
0.5B | +242% |
1.1B | +146% |
1.5B | +181% |
3B | +135% |
7B | +50% |
三个值得注意的细节:
- 没有一根柱子指向省电的方向。我们测过的每个尺寸,INT8 都比 FP16 更耗电。
- 惩罚不是单调递减的。1.5B(+181%)比 1.1B(+146%)更差——不要假设"模型越大、量化越划算"是一条平滑曲线。
- 趋势确实在收敛:从 0.5B 的 +242% 收缩到 7B 的 +50%。但 7B 以上我们没有测量,不外推"某个更大的尺寸会打平"的结论。在这张卡上,INT8 买到的是显存,不是能量。
五、对照:NF4 的画像完全不同
同一张卡上,NF4 的曲线是 crossings 型的:
- 0.5B:比 FP16 多耗 36%;
- 3B:基本打平(约 +0.8%);
- 7B:省 28%。
对实测点做拟合,盈亏平衡点约在 3.7B。也就是说,"量化省电"这句话在 NF4 身上、在 4B 以上模型身上,是成立的;在 INT8 身上,至少在这张卡的这个后端身上,是不成立的。
六、结论与边界
结论:
- 每 token 能量 = 平均功率 ÷ 吞吐。评估量化的能耗收益,只看功率或只看显存是不够的,吞吐塌了什么都能反过来。
- 在 RTX 4090 + bitsandbytes 这条技术栈上,INT8 是"省功率、费能量"的典型:瞬时瓦数更低,但每 token 更贵。
- NF4 在足够大的模型上确实省钱,小模型上则相反——量化省不省电,和模型尺寸强相关。
边界(同样重要):
- 以上全部是单卡、单后端的实测。INT8 的代价是 bitsandbytes 在 Ada 上的实现特征,换一个 kernel、换一张卡(比如有原生 INT8 tensor core 路径更优的栈)、换一个推理框架,完全可能反转。
- 部分测点 n = 1,趋势可信、个位数精度不可信。
- INT8 只在 Ada 和 Ampere 两代卡上测过;其余卡型的曲线是估计值或缺失。
一句话带走:下次想"量化省电"之前,先量一下你自己的栈上的吞吐——功率低不等于能量省。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号