#WorkBuddy# 我用它搭了一套"全自动每日简报 + 收盘报告"工作流(含踩坑实录)
原创
#WorkBuddy# 我用它搭了一套"全自动每日简报 + 收盘报告"工作流(含踩坑实录)
原创
二月的鸟
修改于 2026-09-14 18:31:05
修改于 2026-09-14 18:31:05
一、我要解决什么问题
我每天需要三份固定材料:早间资讯简报、盘前提示、收盘复盘报告。手工做一遍要 2–3 小时,且质量不稳定。用 WorkBuddy 的定时自动化任务之后,现在每天 7:30–19:00 全部自动产出,我只需要验收结果。
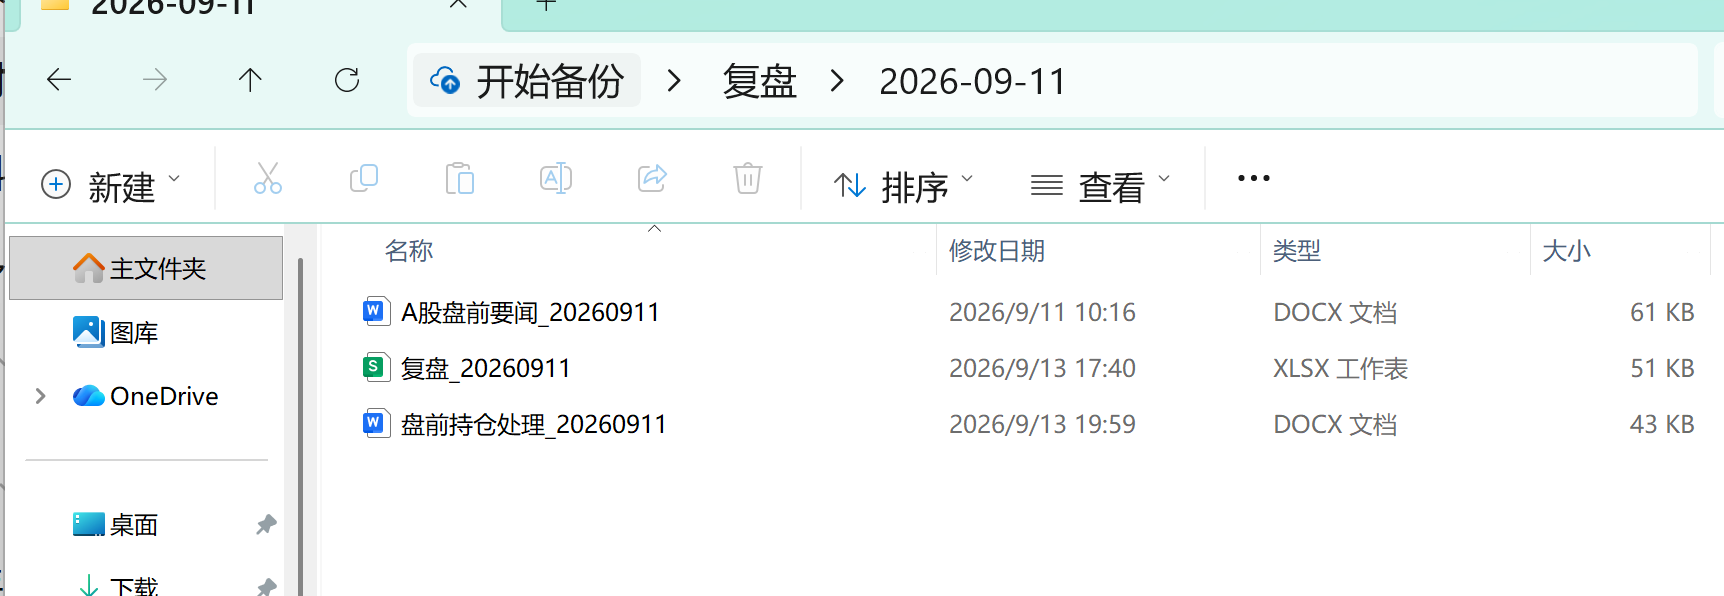
这套东西的核心不是"AI 写文章",而是把交付链固化成任务:建目录 → 抓数据 → 写稿 → 转格式 → 自检 → 交付。哪一步断链,第二天就找不到文件。
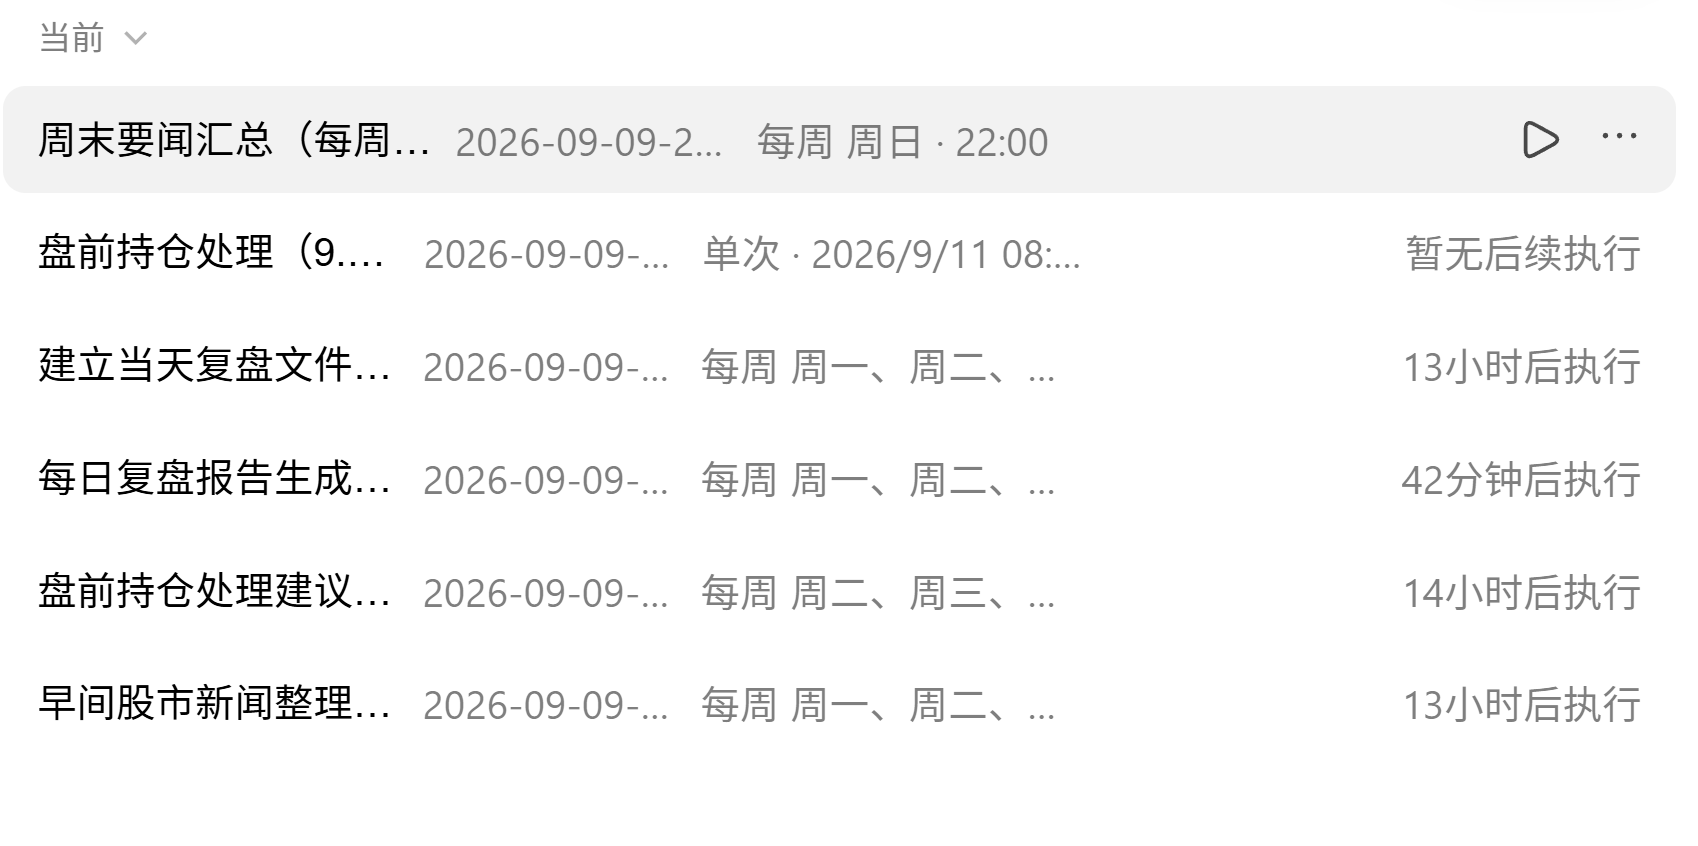
二、任务怎么拆(5 个定时任务)
时间 | 任务 | 产出 |
|---|---|---|
7:30 | 建当日日期文件夹 | 目录骨架 |
7:40 | 早间资讯整理 | 简报 docx |
8:40 | 盘前要点 | 提示 docx |
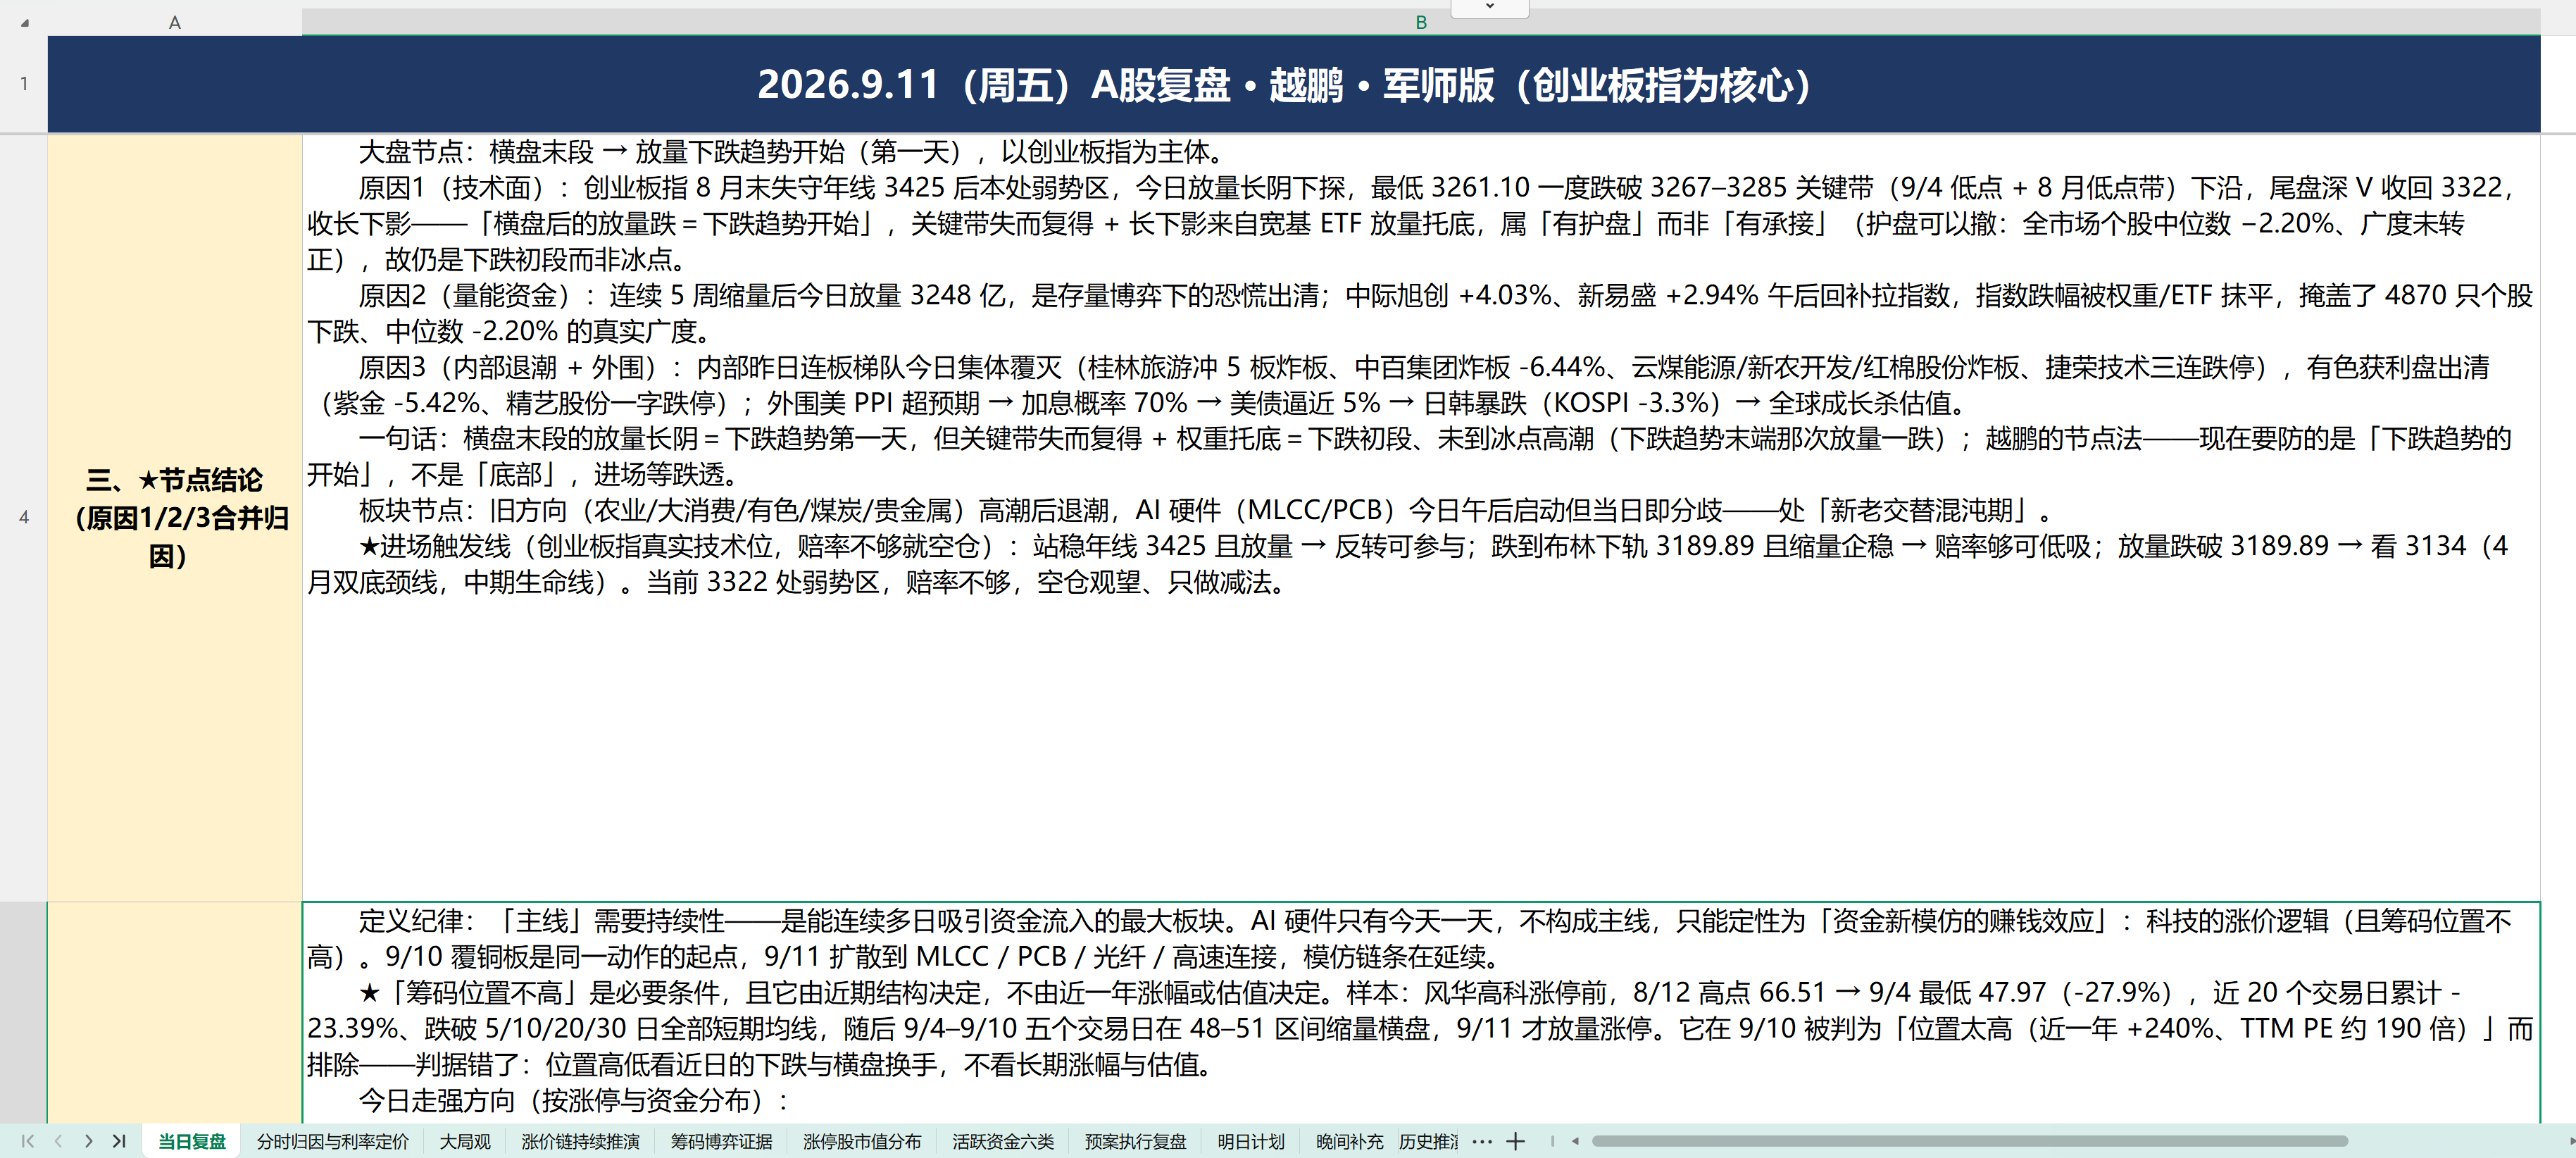
19:00 | 收盘报告 | 结构化 xlsx |
周日 22:00 | 周末汇总 | 下一交易日预案 |
排期用 RRULE 写进任务配置,例如每个工作日 7:40:FREQ=WEEKLY;BYDAY=MO,TU,WE,TH,FR;BYHOUR=7;BYMINUTE=40。一个 RRULE 可以表达"多选日",不要按天建多个任务。
三、prompt 工程上真正有用的几条经验
- 文件名写死、路径写全。任务 prompt 里写精确文件名(如
早间简报_YYYYMMDD.docx)和绝对路径。用"放到今天文件夹"这种模糊说法,隔天就会断链——下游任务按名找不到上游产物。 - 上下游任务靠"文件接力"。下游任务第一步永远是"先读上游文件再干活",且要写清"找不到就跳过并注明",避免凭空编。
- 去重规则要写进 prompt。我的周一简报会重复周日汇总的内容,后来在 prompt 里加了一段"周一禁止重列周末已覆盖内容、只写增量",才真正解决。
- 模型选择:批量跑的定时任务用 Flash 档足够,成本低、速度快;深度分析才上强模型。
- 禁止空话和自证。在 prompt 里明确"条目只写事实+数字+方向,不解释方法论",输出质量比加字数限制更有效。
四、格式转换:md → docx 一行命令
我习惯让模型先产 md(好改),最后用 python-docx 批量转 docx 交付。核心脚本约 60 行:
from docx import Document
from docx.shared import Pt
from docx.oxml.ns import qn
def md2docx(md_path):
doc = Document()
style = doc.styles['Normal']
style.font.name = '微软雅黑'
style.element.rPr.rFonts.set(qn('w:eastAsia'), '微软雅黑')
style.font.size = Pt(10.5)
# 逐行解析 md:# 标题 / - 列表 / 正文……
for line in open(md_path, encoding='utf-8'):
emit(doc, line.rstrip('\n'))
doc.save(md_path.replace('.md', '.docx'))
踩过的坑:转换成功后记得删源 md,否则日期文件夹里堆积中间产物,下游任务会读到旧稿。
五、交付前自检:用脚本管住 AI 的嘴
生成 xlsx 报告后,我强制跑一个自检脚本再交付,检查三件事:
- 结构:sheet 数量、名称、顺序是否符合模板;
- 措辞:用正则扫"断言型违规"(如把通道标签读成资金态度、排他性表述"唯一主线"),命中即打回重写;
- 排版:行高异常检测(横向合并单元格的行高必须按合并区总宽算,用单列宽重算会撑到 2000pt+,这是我交过学费的)。
思路很简单:把"曾经犯过的错"变成正则清单,机器把关比事后肉眼检查可靠。
六、踩坑清单(省你半天调试)
- 工具路径变更要同步改 prompt:脚本挪了目录,prompt 里还写着旧路径,任务每天固定失败。改完路径 grep 一遍所有任务配置。
- 时序敏感的抓数要留缓冲:比如依赖 8:00 开盘的数据,任务设在 7:40 就抓不到,要么延后任务,要么在 prompt 里写"8:00 后补一次检索"。
- 数据源要写备用:主接口失效时 prompt 里要指明备源(如换另一个行情接口),否则任务整场失败。
- 配额用尽的处理:全部任务锁低成本模型,配额恢复后自动跑,不用改回。
- 一次性任务和周期任务分开:过期的一次性任务及时删,避免列表混乱。
七、效果
- 每天节省约 2 小时手工整理时间;
- 产出格式 100% 统一(字体、结构、命名全部固化);
- 质量靠"自检脚本 + 人工验收"双保险,AI 幻觉类错误基本被正则清单拦住。
这套方法不限于金融场景——任何"每天要固定格式产出"的岗位(运营日报、客服周报、竞品监测)都能套用。有问题欢迎评论区交流。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号