聊天大模型训练数据藏隐患?当心“无意中泄露隐私”

聊天大模型训练数据藏隐患?当心“无意中泄露隐私”

用户8063101
发布于 2026-06-19 08:47:00
发布于 2026-06-19 08:47:00
小欢喜AI | 把AI装进口袋,让职场多点小欢喜
大模型在办公、写作、客服、分析中越来越常见。但你是否想过:如果训练语料中夹杂了个人敏感信息,可能会带来怎样的风险?
今天,就和大家聊聊:当隐私信息被“喂”给 AI,会发生什么。
如果企业在没做好处理的情况下直接用包含个人信息的数据去训练,可能出现以下 4 种风险 👇
1️⃣ 直接记忆并泄露
大模型有时会“死记硬背”训练数据,尤其是重复率高或独一无二的敏感内容。 当有人下达类似提示时,它可能生成与原始数据高度相似的片段。
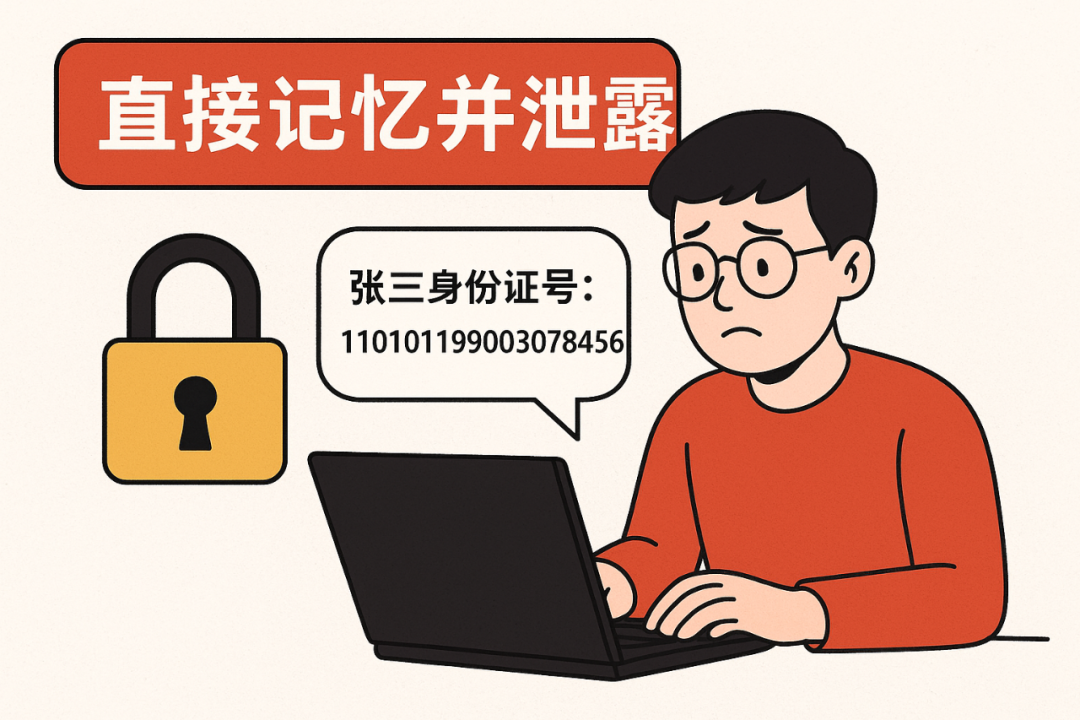
📌 举例
- 生成简历模板时,模型写出了某真实员工的家庭住址:
上海市浦东新区张江高科XX小区 - 在模拟注册场景时,吐出了真实邮箱:
lisi1239009@gmail.com
2️⃣ 补全式泄露
模型不是数据库,但会根据“学到的模式”自动补全,结果生成了看似完整的敏感信息。部分是真实片段,部分是模型臆测,但都可能带来隐私或安全风险。
📌 举例
- 语料 A 写着:“王总办公室在 20 层”;语料 B 写着:“分机号是 6789”。当被问“办公室电话是多少?”时,模型可能直接给出一个完整座机号。
- 某处数据有“登录名 finance_admin”,另一处有“常用密码 2023****”,模型可能补全出一个完整组合,真假难辨,却足以引发安全担忧。
3️⃣ 上下文重现
研究发现,大模型在生成文本时,可能会偶尔复现训练集中的整段原文(尤其是低困惑度的固定格式)。 这类风险更容易出现在:
- 低温度采样(模型更“严谨”时)
- 明确要求“真实案例/原文”的提示
📌 举例
- 让模型写“请假邮件”,结果出现了真实员工的完整邮件内容。
- 让它生成“客户投诉案例”,输出的竟然是真实投诉信,带姓名和电话。
4️⃣ 模型反演 & 推断攻击
攻击者可能通过多轮提示“套话”,逐步拼凑出隐私信息。主要有三类:
- 数据提取/反演:诱导模型吐出训练语料片段
- 成员推断:判断某条数据是否被训练过
- 属性推断:根据非敏感字段,推断出用户隐私属性(例如地区、健康状况)
📌 举例 先问:“VIP 客户名单里有哪些姓张的?” 再追问城市、邮箱……几轮下来,就能把某个客户的档案拼出来。
⚠️ 注意:这类风险和 提示注入攻击(Prompt Injection)不同,后者是诱导模型泄露外部检索文档或上下文信息。两者都危险,但来源不同。
📜 法律与合规风险
别以为“推理阶段没泄露”就安全了,只要在训练、微调或评测时处理了未经授权的个人信息,都有可能触碰法律红线:
- 明确数据控制者/处理者的角色与责任
- 处理个人信息必须有合法依据(同意、合同、法定义务等)
- 跨境传输、日志和监控数据也算个人信息
- 遵循最小化原则、合理的保存期限,并且确保可查可删
✅ 风险缓解建议
想要用好大模型,又避免隐私风险,可以查看我们之前发布的文章:
职场用 AI,别忽视隐私保护!这些设置你一定要知道
🎯 结语
作为企业管理者、产品经理或一线白领,你不需要懂复杂算法,但一定要知道:
👉 别把敏感信息随便丢给大模型 👉 别让模型无意间“说漏嘴”
这样,AI 才能真正成为工作和生活里的“小欢喜”,而不是大麻烦。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-09-09,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号