玩转企业集群运维管理系列(十):企业集群高可用软件 Keepalived 详解

玩转企业集群运维管理系列(十):企业集群高可用软件 Keepalived 详解

民工哥
发布于 2023-12-12 14:51:48
发布于 2023-12-12 14:51:48
Keepalived 简介
Keepalived 是 Linux 下的一个免费的、轻量级的高可用解决方案。是一个由C语言编写的路由软件,主要目标是为 Linux 系统和基于 Linux 的基础架构提供简单而强大的负载平衡和高可用性。
Keepalived 软件起初是专门为 LVS 负载均衡软件而设计,用来管理并监控 LVS 集群系统中各个服务节点的状态,主要用来监控集群中各个服务节点的运行状态。当服务节点出现故障被检测到,则会被 Keepalived 从集群中剔除,待恢复后再重新加入集群,期间的工作自动完成,不需要人工干预,需要人工完成的部分仅限于修复出现故障的服务节点。
后来又加入了可以实现高可用的 VRRP 功能,因此,keepalived 除了能够管理 LVS 软件 ipvsadm 外,还可以作为其它服务(例如:Nginx、HAProxy、MySQL等)的高可用解决方案软件 keepalived 软件主要使用过VRRP协议实现高可用功能。更多关于企业集群运维管理系列的学习文章,请参阅:玩转企业集群运维管理专栏,本系列持续更新中。
Keepalived 体系结构
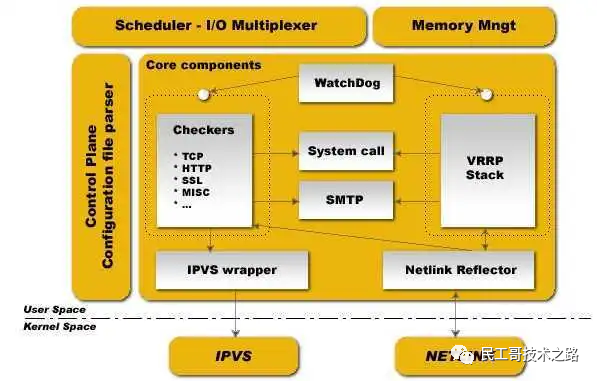
SchedulerI/OMultiplexer 是一个 I/O 复用分发调度器,它负载安排 Keepalived 所有内部的任务请求;
Memory Mngt 是一个内存管理机制,这个框架提供了访问内存的一些通用方法;
Control Plane 是 keepalived 的控制版面,可以实现对配置文件编译和解析;
Core componets 这部分主要包含了5个部分;
- Watchdog:是计算机可靠领域中极为简单又非常有效的检测工具,Keepalived 正是通过它监控 Checkers 和 VRRP 进程的。
- Checkers:这是 Keepalived 最基础的功能,也是最主要的功能,可以实现对服务器运行状态检测和故障隔离。
- VRRP Stack:这是 keepalived 后来引用 VRRP 功能,可以实现 HA 集群中失败切换功能。负责负载均衡器之间的失败切换 FailOver;
- IPVS wrapper:这个是 IPVS 功能的一个实现,IPVSwarrper 模块将可以设置好的 IPVS 规则发送的内核空间并且提供给 IPVS 模块,最终实现 IPVS 模块的负载功能。
- Netlink Reflector:用来实现高可用集群 Failover 时虚拟IP(VIP)的设置和切换,
VRRP协议
VRRP 协议全称:Virtual Router Redundancy Protocol(虚拟路由器冗余协议)。它是一种选择协议、路由备份协议,是Keepalived最重要的一个功能。可以将多个路由器组成一个虚拟路由器(一主多备),在网络发生故障时,可以实现透明切换。通过VRRP协议组成的虚拟路由器,通过一个或多个虚拟IP对外提供服务,在内部则是多个物理路由器协同工作,同一时间只有一台物理路由器对外提供服务,被称为主路由器。其工作过程大致如下:
1.启用VRRP功能后,根据优先级确定自己的在虚拟路由器中的角色,优先级高的为主路由器,其他的为备用路由器。主路由器定期向其他备用路由器发送VRRP报文,通告自己的工作状态正常,备用路由器则会定时接收。
2.VRRP根据不同的抢占方式,确定是否替换主备状态:
- ● 抢占方式:备用路由器收到报文后,会对比优先级,若大于通告报文中的优先级,则切换为主路由器,否则报持状态不变;
- ● 非抢占方式:主路由器在没有出现故障的情交下,主路由器与备用路由器将一直保持原有的状态。
3.若备用路由器在一定时间内没有收到主路由器发送的VRRP报文,则认为主路由器无法正常工作,此时备用路由器将会选举出优先级高的作为主路由器并发送VRRP报文,替代原有主路由器持续工作。
VRRP选举机制
VRRP路由器在运行过程中有三种状态:
- 1.Initialize状态:系统启动后就进入Initialize,此状态下路由器不对VRRP报文做任何处理;
- 2.Master状态;
- 3.Backup状态;
一般主路由器处于Master状态,备份路由器处于Backup状态。更多关于企业集群运维管理系列的学习文章,请参阅:玩转企业集群运维管理专栏,本系列持续更新中。
VRRP使用选举机制来确定路由器的状态,优先级选举
- 1.VRRP组中IP拥有者。如果虚拟IP地址与VRRP组中的某台VRRP路由器IP地址相同,则此路由器为IP地址拥有者,这台路由器将被定位主路由器。
- 2.比较优先级。如果没有IP地址拥有者,则比较路由器的优先级,优先级的范围是0~255,优先级大的作为主路由器
- 3.比较IP地址。在没有Ip地址拥有者和优先级相同的情况下,IP地址大的作为主路由器。
Keepalived服务的三个重要功能
- 1)管理LVS负载均衡软件ipvsadm
- 2)实现LVS集群节点的健康检查
- 3)作为系统网络服务的高可用性
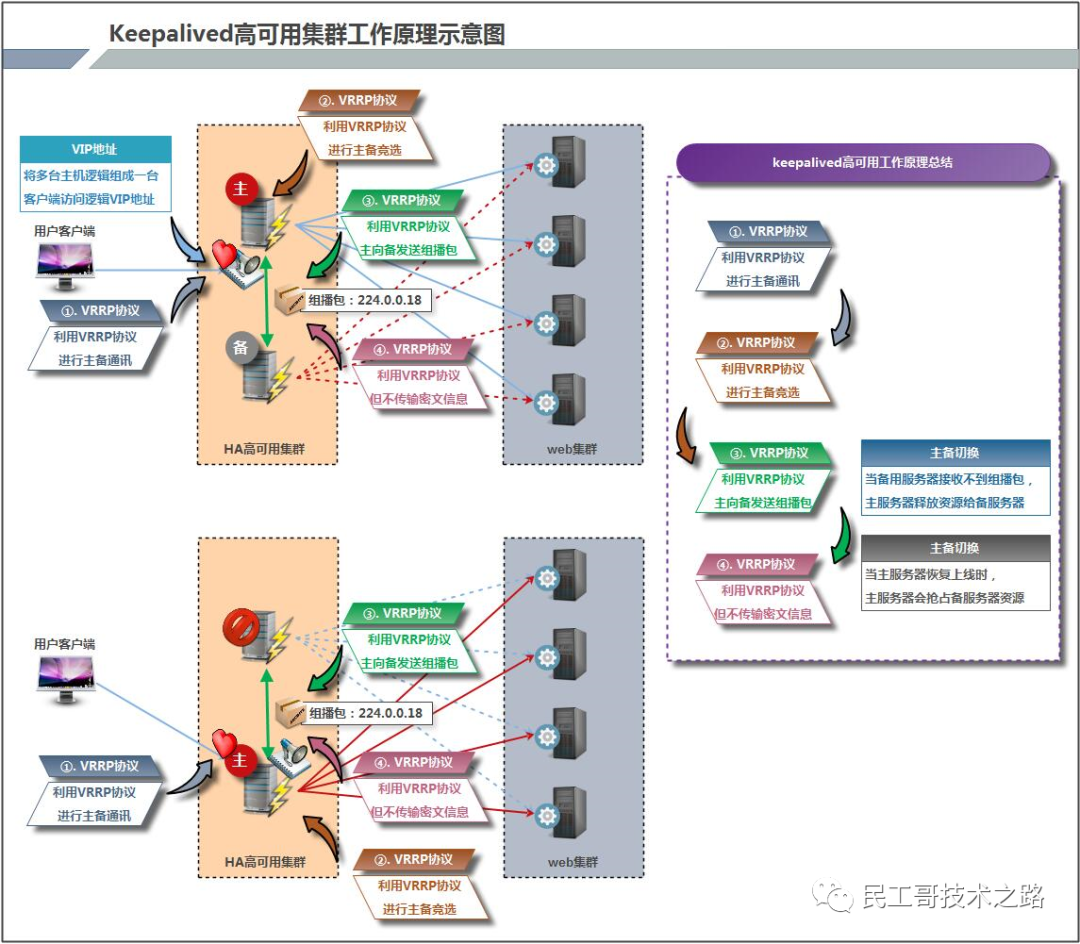
Keepalived 工作机制
Keepalived通过VRRP协议来竞争实现虚拟路由的功能,所有的协议报文都是通过IP多播(multicast)包发送(多播地址224.0.0.18)每个发送的多播数据包都是从多播地址发送;虚拟路由器由VRID(范围0-255)和一组IP地址组成,对外表现为一个周知的MAC地址:00-00-5E-00-01-{VRID}.所以在一个虚拟路由器中,不管谁是MASTER,对外都是相同的MAC和IP(称之为VIP)。
客户端主机并不需要因为MASTER的改变而修改自己的路由配置,对他们来说,这一切都是透明的。在一个虚拟路由器中,只有作为MASTER的VRRP路由器会一直发送VRRP多播包,这里说的MASTER发送多播包就是指的是上面所说的由VRRP协议224.0.0.18地址所发出的多播包,发多播包是为了告诉Backup节点自己还活着,BACKUP就不会抢占MASTER,除非它的优先级(priority更高)。
Keepalived服务的工作原理
Keepalived高可用对之间是通过 VRRP进行通信的, VRRP是通过竞选机制来确定主备的,主的优先级高于备,因此,工作时主会优先获得所有的资源,备节点处于等待状态,当主挂了的时候,备节点就会接管主节点的资源,然后顶替主节点对外提供服务。
在 Keepalived服务对之间,只有作为主的服务器会一直发送 VRRP广播包,告诉备它还活着,此时备不会枪占主,当主不可用时,即备监听不到主发送的广播包时,就会启动相关服务接管资源,保证业务的连续性.接管速度最快可以小于1秒。
Keepalived提供了三个守护进程,分别负责不同的功能:
- ● 父进程:负责fork子进程并对其进行监控。
- ● VRRP子进程:负责VRRP框架。
- ● 键康检查子进程:负责健康检查。
Keepalived依赖于VRRP协议实现高可用,同时还实现基于TCP/IP协议栈的多层(3层、4层、5/7层)的健康检查机制,能够提供服务节点检查及故障隔离的功能。其运行机制大致如下:
- ● 网络层:主要通过ICMP协议,向服务节点发送ICMP数据包(类似ping命令的方式),若无响应,则判定为故障节点并将其从集群中移除。
- ● 传输层:主要通过TCP协议,向后端发起一个TCP连接请求,若无响应,则判定为故障节点并将其从集群中移除。
- ● 应用层:主要根据用户的一些设定来判断节点是否正常,若不正常,则判定为故障节点并将其从集群中移除。常用的方式即使用脚本进行检测。
Keepalived一般会同时运行在两台或更多服务器上,同时提供服务且存在主从之分。实际提供服务的只有主服务节点。其工作原理与VRRP类似。Keepalived会根据配置文件中定义的优先级或节点的主从标记,确定哪一台服务器中运行的服务可以成为主节点并使用VIP(虚拟IP)对外提供服务,其他的则成为从节点。若Keepalived的主节点出现故障停止提供服务或所在的服务器宕机时,会将主节点移除并在从节点中选举出优先级较高的节点作为新的主节点并接管VIP继续提供服务,保证服务的不间断。待故障节点恢复后,再重新加入并重新确定是否需要切换主从关系。更多关于企业集群运维管理系列的学习文章,请参阅:玩转企业集群运维管理专栏,本系列持续更新中。
Keepalived 高可用故障切换转移原理
Keepalived高可用服务之间的故障切换转移,还是通过VRRP(Vritual Route Redundancy Protocol,虚拟路由冗余协议)来实现的 在Keepalived服务正常工作时,主Master节点会不断向备节点发送心跳消息(多播的方式),用来告诉备用节点自己还活着,当主Master节点发送故障时,就无法发送心跳消息,备节点也就因此无法继续检测到来自主Master的心跳消息了,于是调用自身的接管程序,接管主Master节点的IP资源及服务。而当主Master恢复时,备Backup节点默认又会主动释放主节点故障时自身接管的IP资源及服务,恢复到原来的备用角色。
Keepalived不抢占机制(nopreempt)
当Master出现问题后,Backup会竞选为新的Master,那么之前的Master如果故障恢复后,是继续成为Master还是变成Backup呢?默认情况下,如果没设置不抢占,那么之前的Master起来后还是会继续抢占成为Master,也就是说,整个过程需要发生两次切换;主机诶单出故障会发送Master —> Backup,主节点恢复会发送 Backup —>Master,这样对业务频繁的切换是不能容忍的,因此我们希望Master起来后成为Backup,所以要设置不抢占。
Keepalived里面提供了 nopreempt 这个配置只能用在状态为Backup的机器上,但是我们明明希望的是Master不进行抢占,那没办法,Master的状态也得设置为Backup,也就是说两台负载均衡器都要讲state状态设置为Backup。那么谁是Master?就要通过优先级priority的高低来决定了,优先级高得成为Master,反之。
与heartbeat/corosync等比较
Heartbeat、Corosync、Keepalived 这三个集群组件我们到底选哪个好,Heartbeat、Corosync是属于同一类型,Keepalived与Heartbeat、Corosync,根本不是同一类型的。Keepalived使用的vrrp虚拟路由冗余协议方式;Heartbeat或Corosync是基于主机或网络服务的高可用方式;简单的说就是,Keepalived的目的是模拟路由器的高可用,Heartbeat或Corosync的目的是实现Service的高可用。 所以一般Keepalived是实现前端高可用,常用的前端高可用的组合有,就是我们常见的LVS+Keepalived、Nginx+Keepalived、HAproxy+Keepalived。而Heartbeat或Corosync是实现服务的高可用,常见的组合有Heartbeat v3(Corosync)+Pacemaker+NFS+Httpd 实现Web服务器的高可用、Heartbeat v3(Corosync)+Pacemaker+NFS+MySQL 实现MySQL服务器的高可用。
总结一下,Keepalived中实现轻量级的高可用,一般用于前端高可用,且不需要共享存储,一般常用于两个节点的高可用。而Heartbeat(或Corosync)一般用于服务的高可用,且需要共享存储,一般用于多节点的高可用。
更多关于企业集群运维管理系列的学习文章,请参阅:玩转企业集群运维管理专栏,本系列持续更新中。
参考链接:https://blog.csdn.net/xiaoxiaowu0419 /article/details/123715909 https://blog.csdn.net /qq_34556414/article/details/107639954
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2023-12-11,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号