扫描发票批量转 Excel:怎样发现漏文件和重复汇总?
原创
扫描发票批量转 Excel:怎样发现漏文件和重复汇总?
原创
Youna
发布于 2026-11-13 16:33:42
发布于 2026-11-13 16:33:42
收到一批扫描发票,转换出来的 Excel 都能打开,仍然可能有两类问题:某张发票没有成功处理,却没出现在结果里;同一文件重试后出现两份结果,汇总时被算了两次。
批量处理不能只交付一张总表。先保留每个来源文件的转换状态、独立结果和核对记录,再生成汇总,才能回答“这行来自哪张发票”和“这一批还有哪些没完成”。下面是一套读者可以用自己的文件检查的方法,不把转换结果当作自动审核结论。
先判断需要整页表格,还是固定字段
如果目标是把扫描页转成可编辑表格,先用一份有权处理、已去除姓名、账号等敏感信息的文件,检查文字、表格和工作表结构。ComPDF 的PDF 转 Excel 接口支持 OCR 配置及工作表组织方式;扫描页应按实际输入启用 OCR,不能沿用纯文字 PDF 的设置后假定文字已经读出。
接口文档列出的 enableOcr、ocrRecognitionLang、ocrOption 与 excelWorksheetOption 用途不同:前几项影响识别,最后一项决定按表格、页或整份文档组织工作表。先确定接收人如何核对,再选择方式。不要把“每个表格一个工作表”解释成“每张发票必定只有一个工作表”。
如果目标只是发票号码、开票日期和金额等固定字段,需要另行定义字段和来源关系。整页转 Excel 不等于自动生成适合业务系统的发票记录;多个版式的字段映射、明细与总额关系仍须处理。
批次清单先于汇总表建立
每份输入保留独立记录。至少包含文件 ID、文件名、源文件摘要、任务 ID、处理状态、结果位置和核对状态。重试时更新同一输入的处理尝试,保留历史,不额外新增一份业务输入。
例如三份教学记录可以这样组织:
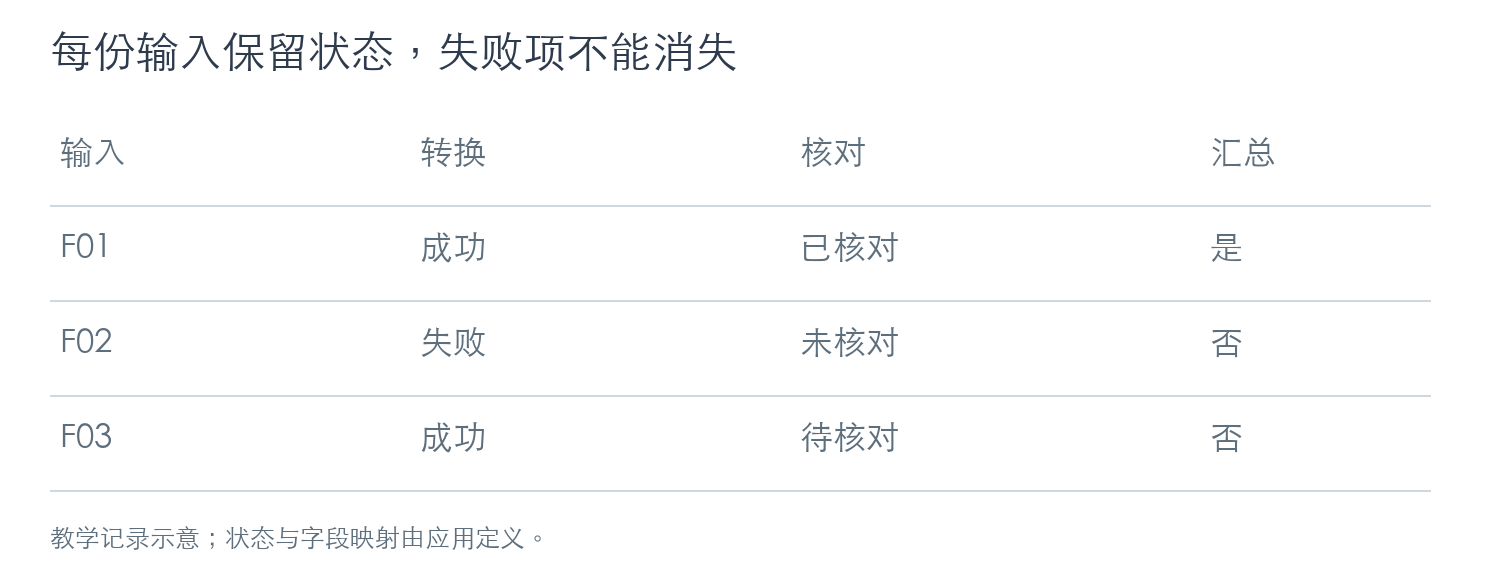
每份扫描发票保留独立处理和核对状态
图:教学记录示意,状态由应用定义。
这里的字段和状态由应用定义,不是接口自动返回的审批结果。F03 虽然转换成功,也不能把它记成已经完成复核;F02 更不能因为没有结果行,就从批次里消失。
汇总前,检查每个输入是否只出现一次
下面的 Python 3 代码只演示批次完整性判断,不调用 OCR、不判断真实发票,也不执行财务处理。expected 是本批应处理的来源文件 ID,results 是业务核对完成后准备进入汇总的记录。
from collections import Counter

expected = {"F01", "F02", "F03"}
results = [
    {"source_id": "F01", "review": "approved"},
    {"source_id": "F03", "review": "pending"},
    {"source_id": "F01", "review": "approved"},
]
counts = Counter(row["source_id"] for row in results)
missing = sorted(expected - set(counts))
unknown = sorted(set(counts) - expected)
duplicated = sorted(key for key, value in counts.items() if value > 1)
unreviewed = sorted({row["source_id"] for row in results
                     if row["review"] != "approved"})
issues = {"missing": missing, "unknown": unknown,
          "duplicated": duplicated, "unreviewed": unreviewed}
print(issues)
if any(issues.values()):
    print("批次尚未通过检查,请处理异常后再汇总。")
else:
    print("来源记录完整;还需核对字段与金额后交付。")
示例会找出 F02 缺失、F01 重复、F03 未核对。它检查的是“每份输入应产生一条汇总记录”的设计;如果一份文件包含多张发票,先给每张发票建立子记录,再用子记录 ID 检查,不能直接套用这个一对一关系。
同一输入 ID 重复与两份不同文件包含同一张发票,也不是同一问题。后者需要结合发票类型、号码、日期、开票方及原文判断,不能只凭某一个数字相同就自动删除。
金额和号码,回到原文核对
发票号码先按文本保留,不能为了计算将它转成浮点数。日期格式、空值与数字零分别处理,缺失金额也不能补零后继续参与总计。
金额要区分明细、不含税金额、税额和价税合计;不同币种不要直接相加。转成 Excel 后,检查小数点、负号、千分位和合并单元格,尤其是低清晰度扫描件中的小字。若要做金额一致性检查,应先明确本批采用的金额字段和舍入规则。
将待核对项放进异常清单,而不是静默修正。对每个修改保留来源文件、页码或原文位置以及修改说明,接收人才能回查。
用一批小文件检查,再扩大数量
第一轮可以准备三份具有不同版式的文件,至少包含一份扫描件和一份多页文件。先逐份完成转换并保存结果,再人为制造一个失败、一次重试和一条重复汇总,确认批次清单能发现它们。
交付时保留原文件、逐文件结果、汇总表和异常清单之间的对应关系。用户需要回查时,应能从汇总记录定位到来源,而不是重新搜索整个上传目录。
ComPDF 在这条链路里承担 PDF 到可编辑表格的转换与 OCR;应用负责来源追踪、重试与汇总,业务人员依据原文完成必要核对。先把漏文件和重复记录显式呈现出来,再考虑提高批量速度,结果才更容易解释和复查。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号