C# 调整 PDF 页面顺序:自定义排序与整份倒序
原创
C# 调整 PDF 页面顺序:自定义排序与整份倒序
原创
用户12495000
发布于 2026-11-09 10:21:17
发布于 2026-11-09 10:21:17
扫描文件合并后页序不对,或希望把文档末尾的页面放到前面,都需要调整 PDF 的页面顺序。这类操作可以通过指定页面索引来完成,无需先将 PDF 转换成图片。
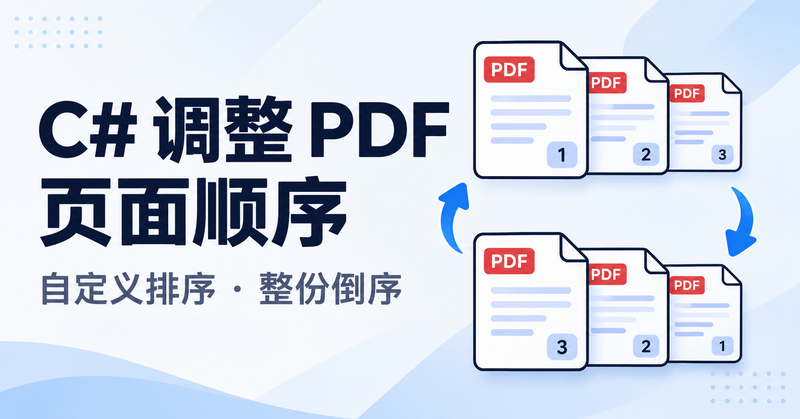
本文使用 Spire.PDF for .NET,分别介绍自定义页面顺序和整份文档倒序两种处理方式。两个示例使用同一个方法 PdfPageCollection.ReArrange(int[] orderArray),区别在于排序数组的生成方式。
一、安装 Spire.PDF for .NET
Spire.PDF for .NET 是用于在 .NET 程序中读取、创建和处理 PDF 文件的类库。本文使用其中的文档加载、页面重排和文件保存接口。
在 Visual Studio 的 NuGet 包管理器控制台中执行:
Install-Package Spire.PDF也可以在项目目录下使用 .NET CLI:
dotnet add package Spire.PDF下文代码采用 C# 顶级语句写法,可以分别放入支持该语法的控制台项目的 Program.cs 中运行。输入文件使用相对路径时,应将文件放在程序的工作目录下;也可以改为绝对路径。
二、理解页面索引与排序数组
调整页序前,首先要区分阅读器中看到的页面位置与代码使用的页面索引:索引从 0 开始,因此第 1 页对应索引 0,第 2 页对应索引 1。
ReArrange() 接收一个整数数组,数组中的每个值表示原文档中的页面索引,数组内的排列顺序就是调整后的页面顺序。
例如,一份包含 4 页的 PDF,使用以下数组:
new int[] { 1, 0, 2, 3 }其对应关系如下:
调整后的位置 | 数组中的索引 | 对应原文档页面 |
|---|---|---|
第 1 页 | 1 | 原第 2 页 |
第 2 页 | 0 | 原第 1 页 |
第 3 页 | 2 | 原第 3 页 |
第 4 页 | 3 | 原第 4 页 |
也就是说,这个数组将前两页互换,后两页保持原来的顺序。
本文讨论的是保留全部页面的重排,因此构造数组时,应包含原文档的所有页面索引,每个索引恰好出现一次,且取值范围为 0 到 pdf.Pages.Count - 1。
三、按自定义顺序调整 PDF 页面
自定义排序适合已经明确目标页序的场景,例如交换前两页,或者将封面移动到文档开头。
下面以一份 恰好包含 4 页 的 PDF 为例,将原来的第 2 页放在第 1 页之前,输出页序为:原第 2 页、原第 1 页、原第 3 页、原第 4 页。
using Spire.Pdf;

// 创建文档对象并加载 PDF
PdfDocument pdf = new PdfDocument();
pdf.LoadFromFile("input.pdf");

// 按原页面索引重排:交换前两页
pdf.Pages.ReArrange(new int[] { 1, 0, 2, 3 });

// 保存为新文件并关闭文档
pdf.SaveToFile("ChangeOrder.pdf");
pdf.Close();
代码的处理过程可以分为三步:
- 通过
LoadFromFile()加载原始 PDF。 - 调用
pdf.Pages.ReArrange(),按照数组给出的原页面索引重新排列页面。 - 使用
SaveToFile()保存结果,再调用Close()关闭文档。
如果希望将这份 4 页文档的最后一页移到最前面,只需将数组改成 { 3, 0, 1, 2 }。
需要注意,示例中的数组是针对 4 页文档写死的。处理其他页数的文件时,应根据实际页数构造完整数组,不能直接套用。
四、将 PDF 页面整体倒序
如果需要将最后一页放到最前面,倒数第二页放到第二位,直到原来的第一页位于文档末尾,可以根据总页数自动生成倒序数组。
与手动填写数组相比,这种方式更适合页数不同的文档。
using Spire.Pdf;
using System.Linq;

// 创建文档对象并加载 PDF
PdfDocument pdf = new PdfDocument();
pdf.LoadFromFile("Input.pdf");

// 获取总页数
int pageCount = pdf.Pages.Count;

// 生成倒序页面索引
int[] reverseOrder = Enumerable.Range(0, pageCount)
    .Reverse()
    .ToArray();

// 按倒序索引重排页面
pdf.Pages.ReArrange(reverseOrder);

// 保存为 PDF 文件并关闭文档
pdf.SaveToFile("Reversed.pdf", FileFormat.PDF);
pdf.Close();
倒序数组的生成过程如下:
Enumerable.Range(0, pageCount):从 0 开始生成pageCount个连续整数,即全部页面索引。Reverse():将索引序列反转。ToArray():将结果转换成ReArrange()所需的整数数组。
例如,原文档有 5 页,生成的索引先是 { 0, 1, 2, 3, 4 },反转后变为 { 4, 3, 2, 1, 0 },输出文档的页面顺序也随之变为原第 5、4、3、2、1 页。
五、实际使用时需要注意的问题
1. 页面顺序与页面上的页码文字是两回事
页面重排改变的是页面在文档中的位置,不会根据新位置重新编写页眉、页脚中的页码文字。例如,原第 5 页移动到最前面后,页面上原有的“第 5 页”仍然需要另行处理。
如果文档包含目录、书签或内部跳转链接,输出后也应检查其指向是否符合预期,不能仅凭页面顺序正确就认为全部导航内容已经同步更新。
2. 自定义数组应与实际页数匹配
对于保留全部页面的排序操作,建议在调用前检查数组长度、索引范围以及是否存在重复值。数组中的数字表示原页面索引,不能直接填写从 1 开始的阅读页码。
3. 使用不同的输入和输出路径
示例将结果保存为新文件,便于对照检查。检查时可以先确认页数,再核对第一页、最后一页及被移动的页面。
4. 区分示例代码与正式项目代码
本文省略了异常处理,以突出页面重排的核心逻辑。正式项目还应处理输入路径无效、文件读取失败或输出目录不可写等情况,并确保异常发生时也能关闭文档、释放相关资源。
此外,Spire.PDF for .NET 与 Free Spire.PDF for .NET 是不同的包。使用试用授权或免费版本时,应核对所用版本的授权说明和处理限制,避免将这些限制误认为页面重排逻辑的问题。
六、总结
使用 Spire.PDF for .NET 调整 PDF 页序的关键,是构造一个表示目标顺序的原页面索引数组。已知目标页序时,可以直接指定数组;整份倒序时,则可以根据 Pages.Count 生成索引序列,再通过 LINQ 反转。
无论采用哪一种方式,都需要注意索引从 0 开始,并在保存后检查实际页序及文档导航内容。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号