心理访谈转录平台构建:流式VAD采集、声纹聚类、WebSocket实时推送全链路项目解析27.0
原创
心理访谈转录平台构建:流式VAD采集、声纹聚类、WebSocket实时推送全链路项目解析27.0
原创
未闻花名
发布于 2026-11-07 16:35:40
发布于 2026-11-07 16:35:40
一、前言
青少年心理辅导沟通存在一个现实痛点:咨询师在现场沟通时,既要专注倾听、共情回应,又要手动记录对话内容,很容易分心,遗漏关键情绪信息。人工记录效率低,事后整理访谈笔录耗时巨大;而纯录音回放整理,无法快速定位对话片段、区分对话双方,也缺少风险标记、情绪标签、跟进备注等心理工作需要的业务能力。
基于青少年心理监测项目继续分析项目里面的对话转录存档后台系统,应用FastAPI搭建后端服务,结合FunASR离线语音识别、VAD语音端点检测、CAM++声纹说话人分离,搭配前端Web Audio API完成浏览器端实时收音、流式切分,通过WebSocket将转录结果实时推送到心理老师后台页面。
系统支持两种采集模式:一是流式实时收录,老师开启麦克风,前端VAD自动切分语音片段,逐段上传识别,边对话边出文字;二是完整音频上传转录,上传整段录音,后端一次性完成识别与说话人聚类。数据库存储会话元信息、逐句转录文本、声纹编号、音频文件、老师备注、审计日志。老师后台可人工修正转录文字、重判说话人、标记风险等级、标注情绪标签、填写辅导备注,支持会话筛选、检索、导出。
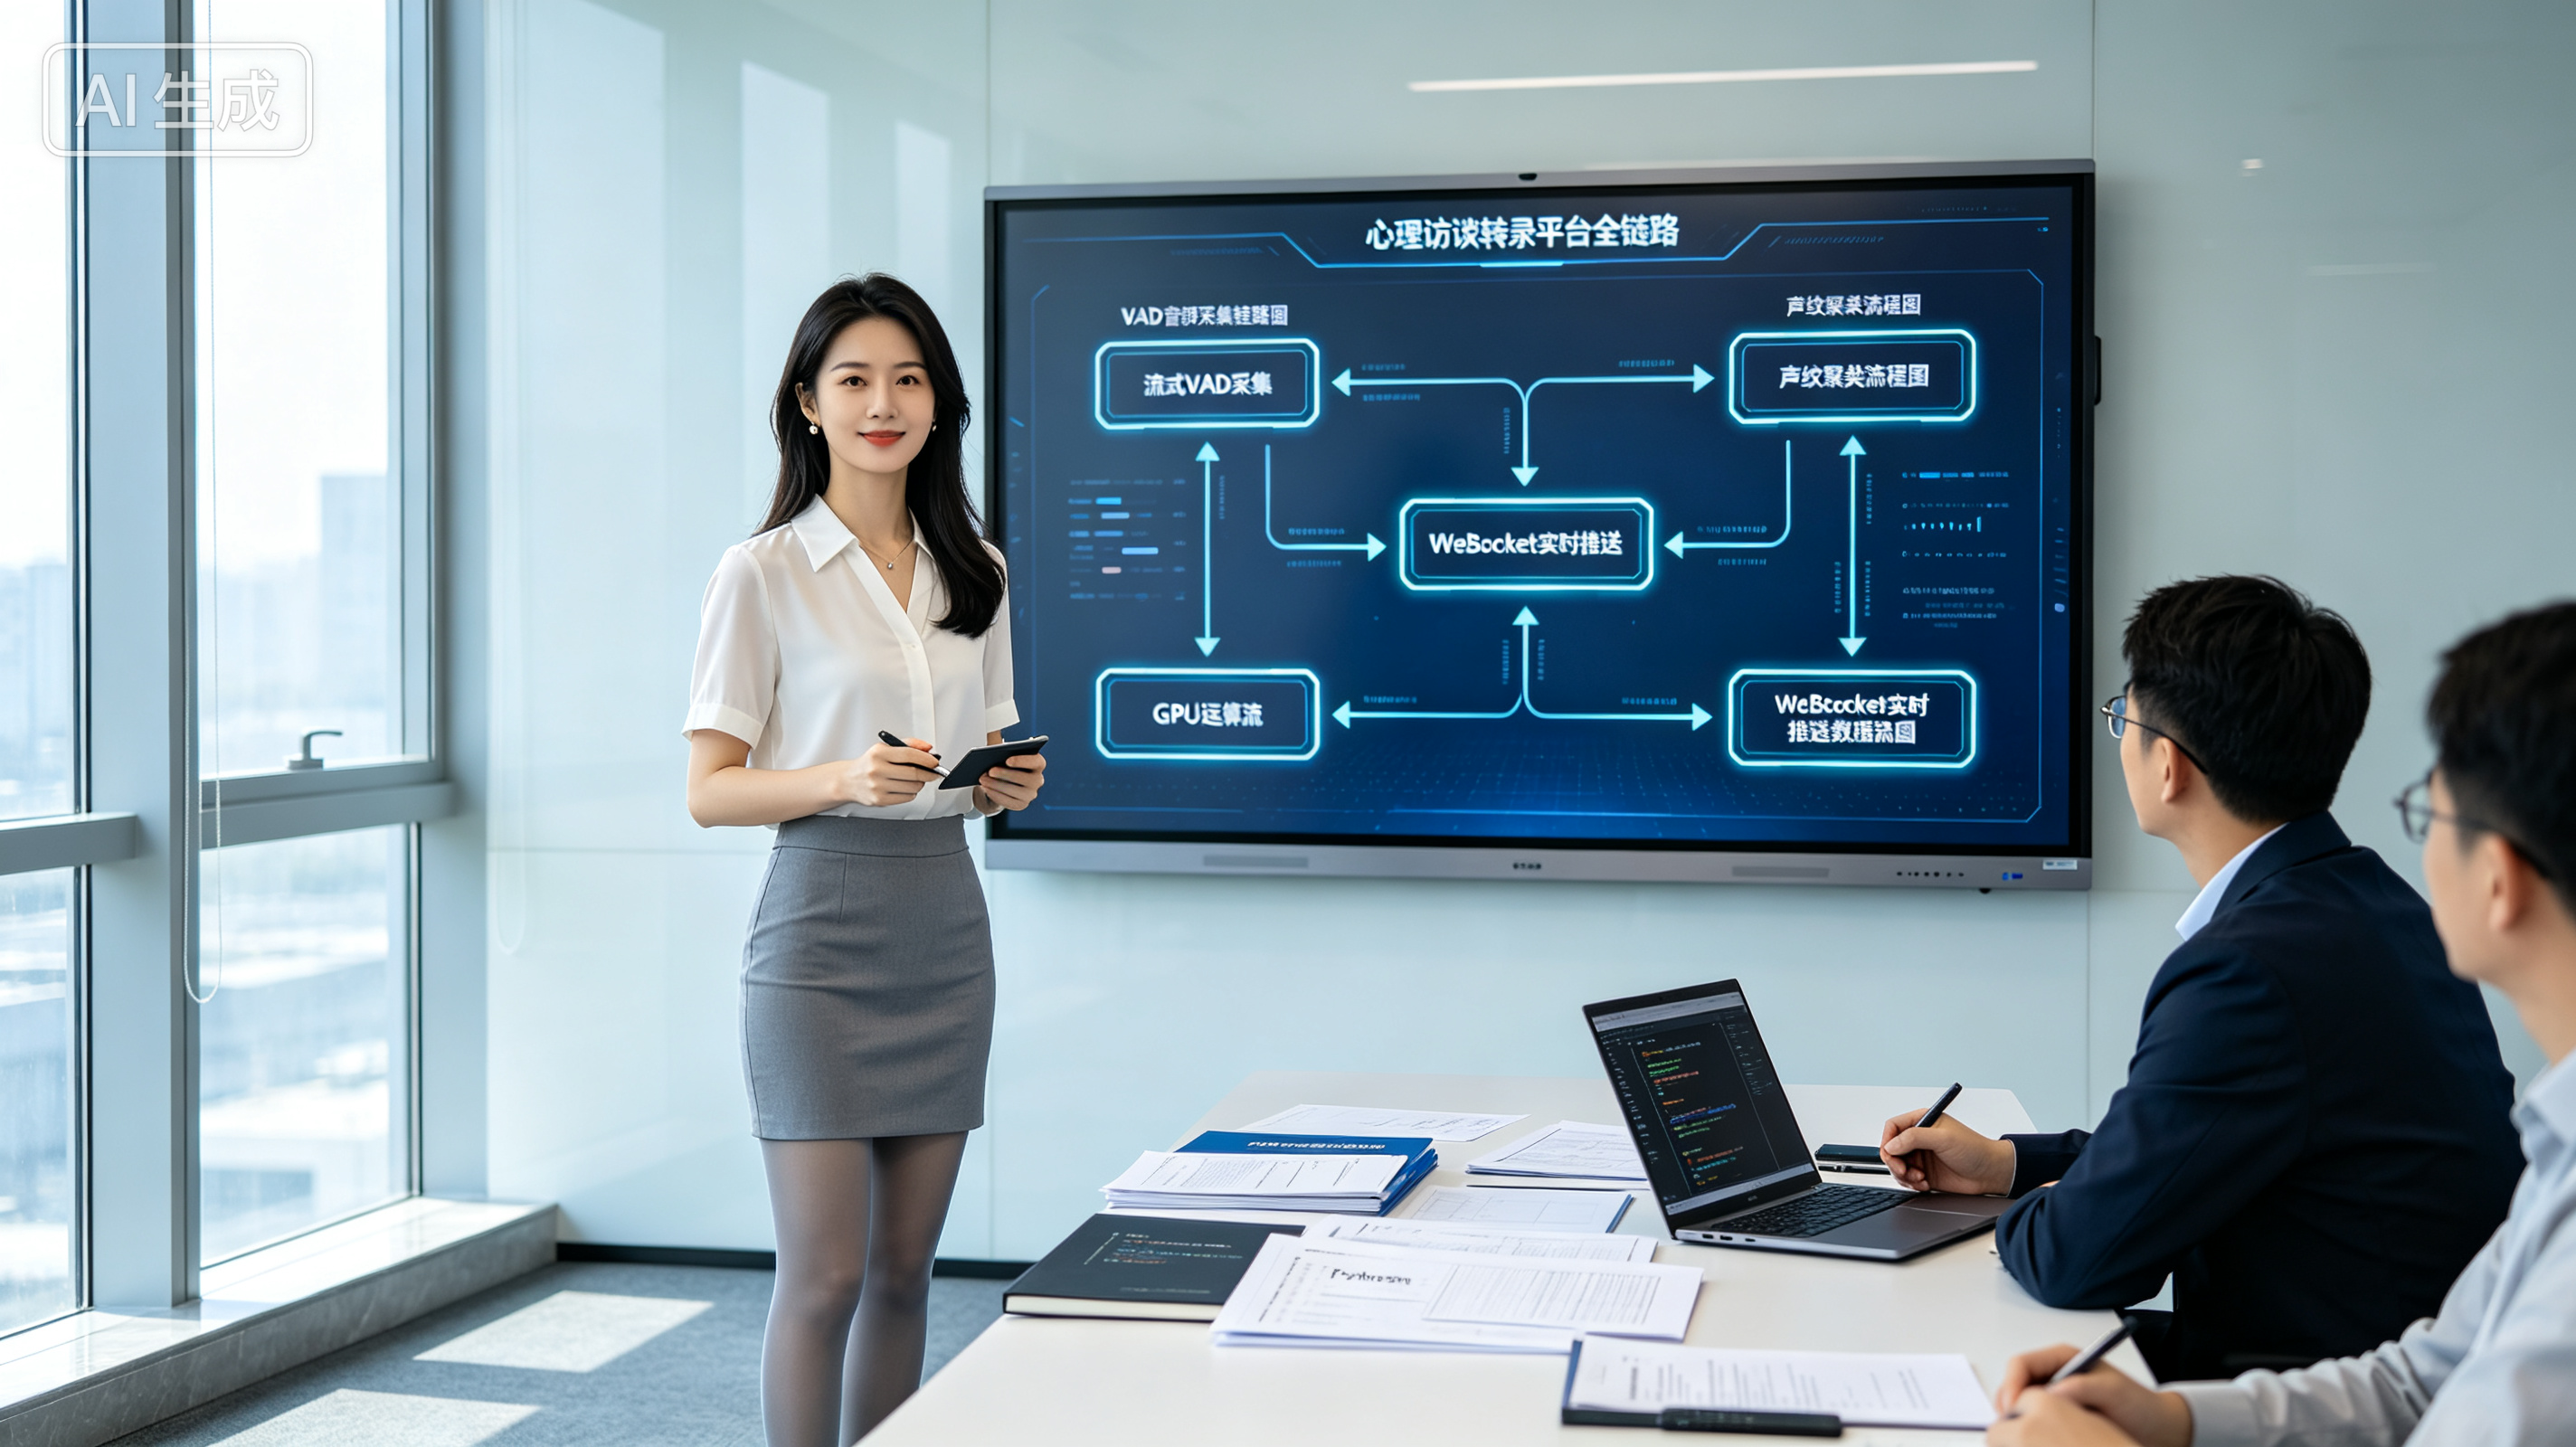
二、系统整体架构
1. 整体业务流程
整套系统分为三层:前端交互层、后端业务服务层、AI语音能力层。
前端层:浏览器获取麦克风音频,Web Audio做音频采样、VAD静音检测,切割成短语音片段;片段通过FormData上传后端;WebSocket订阅消息,接收实时转录结果渲染页面,同时提供会话列表、转录查看、人工编辑、风险/标签管理界面。
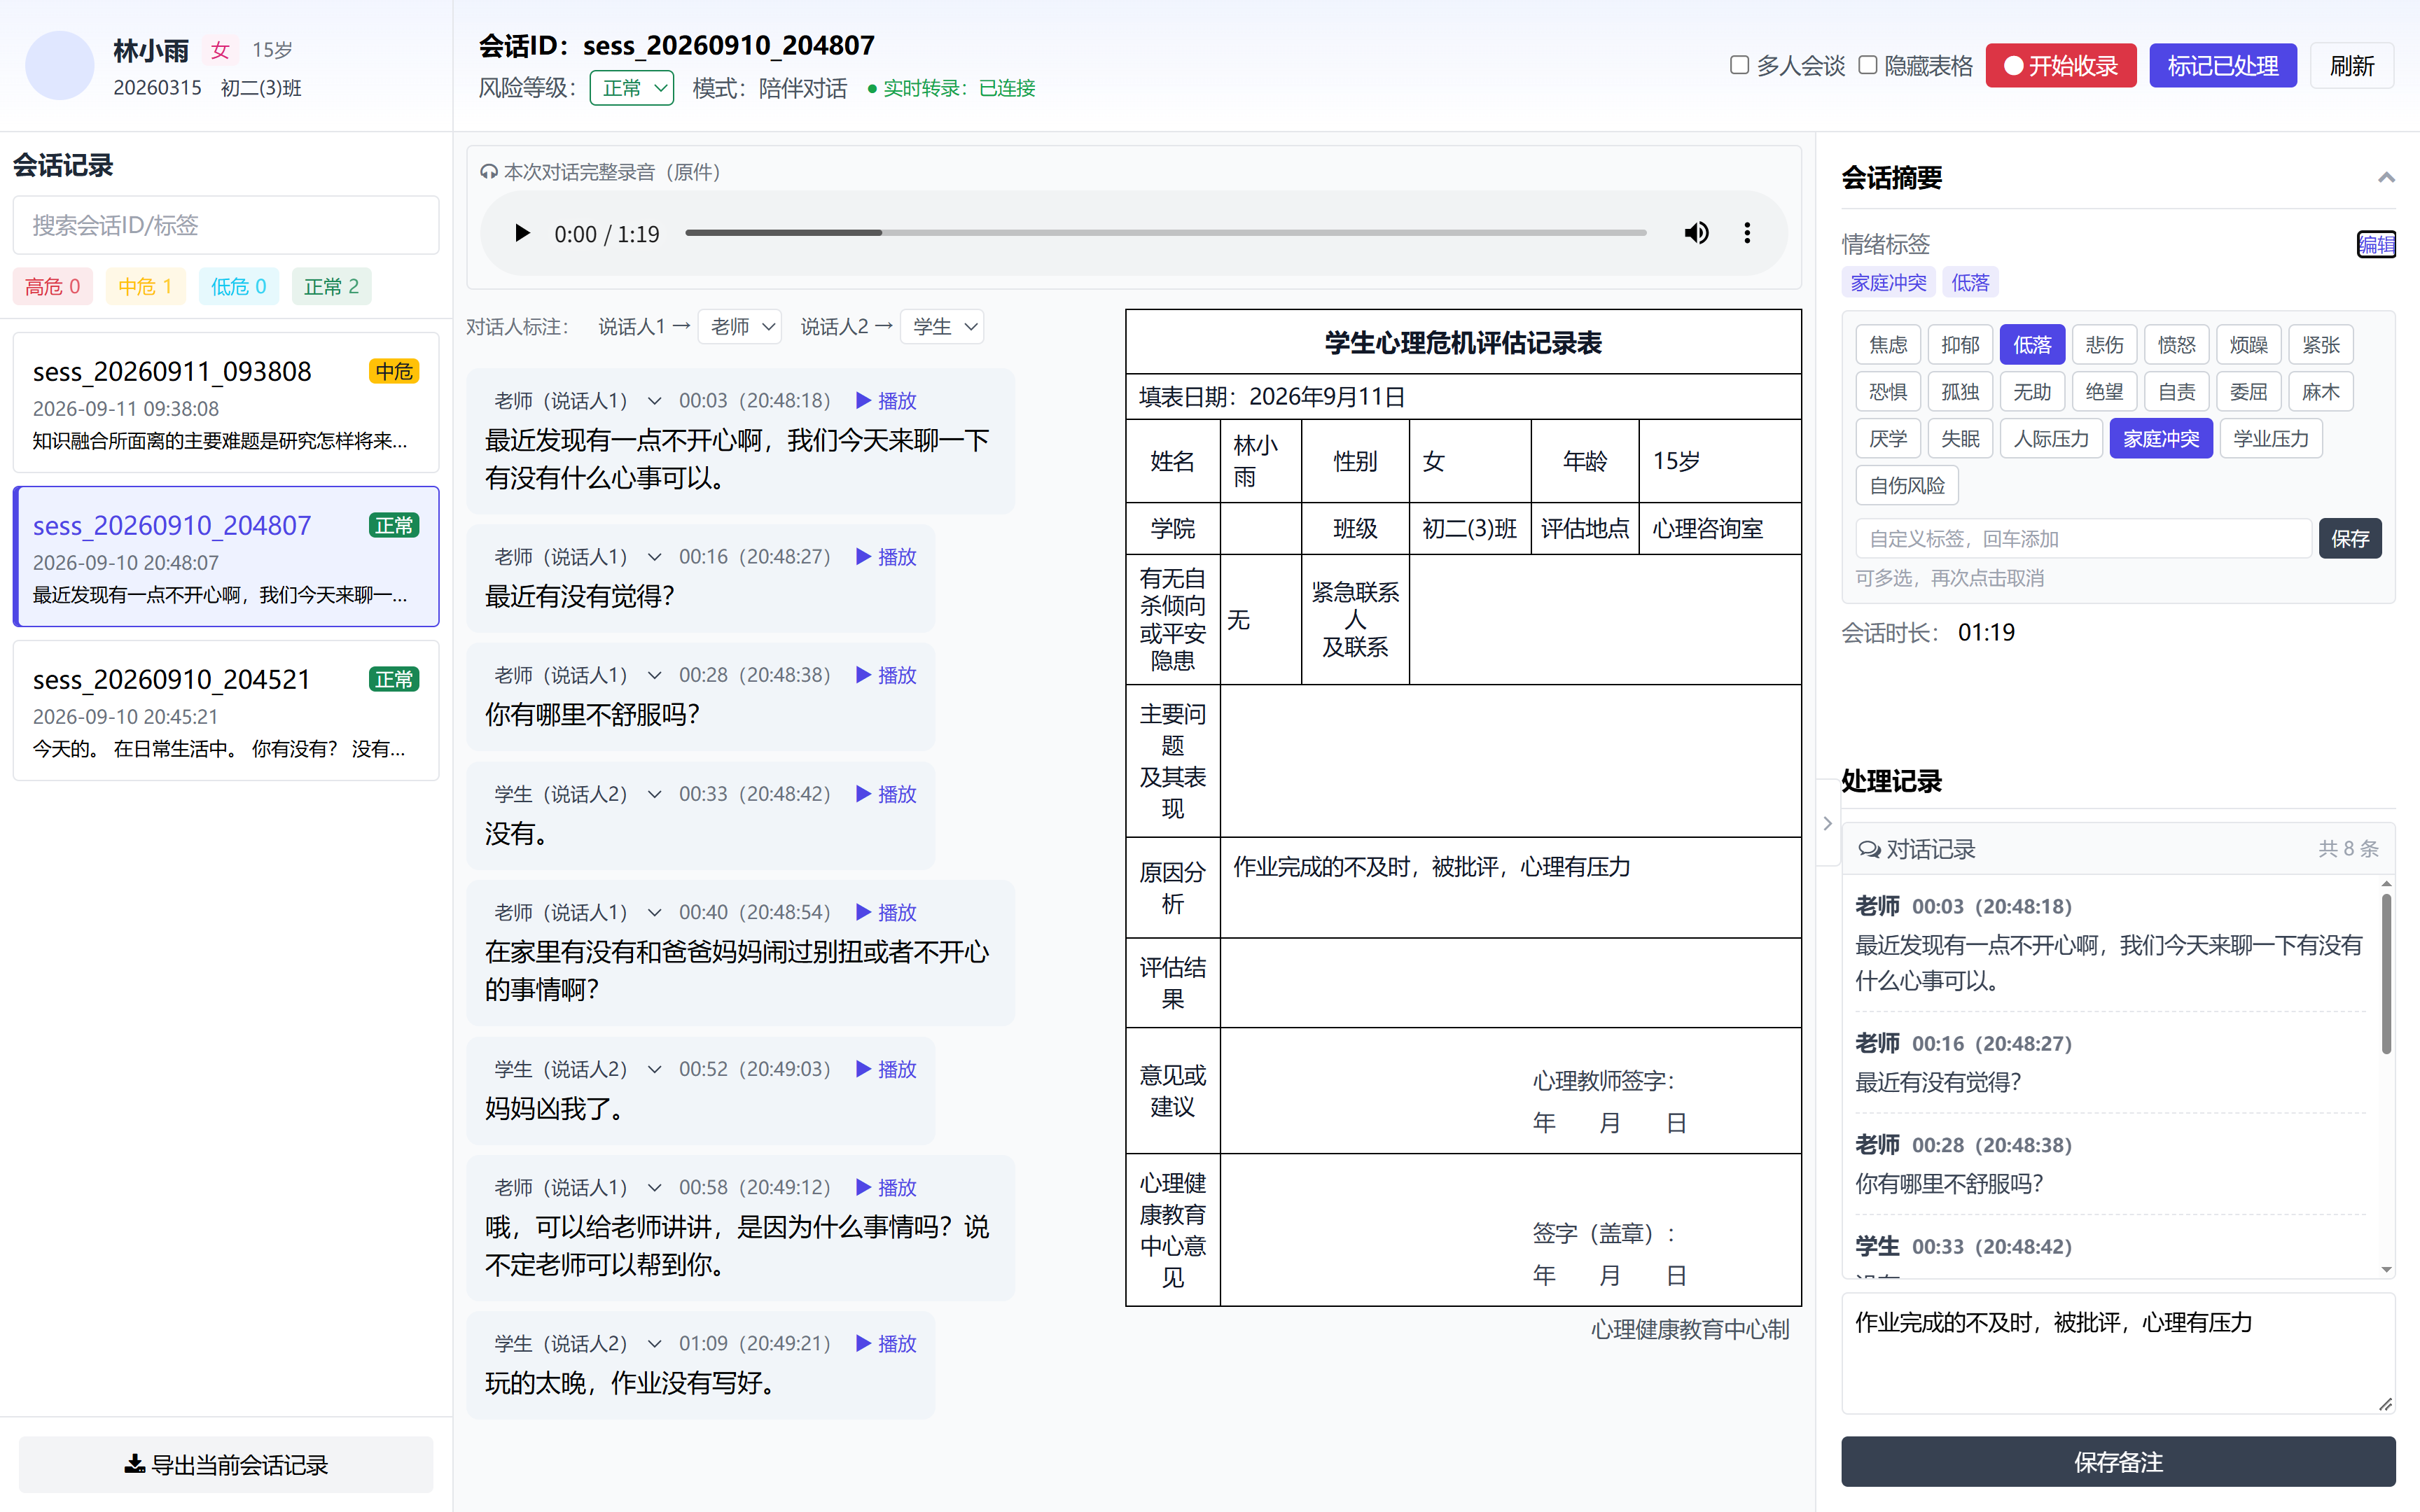
后端服务层:FastAPI接口服务,提供会话创建、音频上传、转录存储、会话查询、备注保存、消息编辑接口;维护WebSocket广播中心;管理SQLite数据库;异步任务处理完整音频的批量转录。
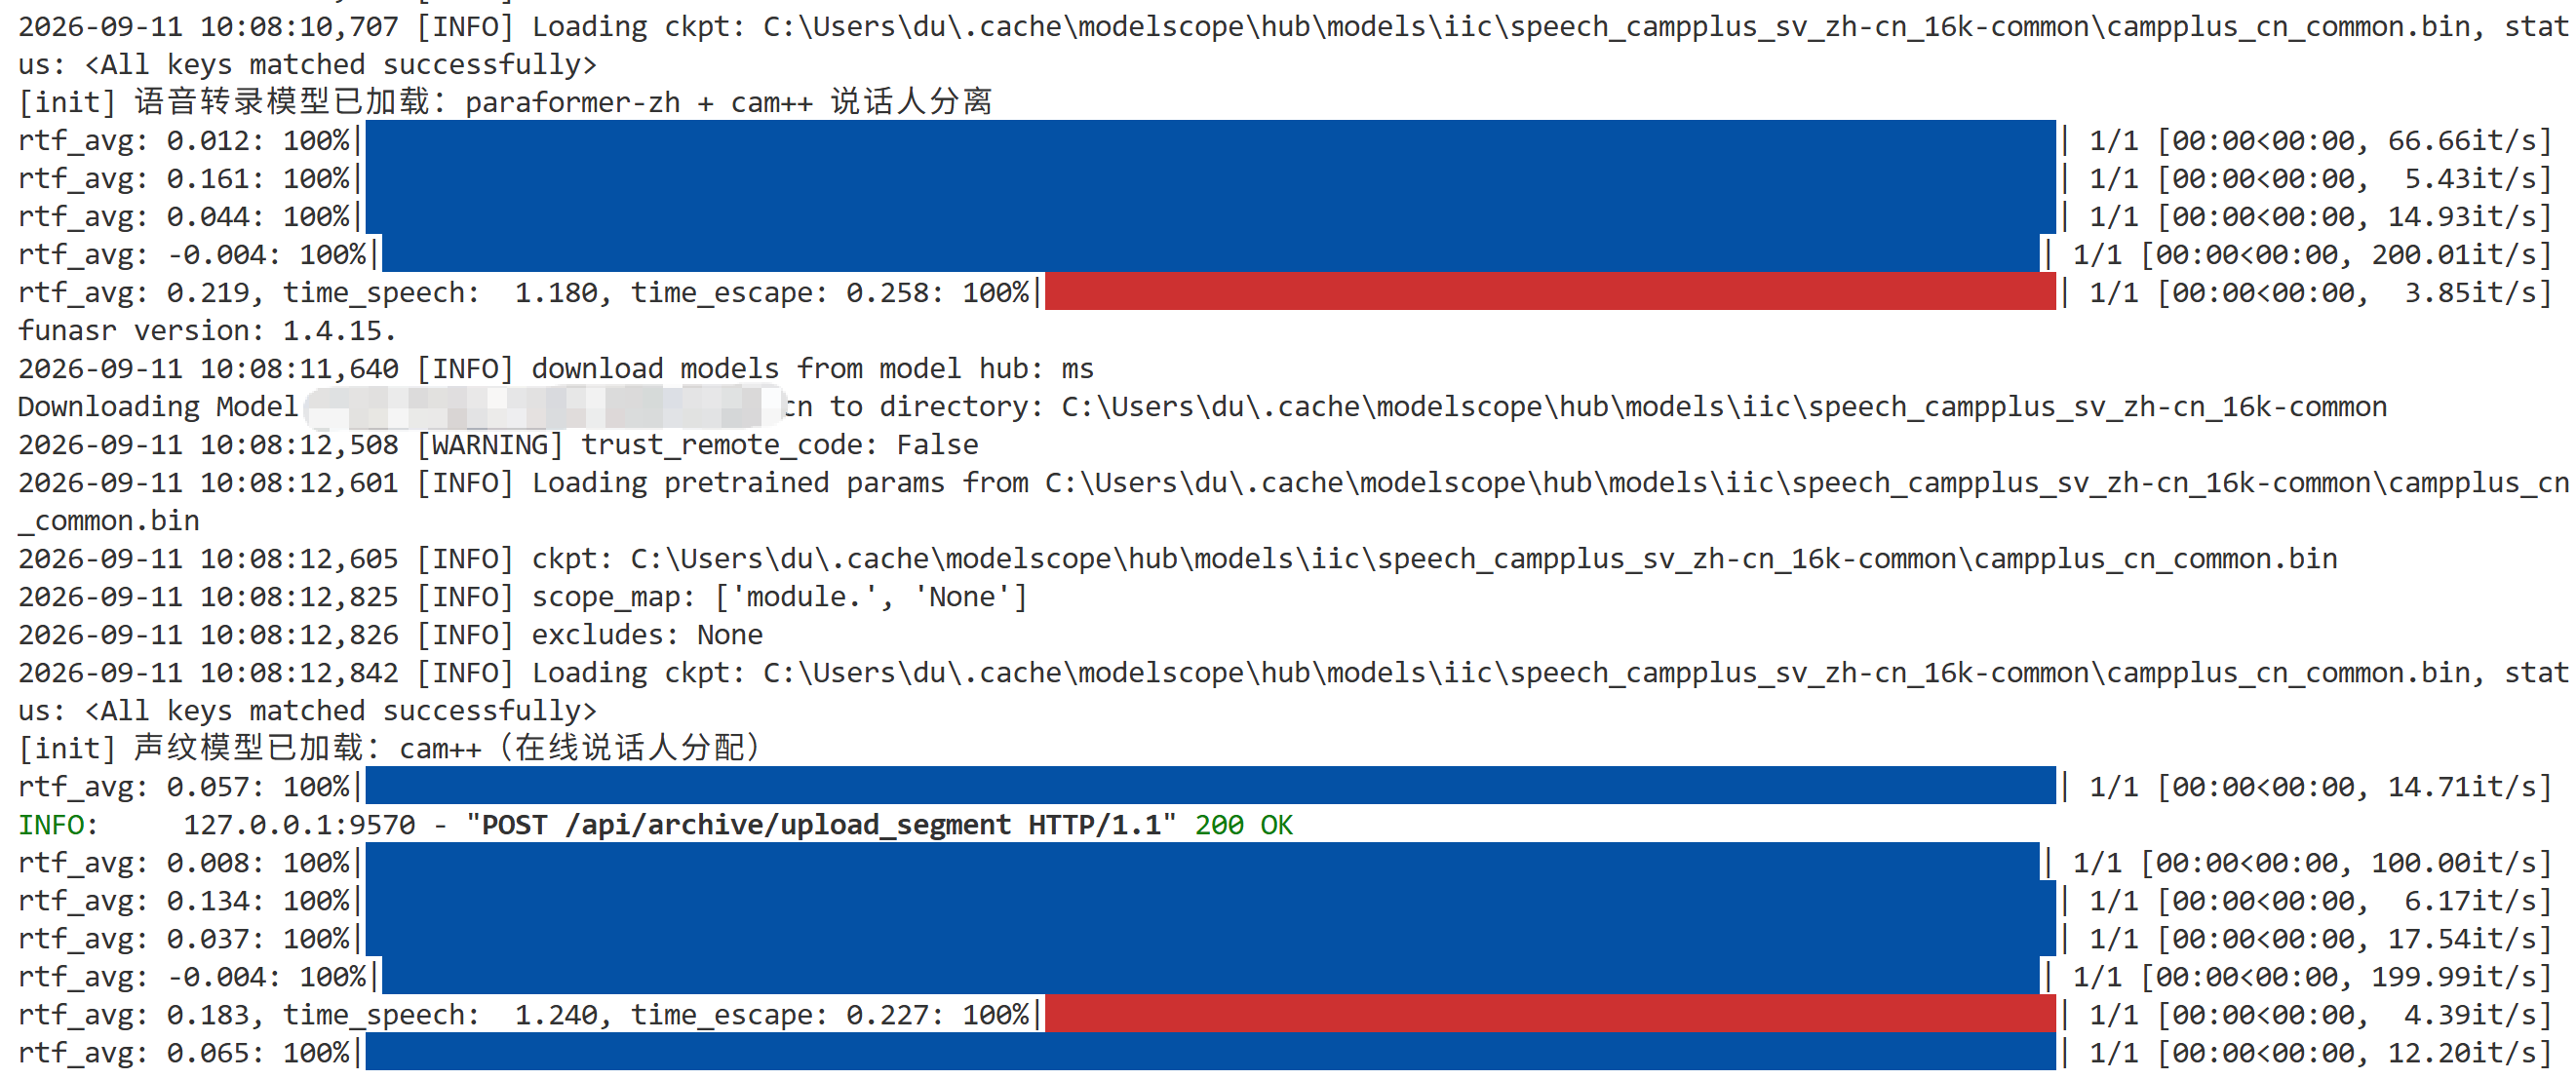
AI语音层:FunASR模型流水线,包含Paraformer语音识别、FSMN VAD、标点恢复、CAM++声纹提取与说话人聚类,支持流式片段识别和整段音频全局聚类精修。数据流主线(流式实时收录模式):

麦克风采集音频 → 前端VAD切分语音片段 → 分片上传/api/archive/upload_segment → 后端转码16k单声道WAV → ASR识别文本、CAM++提取声纹 → 声纹分配说话人spk编号 → 写入数据库消息表 → WebSocket广播消息推送到前端页面渲染。
会话结束时,前端上传完整录音,后端执行全局Agglomerative层次聚类,修正实时阶段声纹分配产生的碎片说话人编号,统一修正库内所有句子speaker字段。
2. 数据库设计概述
项目采用SQLite单文件数据库,轻量易部署,适合单机原型场景,共4张数据表:
- 1. sessions会话主表:存储会话ID、风险等级、会话模式、创建更新时间、处理标记、摘要、转录状态、完整音频路径。
- 2. session_messages消息转录表:单条对话记录,关联会话ID,存储角色、文本、音频路径、说话人编号、起止毫秒时间戳。
- 3. teacher_notes老师备注表:保存老师手写跟进备注,附带对话快照,备注修改可追溯。
- 4. audit_logs审计日志表:记录所有老师操作,查看会话、修改文字、修改风险、保存标签、保存备注全部留痕,满足心理访谈记录溯源需求。
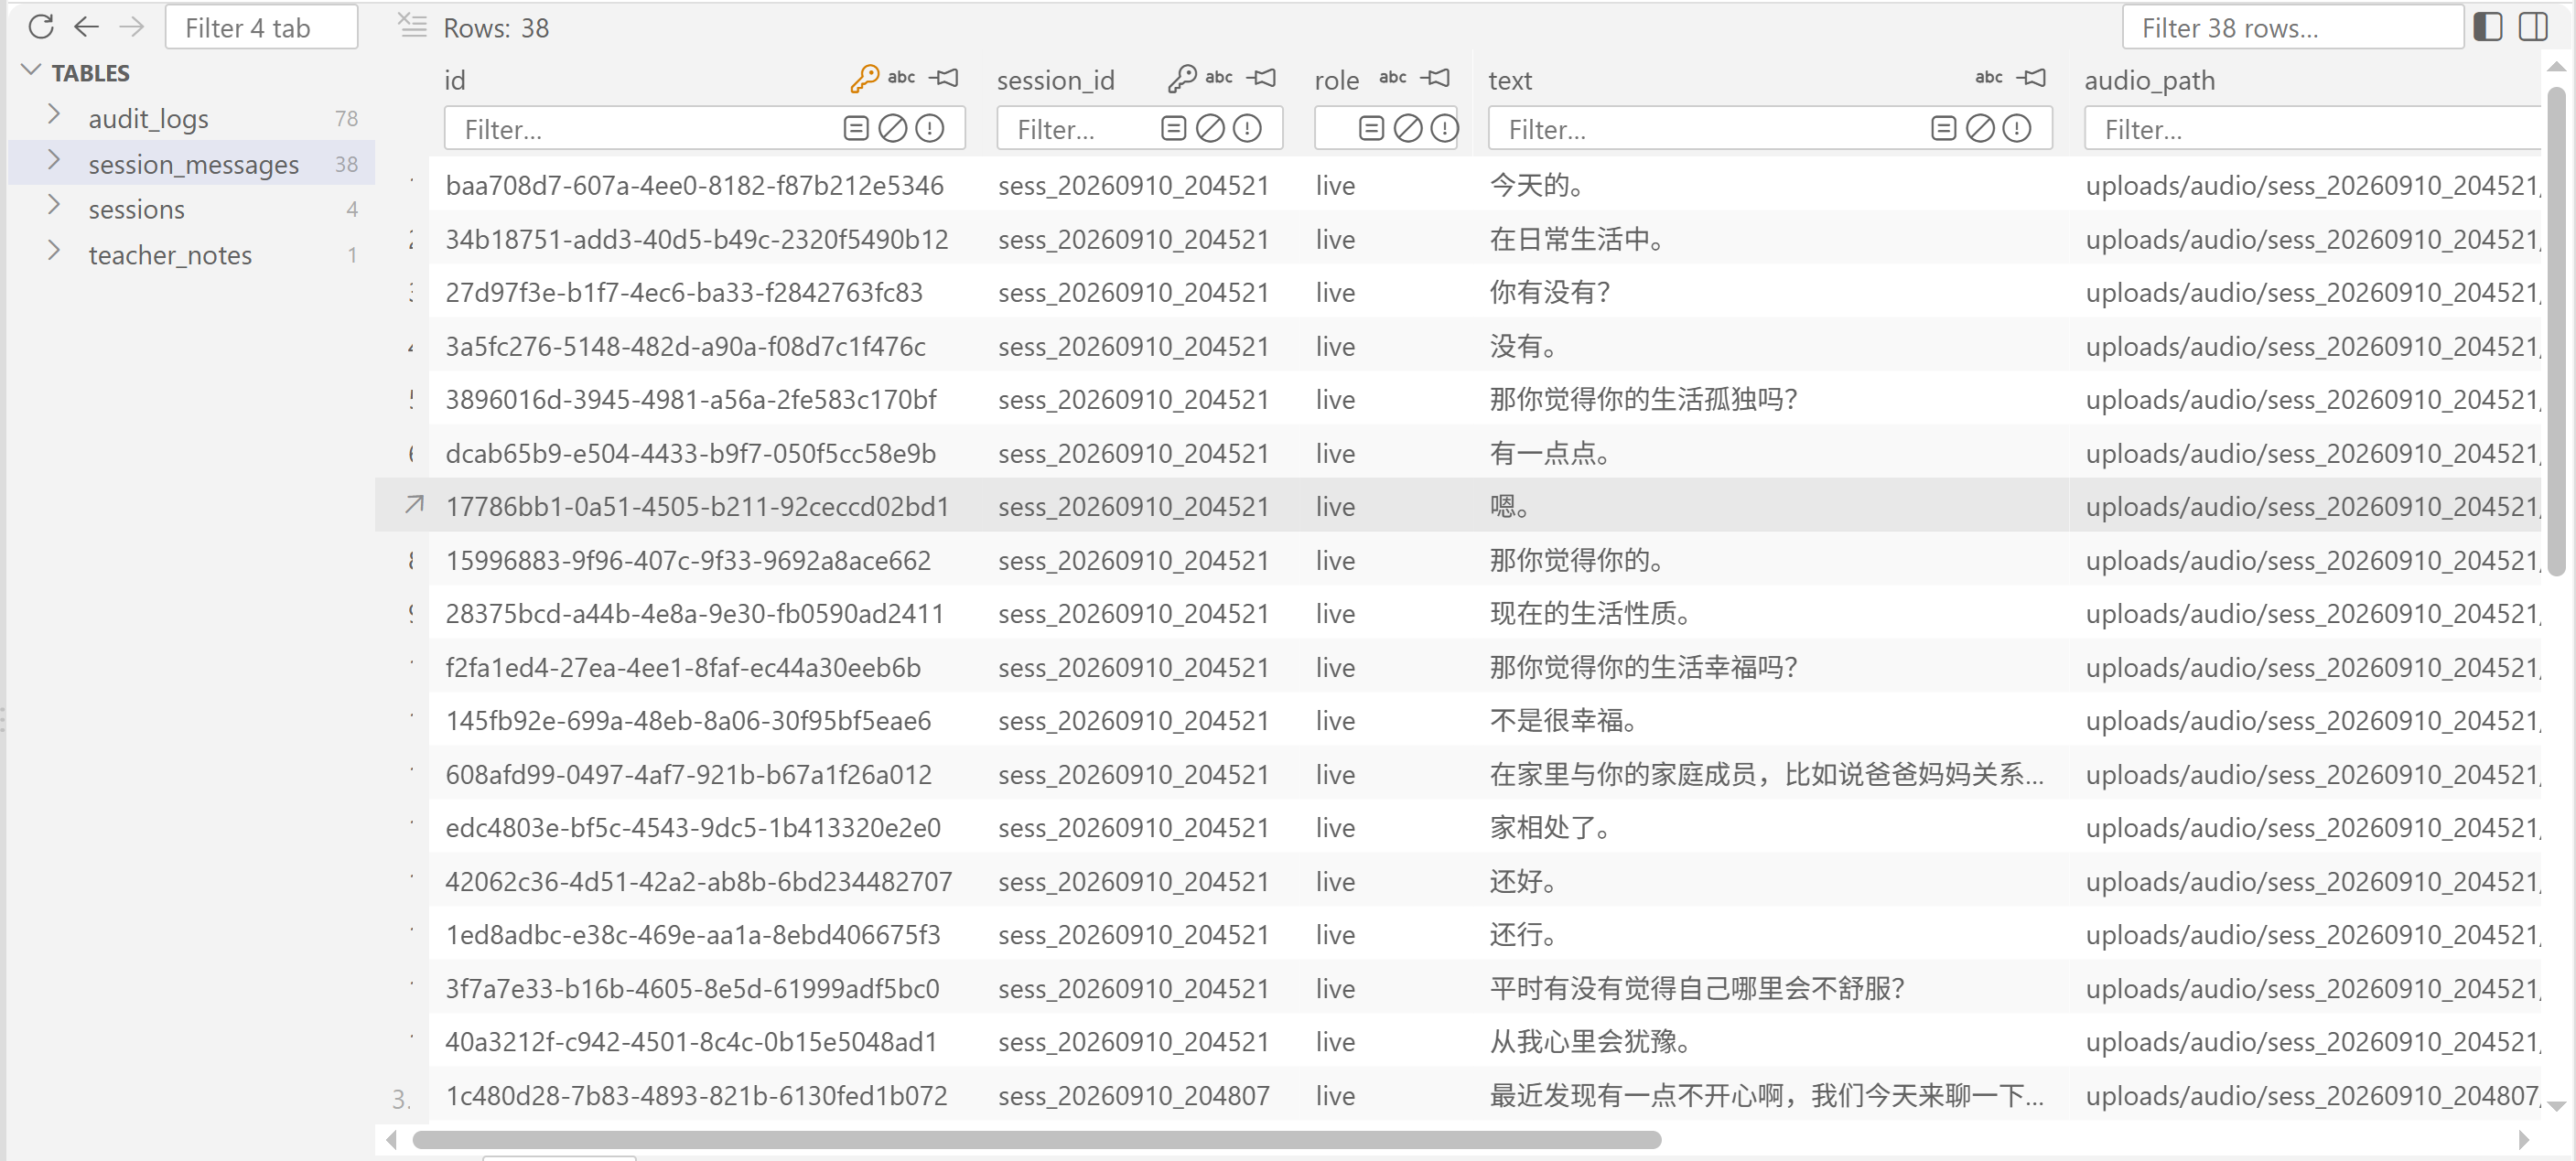
实践示例:数据库模型定义
# 会话主表
class DBSession(Base):
    __tablename__ = "sessions"
    id = Column(String, primary_key=True, index=True)
    risk_level = Column(String, default="none")
    mode = Column(String, default="chat")
    created_at = Column(DateTime, default=datetime.utcnow)
    updated_at = Column(DateTime, default=datetime.utcnow, onupdate=datetime.utcnow)
    handled = Column(Boolean, default=False)
    summary_text = Column(Text, default="")
    emotion_tags = Column(Text, default="")
    transcribe_state = Column(String, default="idle")
    full_audio_path = Column(String, nullable=True)

# 对话消息转录表
class DBSessionMessage(Base):
    __tablename__ = "session_messages"
    id = Column(String, primary_key=True)
    session_id = Column(String, ForeignKey("sessions.id"))
    role = Column(String)
    text = Column(Text)
    audio_path = Column(String, nullable=True)
    speaker = Column(String, nullable=True)
    start_ms = Column(Integer, nullable=True)
    end_ms = Column(Integer, nullable=True)
    created_at = Column(DateTime, default=datetime.utcnow)
3. 项目依赖清单
后端核心依赖:FastAPI、uvicorn、SQLAlchemy、pydantic、funasr、numpy、scikit-learn、ffmpeg。 前端原生JS,无Vue/React框架,直接原生DOM开发,降低部署门槛,单HTML页面托管。
基础安装示例:
pip install fastapi uvicorn sqlalchemy pydantic funasr numpy scikit-learn
# ffmpeg单独安装,用于音频转码
三、后端FastAPI服务实现
1. WebSocket实时广播模块
心理辅导场景需要实时推送转录文字,老师后台页面不需要轮询查询会话,通过WebSocket长连接实现消息广播。后端维护WsHub连接管理器,保存所有在线老师客户端连接。每当新的转录消息入库,自动向全部已连接客户端推送JSON消息;前端判断消息会话ID与当前打开会话一致,追加渲染转录文本。
实践示例:WebSocket Hub管理
class WsHub:
    def __init__(self):
        self.clients: List[WebSocket] = []
    async def connect(self, ws: WebSocket):
        await ws.accept()
        self.clients.append(ws)
    def disconnect(self, ws: WebSocket):
        if ws in self.clients:
            self.clients.remove(ws)
    async def broadcast(self, payload: dict):
        dead = []
        for c in self.clients:
            try:
                await c.send_json(payload)
            except Exception:
                dead.append(c)
        for d in dead:
            self.disconnect(d)
hub = WsHub()

@app.websocket("/ws/transcript")
async def ws_transcript(ws: WebSocket):
    await hub.connect(ws)
    try:
        while True:
            await ws.receive_text()
    except WebSocketDisconnect:
        hub.disconnect(ws)
    except Exception:
        hub.disconnect(ws)
设计要点:
- 广播循环捕获发送异常,失效连接自动清理,防止死连接堆积内存泄漏。
- 客户端消息仅用作心跳保活,后端不解析客户端上行业务数据。
- 推送消息携带session_id,多会话并行收录时,前端只渲染当前选中会话内容,避免跨会话消息污染界面。
2. 核心业务接口分层
后端接口分为两大模块:
- 智能体写入接口:/api/archive/save_msg,供外部智能体服务写入对话文本。
- 老师后台接口:会话列表查询、会话详情查看、保存备注、情绪标签、风险等级修改、单句转录文本/说话人编辑、会话导出。
- 音频收录接口:创建会话、上传语音片段、上传完整音频、结束会话精修。
接口统一使用Pydantic校验入参,数据库操作通过SQLAlchemy会话管理,get_db依赖函数自动创建、释放数据库连接。
实践示例:单句消息修改接口,支持修改文本与说话人
class UpdateMsgTextReq(BaseModel):
    msg_id: str
    text: Optional[str] = None
    speaker: Optional[str] = None
    teacher_account: Optional[str] = "teacher01"

@app.post("/api/teacher/message/update")
async def update_message_text(req: UpdateMsgTextReq, db: Session = Depends(get_db)):
    m = db.query(DBSessionMessage).filter(DBSessionMessage.id == req.msg_id).first()
    if not m:
        raise HTTPException(status_code=404, detail="消息不存在")
    old_text, old_spk = m.text, m.speaker
    if req.text is not None:
        m.text = req.text
    if req.speaker is not None:
        m.speaker = req.speaker
    db.add(DBAuditLog(id=str(uuid.uuid4()), operator=req.teacher_account,
                      action="edit_message", session_id=m.session_id))
    db.commit()
    print("[edit] %s: text %r -> %r | speaker %r -> %r" % (req.msg_id, old_text, m.text, old_spk, m.speaker))
    return {"ok": True, "msg_id": m.id, "text": m.text, "speaker": m.speaker}
业务特性:
- 每次人工编辑都会写入审计日志,记录操作人、操作类型、会话ID,满足心理咨询记录留痕规范。
- 文本、说话人两个字段独立可选,支持只改文字,或者只改说话人,不用每次提交全部字段。
3. 音频转码与WAV时长解析
前端浏览器录音输出webm格式,FunASR模型要求输入为16kHz、单声道WAV。后端调用ffmpeg子进程做格式采样率转换。同时实现轻量WAV文件头解析函数,直接读取WAV头信息计算音频时长,不需要解码全部音频,快速获取会话总时长。
def wav_duration_ms(path):
    try:
        with open(path, "rb") as f:
            head = f.read(12)
            if len(head) < 12 or head[0:4] != b"RIFF" or head[8:12] != b"WAVE":
                return None
            f.seek(12)
            channels = rate = bits = data_size = 0
            while True:
                hdr = f.read(8)
                if len(hdr) < 8:
                    break
                cid, csize = hdr[0:4], int.from_bytes(hdr[4:8], "little")
                if cid == b"fmt ":
                    body = f.read(csize)
                    if len(body) >= 16:
                        channels = int.from_bytes(body[2:4], "little")
                        rate = int.from_bytes(body[4:8], "little")
                        bits = int.from_bytes(body[14:16], "little")
                elif cid == b"data":
                    data_size = csize
                    break
                else:
                    f.seek(csize + (csize % 2), 1)
            if not (channels and rate and bits and data_size):
                return None
            return int(data_size / (channels * bits / 8) / rate * 1000)
    except Exception:
        return None
时长计算优先级:优先读取完整录音WAV真实时长;无完整音频时取消息最大end_ms;兜底取消息创建时间差。
四、AI语音识别与说话人分离
1. FunASR模型懒加载策略
项目使用FunASR套件,包含4个子模型:Paraformer大模型中文ASR、FSMN VAD、标点恢复CAM++声纹验证模型。 模型采用懒加载,服务启动不加载模型,第一次调用识别接口时才加载,避免服务启动耗时过长、占用内存。同时增加全局标记_asr_broken,模型加载失败后不再重试加载,降级为仅保存音频文件,不做语音识别,保证服务不会因为模型下载失败直接崩溃。
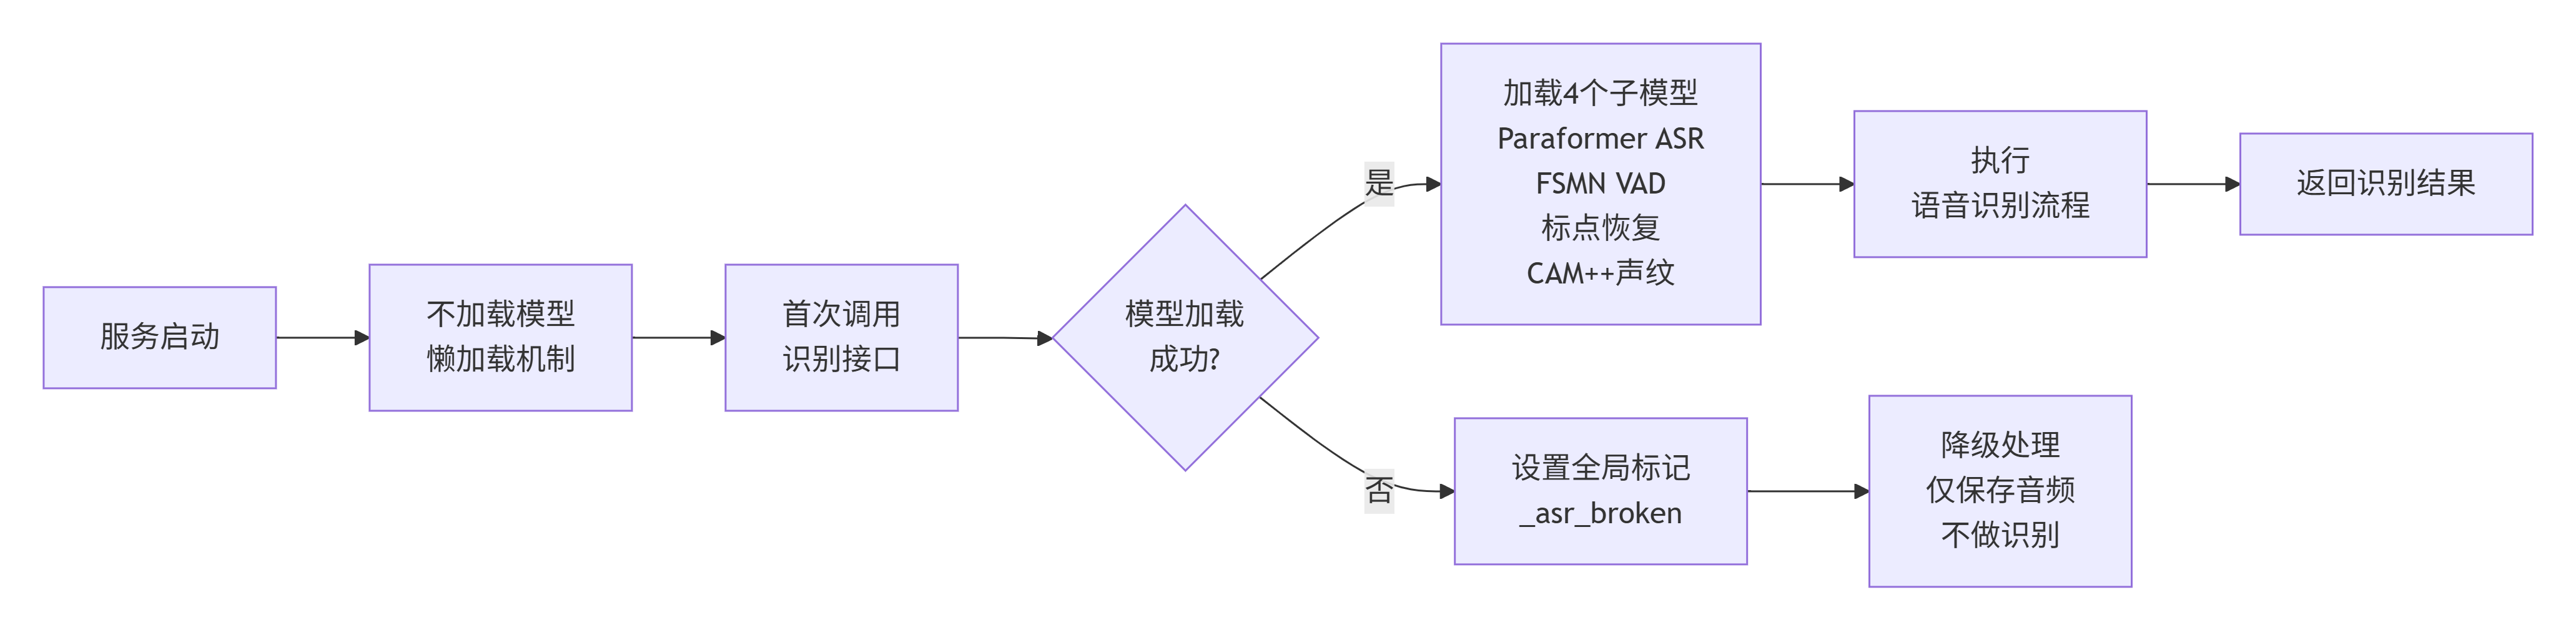
def get_asr_model():
    global _asr_model, _asr_broken
    if _asr_model is None and not _asr_broken:
        try:
            from funasr import AutoModel
            _asr_model = AutoModel(
                model="iic/speech_paraformer-large_asr_nat-zh-cn-16k-common-vocab8404-pytorch",
                vad_model="iic/speech_fsmn_vad_zh-cn-16k-common-pytorch",
                punc_model="iic/punc_ct-transformer_zh-cn-common-vocab272727-pytorch",
                spk_model="iic/speech_campplus_sv_zh-cn_16k-common",
                device="cpu", disable_update=True)
            print("[init] 语音转录模型已加载:paraformer-zh + cam++ 说话人分离")
        except Exception as e:
            _asr_broken = True
            print("[warn] 语音转录模型不可用(仅保存音频原件):", type(e).__name__, e)
    return _asr_model
2. 两段式说话人聚类
这是本项目核心创新设计,解决流式实时说话人识别痛点,核心采用快速响应实时分配,在会话结束后全局精修:
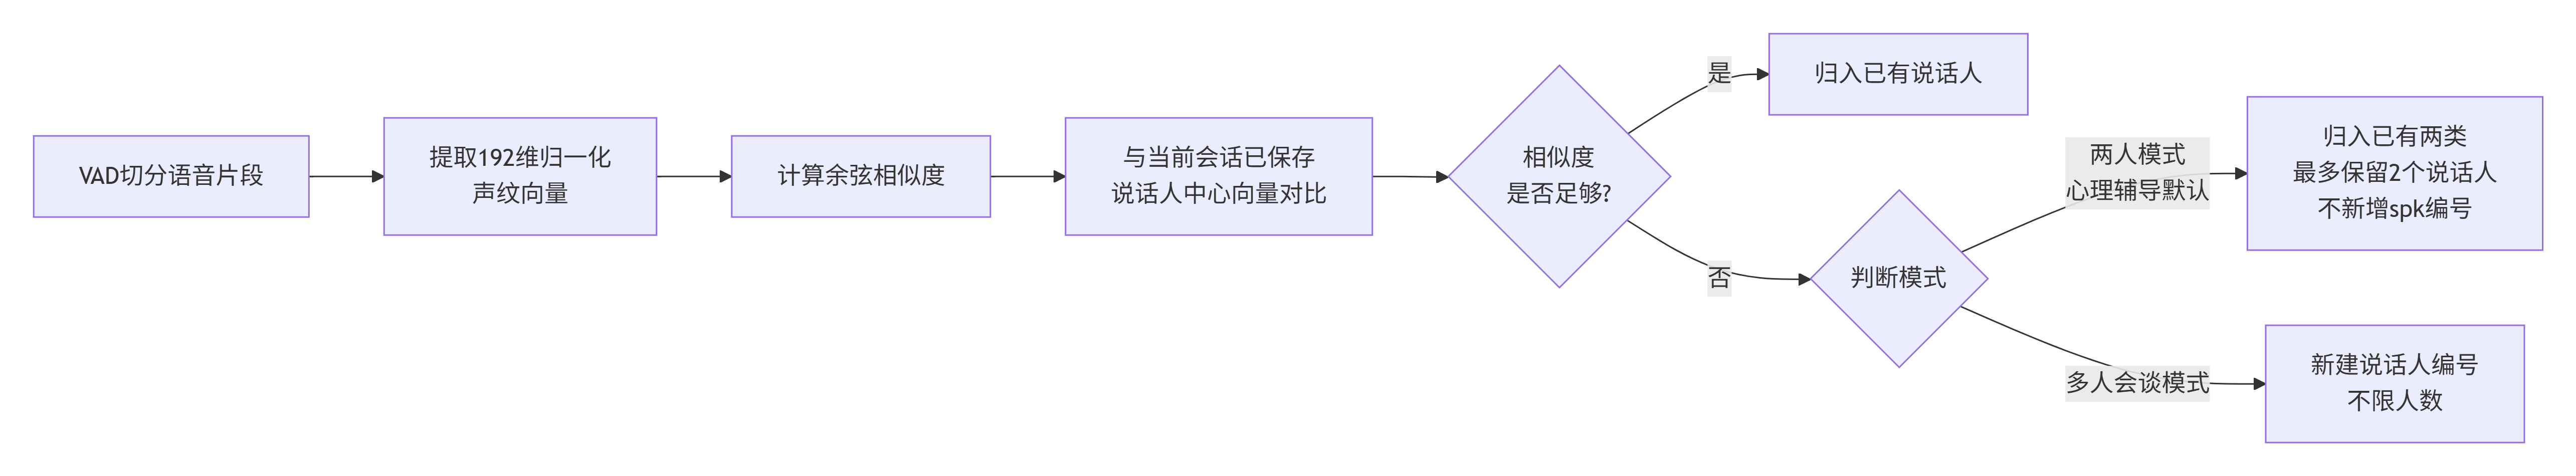
在线实时分配(片段上传阶段):每一段VAD切分出的语音片段提取192维归一化声纹向量,计算余弦相似度,和当前会话已保存的说话人中心向量对比。两人模式(心理辅导默认):最多保留2个说话人,新片段相似度不足阈值,直接归入已有两类,不会新增spk编号,避免同一个人被拆分成spk0/spk2/spk3。多人会谈模式:相似度不足阈值,新建说话人编号,不限人数。
会话结束全局聚类(refine_speakers):会话采集全部结束,收集所有片段声纹,使用AgglomerativeClustering层次聚类,重新全局分组,修正实时阶段分配错误、碎片编号。两人场景强制聚类为2类,保证只有老师、学生两个角色。 聚类完成,批量更新数据库所有消息speaker字段。
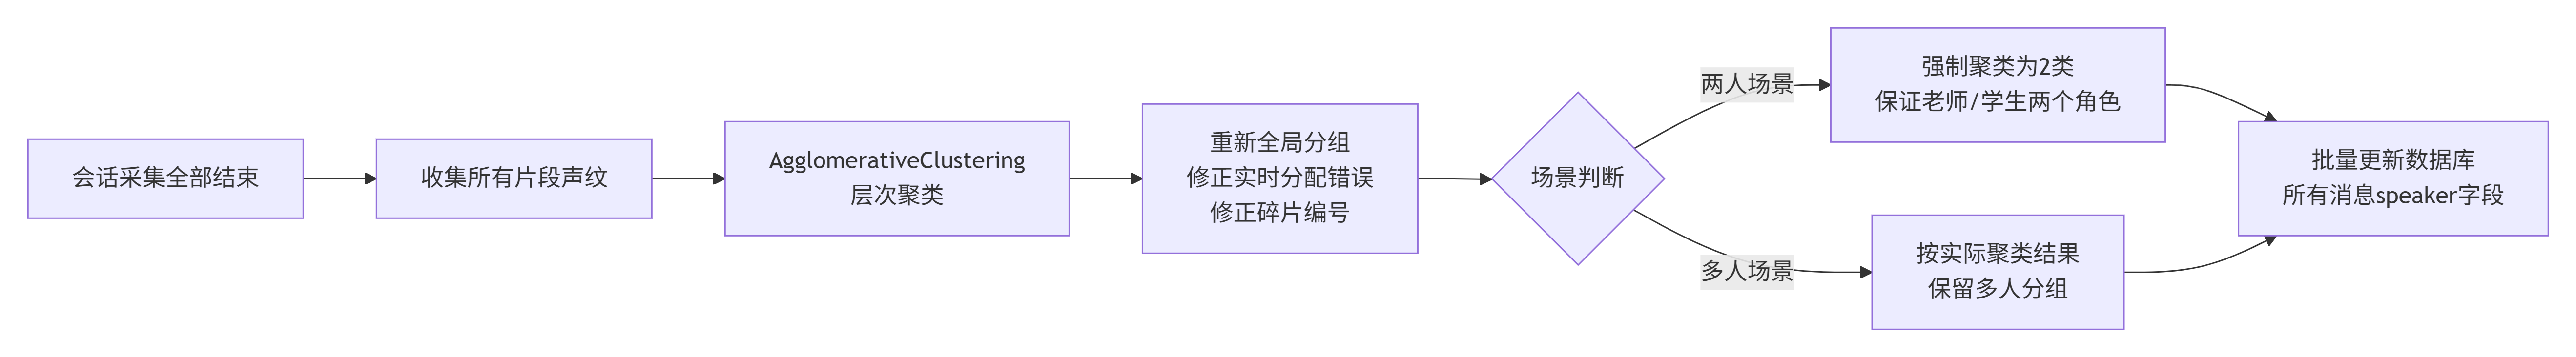
实践示例:声纹相似度匹配分配说话人
参数说明:SPK_THR=0.45余弦相似度阈值,cam++声纹,同一人相似度一般0.6~0.8,不同人0.2~0.3。阈值经过实测调优。
def assign_speaker(sid, emb):
    st = live_state(sid)
    if emb is None:
        return "spk0"
    max_spk = 0 if st.multi_party else TWO_PARTY_MAX
    with st.lock:
        best, best_sim = None, -1.0
        for spk, c in st.centers.items():
            sim = float(np.dot(emb, c))
            if sim > best_sim:
                best, best_sim = spk, sim
        if best is not None and best_sim >= SPK_THR:
            n = st.counts.get(best, 1)
            merged = st.centers[best] * n + emb
            norm = float(np.linalg.norm(merged))
            st.centers[best] = merged / norm if norm > 0 else emb
            st.counts[best] = n + 1
            return best
        if best is not None and max_spk and len(st.centers) >= max_spk:
            st.counts[best] = st.counts.get(best, 1) + 1
            return best
        spk = "spk%d" % len(st.centers)
        st.centers[spk] = emb
        st.counts[spk] = 1
        return spk
3. 转录后文本合并策略
ASR输出会产生大量短句碎片,后端在transcribe_diarized函数做相邻句子合并:同一个说话人,两段间隔小于1200ms,合并为同一条记录,减少界面碎片化短句,提升阅读体验。
def transcribe_diarized(wav_path):
    """整段音频 → 带说话人的句子列表 [{speaker, text, start_ms, end_ms}](按时间顺序)"""
    model = get_asr_model()
    if model is None:
        return []
    res = model.generate(input=wav_path, batch_size_s=300, return_spk_res=True)
    if not res:
        return []
    item = res[0]
    segs = item.get("sentence_info") or []
    out = []
    for s in segs:
        txt = (s.get("text") or "").strip()
        if not txt:
            continue
        out.append({
            "speaker": "spk%d" % int(s.get("spk", 0)),
            "text": txt,
            "start_ms": int(s.get("start", 0)),
            "end_ms": int(s.get("end", 0)),
        })
    if not out:   # 没有句子级信息时退化为整段文本
        txt = clean_asr_text(item.get("text", ""))
        if txt:
            out.append({"speaker": "spk0", "text": txt, "start_ms": 0, "end_ms": 0})

    # 同一说话人、间隔很短的相邻句子合并,避免碎句过多
    merged = []
    for seg in out:
        if merged and merged[-1]["speaker"] == seg["speaker"] and seg["start_ms"] - merged[-1]["end_ms"] < 1200:
            merged[-1]["text"] += seg["text"]
            merged[-1]["end_ms"] = seg["end_ms"]
        else:
            merged.append(dict(seg))
    return merged
4. 大模型分析提取
老师点“结束收录”的瞬间,服务端自动把带说话人标注的完整对话交给混元大模型,一次性产出心理辅导后的记录评估,约束大模型按指定格式输出,将匹配到的结果内容直接导入到评估记录单,实时推送到老师端,不需要老师做任何额外操作,提升效率。
# ===================== 腾讯混元大模型接入(TokenHub平台) =====================
from openai import OpenAI

api_key = os.environ.get('TENCENT_API_KEY')
llm_client = OpenAI(
    api_key=api_key,
    base_url="https://tokenhub.tencentmaas.com/v1",
)
model_name = "hy3-preview"


def llm_invoke(prompt: str, system_prompt: str = "你是一个专业的校园对话分析助手。请严格按照要求输出JSON格式结果,不要输出任何多余内容。") -> str:
    """调用腾讯混元大模型(同步阻塞,异步路由里请配合 asyncio.to_thread 使用)"""
    response = llm_client.chat.completions.create(
        model=model_name,
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": prompt},
        ],
        temperature=0.1,
    )
    return response.choices[0].message.content


def _extract_json(text: str) -> Optional[dict]:
    """从容错解析 LLM 返回的 JSON(容忍 ```json 包裹 / 前后多余文字)"""
    if not text:
        return None
    t = text.strip()
    m = re.search(r"```(?:json)?\s*(\{.*\})\s*```", t, re.S)
    if m:
        t = m.group(1)
    else:
        s, e = t.find("{"), t.rfind("}")
        if s >= 0 and e > s:
            t = t[s:e + 1]
    try:
        return json.loads(t)
    except Exception:
        return None


ANALYZE_SYSTEM_PROMPT = """你是校园心理辅导对话分析助手。请根据带说话人标注的对话记录,输出严格JSON,字段如下:
{
  "summary": "80字以内的对话摘要,概括主要话题与结论",
  "risk_level": "danger|warning|low|none 四选一(danger=涉及自伤/伤人/极端情绪;warning=明显情绪困扰或冲突;low=轻微负面情绪;none=正常交流)",
  "emotion_tags": ["情绪标签数组,2~4个,如:焦虑、抵触、平静、积极"]
}
只输出JSON,不要任何解释。"""


def llm_analyze_session(transcript_text: str) -> Optional[dict]:
    """整段对话 → LLM 分析 {summary, risk_level, emotion_tags};失败返回 None(不影响主流程)"""
    if not (transcript_text or "").strip():
        return None
    try:
        raw = llm_invoke(
            "以下是老师与学生的对话记录,请分析:\n" + transcript_text[:6000],
            system_prompt=ANALYZE_SYSTEM_PROMPT,
        )
        data = _extract_json(raw)
        if not data:
            return None
        risk = data.get("risk_level")
        if risk not in ("danger", "warning", "low", "none"):
            risk = "none"
        tags = data.get("emotion_tags") or []
        if not isinstance(tags, list):
            tags = []
        tags = [str(t).strip()[:12] for t in tags if str(t).strip()][:6]
        return {
            "summary": str(data.get("summary", "")).strip()[:200],
            "risk_level": risk,
            "emotion_tags": tags,
        }
    except Exception as e:
        print("[warn] 混元分析失败:", type(e).__name__, e)
        return None
五、前端交互模块
1. Web Audio API 前端VAD流式收音
前端核心能力:浏览器原生麦克风采集,AudioContext做音频采样,实现前端VAD语音活动检测,不需要依赖外部SDK。
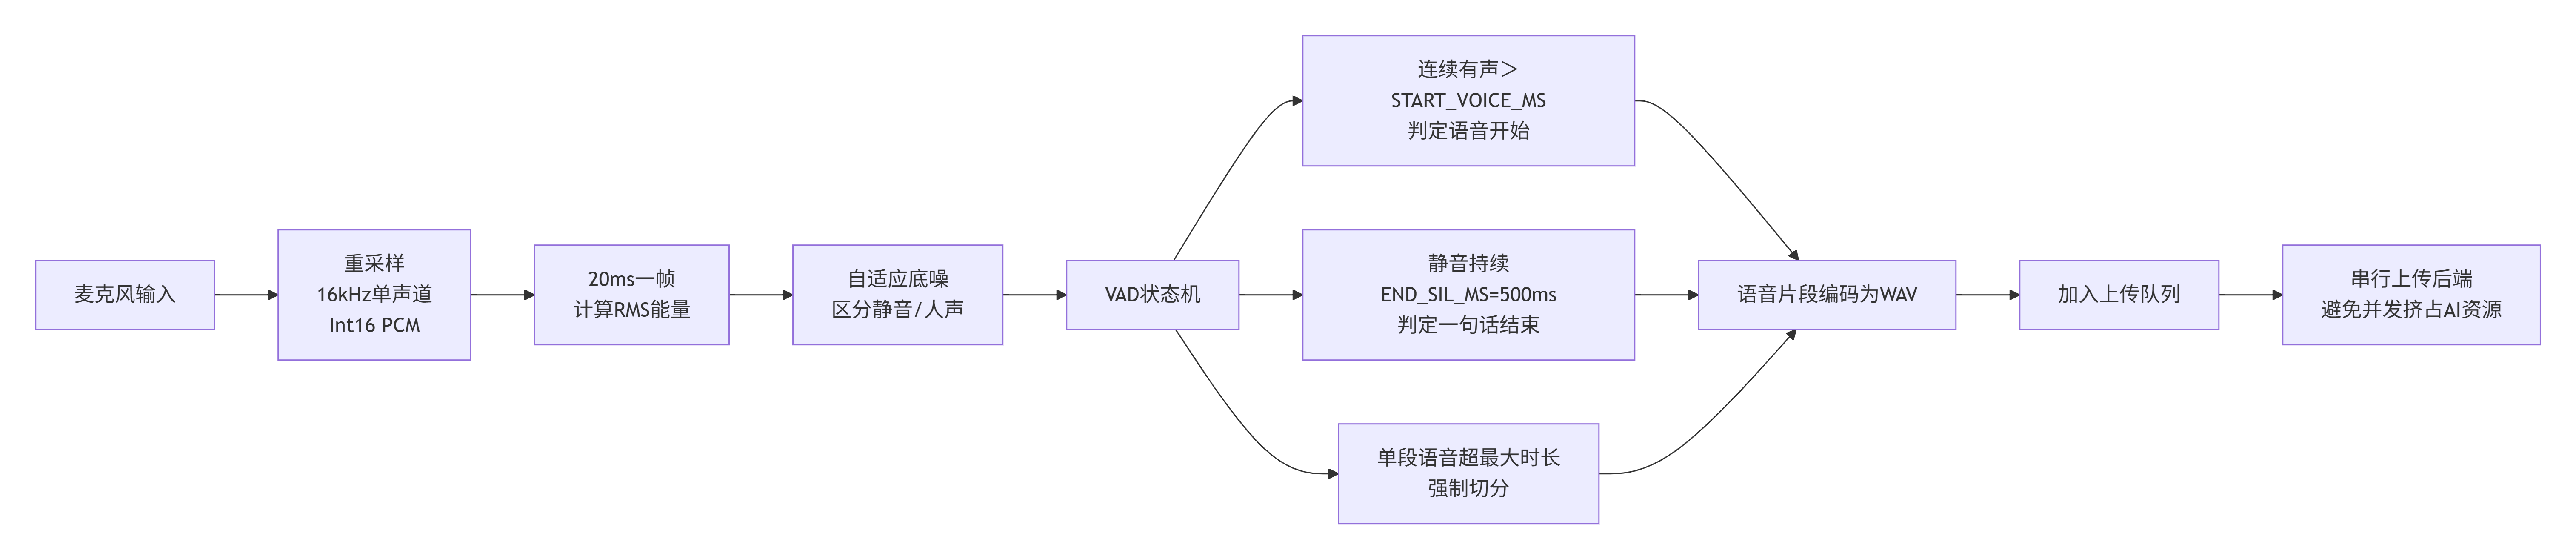
音频采样:麦克风输入重采样为16kHz单声道Int16 PCM;20ms一帧计算RMS能量,自适应底噪,区分静音和人声;VAD逻辑:连续超过START_VOICE_MS有声判定语音开始;静音持续END_SIL_MS=500ms判定一句话结束;单段语音超过最大时长强制切分;切分得到的语音片段编码为WAV,加入上传队列串行上传后端,避免并发上传挤占AI识别资源。
示例实践:JS核心VAD帧处理片段
VAD自适应底噪:静音期间持续更新noiseFloor,适应环境噪音变化,适合办公室、咨询室不同环境噪声。
function handleFrame(buf, off, sampleIdx){
    const tMs = sampleIdx / SR * 1000;
    const rms = frameRms(buf, off);
    const thr = Math.max(0.012, noiseFloor * 3.0);
    const frame = buf.subarray(off, off + FRAME);
    if(!inSpeech){
        noiseFloor = noiseFloor * 0.98 + rms * 0.02;
        if(rms > thr){
            voiceMs += 20;
            segChunks.push(frame.slice());
            if(voiceMs >= START_VOICE_MS){
                inSpeech = true; silMs = 0;
                segStartMs = Math.max(0, tMs - voiceMs + 20);
            }
        }else{
            voiceMs = 0;
            if(segChunks.length) segChunks = [];
        }
        return;
    }
    segChunks.push(frame.slice());
    silMs = rms > thr ? 0 : silMs + 20;
    const segMs = segChunks.length * 20;
    if(silMs >= END_SIL_MS){
        const keep = Math.max(1, Math.floor((segMs - silMs) / 20));
        finishSegment(segChunks.slice(0, keep), segStartMs, segStartMs + keep * 20);
        inSpeech = false; silMs = 0; voiceMs = 0; segChunks = [];
    }else if(segMs >= MAX_SEG_MS){
        finishSegment(segChunks.slice(), segStartMs, segStartMs + segMs);
        inSpeech = false; silMs = 0; voiceMs = 0; segChunks = [];
    }
}
2. 转录文本与说话人人工编辑界面
前端实现两种编辑能力:
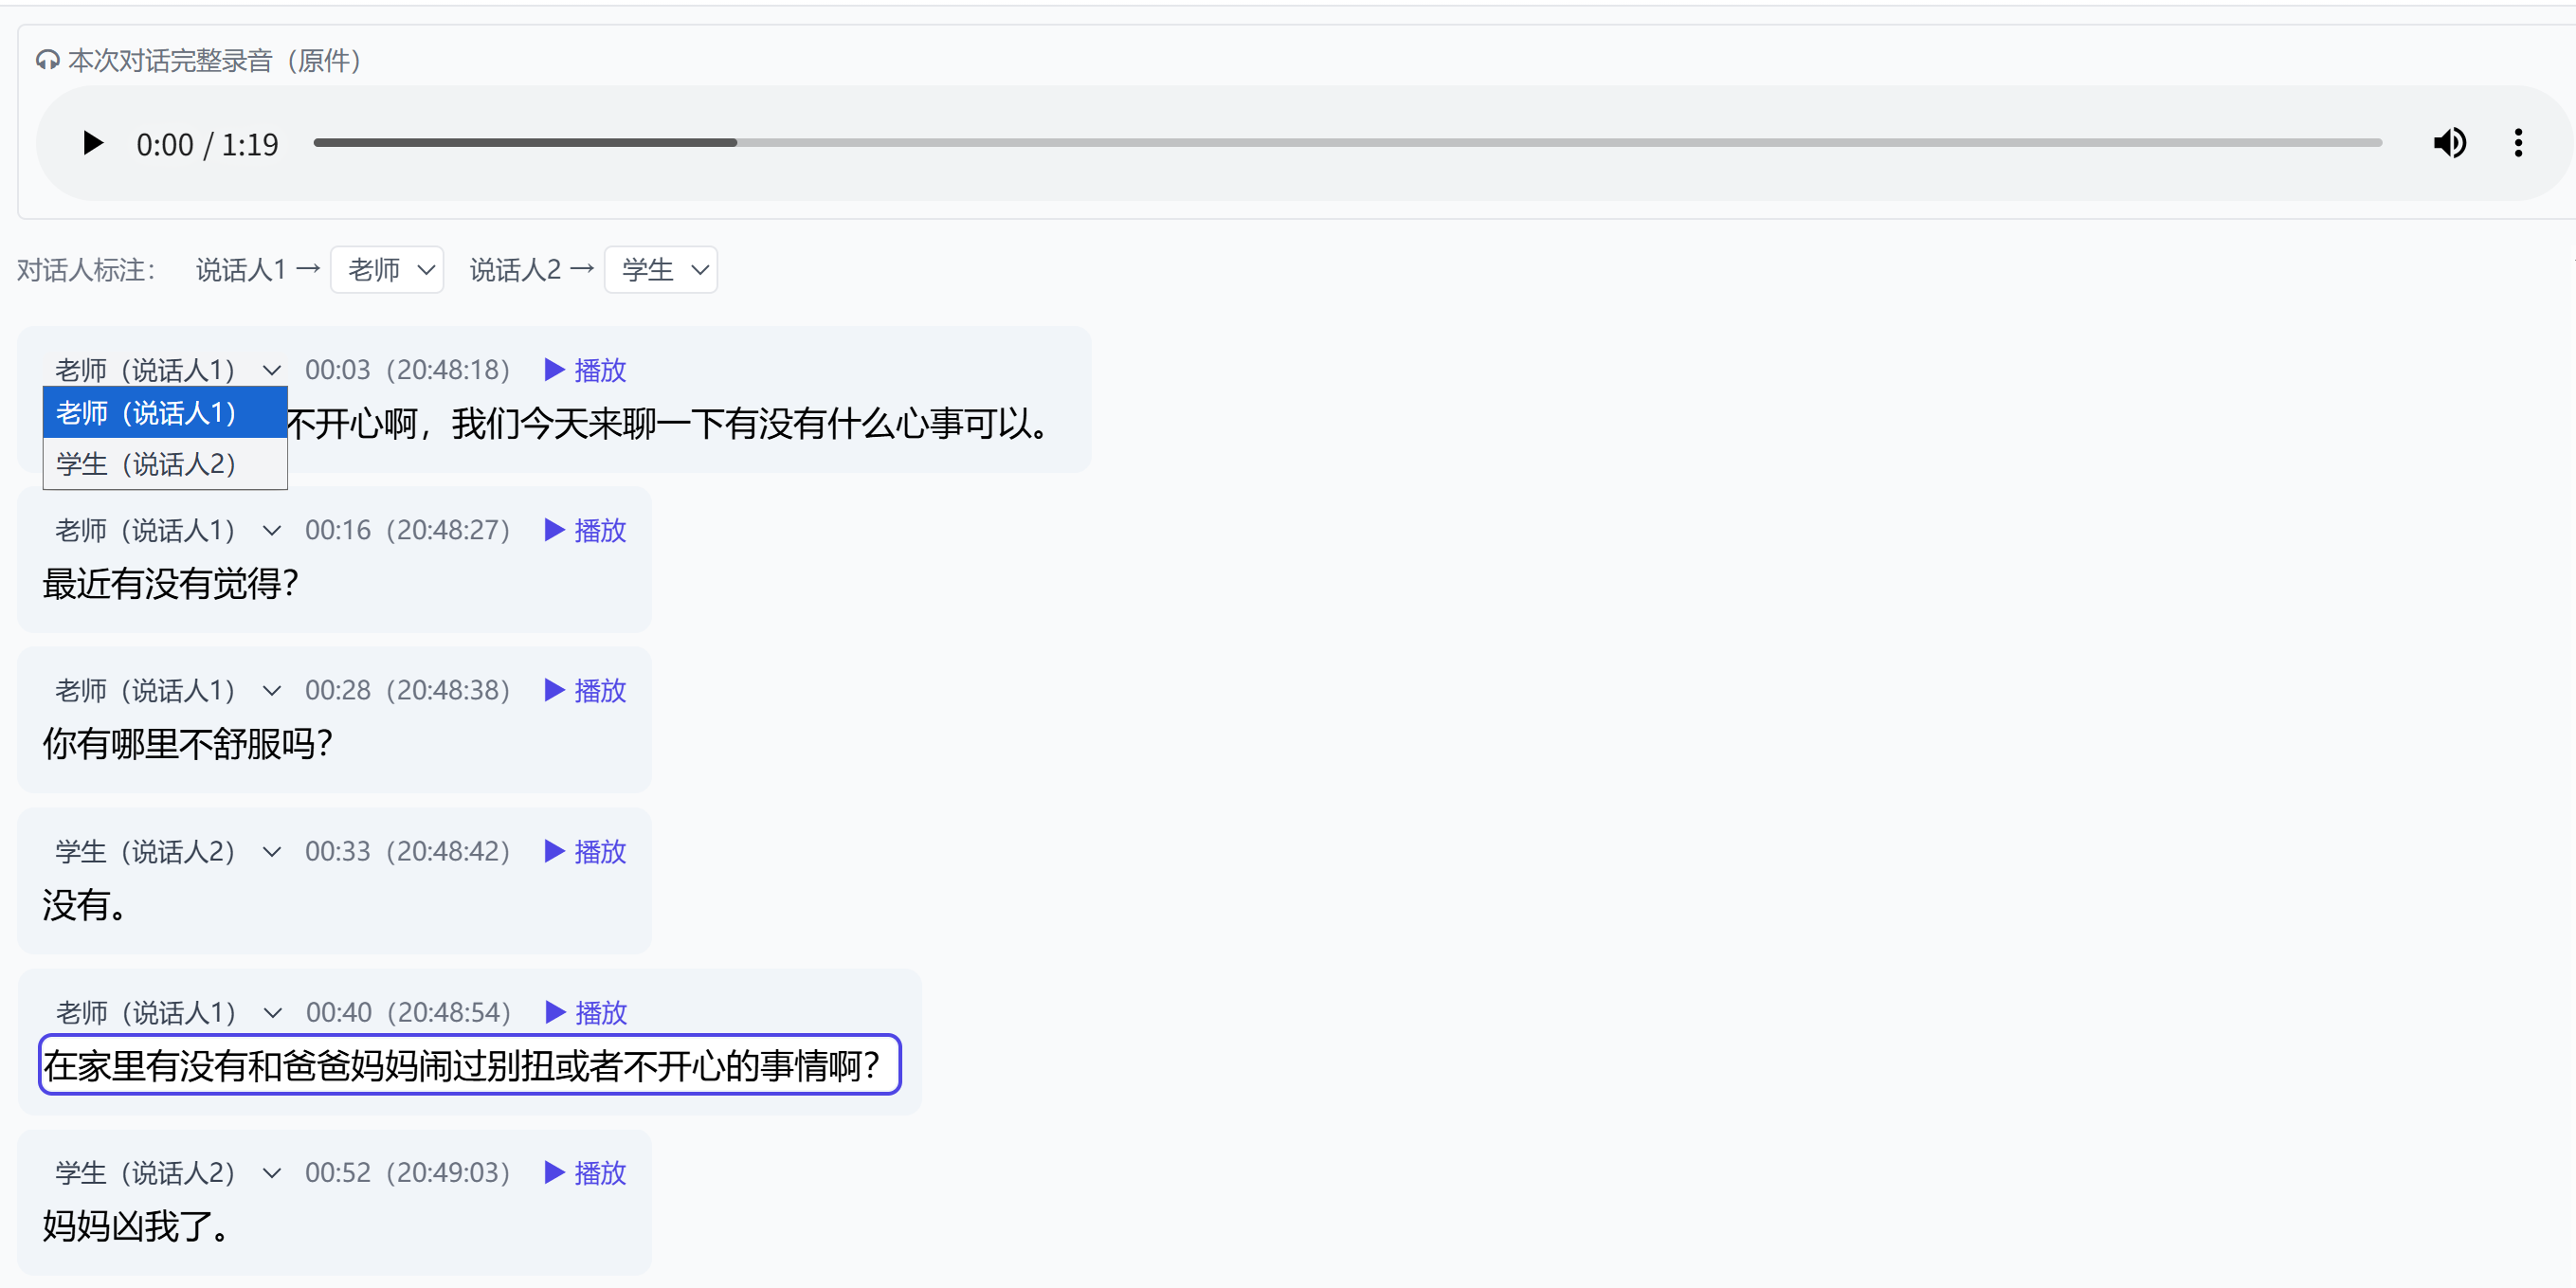
- 点击转录文字直接开启contentEditable编辑,回车/失焦自动提交修改,ESC撤销;修改成功后绿色边框闪烁提示,失败保留本地修改,弹出提示。
- 单句话下拉框修改说话人角色;顶部对话人标注栏,支持批量把spk0/spk1标注为老师/学生;多人模式支持合并多个说话人编号。
3. 会话管理、风险标记、情绪标签
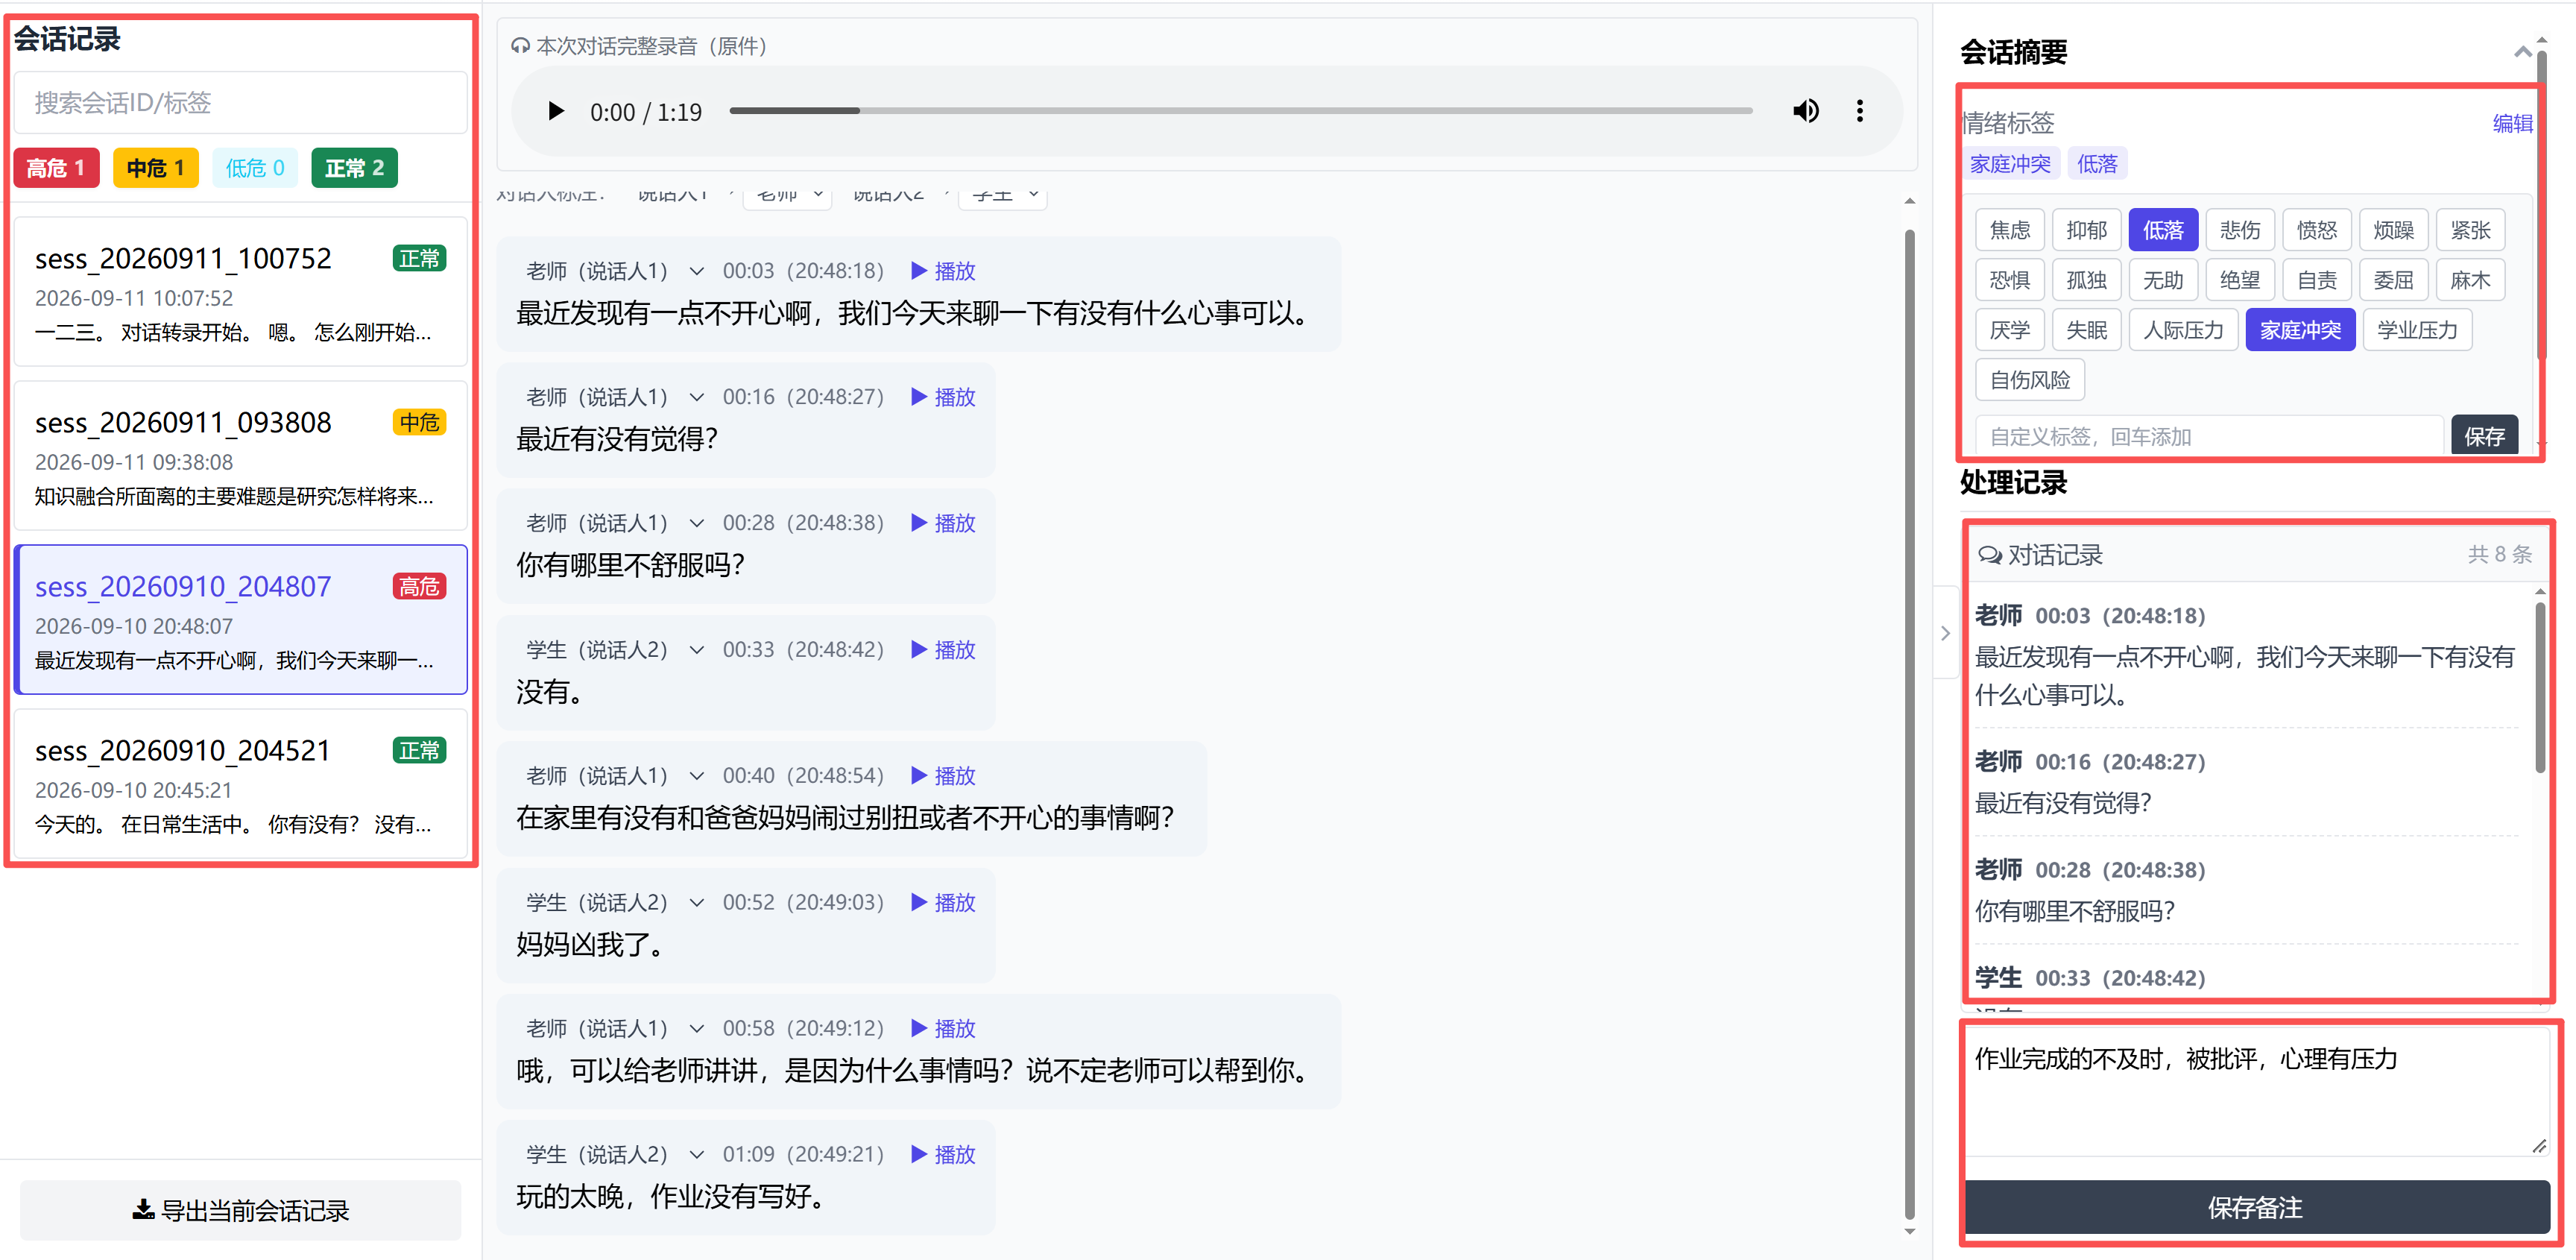
- 风险等级:danger高危、warning中危、low低危、none正常。修改高危降级会弹出二次确认,所有操作写入审计日志。
- 情绪标签:预设标签+自定义标签,多选芯片UI,保存后存入数据库逗号分隔字符串。
- 左侧会话列表:支持多风险筛选、关键词检索(会话ID、摘要、情绪标签、时间),本地前端过滤,减少后端查询压力。
- 备注功能:老师填写辅导备注,保存时自动把当前对话快照存入transcript_snapshot字段,后续即使转录记录修改,备注附带的原始对话快照永久保留。
六、业务能力设计
1. 风险分级机制
风险等级可以由AI预识别,也可以由心理老师人工二次改判。代码业务规则:
- AI自动写入风险时,高危标记一旦打上不会自动降级,防止AI误判自动消除高危标记;
- 只有老师手动操作才可以降级,并且降级二次确认,审计记录完整留存。
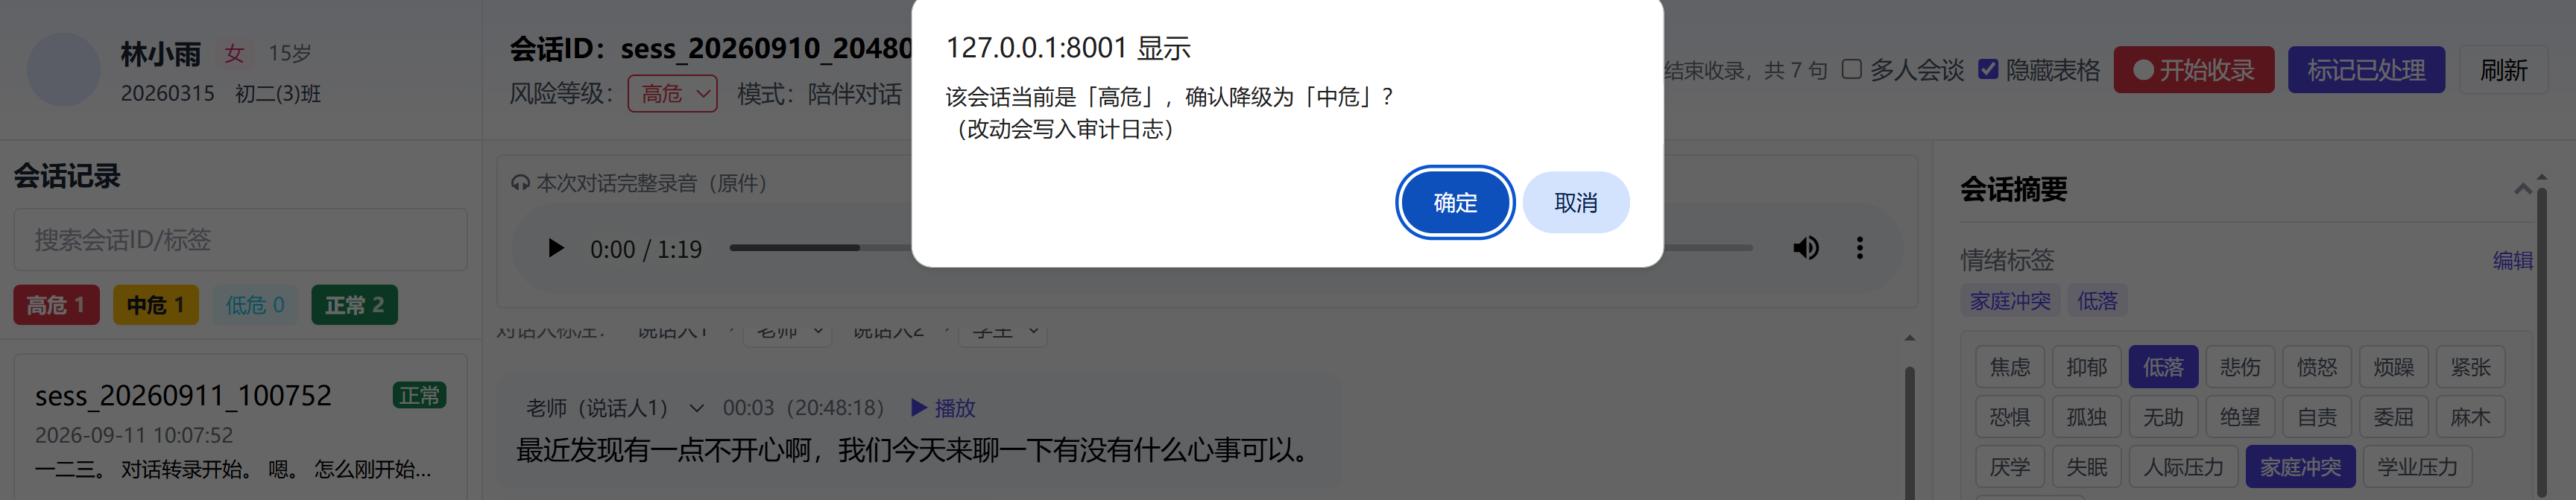
这个逻辑贴合心理安全业务,高危会话不能被系统自动降低风险等级,必须人工复核。
# ===================== 接口:接收消息,存入转录记录(给智能体服务调用) =====================
@app.post("/api/archive/save_msg")
async def save_chat_message(req: SaveMessageReq, db: Session = Depends(get_db)):
    """智能体主服务调用:保存每一轮对话转录文本"""
    sid = req.session_id
    sess = db.query(DBSession).filter(DBSession.id == sid).first()
    if not sess:
        sess = DBSession(id=sid, risk_level=req.risk_level or "none", mode=req.mode)
        db.add(sess)
    else:
        # 高危标记一旦打上就不会降级
        if req.risk_level and sess.risk_level != "danger":
            sess.risk_level = req.risk_level
    db.commit()

    msg = DBSessionMessage(
        id=str(uuid.uuid4()),
        session_id=sid,
        role=req.role,
        text=req.text,
        audio_path=req.audio_path
    )
    db.add(msg)
    db.commit()

    # 实时推送给已连接的老师端
    await hub.broadcast({
        "type": "new_message",
        "msg_id": msg.id,
        "session_id": sid,
        "role": msg.role,
        "text": msg.text,
        "time": local_str(msg.created_at)
    })
    return {"ok": True, "msg_id": msg.id}
2. 会话快照存档
老师保存备注的时候,前端把当前页面渲染的完整对话(包含人工修改文字、重分配说话人)生成纯文本快照,随备注存入数据库transcript_snapshot。
作用:后续转录记录被再次编辑,备注绑定的快照不会变动,保留老师当时看到的原始对话,满足心理个案档案归档需求。
3. 审计日志全链路留痕
所有敏感操作:查看会话、修改转录文字、修改说话人、修改风险等级、新增情绪标签、保存备注、导出会话,全部插入DBAuditLog记录,记录操作账号、会话ID、动作类型。
心理服务场景,个案记录需要可追溯,审计日志满足档案溯源要求。
七、服务启动
1. 启动后端服务
# 安装依赖
pip install fastapi uvicorn sqlalchemy pydantic funasr numpy scikit-learn
# 安装ffmpeg,ubuntu: apt install ffmpeg windows下载二进制加入环境变量
python transcript_archive.py
服务启动后访问[http://127.0.0.1:8001](http://127.0.0.1:8001) 打开老师后台页面。
2. 使用流程示例
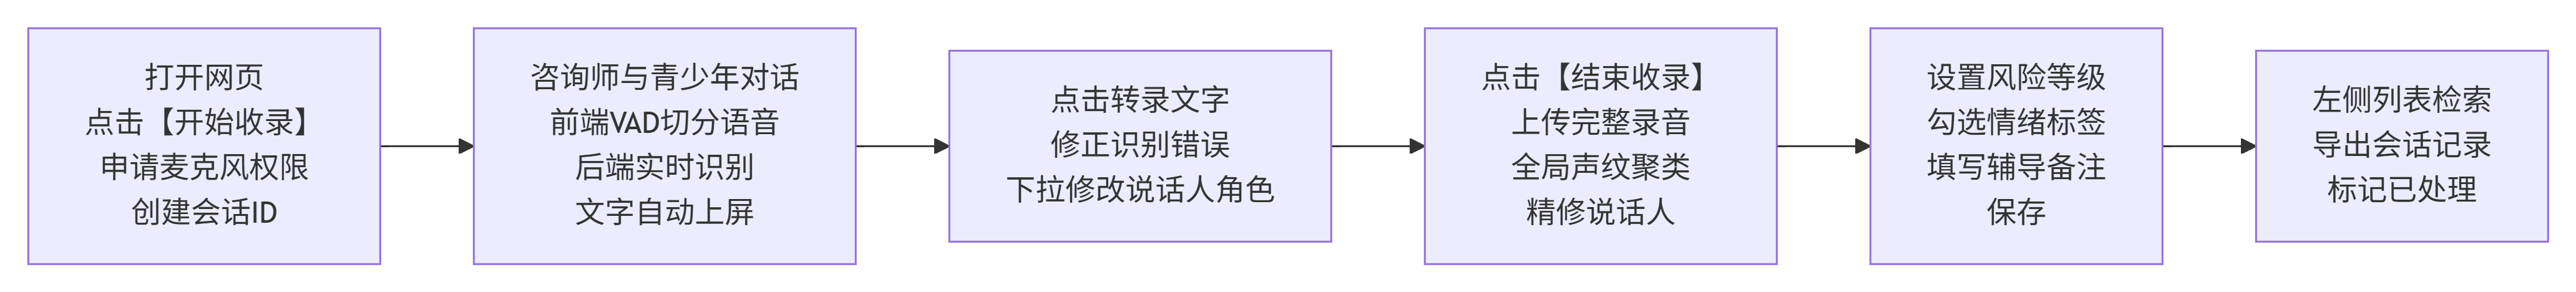
- 1. 打开网页,点击【开始收录】,浏览器申请麦克风权限,系统创建新会话ID;
- 2. 咨询师和青少年对话,前端VAD自动切语音片段,后端实时识别,文字自动上屏;
- 3. 老师可以点击转录文字修正识别错误,下拉修改说话人角色;
- 4. 对话结束点击【结束收录】,后端上传完整录音,执行全局声纹聚类精修说话人;
- 5. 老师设置风险等级、勾选情绪标签,填写辅导备注并保存;
- 6. 会话保存后,可在左侧列表检索,导出会话记录,标记会话已处理。
八、总结
青少年心理对话转录存档系统的核心不是单纯的语音转文字工具,而是面向心理辅导业务的完整工程化平台。 技术层面,项目融合前端WebAudio实时VAD、FastAPI异步后端、FunASR离线ASR与声纹聚类,创新性使用“实时声纹分配+会话结束全局聚类”两段式说话人分离,兼顾实时预览效果与最终识别准确度;WebSocket长连接实现转录消息实时推送。 业务层面,针对心理个案管理的需求,增加风险分级控制、情绪标签、个案备注+快照、全操作审计日志,人工修正转录文本与说话人,适配心理咨询师真实工作流程。
项目使用轻量技术栈,原生前端+SQLite,部署简单,适合小范围试点;同时代码结构模块化,预留扩展接口,可以接入大模型完成自动摘要、风险智能识别,进一步赋能青少年心理辅导工作。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号