pdf转word空白页删不掉,win10和win11上按符号类型分批清除
原创
pdf转word空白页删不掉,win10和win11上按符号类型分批清除
原创
软领
发布于 2026-11-06 10:59:46
发布于 2026-11-06 10:59:46
用 Word 打开刚转出来的 docx,状态栏写着「第 3 页,共 7 页」,回头翻原 PDF 只有 5 页。多出来的那一页光标点不进去,按退格没反应,全选删除又容易把后面的正文一起带走。
这类空白页多数是排版残留和转换设置叠在一起造成的,原文件本身没坏,不用重新做一份 PDF,也不必怀疑转换过程出错。真正麻烦的地方在于,多出来的整页藏在看不见的排版符号里——手动分页符、表格后面的自动空段落、过高的页脚、被勾上的「段前分页」,每一样都能顶出一整页。
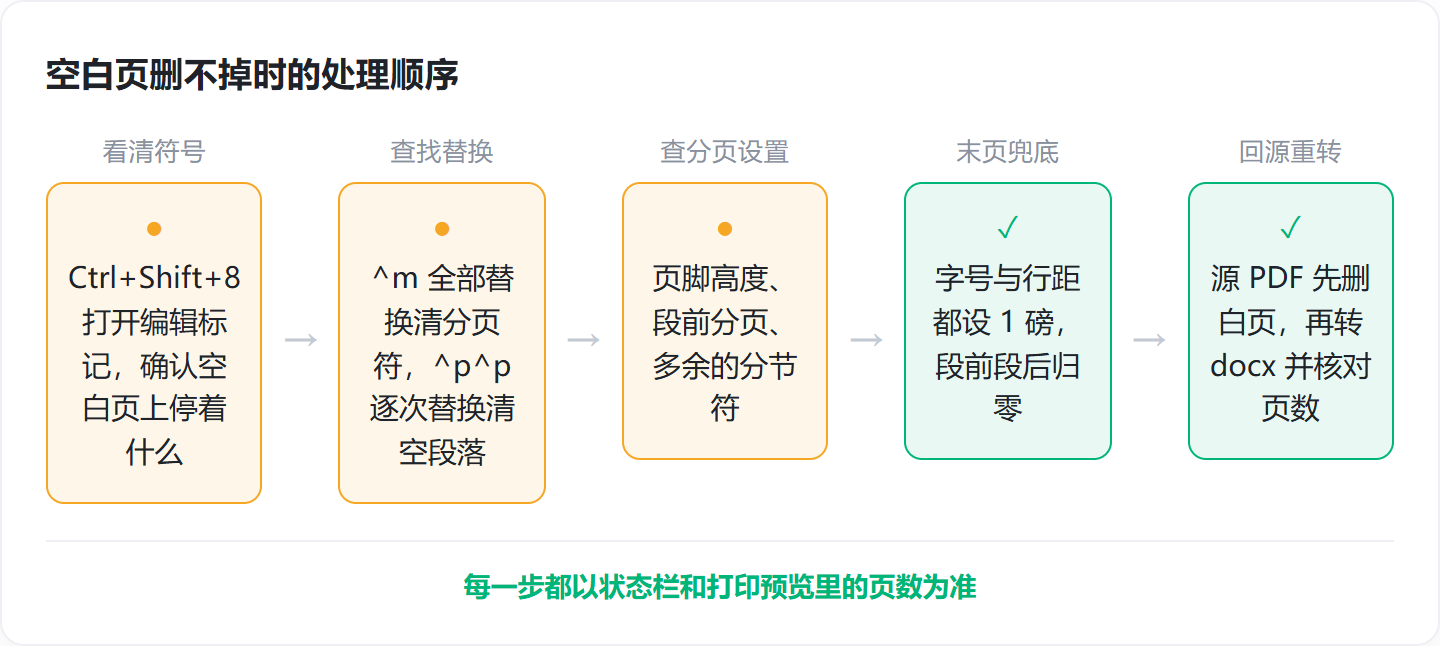
处理顺序可以按这条线走:先打开编辑标记(¶)看清空白页上停着什么符号,再用 Ctrl+H 把 ^m、^p^p 分批清掉,接着查页面设置和段落的分页开关,末页那张顽固空白页用 1 磅字号兜底,如果白页本来就在源 PDF 里,就回源删掉再转一遍。下面这些步骤在 Windows 10/11 上实测可用,最后更新于 2026-11-04。
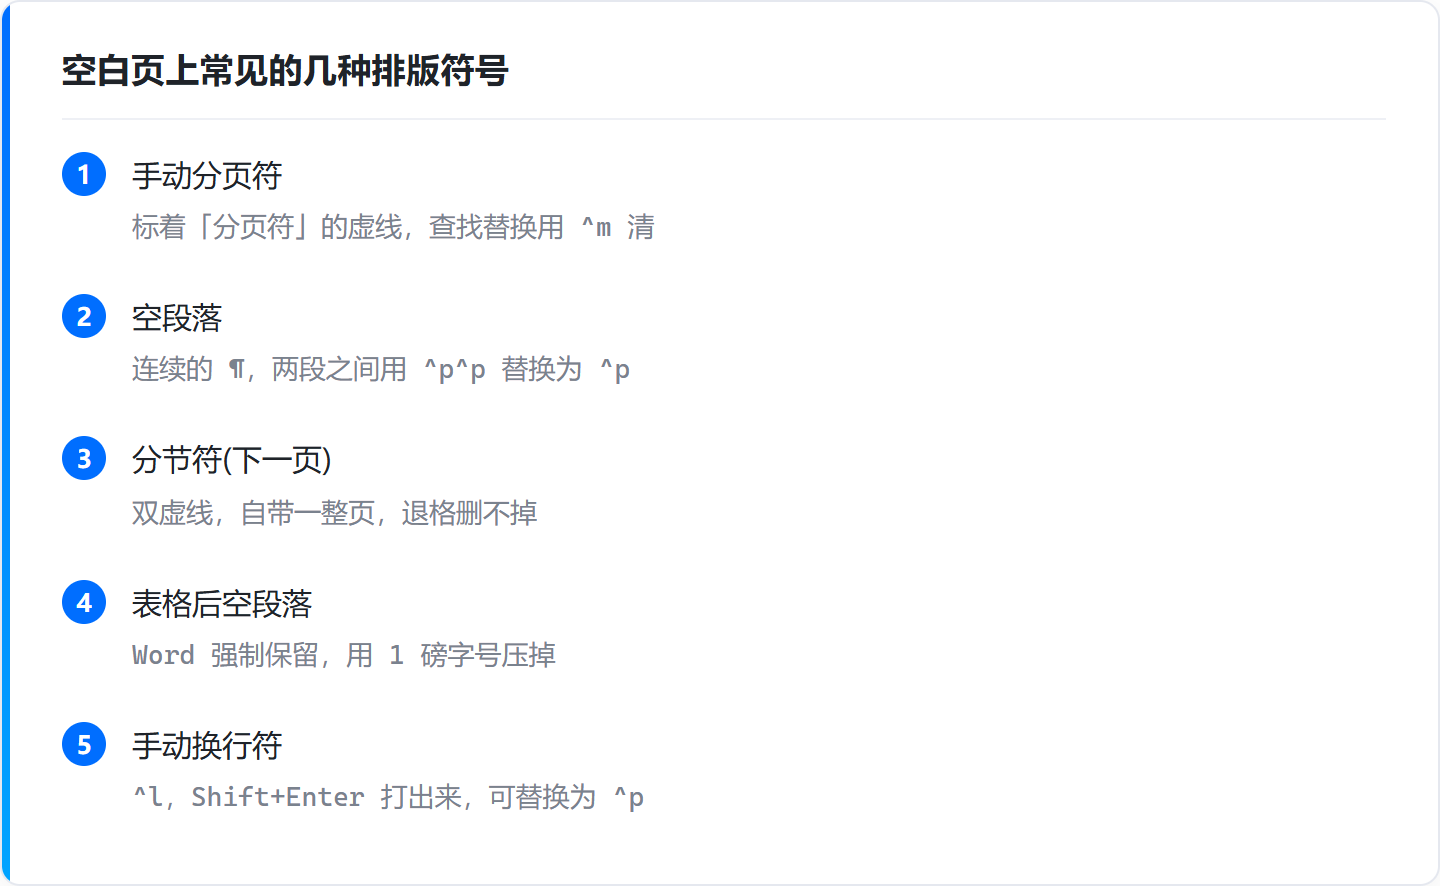
空白页一般来自这几处
多出来的页面不会凭空产生,它总是被某个排版元素顶出来的,常见的来源有这么几类:
- 手动分页符:按源 PDF 的分页位置插入,编辑标记里显示成一条标着「分页符」的虚线
- 空段落:表格后面或章节末尾的连续回车,显示成一串
¶ - 分节符(下一页):双虚线,自带一整页,退格删不掉
- 页眉页脚里的空行:包括单独占一行的页码域,页码域换行同样会顶出一页
- 页面设置:页脚高度偏大、纸张大小被改过、页边距突出一块
- 段落的分页开关:「段前分页」「与下段同页」「孤行控制」
这几类大多能在编辑标记里看到痕迹,只有页面设置那几项需要单独查一遍。
先打开编辑标记,看清空白页上停着什么
空白页删不掉时先别按退格。第一步是把看不见的符号显示出来,确认空白页上到底停着什么——手动分页符会显示成一条标着「分页符」的虚线,空段落是一串连续的 ¶。
- 打开转换好的 Word 文档,点「开始」→「段落」组里的「显示/隐藏编辑标记」(¶),快捷键是
Ctrl+Shift+8 - 按
Ctrl+End跳到文末,再从后往前翻:连续的回车符(¶)是空段落,标着「分页符」的虚线是手动分页符,双虚线「分节符(下一页)」会自带一整页 - 空白页在文档中间时,用
Ctrl+Home从前往后逐页看,光标停在空白页上时留意状态栏的「第 X 页,共 Y 页」是不是真的多了一页 - 记下符号位置和类型再处理:光标紧贴分页符前面按
Delete删得掉的是分页符;退格怎么都删不掉,多半是分节符或者文末表格后面的空段落 - 顺手看一眼草稿视图(「视图」→「草稿」),分节符和分页符在这里显形最清楚
判断方式很简单:能在分页符前面按 Delete 删掉的是分页符,退格删不动的是分节符或表格后的空段落,这两类要换方法处理。把符号类型先记下来,后面的替换和页面设置才有针对性。
用 Ctrl+H 查找替换清掉分页符和空段落
查找替换能一次性清掉手动分页符;空段落得一段一段点替换,不然正常的段间距会被一起吃掉。^ 代码只在非通配符模式下才认,很多人替换没反应就是卡在这里。
- 按
Ctrl+H打开「查找和替换」,点左下角「更多」展开选项,确认没有勾选「使用通配符」(^代码要在非通配符模式下才认) - 查找内容填
^m(手动分页符),替换为留空,这一类可以放心点「全部替换」 - 查找内容填
^p^p,替换为^p,然后一段一段点「替换」而不是「全部替换」,一次全替会把正常的段间距和空行一起吃掉 - 再查找
^l(手动换行符,Shift+Enter打出来的),替换为^p或留空,删掉被硬折断的行 - 替换完点「关闭」,回到页面视图看
¶标记还有没有残留;^打不出来时切到英文输入法按Shift+6 - 改完不要立刻另存为,先
Ctrl+S保存原文件,方便对比替换前后的页数
替换完先看状态栏的「共 Y 页」,页数没降说明还有分节符或页面设置没处理,接着往下查。
查页眉页脚、页面设置和段落的分页开关
有些空白页是页脚高度、页眉里的空行或者段落的「段前分页」顶出来的,跟正文内容没有关系。这几处都藏在页面上层,只盯着正文很难发现。
- 双击页眉区域进入编辑,删掉多余空行和单独占一行的页码域——页码域换行也会顶出一整页;删完点「关闭页眉和页脚」
- 「布局」→「页面设置」右下角小箭头,检查纸张大小是否被改过、页脚高度是不是过大、页边距有没有突出一块
- 选中正文,「开始」→「段落」右下角弹窗 →「换行和分页」,取消「段前分页」「与下段同页」「孤行控制」这几项勾选
- 仍多一页时切到草稿视图,把多余的分节符删掉,分节符本身就会带来新的一页
- 按
Ctrl+P看打印预览,预览里页数正常再退出,避免打印时又凭空多一张白页
页数在打印预览里正常,这一轮才算真的改完。
末页那张顽固空白页用 1 磅字号兜底
文末表格后面的空段落是 Word 强制保留的,退格删不掉,把它压到看不见最省事。这一步不删内容,只改字号和行距。
- 按
Ctrl+End到文末,看最后一个¶是不是紧跟在表格后面的自动空段落——这类段落是 Word 强制保留的,退格删不掉 - 把光标放进这个空段落,先试
Delete和退格各一次;表格宽度超出页面底部时,先收窄表格列宽或把表格整体上移一点 - 还删不掉就选中该段落,「开始」→「字体」字号直接输入 1 磅,段落弹窗里行距设为「固定值」1 磅、段前段后间距都设为 0
- 如果段落里勾了「如果定义了文档网格,则对齐到网格」,把这个勾去掉,避免网格把 1 磅段落重新撑开
- 保存并重新打开文档,再开一次编辑标记确认这个空段落已经不占页;页数以状态栏「共 Y 页」复核
保存后重新打开再看一次编辑标记,段落不占页就说明压住了。
空白页本来就在源 PDF 里,回源删页再转
源 PDF 每页尾部自带空白时,在 Word 里怎么删都白费,得回源文件处理。先把多余白页删掉再转,能省掉一整轮清空段落的操作。
- 拿原 PDF 逐页翻一遍,对照转换后的 Word,确认多出来的空白页是源文件里本来就有的白页,还是转换时新增的空段落
- 是源文件自带的:用能编辑页面的 PDF 工具打开它,把多余的空白页先删掉并保存,再进入转换流程
- 转换时在工具里选 PDF 转 Office → PDF 转 Word,输出格式按需要选
docx或doc,添加文件后开始转换 - 转回来的 Word 若还有残留空段落,重复前面查找替换那一步的
Ctrl+H:^p^p替换为^p,逐次替换 - 最后对照原 PDF 的分页位置核对一遍,确认页数和章节断点都一致,再另存为最终版本
回源处理这一步做完,残留的空段落再用一次 ^p^p 替换基本就能收尾。
常见问题
pdf转word空白页删不掉,按退格键一点反应都没有是怎么回事?
删不掉的通常是文末表格后面的自动空段落,或者「分节符(下一页)」。分节符自带一整页,这两类都不吃退格键,得换成查找替换或改字号处理。
PDF 转 Word 后每一页后面都多一张空白页,是转换设置没选对吗?
每页都多一张,多半是源 PDF 每页尾部本来就有空白,或者页面设置里的页脚高度偏大。先把原 PDF 逐页看一遍确认,再去查页脚高度和「段前分页」。
Word 文末最后一个空白页怎么都删不掉,把字号改成 1 磅真的有用吗?
有用。把它的字号设成 1 磅、行距设成「固定值」1 磅、段前段后间距归零,段落仍在文档里但不再占一整页。别忘了取消「如果定义了文档网格,则对齐到网格」,否则网格会把它重新撑开。
用查找替换把 ^p^p 换成 ^p 会不会把正常段间距也吃掉?
全部替换会。^p^p 代表两段之间的空行,正常排版里也可能出现,一次全替会把空行一起压掉。改成一段一段点「替换」,边点边看页面变化,就只清掉多出来的那一层。
同一份 PDF 转成 doc 和 docx,多出来的空白页数量会不一样吗?
会有一点差别。两种格式对分页符和表格后段落的处理不一致,docx 通常更贴近原 PDF 的排版,doc 在老版本 Word 里打开时分页位置可能再挪一次。拿不准就先转 docx,核对页数后再另存成需要的格式。
整套流程的判断依据始终是页数:转出来是多少页、清掉符号后剩多少页、回源重转后和原 PDF 对不对得上。页数对上了,这件事就算收尾。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号