PDF 不止装文字:用 Python 给 PDF 添加和提取内嵌附件
原创
PDF 不止装文字:用 Python 给 PDF 添加和提取内嵌附件
原创
用户12495000
发布于 2026-11-04 10:37:54
发布于 2026-11-04 10:37:54
一份完整的项目报告,往往不只有 PDF 正文,还包括用于计算的 Excel 表格、原始图片或补充说明。如果这些文件分开发送,接收者就需要逐一下载、整理,还可能遗漏其中某一份材料。
PDF 的附件功能提供了另一种组织方式:把配套文件直接嵌入 PDF,让正文与相关资料一起交付。 例如,在财务报告中附上原始工作簿,在产品手册中附上示例文件,或者在合同中附上补充材料。
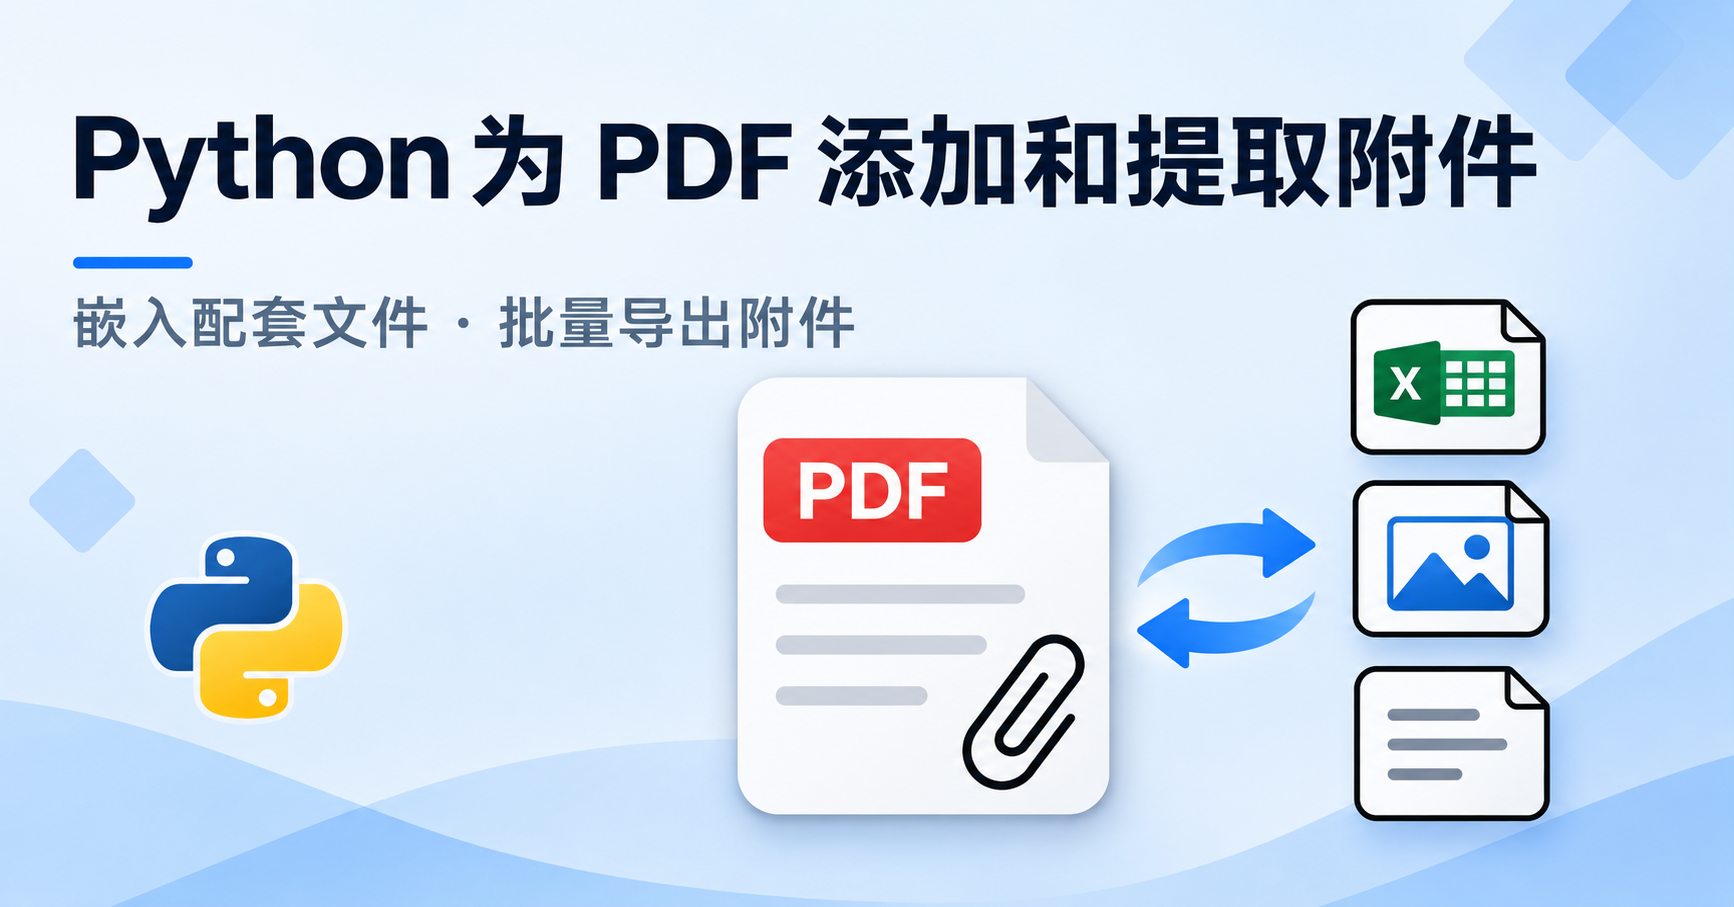
本文介绍如何使用 Spire.PDF for Python 完成两项操作:向 PDF 添加附件,以及从 PDF 中提取附件。
PDF 附件与页面内容有什么区别?
可以把带附件的 PDF 理解为一份“自带资料袋的文档”:页面负责展示正文,附件负责保存配套文件。
这里的“嵌入”与插入图片、添加超链接有所不同:
操作 | 文件如何保存在 PDF 中 | 阅读时的表现 |
|---|---|---|
将图片插入页面 | 图片成为页面内容的一部分 | 打开页面即可看到 |
添加文件超链接 | 通常只记录目标地址或路径 | 点击后访问目标位置 |
添加附件 | 将文件本身嵌入 PDF | 通过支持附件的阅读器查看或另存 |
因此, 把 Excel 文件作为附件加入 PDF,并不会将工作表转换为 PDF 页面 。接收者提取后,仍然可以用 Excel 打开和编辑原始工作簿。
需要注意,阅读器对附件的支持有所不同。查看附件时,建议使用 Adobe Acrobat 等提供附件面板的桌面阅读器;部分浏览器内置 PDF 查看器可能不显示附件入口。
环境准备
Spire.PDF for Python 是一个用于创建和处理 PDF 的库。本文使用它提供的附件接口,直接操作 PDF 内部保存的文件,无需手动打开阅读器添加或导出附件。
先安装依赖库:
pip install Spire.PDF在代码中导入所需模块:
from spire.pdf import *接下来的示例分别演示附件的添加与提取。运行前,请将文件路径替换为本地实际路径。
一、向 PDF 添加附件
假设我们已有一份 PDF 报告,希望把原始数据 Report.xlsx 和配套图片 Logo.png 一并交付。将它们作为附件嵌入后,接收者只需保留一个 PDF,就能同时保存正文与这两份材料。
操作过程分为四步:
- 加载目标 PDF。
- 根据外部文件创建附件对象。
- 将附件加入文档的附件集合。
- 保存包含附件的新 PDF。
代码示例
from spire.pdf import *
from spire.pdf.common import *

# 创建 PDF 文档对象
doc = PdfDocument()

# 加载目标 PDF
doc.LoadFromFile("Input.pdf")

# 根据外部文件创建附件对象
attachment_one = PdfAttachment("Report.xlsx")
attachment_two = PdfAttachment("Logo.png")

# 将附件加入 PDF
doc.Attachments.Add(attachment_one)
doc.Attachments.Add(attachment_two)

# 保存为新的 PDF 文件
doc.SaveToFile("Attachments.pdf")

# 释放资源
doc.Close()
代码说明与结果查看
PdfAttachment("Report.xlsx") 用于根据指定文件创建附件对象;随后调用 doc.Attachments.Add(),将其加入当前 PDF。需要添加更多文件时,可以继续创建附件对象并加入集合。
附件不会占用页面空间,也不会改变正文排版。 保存后打开 Attachments.pdf,页面看起来可能与原文档完全相同,但在支持附件的阅读器中,可以通过“附件”或“附加文件”面板找到嵌入的文件。
本例使用了不同的输入、输出文件名,因此原始 Input.pdf 会保留,新增附件的结果则保存到 Attachments.pdf。
还需考虑文件体积:附件保存的是文件数据本身,大型工作簿或高清图片可能明显增加 PDF 的大小。用于邮件发送或系统上传时,应同时留意交付渠道的文件大小限制。
二、从 PDF 提取附件
收到带附件的 PDF 后,如果需要编辑其中的工作簿、整理配套图片,或把附件交给后续程序处理,就可以将它们提取为独立文件。
提取附件不需要解析 PDF 页面,也不涉及 OCR。程序直接读取文档的附件集合,再把其中保存的文件数据写入磁盘。
操作过程如下:
- 加载带附件的 PDF。
- 获取文档的附件集合。
- 遍历附件,读取文件名与数据。
- 将每个附件保存到指定目录。
代码示例
运行前,请先创建 Output\ExtractedFiles 文件夹。
from spire.pdf import *
from spire.pdf.common import *

# Create a PdfDocument object
doc = PdfDocument()
# Load a PDF file
doc.LoadFromFile("Attachments.pdf")
# Get the attachment collection from the document
collection = doc.Attachments
# Loop through the collection
if collection.Count > 0:
    for i in range(collection.Count):
        # Get a specific attachment
        attachment = collection.get_Item(i)
        # Get the file name and data of the attachment
        fileName = attachment.FileName
        data = attachment.Data
        # Save it to a specified folder
        data.Save("Output\\ExtractedFiles\\" + fileName)
doc.Close()
代码说明与结果查看
doc.Attachments 返回文档的附件集合,collection.Count 表示集合中的附件数量。如果没有附件,示例会跳过保存操作。
遍历时,get_Item(i) 按索引获取附件,FileName 提供文件名,Data.Save(path) 则将附件数据写入指定位置。
对于前面的示例,提取完成后,输出目录中将出现 Report.xlsx 和 Logo.png。这些文件可以分别交给对应的软件打开,无需再通过 PDF 阅读器访问。
提取时需要注意的细节
首先是输出目录。 示例假定 Output\ExtractedFiles 已经存在;实际项目中,可以在提取前用 Python 的 os.makedirs() 自动创建目录。
其次是文件重名。 不同 PDF 可能都包含名为 Report.xlsx 的附件,如果统一保存到同一文件夹,就可能发生覆盖。批量提取时,建议为每份 PDF 创建独立子文件夹;同一 PDF 内的同名附件,则可以在文件名前添加索引。
还应规范保存文件名。 处理外部来源的 PDF 时,可用 os.path.basename() 取出附件名称中的文件名部分,再与目标目录组合,避免直接将附件名称中的路径信息用于保存。
常见问题
添加附件后,为什么 PDF 页面没有变化?
附件保存在文档内部,并不属于页面上直接显示的内容。请使用支持附件功能的阅读器,在附件面板中查看。
添加附件后,还需要发送原始文件吗?
附件已随 PDF 保存时,接收者可以从 PDF 中将其提取出来。不过,交付前最好打开输出文件检查一次,确认所需附件均已加入。
提取附件与提取 PDF 中的图片是一回事吗?
不是。提取附件是读取 PDF 内嵌的独立文件;提取页面图片则是读取页面使用的图像资源。即使某张图片显示在 PDF 页面上,它也不一定属于附件集合。
可以批量处理多个 PDF 吗?
可以。将单个 PDF 的处理逻辑放入文件遍历循环即可。批量提取时,建议按 PDF 文件名分别建立输出目录,方便追溯来源并减少重名冲突。
小结
PDF 附件适合把“正文”和“配套资料”组织在一起:正文保持便于阅读的版式,原始工作簿、图片和补充文件则随文档一同保存。
使用 Spire.PDF for Python,可以通过 PdfAttachment 和 doc.Attachments.Add() 添加附件,也可以遍历 doc.Attachments,将已有附件保存为独立文件。实际应用中,重点关注阅读器兼容性、文件体积,以及提取时的目录和文件名处理即可。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号