用 Python 对 Excel 数据排序:三种场景与实现
原创
用 Python 对 Excel 数据排序:三种场景与实现
原创
用户12495000
发布于 2026-10-28 10:50:52
发布于 2026-10-28 10:50:52
排序是 Excel 数据处理中最常见的操作之一。数据量小、偶尔排序时,手动操作完全够用;但如果数据频繁更新、需要批量处理多个文件,或要按照业务自定义的规则排列,用代码自动完成会更稳定,也更容易复现。
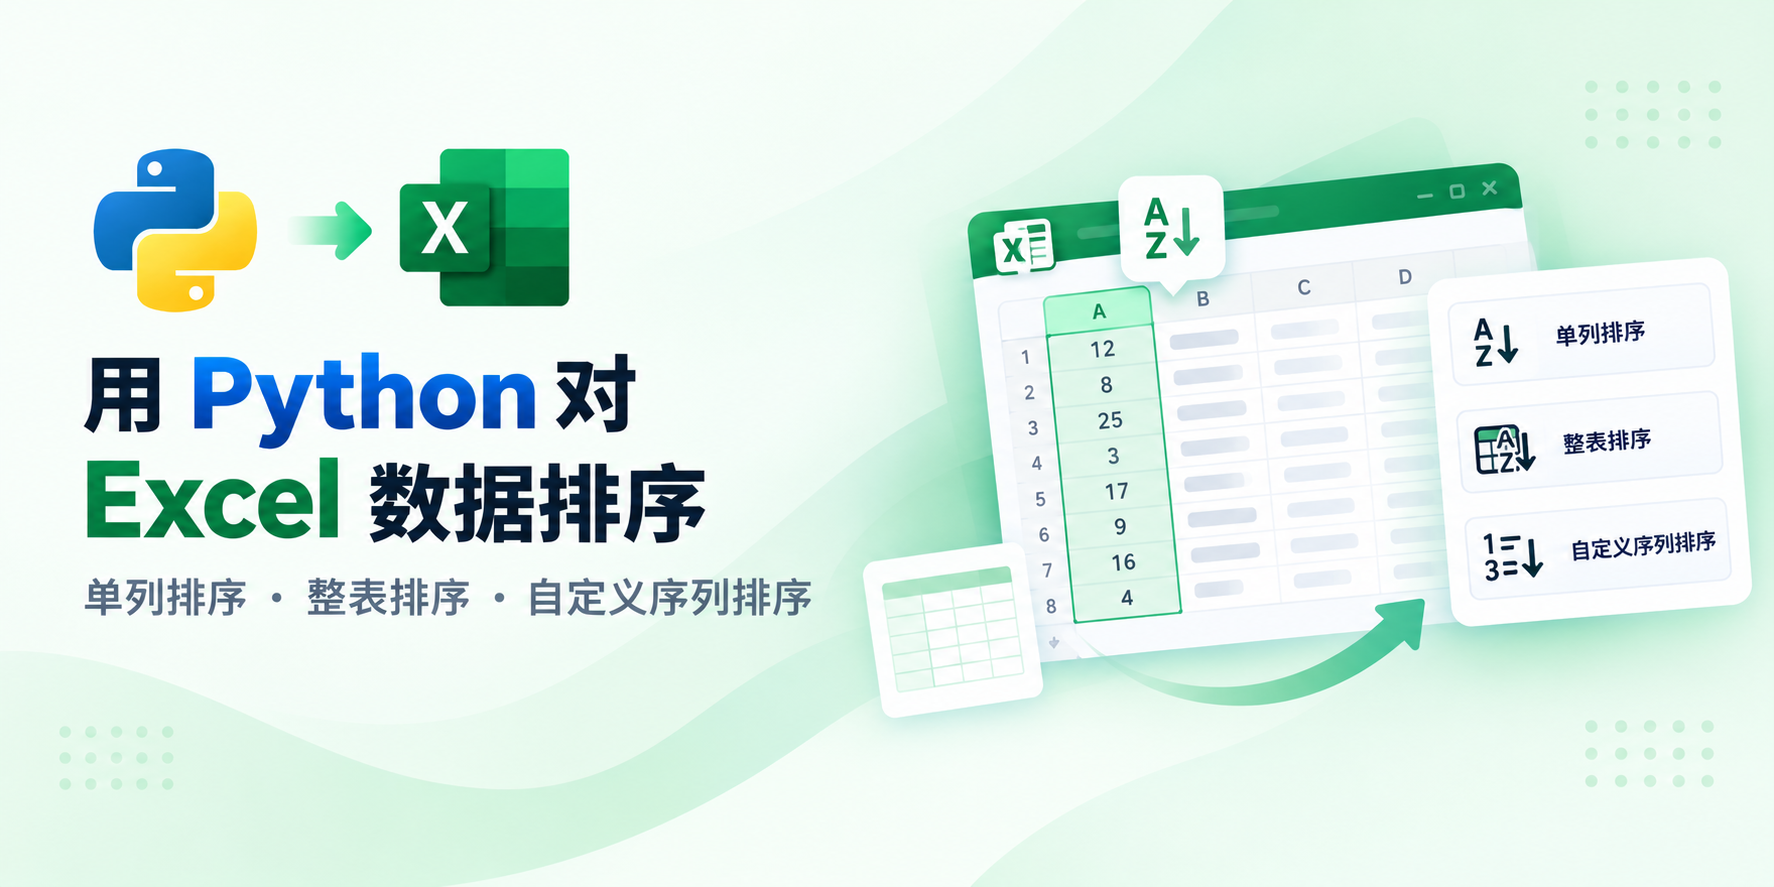
本文基于 Spire.XLS for Python,按"先讲清排序前必须处理的一个共性问题,再分别演示三种排序场景"的顺序展开:单列排序、以某列为关键字对整表排序、按自定义序列排序。
一、环境准备与一个共性前提
安装与引入
通过 pip 安装 Spire.XLS for Python:
pip install Spire.XLS安装完成后,在代码开头引入命名空间:
from spire.xls import *排序前先把公式转成静态值
三种排序场景的代码里都有一段相同的预处理:遍历待排序区域,把含公式的单元格替换为公式计算后的值。原因是排序以单元格的实际值为准,若保留公式,排序后公式引用可能错乱,结果与预期不符。这段逻辑在后续示例中不再重复解释,统一在此说明:
for cell in cellRange:
    if cell.HasFormula:
        value = cell.FormulaValue
        cell.Clear(ExcelClearOptions.ClearContent)
cell.Value = value另外,SortColumns.Add() 的列索引从 0 开始:A 列对应 0,B 列对应 1,依此类推。配置时注意对照自己的表结构。
二、三种排序场景
场景一:单列排序
只对某一列的数据本身重排,其他列不参与。
from spire.xls import *

workbook = Workbook()
workbook.LoadFromFile("Input.xlsx")

worksheet = workbook.Worksheets[0]
cellRange = worksheet["G1:G13"]

# 公式转静态值(同第一节)
for cell in cellRange:
    if (cell.HasFormula):
        value = cell.FormulaValue
        cell.Clear(ExcelClearOptions.ClearContent)
        cell.Value = value

# 以第 6 列(G 列)为排序列,按数值降序
workbook.DataSorter.SortColumns.Add(6, SortComparsionType.Values, OrderBy.Descending)
workbook.DataSorter.Sort(cellRange)

workbook.SaveToFile("output/SortByColumn.xlsx", ExcelVersion.Version2016)
workbook.Dispose()
要点 :操作范围是 G1:G13,即仅目标列。SortColumns.Add(6, ...) 中的 6 是 0 基索引,对应 G 列;排序按数值比较、降序执行。
场景二:以某列为关键字对整表排序
以某一列作为排序关键字,对整张数据表的各行重排,行与行之间的关联关系保持不变。
from spire.xls import *

workbook = Workbook()
workbook.LoadFromFile("Input.xlsx")

worksheet = workbook.Worksheets[0]
cellRange = worksheet["A1:G13"]

# 公式转静态值(同第一节)
for cell in cellRange:
    if (cell.HasFormula):
        value = cell.FormulaValue
        cell.Clear(ExcelClearOptions.ClearContent)
        cell.Value = value

# 仍以第 6 列(G 列)为关键字,按数值降序
workbook.DataSorter.SortColumns.Add(6, SortComparsionType.Values, OrderBy.Descending)
workbook.DataSorter.Sort(cellRange)

workbook.SaveToFile("output/SortByColumns.xlsx", ExcelVersion.Version2016)
workbook.Dispose()
要点 :与场景一相比,排序关键字没变,变的只是操作范围——从 G1:G13 扩大到 A1:G13。执行 Sort() 后,程序按 G 列的数值整体移动每一行,A 到 F 列的内容随行一起变化,而不是只重排 G 列本身。
这种方式更贴近实际业务:例如按"销售额"列对销售表排序时,每行对应的产品、地区、日期等信息都要跟着移动,否则数据就会错位。
场景三:按自定义序列排序
升序、降序只能满足一部分需求。有时需要按业务定义的顺序排列,例如"高、中、低"优先级,或某套既定编号顺序。这时可以使用自定义排序列表。
from spire.xls import *

workbook = Workbook()
workbook.LoadFromFile("Input.xlsx")

worksheet = workbook.Worksheets[0]
cellRange = worksheet["A1:G13"]

# 显式定义排列顺序
customList = ["6", "5", "4", "3", "2", "1", "12", "11", "10", "9", "8", "7"]

# 以第 0 列(A 列)为排序列,使用自定义序列作为依据
workbook.DataSorter.SortColumns.Add(0, customList)
workbook.DataSorter.Sort(cellRange)

workbook.SaveToFile("output/CustomSortList.xlsx", ExcelVersion.Version2016)
workbook.Dispose()
要点 :排序列中的值按 customList 中出现的先后顺序归位,而不是按数值大小比较。仍对 A1:G13 整个范围执行 Sort(),A 列各值的相对位置将按列表给定顺序排列。
需要注意两点:
- 自定义列表中的元素类型应与排序列的数据类型一致(本例中数字以字符串形式给出),否则可能无法正确匹配。
- 如果排序列中出现自定义列表里没有的值,这些值的相对位置需以实际运行结果为准;建议正式排序前先核对数据与列表的对应关系。
三、三种场景对比
场景 | 操作范围 | 排序依据 | 适用情况 |
|---|---|---|---|
单列排序 | 仅目标列 | 按数值升序 / 降序 | 只需重排某一列自身 |
整表排序 | 整张表(按某列) | 按某列数值升序 / 降序 | 按关键字对整行数据排序 |
自定义序列排序 | 整张表 | 按自定义列表顺序 | 业务有既定排列规则 |
三者最核心的区别在"操作范围":范围决定哪些数据参与重排,排序关键字决定按什么规则排。单列排序与整表排序的代码几乎相同,差别只在传给 Sort() 的区域;自定义序列排序则把排序依据从"数值比较"换成了"列表顺序"。
四、小结
使用 Spire.XLS for Python 排序时,把握三点即可覆盖多数场景:
- 先处理公式 :排序前把公式转为静态值,避免引用错乱。
- 选对操作范围 :只重排某列就传单列区域;要整行联动就传整表区域。
- 注意列索引从 0 开始 :配置
SortColumns.Add()时对照表结构确认列号。
按这三步对照自己的数据,再套用上面三种场景的代码,基本就能完成常见的 Excel 排序任务。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号