AI 图像编辑的文字与多图能力怎么测?一套对照方法
原创
关于图像生成与编辑模型,公开信息里能查到的多是演示图:一张构图讲究、文字工整、元素繁多的成品。这类图能说明「模型做得到」,说明不了「你去做的时候能不能稳定做到」。
两者的差距不小。演示图通常是从多次生成里挑出来的一张,而实际任务是批量跑,要的是稳定区间,不是上限。
这篇给一套可以直接照做的对照方法:三个实验,分别测文字渲染、多图融合、风格迁移,每个实验只动一个变量,其余全部锁死。跑完之后拿到的不是「谁更强」,而是「这类任务在这个模型上的稳定区在哪」。
一、先定评分口径,再开始跑
没有口径的测试结果没法比较。三个等级够用:可用、半可用、不可用。关键是每一级的判定要写成看得见的条件,而不是「感觉还行」。
等级 | 判定条件 | 怎么记 |
|---|---|---|
可用 | 要素齐全、无明显错字、可直接交付 | 记 1 |
半可用 | 主体正确,但有 1–2 处需修(漏字、边缘、光向) | 记 0.5 |
不可用 | 主体错误、文字大段崩坏、结构变形 | 记 0 |
评分由两个人独立做一遍,不一致的样本拿出来复核。一个人评容易带自己的偏好,尤其是「半可用」这一档,边界比较模糊。
样本量上,每个变量组合至少 10 次生成。少于 10 次,单次波动就能把结论带偏。
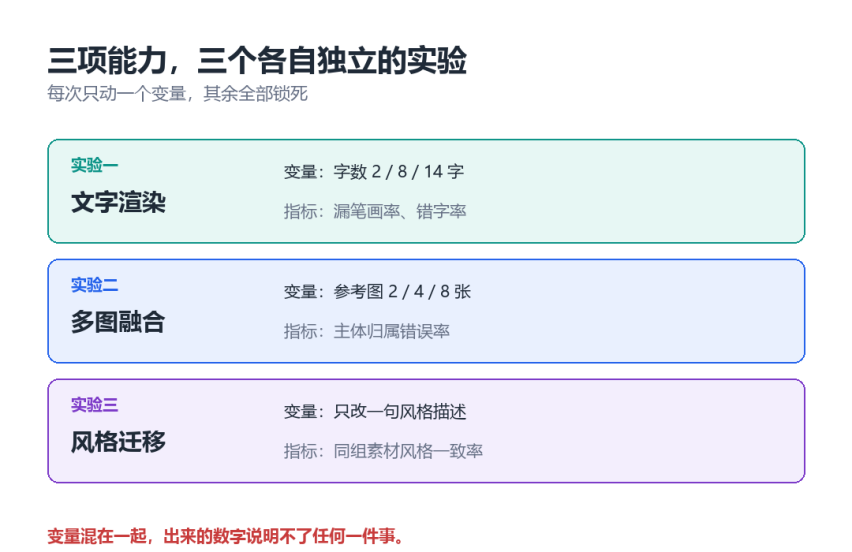
图 1:三个实验各自的自变量与观测指标。示意图由本文绘制。
二、实验一:文字渲染,测的是长度而不是美观
文字是这类模型容易翻车的地方,但它翻车的方式跟直觉不一样:短词几乎不出错,长串几乎不出对。所以变量要按字数分档,而不是按「好看/难看」分。
设计:同一套提示词模板,只改要渲染的字数——2 字短词、8 字标题、14 字长串三档,每档 10 次。语言固定中文,字体描述固定,画面主体固定。
指标记三个:漏笔画率(有字但缺笔画)、错字率(写成别的字)、位置偏移(字跑出预留区)。三个指标分开记,因为它们的成因不同——漏笔画多半跟分辨率有关,错字跟字义理解有关。
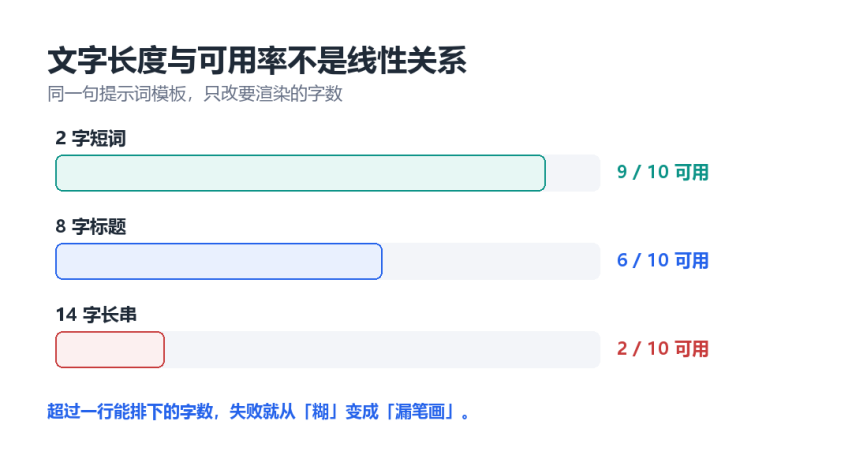
图 2:同一模板下,三种文字长度的可用率分布。示意图由本文绘制。
结果读法:短词档的可用率接近满值,8 字档开始掉,14 字档掉得明显。这不是线性关系,拐点通常出现在「一行排不下」的位置。
这里有个容易被忽略的细节:把分辨率提上去之后,文字出错的形态会变。低分辨率是糊成一团,高分辨率是看得清但漏笔画。所以文字类任务必须用交付分辨率来测,用低分辨率的结果判断「字没问题」,等于没测。
三、实验二:多图融合,测的是归属判断
多图参考的能力,宣传里说的是「能同时参考多张素材」。实际用起来,问题不在能不能参考,在归谁——把 A 的主体配到 B 的场景上,这类错误肉眼一眼能看出来,但跑批量时很容易漏。
设计:固定主体图一张,参考图分别给 2 张、4 张、8 张,每档 10 次。提示词只描述成品要什么,不指定「哪张当主体」——因为真实使用中,多数人不会指定。
指标记主体归属错误率:成品里的主体不是指定的那张,或主体与场景来自不同参考图,都算错误。
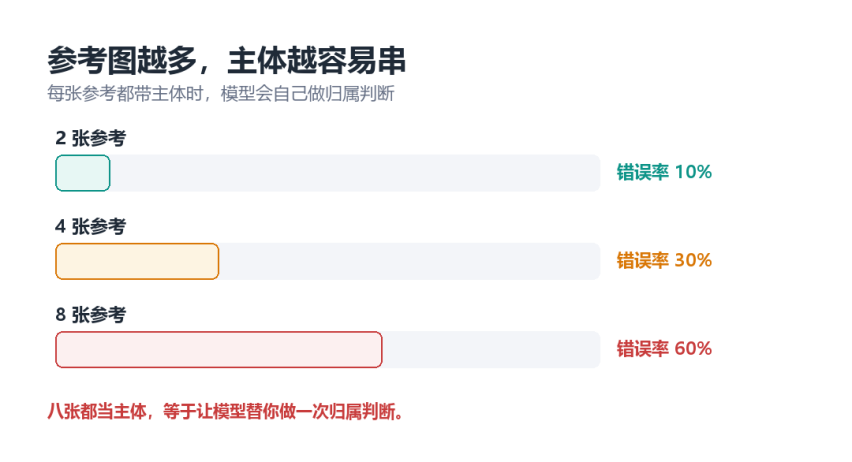
图 3:参考图张数与主体归属错误率的关系。示意图由本文绘制。
结果读法:2 张时错误率低,4 张开始上升,8 张时超过一半。原因是参考图一多,每张都带主体,模型需要自己做一次归属判断,而它没有可靠依据。
这条结论的实用价值是:多图参考不解决「素材多」的问题,只解决「素材要融合」的问题。素材一多,正确做法是先人工挑出 2–3 张,再丢进去,而不是全部丢进去让模型自己选。
四、实验三:风格迁移,测的是一致性
风格迁移的测试跟前面两个不同,它不看单张好不好看,看一组图之间像不像同一套。
设计:固定 5 张素材,第一轮只写一句风格描述(比如「浅色木纹台面,左上侧光,冷调」),生成 5 张;第二轮把这一句改成另一句,再生成 5 张。两轮之间,其余参数全部不动。
指标是同组一致率:同一轮内 5 张放在一起,风格是否统一;两轮之间,差异是否只在描述的那一项上。
结果读法:一句风格描述能控制的维度是有限的。它能稳定控制色调、光线方向这类全局属性;控制不了材质细节和构图节奏,这两项还得进提示词的具体描述里。
所以「只改一句就换一套气质」这种说法要打折听:换的是气质,不是细节;真要换细节,还是得改提示词本体。
五、三个实验放在一起看
能力 | 稳定区 | 超出稳定区之后 |
|---|---|---|
文字渲染 | 一行以内、8 字以内 | 漏笔画,且分辨率越高越明显 |
多图融合 | 参考图 2–3 张 | 主体归属开始出错 |
风格迁移 | 色调、光向等全局属性 | 材质与构图控制不住 |
这张表的用法不是记数字,是记边界的位置:知道边界在哪,就知道什么时候该人工介入。
举一个具体例子。一个详情页要出 9 张图,其中 2 张带文字。按上面的边界,正确的做法是:带文字的 2 张单独跑、单独验收,字数压到一行以内;剩下 7 张批量跑。而不是 9 张一起批量,结果在 2 张上反复返工。
六、把测试跑成脚本
手工记 30 次结果很难坚持,落成表就容易多了。结果表按「实验 / 变量 / 样本号 / 评分 / 问题类型」五列记,跑完用几行代码算比率。
# 读结果表算各档可用率,不依赖界面,能反复跑
import csv
from collections import defaultdict
def rate(path):
    stat = defaultdict(lambda: [0, 0.0])
    with open(path, encoding="utf-8") as f:
        for row in csv.DictReader(f):
            key = (row["实验"], row["变量"])
            stat[key][0] += 1
            stat[key][1] += float(row["评分"])
    for (exp, var), (n, s) in sorted(stat.items()):
        # 可用率:可用记 1、半可用记 0.5,按样本数归一
        print(f"{exp:<8}{var:<10}{s / n:6.1%}  n={n}")
rate("result.csv")
问题类型那一列不要省。只记分数,只知道「这档不行」,不知道「为什么不行」;记了类型,才知道是该改提示词、改张数,还是改验收档。
七、误差与局限
样本量小是第一层误差。每档 10 次只能看出趋势,不能当精确数字用。要比较两个版本的细微差别,样本量得往上加。
模型更新是第二层。这类模型的版本迭代快,今天测出来的边界,下个版本可能就移了。所以结论要带日期,别当成长期不变的事实。
第三层是任务相关性。测试用的是固定素材、固定模板,换一类商品,结论的方向可能一致,拐点的位置会变。
还有一层是评分的主观性。两个评分人之间的一致性如果没有核对过,结果里就混进了个人偏好。做法是每周抽 10 个样本双评,算一下一致率,低于八成就要回去对口径。
八、常见问题
问:一定要两个评分人吗?
能做到就做,做不到就隔一天自评两次。同一人连续评,标准会漂。
问:为什么不用打分制?
百分制在小样本上会把误差放大成假精度。三档加半档已经够区分,再多就是自我安慰。
问:测完要不要换模型?
不一定。测完先看边界在哪,再决定是换模型,还是把任务拆开。多数情况下,拆任务比换模型更有效。
问:这套方法能测视频模型吗?
思路能搬,指标要换。视频多一个时间维度,得加帧间一致性和运动合理性两项。
九、小结
把「能不能用」变成可测的三件事:文字渲染看长度、多图融合看归属、风格迁移看一致性。三件事都只动一个变量,其余锁死。
测完得到的不是排名,是边界。边界的位置比上限的数字有用——上限只决定做得好的那张有多好,边界决定批量交付能不能稳住。
我测试时用的环境是 Flux Art,好处是几个代际并列在同一个入口里,同一套提示词切换着跑比较省事;麻烦的地方在于切换版本会重置一部分参数,每次换完得重新对一遍,否则前后两轮就不是同一个条件了——这一点在对照实验里很要命。
文中数据来自固定素材、固定模板下的重复尝试,样本量见各节说明,方法可复用,结论不外推。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号