CISPO(Clipped Importance Sampling Policy Optimization,剪裁重要性采样策略优化)是一种在大语言模型 RL/Alignment(对齐与强化学习)阶段使用的策略梯度(Policy Gradient)损失函数算法(Chen et al., 2024;Khatri et al., 2024)。CISPO 使用裁剪后重要性比率作为系数的策略梯度,与直接裁剪目标函数的 PPO 不同,CISPO 裁剪的是比率本身,并将其从计算图中分离,再用它对对数概率加权。
CISPO 的目标函数为:
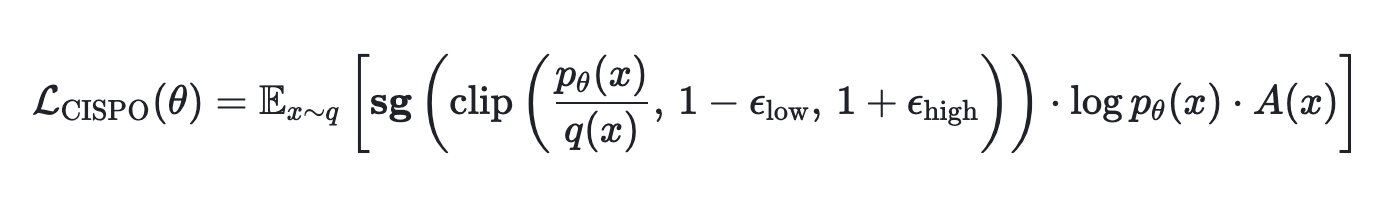
与 PPO 的关键区别:裁剪掩码是分离的(
sg = 停止梯度),因此它只作为一个纯粹的加权系数,而不会影响梯度流动。实现
# Compute probability ratioprob_ratio = torch.exp(target_logprobs - sampling_logprobs)# Apply clippingclipped_ratio = torch.clamp(prob_ratio, clip_low_threshold, clip_high_threshold)# Compute CISPO objective (detach the clipped ratio — this is the key difference from PPO)cispo_objective = clipped_ratio.detach() * target_logprobs * advantages# CISPO loss is negative of objectiveloss = -cispo_objective.sum()
输入张量
Key | Shape | 说明 |
target_tokens | (N,) | 目标 token ID(来自采样器 q) |
logprobs | (N,) | 这些 token 的 sampling_logprobs |
advantages | (N,) | RL 中的优势值 |
输出张量
Key | Shape | 说明 |
logprobs | (N,) | 这些 token 的 target_logprobs |
诊断信息
loss:sum(标量):CISPO 损失之和裁剪阈值的选择
由于裁剪后的比率是对 log pθ 的一个分离系数(而不是像 PPO 那样直接裁剪目标函数本身),CISPO 永远不会把某个 token 的梯度置零 —— 它只是约束系数的量级。这正是阈值(尤其是下界)的取值之所以重要的原因。
默认是单侧裁剪。CISPO 默认关闭下界,只对上限作封顶(
clip_low_threshold=0.0、clip_high_threshold=4.0),因此不传 loss_fn_config 就能得到这一行为。若要显式指定:fwd_bwd_future = await training_client.forward_backward_async(data=data,loss_fn="cispo",loss_fn_config={"clip_low_threshold": 0.0, "clip_high_threshold": 4.0})fwd_bwd_result = await fwd_bwd_future.result_async()
在任何场景下这都是一个安全的默认值。没有下界时,最坏情况不过是系数退回到普通的重要性采样权重,而这本身表现良好。相反,一个正的
clip_low_threshold(例如 0.8)会为那些比率已远低于 1 的 token 也作托底,这些是策略已经远离的 token,从而抹掉了重要性采样为陈旧 token 提供的衰减作用。
在 on-policy 下这很少产生影响,但在 off-policy(异步场景,采样器 q 落后于训练器 pθ)下,它可能形成正反馈循环:采样器与训练器之间的 KL 增大,更多 token 落到区间之外,偏差增大,KL 进一步增大。因此,去掉下界几乎没有代价,在 off-policy 下却有实实在在的收益。
这与引入并扩展 CISPO 的两篇论文都一致。MiniMax-M1(Chen et al., 2024)报告称:“我们没有对 IS 权重施加下界,而是把 ϵlowIS 设为一个很大的值;我们只调了 ϵhighIS。”ScaleRL(Khatri et al., 2024)使用 clip(r, 0, ϵmax),并发现 CISPO 对上限基本不敏感, ϵmax 取 4、5、8 时表现相同。因此在该范围内取一个宽松的上限是安全的默认值。


