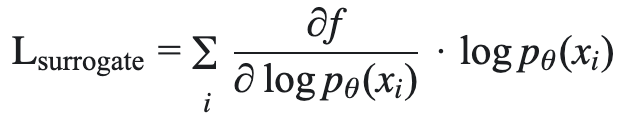对于内置损失函数无法覆盖的场景,TCRL 提供了
forward_backward_custom 和 forward_backward_custom_async,用于计算更通用的一类损失函数(代价是会带来一些额外延迟)。基本用法
自定义损失函数接收数据和模型的 logprobs,并返回一个标量损失以及可选的指标:
def logprob_squared_loss(data: list[Datum], logprobs: list[torch.Tensor]) -> tuple[torch.Tensor, dict[str, float]]:loss = (logprobs ** 2).sum()return loss, {"logprob_squared_loss": loss.item()}
future = training_client.forward_backward_custom(data, logprob_squared_loss)result = future.result()print(f"Loss: {result.loss}, Metrics: {result.metrics}")
多序列损失
您也可以定义一次作用于多个序列的损失函数:
def variance_loss(data: list[Datum], logprobs: list[torch.Tensor]) -> tuple[torch.Tensor, dict[str, float]]:flat_logprobs = torch.cat(logprobs)variance = torch.var(flat_logprobs)return variance, {"variance_loss": variance.item()}
更实用的场景是在成对比较数据上计算 Bradley-Terry 损失(参见论文 Learning to Summarize),或 Direct Preference Optimization(直接偏好优化,DPO)—— 详见 DPO 与偏好教程。
多目标损失
您可以将
forward_backward_custom 与多目标 target_tokens 配合使用,在特定序列位置上针对一个小型候选集定义损失。例如,掩码交叉熵损失会在四个答案 token 上(而不是整个词表上)重新归一化,从而用于训练多项选择题:import torchimport tinkermessages = [{"role": "user", "content": ("What is the capital of France?\\n""A) London\\n""B) Paris\\n""C) Berlin\\n""D) Madrid\\n""Answer Letter:")}]prompt_tokens = tokenizer.apply_chat_template(messages, add_generation_prompt=True)# Extract token IDs for the four answer letters.a_token = tokenizer.encode(" A", add_special_tokens=False)[0]b_token = tokenizer.encode(" B", add_special_tokens=False)[0]c_token = tokenizer.encode(" C", add_special_tokens=False)[0]d_token = tokenizer.encode(" D", add_special_tokens=False)[0]target_tokens = torch.zeros(len(prompt_tokens), 4, dtype=torch.long)target_tokens[-1] = torch.tensor([a_token, b_token, c_token, d_token])datum = tinker.Datum(model_input=tinker.ModelInput.from_ints(prompt_tokens),loss_fn_inputs={"target_tokens": target_tokens},)CORRECT_ANSWER_IDX = 1 # B) Parisdef masked_ce_loss(data, logprobs_list):# logprobs_list[i] has shape [N, K=4] for each datum# Renormalize over just the four answer tokens instead of the full vocabulary.answer_logprobs = logprobs_list[0][-1] # shape [K=4]answer_logprobs = answer_logprobs - torch.logsumexp(answer_logprobs, dim=-1)loss = -answer_logprobs[CORRECT_ANSWER_IDX]return loss, {"masked_ce": loss.item()}future = training_client.forward_backward_custom([datum], masked_ce_loss)result = future.result()
说明:
如果您正在使用的自定义损失函数具有通用价值,请告诉我们(联系 tcrl@tencent.com),我们会将其加入内置损失函数列表。这些方法的
async 版本请参阅 Async Patterns 教程。forward_backward_custom 的工作原理
使用
forward_backward_custom 并不需要阅读本节,但其中的关键点是:TCRL 不会序列化(pickle)您的函数,也不会将其发送到服务端。相反,它会把梯度计算拆解为一次 forward 调用,加上一次针对加权交叉熵损失的 forward_backward 调用,从而计算出完全正确的梯度。从数学上看,从完整的非线性损失出发:
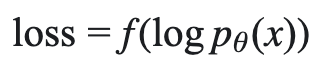
TCRL 会构造一个关于 logprobs 呈线性、但梯度完全相同的代理损失: