DRO(Direct Reward Optimization,直接奖励优化) 是一种在大语言模型 RL/Alignment(对齐)阶段 用于直接优化人类偏好或隐式奖励的损失函数(Loss Function)。与传统 PPO 需要额外训练独立的奖励模型(Reward Model)不同,DRO 继承了 DPO(Direct Preference Optimization)等算法的思想,通过数学变换将奖励函数直接融合到策略模型的损失计算中,从而无需复杂的两阶段强化学习过程,实现更高效、稳定的偏好对齐与优化。
DRO(Richemond et al., 2024;Kimi Team et al., 2025)是一种通用的离策略(甚至离线)RL 方法,它通过二次惩罚项来约束策略更新。请注意,该损失使用了一种不同的(软)优势估计形式,需要在客户端自行实现。
DRO 的目标函数为:
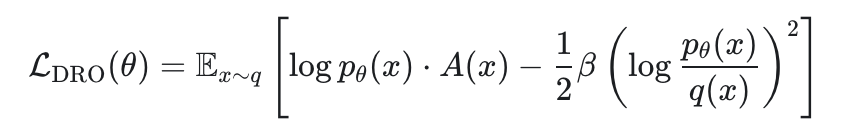
二次惩罚项 1/2β(log pθ/q)2 可防止学习器偏离采样分布过远。
实现
# Compute quadratic penalty termquadratic_term = (target_logprobs - sampling_logprobs) ** 2# Compute DRO objectivedro_objective = target_logprobs * advantages - 0.5 * beta * quadratic_term# DRO loss is negative of objectiveloss = -dro_objective.sum()
输入张量
Key | Shape | 说明 |
target_tokens | (N,) | 目标 token ID(来自采样器 q) |
logprobs | (N,) | 这些 token 的 sampling_logprobs |
advantages | (N,) | RL 中的优势值 |
输出张量
Key | Shape | 说明 |
logprobs | (N,) | 这些 token 的 target_logprobs |
诊断信息
loss:sum(标量):DRO 损失之和自定义 beta
fwd_bwd_future = await training_client.forward_backward_async(data=data,loss_fn="dro",loss_fn_config={"beta": 0.05})fwd_bwd_result = await fwd_bwd_future.result_async()


