PPO(Proximal Policy Optimization,近端策略优化)是一种在强化学习(RL)中广泛应用的算法(由 Schulman 等人于 2017 年提出),也是大语言模型在
RL/Alignment(对齐)阶段最核心的 Loss Function 之一。是一种通过设置“剪裁区间(Clipping)”来限制新旧策略更新幅度的强化学习算法,确保模型在自我演进和探索过程中不会因单次调整过猛而“崩溃或吐乱码”。
裁剪目标函数为:
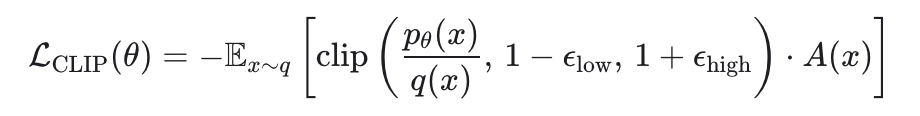
最终的 PPO 损失取裁剪后与未裁剪目标函数中的较小值:
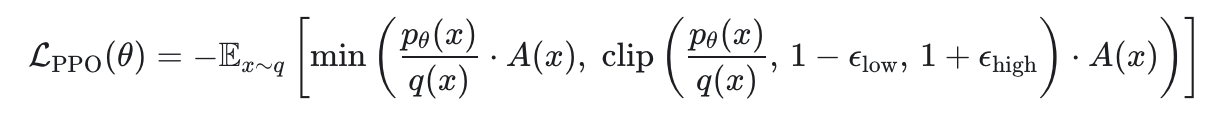
其中 εlow 和 εhigh 为超参数(默认值:0.2)。请注意,裁剪与损失计算都是逐 token 应用的。
实现
# Compute probability ratioprob_ratio = torch.exp(target_logprobs - sampling_logprobs)# Apply clippingclipped_ratio = torch.clamp(prob_ratio, clip_low_threshold, clip_high_threshold)# Compute both objectivesunclipped_objective = prob_ratio * advantagesclipped_objective = clipped_ratio * advantages# Take minimum (most conservative)ppo_objective = torch.min(unclipped_objective, clipped_objective)# PPO loss is negative of objectiveloss = -ppo_objective.sum()
输入张量
Key | Shape | 说明 |
target_tokens | (N,) | 目标 token ID(来自采样器 q) |
logprobs | (N,) | 这些 token 的 sampling_logprobs |
advantages | (N,) | RL 中的优势值 |
输出张量
Key | Shape | 说明 |
logprobs | (N,) | 这些 token 的 target_logprobs |
诊断信息
loss:sum(标量)— PPO 裁剪损失之和自定义裁剪阈值
fwd_bwd_future = await training_client.forward_backward_async(data=data,loss_fn="ppo",loss_fn_config={"clip_low_threshold": 0.9, "clip_high_threshold": 1.1})fwd_bwd_result = await fwd_bwd_future.result_async()


