Importance Sampling(重要性采样) 是统计学和强化学习(RL)中的一种采样与估计方法, 是一种通过利用“已知分布(旧模型/采样器)”生成的数据,来精确估计和训练“另一个未知或在新变动中的分布(新模型/学习器)”的数学方法。
痛点:大模型生成文本(Rollout)极其消耗算力,如果模型参数每更新一次就重新生成一批数据,训练速度会慢到无法接受。
解法:允许模型用“旧模型吐出的回答数据(q)”来训练“最新的模型(pθ)”。
机制:通过乘上比值 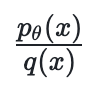
这是策略梯度目标函数的一个常见变体,当学习策略 pθ 可能因非确定性、策略更新滞后或其他原因而与采样策略 q 不一致时使用。
朴素目标函数为:
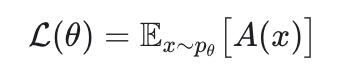
当 x ∼ q(采样器)与 x ∼ pθ(学习器)不匹配时,它存在偏差。重要性采样对此进行修正:
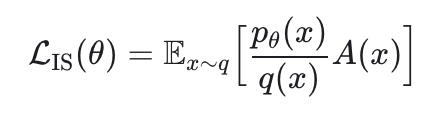
其中:
log pθ(x) :来自学习器的
target_logprobs(forward_backward 的前向传播)log q(x) :来自采样器的
sampling_logprobs(在采样(rollout)过程中记录)实现
# Compute probability ratioprob_ratio = torch.exp(target_logprobs - sampling_logprobs)# Compute importance-weighted lossloss = -(prob_ratio * advantages).sum()
输入张量
Key | Shape | 说明 |
target_tokens | (N,) | 目标 token ID(来自采样器 q) |
logprobs | (N,) | 这些 token 的 sampling_logprobs |
advantages | (N,) | 优势值(正值用于强化,负值用于抑制) |
输出张量
Key | Shape | 说明 |
logprobs | (N,) | 这些 token 的 target_logprobs |
诊断信息
loss:sum(标量):重要性加权策略梯度损失之和 ℒIS


