交叉熵(Cross-Entropy) 是信息论和机器学习中用于衡量两个概率分布之间差异程度的数学量。在大语言模型(LLM)和分类任务中,交叉熵常被用作 损失函数(Loss Function),用来量化“模型的预测概率分布”与“真实标签分布”之间的差距。
标准交叉熵损失(负对数似然),它优化策略 pθ,使目标 token x 的对数概率最大化:
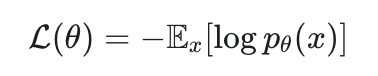
其中
weights 取值非 0 即 1,通常由 renderer.build_supervised_example() 生成,该函数返回 (model_input, weights),用于指定需要参与训练的 assistant 轮次。实现
# Apply weights and compute elementwise losselementwise_loss = -target_logprobs * weights# Apply sum reduction to get the total lossloss = elementwise_loss.sum() # scalar
输入张量
Key | Shape | 说明 |
target_tokens | (N,) 或 (N, K) | 目标 token ID |
weights | (N,) 或 (N, K) | 逐 token 的损失权重(通常来自 renderer) |
输出张量
Key | Shape | 说明 |
logprobs | (N,) 或 (N, K) | 所请求目标 token 的对数概率 |
诊断信息
loss:sum(标量)— 加权交叉熵损失之和Top-K 蒸馏
当输入张量的形状为
(N, K) 时,cross_entropy 会提取学生模型在每个位置上 K 个目标 token 的 logprobs,并计算: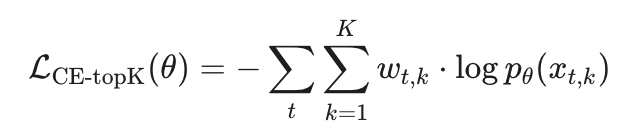
其中 wt,k 为用户提供的权重。对于软目标蒸馏,令 wt,k = p̃teacher(xt,k),即教师模型在 top-K token 上重新归一化后的概率。对于硬目标训练,则将单个候选 token 的权重置为 1.0,其余置为 0.0。
示例:将 Qwen3-235B 蒸馏为 Qwen3-30B
下面的示例从教师模型采样一段补全内容,在每个生成位置恢复其 top-K 分布,并训练学生模型去拟合该分布。
import tinkerimport torchfrom transformers import AutoTokenizertokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-235B-A22B-Instruct-2507")K = 20service_client = tinker.ServiceClient()teacher_sampling_client = await service_client.create_sampling_client_async(base_model="Qwen/Qwen3-235B-A22B-Instruct-2507")student_training_client = await service_client.create_lora_training_client_async(base_model="Qwen/Qwen3-30B-A3B-Instruct-2507")messages = [{"role": "user", "content": "Write a Python function to compute the nth Fibonacci number efficiently."}]prompt_tokens = tokenizer.apply_chat_template(messages, add_generation_prompt=True)# 1. Sample a completion from the teacher.sample_response = await teacher_sampling_client.sample_async(prompt=tinker.ModelInput.from_ints(prompt_tokens),num_samples=1,sampling_params=tinker.SamplingParams(max_tokens=512, temperature=0.7),)sampled_tokens = list(sample_response.sequences[0].tokens)# 2. Teacher-force the completion to recover top-K logprobs at each position.teacher_forced = tinker.ModelInput.from_ints(prompt_tokens + sampled_tokens)topk_response = await teacher_sampling_client.sample_async(prompt=teacher_forced,num_samples=1,sampling_params=tinker.SamplingParams(max_tokens=1),include_prompt_logprobs=True,topk_prompt_logprobs=K,)output_toks_with_logprobs = topk_response.topk_prompt_logprobs[len(prompt_tokens):]seq_len = len(output_toks_with_logprobs)teacher_tokens = torch.tensor([[tok_id for tok_id, _ in row] for row in output_toks_with_logprobs], dtype=torch.long) # [seq_len, K]teacher_logprobs = torch.tensor([[lp for _, lp in row] for row in output_toks_with_logprobs]) # [seq_len, K]# Renormalize teacher logprobs over top-K via logsumexp.teacher_logprobs -= torch.logsumexp(teacher_logprobs, dim=-1, keepdim=True)# Build shifted student_input: prompt + completion[:-1], so position t predicts token t+1.student_input = prompt_tokens + sampled_tokens[:-1]gen_start = len(prompt_tokens) - 1target_tokens = torch.zeros(len(student_input), K, dtype=torch.long)target_tokens[gen_start : gen_start + seq_len] = teacher_tokensweights = torch.zeros(len(student_input), K)weights[gen_start : gen_start + seq_len] = teacher_logprobs.exp()datum = tinker.Datum(model_input=tinker.ModelInput.from_ints(student_input),loss_fn_inputs={"target_tokens": target_tokens,"weights": weights,},)fwdbwd_future = await student_training_client.forward_backward_async([datum], loss_fn="cross_entropy")fwdbwd_result = await fwdbwd_future.result_async()


