知识库不是资料堆S/A/P/B 四档分级与飞轮运营
原创
知识库不是资料堆S/A/P/B 四档分级与飞轮运营
原创
OneCode
发布于 2026-11-10 16:48:15
发布于 2026-11-10 16:48:15
企业知识库最容易变成资料堆:文档越存越多,字段口径却各说各话。本文给出一套可落地的工程化方法——先按确定性把知识分成 S/A/P/B 四档,再由 FDE 完成盘点、抽取、清洗与审计入库,用统一本体接口同时赋能 LLM、工具与用户,最后以双闭环和三道门禁让知识库持续自增强。
2026-11-10模块基线 ooder-biz-form方法 + 参考架构v2.2 · 方法论版
本文结构:01问题与机制 | 02方法与 FDE | 03架构与消费 | 04价值与利用栈 | 05运营与治理 | 06验证 | 07结语
关键词:数据知识库 · S/A/P/B 分档 · FDE · 本体接口 · 数据飞轮
摘要 · 本文主张
- 分档是方法:知识必须按确定性分成 S/A/P/B 四档——S 级直接成规则,A 级只做关联打分与候选,P 级只做语义环境增强,B 级全量留痕、单向晋升。
- 接口是架构:三类 Agent 消费同一个本体索引,接口不变、维度可扩;新增知识维度不需要改造每个消费者。
- 利用是价值路径:JVE(本地判定引擎)管确定性回答的“快与准”,BGM3(生成式回答大模型)+ 高精度向量库管生成式回答的“广与好”,分流由 L2 编排完成。
- 运营是闭环:入口埋点、晋升门禁、回归门禁三件套,决定飞轮是在自增强,还是在制造数据漂移。
CHAPTER 01问题与机制:知识库为什么会变成资料堆
知识库项目最常见的失败,不是数据不够多,而是数据没有分层:文档、字典、会话纠偏混在一起,谁也说不清哪条能直接信、哪条只能作参考。结果就是检索很热闹,建模仍靠猜,纠偏沉不下来。
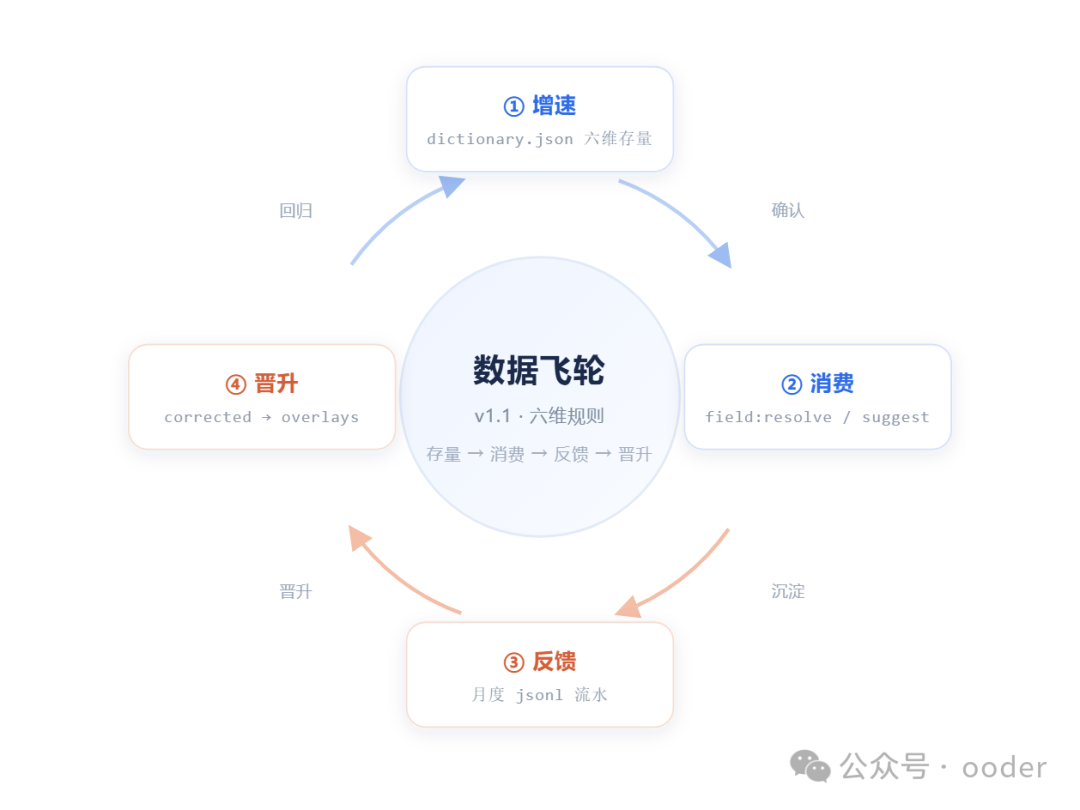
要解决这个问题,先把知识库当成一条工程流水线,而不是一个资料仓库。本文用一张飞轮图串起四件事:存量怎么来、消费怎么发生、反馈怎么沉淀、晋升怎么生效。
数据飞轮的本质是「存量知识 → 消费 → 反馈 → 晋升 → 更大的存量」的自增强回路。本系统将其拆解为四件套,每一件都有唯一的代码承载:
阶段 | 本系统实现 | 载体 |
|---|---|---|
增速(存量) | 字典 v1.1:dictionary.json 六维规则作为初始知识 | OntologyIndex.java |
反馈 | accepted / corrected / rejected / pending 月度流水 | OntologyFeedbackService.java |
晋升 | 多次一致 corrected → 字典候选(overlays),不改 base | OntologyPromotionService.java |
加速 | 重建索引 + 回归测试 → 下次 resolve 直接命中,补偿减少 | OntologyIndex.reload() + OntologyHarness |
图片
图 1-1 数据飞轮四阶段闭环(可点击放大)
◆ 判据
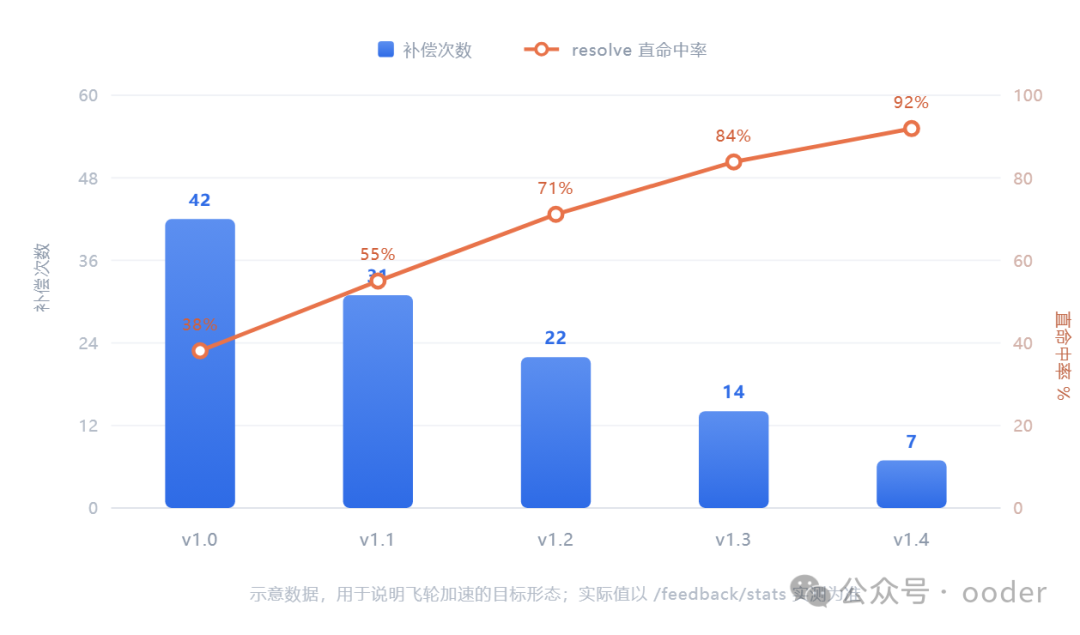
飞轮是否在转,只看一个指标——同一语义字段的重复补偿(fallback)次数是否随字典版本递减(第 5 章 /feedback/stats)。
CHAPTER 02方法:S/A/P/B 四档分级与 FDE 工作流
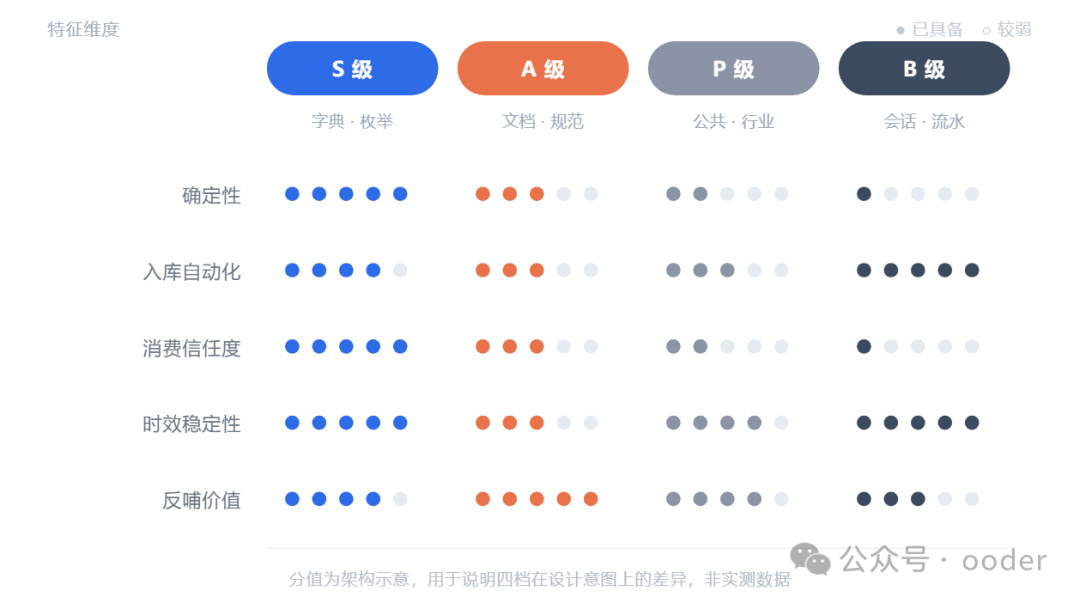
存量知识不是均质的。按确定性 × 加工方式划分为四档,每一档的入库方式、消费信任度、晋升路径完全不同:
2.0 背景:FDE 独立梳理数据知识库
FDE(Forward Deployed Engineer,前置部署工程师)是数据知识库的独立责任人:脱离功能开发主线,专职负责知识库的采集、清洗、分档与审计。设立独立角色的背景——知识库质量决定一切赋能的上限,且来源异构(业务系统、代码工程、文档语料、会话流水),需要专职视角统一治理,避免"谁开发谁顺手录知识"造成的口径漂移。FDE 的工作流见 2.5 节。
2.1 S 级:确定性·结构化数据(直接成规则)
S 级来自业务字典(业务系统字典、主数据、编码规范)与工程逆向的枚举及常量(如 @ComboBoxAnnotation enums、@Required、数据库列类型等注解元数据)。特征:机器可校验、有唯一出处、无歧义。直接写入 base dictionary(typeRules / enumOwnerAliases / columnTypeRules),人工可审计;resolve 直接命中,零确认。
2.2 A 级:高价值提取型数据(多维度关联 + 分值运算)
A 级来自规范文档、流程描述、规则规范、用户手册、产品规格。特征:人工撰写、价值密度高、但存在时效性与表述歧义。处理路径:知识化抽取 → 与 S 级确定性数据做多维度关联(语义相似度、字段标签命中、场景重合度、来源权威度),通过分值运算加权融合,作为辅助决策的候选打分输入——只出候选不出结论;与 S 级冲突时 S 级优先。技术规格见附录 C-1。
2.3 P(Public)级:高价值清洗型数据(语义环境增强)
P 级来自公共信息、行业规范等外部语料(P 即 Public,公共/行业语料)。特征:体量大、噪声高,但在适用范围内价值高。处理路径:清洗(去重、降噪、抽取领域术语与约束)→ 在适用范围内做语义环境增强——不进规则库,只进语义层,用于提供高质量的自然语言输出(提示词上下文、措辞规范、行业口径校准)。
2.4 B 级:会话生成数据(单向晋升)
B 级来自 模型补偿产出(llm-fallback-subflow)与用户会话纠偏。特征:逐条产生、质量参差。处理路径:全量进 feedback 流水(corrected / pending),永不直写 base;仅 suggestion 展示;达标后经 promote 晋升为候选,过 harness 后生效。样本永远保留原始上下文(会话、场景、操作人)供审计。
图片
图 2-1 四档数据的五维特征对比(示意分值)(可点击放大)
◆ 四条铁律 + 冲突消解
- S 级是地基:六维规则中凡可从工程/字典逆向的,一律先逆向成 S 级,不靠 LLM 猜。
- A 级不上规则:文档知识只进关联打分与 RAG 检索层,不得直接变成 typeRules——避免"手册过时即规则过时"。
- P 级只做语义增强:公共/行业语料只能在生成式输出的上下文里出现,禁止进入确定性规则通道,防止外部口径覆盖内部真源。
- B 级单向晋升:B → 候选 →(harness)→ 生效,路径唯一且可回滚。
冲突消解顺序:S > A > P > B。resolve 命中只在 S 级成立;A/P/B 级最多走到 human_confirm。
2.5 FDE 四步工作流:盘点 → 抽取 → 清洗 → 审计入库
分档不是一次性分类,而是一条由 FDE 负责的日常流水线。四步工作流如下:
步骤 | 动作 | 产出 | 对应档位 |
|---|---|---|---|
① 盘点 | 梳理客户业务系统清单:字典表、主数据、编码规范、流程文档、用户手册、行业规范,标注来源与更新节奏 | 数据源台账(来源 × 档位 × 更新频率) | 全部四档 |
② 抽取 | 从业务字典导出枚举与编码;从工程代码逆向枚举与常量(enum、常量类、配置项);从文档中提取字段规则、流程描述与业务规则 | 原始知识条目(术语、枚举、规则、描述) | S / A |
③ 清洗 | 术语归一(别名合并、大小写统一)、冲突消解(S > A > P > B)、脱敏与适用范围标注 | 可入库的结构化条目 | S / A / P |
④ 审计入库 | 人工可审计的 diff 形式写入 base 字典六维与 RAG 索引;版本化提交,可回滚 | dictionary.json vN + RAG 索引 | S / A / P |
◆ 边界
B 级数据不经 FDE 手工录入——它由飞轮自动沉淀(模型补偿产出 + 用户会话纠偏),FDE 只负责按季度审计晋升队列,执行 /feedback/{id}:decide 裁决与 /promote 晋升。手工录入与自动沉淀两条线永不交叉写入同一文件。
CHAPTER 03架构与消费:一个本体接口,三类 Agent
3.1 字典唯一真源:六维规则
OntologyIndex.reload() 从 dictionary.json 加载六个维度,构建 semantic / alias 双索引。六维全部只收 S 级与经晋升的候选:
维度 | 语义 | 典型消费者 |
|---|---|---|
typeRules | 字段类型 → 组件映射 | formAgent |
appearanceRules | 外观修饰(宽度/占位/格式) | formAgent、设计器 |
enumOwnerAliases | 枚举归属与别名(含 key:label 对) | formAgent、业务 Agent |
popSources | 弹选数据源(形式 × 实质) | 业务 Agent(popbox) |
namingTerms | 命名术语(中→英类/字段名) | codegen |
columnTypeRules | 数据库列类型 → 字段类型 | DB 逆向路线 |
关键设计决策:枚举、命名、弹选一律走字典,代码内不留硬编码(BusinessNaming / ExternalFormEntityMapper 的硬编码已移除,改为消费本体)。
3.2 统一消费 API
POST /api/ontology/field:resolve      字段解析:语义 → 类型/组件/枚举候选(唯一解析入口)
POST /api/ontology/field:suggest      字段建议:低置信时返回候选列表,触发 human_confirm
GET  /api/ontology/enum               枚举查询(key:label 对)
POST /api/ontology/reload             重建索引(晋升后必须调用)
POST /api/ontology/feedback           反馈写入(accepted/corrected/rejected/pending)
GET  /api/ontology/feedback/pending   待裁决队列
GET  /api/ontology/feedback/stats     飞轮指标
POST /api/ontology/feedback/{id}:decide  人工裁决 pending
POST /api/ontology/promote            corrected → 字典候选晋升
GET  /api/ontology/harness            回归测试
GET  /api/ontology/health             健康检查
接口不变、维度可扩:Agent 侧零改造即可消费新增维度。这是"统一本体模型接口"的核心承诺。
3.3 消费矩阵:三类 Agent 的维度差异
三类 Agent 消费同一个 OntologyIndex 与同一套 L2 接口,但各取所需维度:
formAgent(表单代理) | 流程 Agent | 业务 Agent | |
|---|---|---|---|
消费维度 | typeRules、appearanceRules、enumOwnerAliases、popSources | 表单绑定 + B 层定义的节点级裁切 | popSources(主数据)、enumOwnerAliases、LLM 补偿知识 |
入口 | FormConvertCapability → FormConvertService | ProcessDefinitionLoader + LegacyProcessDefinitionAdapter | MasterDataRegistry + PopService 家族 |
建模路线 | 模板导入(有成/钉钉)→ 字典/DB 驱动 → NLP 直接建模 | 消费任一路线产出的 B 层定义 | 为路线 2/3 提供字段候选 |
编排器 | DesignerFirst / DBFirst / ViewFirst Orchestrator | — | — |
产出 | B 层 .cls + codegen(VIEW/API/SPI/C 层) | 流程节点 → 审批页字段裁切 | popbox 数据源注册 |
飞轮触点 | field:suggest 低置信 → human_confirm → corrected | 裁切偏差 → pending 裁决 | 规则未命中 → LLM 补偿 → 知识回流 |
本体桥接点:FormOntologyBridge 是 gen 链(FormEntityBundle → FormFieldProcessor → FormLayoutBuilder → ExportJavaCompiler)与本体之间的唯一翻译层;BusinessNaming 消费 namingTerms 维度做中→英命名。
主数据弹选(形式 × 实质):形式(能否弹选)由 popSources 维度界定——凡具备"列表检索 + 单选/多选回填"形态的实体可注册为 popSource;实质(业务含义)由 PopService 家族声明——ProjectPopService、CustomerPopService、SupplierPopService、BankAccountPopService、CostCenterPopService 均继承 AbstractMasterDataPopService,统一从业务字典拉取 → 注册 Registry → 写入 popSources。
CHAPTER 04价值:三个赋能与利用栈四层
分档和接口解决“知识怎么组织”,本章回答“知识怎么变成价值”:三个赋能面回答谁受益,利用栈四层回答价值如何逐层放大。
4.1 三个赋能:LLM、工具、用户
知识库不是静态资料堆,而是被组织成三个赋能面——每一个面都从同一份 OntologyIndex 取数:
赋能面 | 消费的知识维度 | 实现载体 | 效果 |
|---|---|---|---|
赋能 LLM(更精准) | namingTerms 术语表注入提示词、enumOwnerAliases 消歧、popSources 主数据锚点 | L2 统一调用接口 + LLM 编排(意图路由、多工具调度、低置信走补偿链路) | 提示词口径一致、幻觉减少;能在接口层确定性解决的绝不进模型 |
赋能工具(快速精确建模) | typeRules、appearanceRules、columnTypeRules 直读 | formAgent 字段 resolve / suggest;流程 Agent 节点建模;codegen 生成 | 表单、流程建模不再依赖模型猜字段类型与显隐规则,规则直出、零确认命中 |
赋能用户(高质量回答、快速诊断) | S 级规则 → JVE 预判;A/P 级语料 → BGM3 + 高精度向量库 RAG | L3 双通道:确定性回答 + 生成式回答;诊断时按 popSources 追溯主数据源头 | 回答措辞专业、口径一致;问题定位从"翻代码"变为"查规则" |
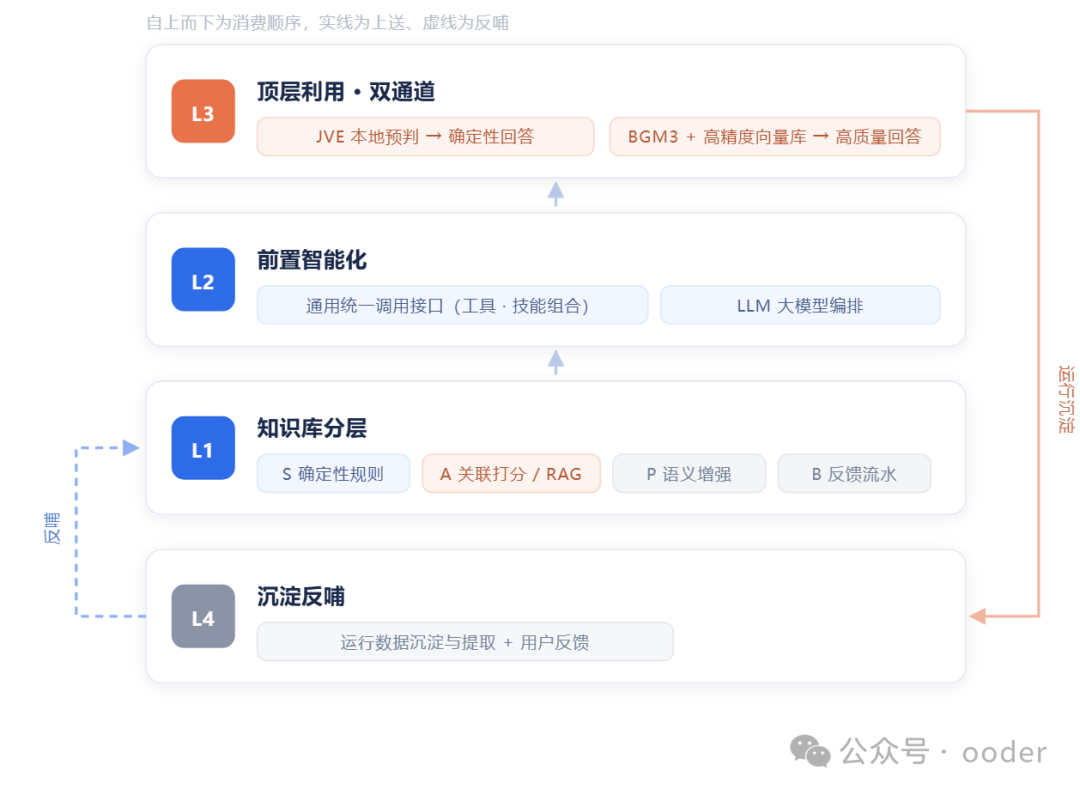
4.2 利用栈四层:从前置智能化到沉淀反哺
图片
图 4-1 数据利用栈四层(L4 反哺 L1 构成大闭环)(可点击放大)
- L1 知识库分层:四档分库存储(附录 B)——S 级进
dictionary.json,A 级进 RAG 索引与关联打分表,P 级进语义增强语料库,B 级进data/ontology/feedback/*.jsonl流水。每层有独立的准入、信任度与回滚机制。 - L2 前置智能化:通用统一调用接口(本体 API、SSE 事件契约、codegen、buildView 等工具技能组合)+ LLM 大模型编排。编排只处理"值得处理的问题"——低置信时判定走补偿链路(
llm-fallback-subflow)。 - L3 顶层利用 · 双通道:确定性回答通道——行业/专业小模型组合成 JVE(本地判定引擎)做本地快速预判,毫秒级、离线可用、结果可回归,命中 S 级规则的问题在此直接闭环;高质量回答通道——BGM3(生成式回答大模型)+ 高精度向量库对 A/P 级语料做 RAG,生成措辞专业、口径一致的输出。JVE 管"快与准",BGM3+向量库管"广与好",分流决策由 L2 编排完成。
- L4 沉淀反哺:运行数据(SSE 流水、resolve 命中率、补偿触发点)与用户反馈(accepted/corrected)反哺 L1——corrected 达标晋升为字典候选、知识条目回流 RAG、公共语料适用范围校准。
CHAPTER 05运营:双闭环、三道门禁与指标治理
飞轮不是“上线后自然发生”的,它需要三个工程抓手、两条闭环和一套指标来运营。
5.1 三个抓手:入口埋点、晋升门禁、回归门禁
三个工程抓手缺一不可:
- 入口埋点:所有消费路径的确认、纠偏、补偿事件统一落
/feedback流水(第 3 章 API)。没有埋点就没有原料。 - 晋升门禁:corrected 必须满足"多次一致 + harness 通过"才能晋升为 overlays 候选(
OntologyPromotionService),杜绝噪声进规则库。 - 回归门禁:
/reload必须通过OntologyHarness回归测试才生效——字典更新不能打破既有命中。
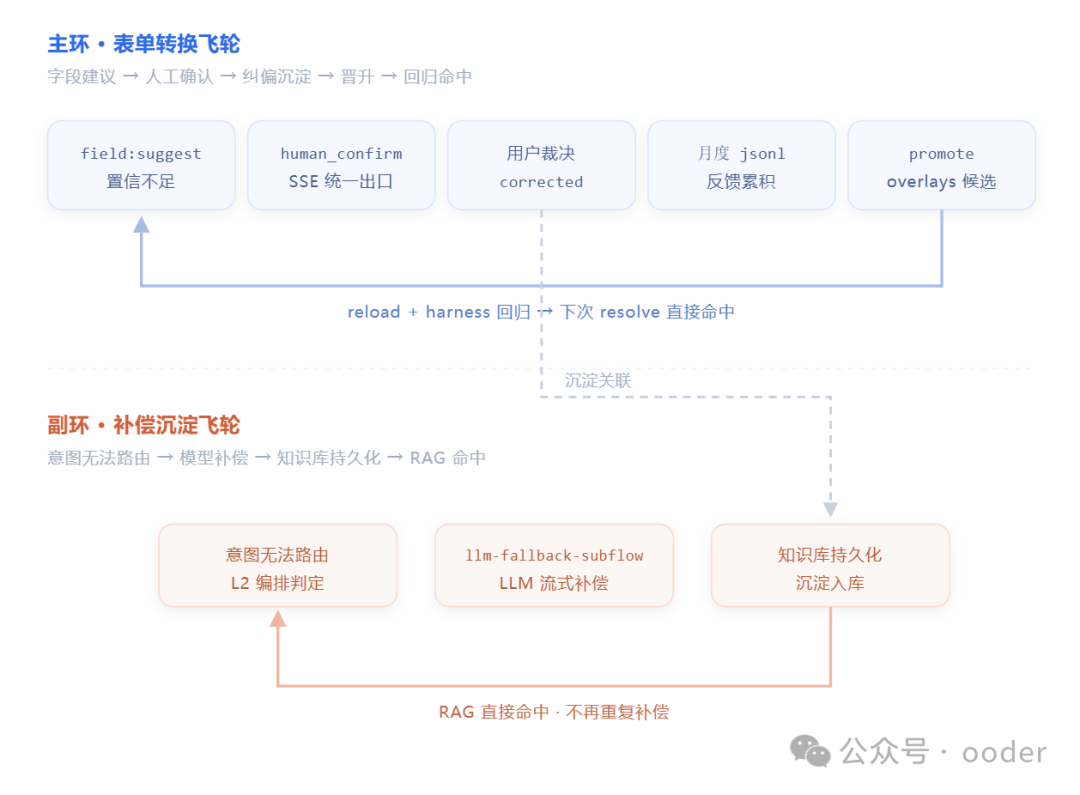
三个抓手对应 5.2 节的双闭环:主环(表单转换)与副环(补偿 → 知识库 → RAG)都沿着同一套门禁运转。
5.2 双闭环:表单转换环与补偿沉淀环
图片
图 5-1 主环与副环:两条闭环共享「解决一次,永久生效」的心智模型(可点击放大)
副环对应流程侧子流程 llm-fallback-subflow/definition.json:补偿判断 → LLM 配置解析 → 提示词构建 → 流式调用 → 响应应用 → 数据飞轮持久化。LLM 补偿结果写入知识库,下次相似查询 RAG 直接命中,不再重复补偿。
5.3 指标与治理:看什么、怎么裁决
指标 | 接口 | 治理动作 |
|---|---|---|
反馈漏斗(accepted/corrected/rejected/pending 计数) | GET /feedback/stats | corrected 率高 → 晋升候选多;rejected 率高 → 字典规则需人工修订 |
待裁决队列 | GET /feedback/pending | POST /feedback/{id}:decide 逐条裁决 |
晋升门禁 | OntologyPromotionService | 最小支持数 + final 签名一致 + 置信度阈值;不满足则留在 pending |
回归门禁 | GET /harness | 晋升后回归不通过 → 自动回滚 overlay 或人工介入 |
补偿频次 | llm-fallback-subflow 持久化统计 | 环比上升 → 知识覆盖缺口,补录术语 |
图片
图 5-2 主环加速效果(示意):字典版本递增 vs 补偿次数 / 直命中率(可点击放大)
◆ 治理纪律
三条底线:base dictionary 永远人工可审计;飞轮只能写 overlays;每次 reload 必须过 harness。这是数据飞轮不演变为数据漂移的底线。
分级治理补充(联动第 2 章):base dictionary 只收 S 级;A 级知识变更走文档评审后重抽关联打分与 RAG;P 级语料变更走适用范围评审;B 级晋升时必须核验与 S 级无冲突(冲突即拒绝晋升并留 pending)。
CHAPTER 06验证:五个用户故事与效果对比
每个故事标注其穿越的利用栈层级徽章:L1知识库分层 L2前置智能化 L3顶层利用 L4沉淀反哺。
US-1 L2L3 formAgent:模板导入报销单,观察 JVE 预判命中与 human_confirm
- 从 chatnext 右侧入口选择路线 1(
*模板导入),上传报销单模板(有成/钉钉导出均可,走 YouChengFormImportProvider / DingTalkFormImportProvider)。 - 观察 SSE 流:每张模板字段触发
field:resolve——S 级命中(JVE 本地预判通过)的字段直接产出组件建议,不进大模型。 - 命中失败的字段进入
field:suggest→ L2 编排降级到 LLM → SSE 推送human_confirm(统一键名出口:SseEventPushServiceL776)。 - 预期:常用财务字段(金额/日期/事由)零确认直接命中;生僻字段才弹确认。
US-2 L4L1 corrected 纠偏 → 晋升 → 版本递增复跑命中
- 在 US-1 的确认环节将某字段从候选 A 纠偏为候选 B。
POST /api/ontology/feedback,action=corrected,携带 final 签名(L4 沉淀)。GET /feedback/stats查看该月 corrected 计数;重复 2-3 次同向纠偏达到最小支持数。POST /promote→ 写入data/finance-dictionary/overlays/promotions.json(L1 反哺,S 级无冲突核验通过)。POST /reload+GET /harness回归通过。- 预期:重跑 US-1 相同模板,原确认字段不再弹 human_confirm,字典版本号 +1。
US-3 L1 流程 Agent 绑定 LeaveForm,C 层裁切共享同一真源
- B 层定义:
LeaveForm.java(@FormAnnotation+@CustomAnnotation元数据,枚举 key:label 对齐后入库为 S 级)。 - C 层:
ProcessFormController按活动定义裁切字段可编辑性(起草环节放开申请字段,审批环节放开 decision/opinion)。 - 预期:formAgent 生成的字段元数据与流程裁切读取的是同一份定义,无第二真源;审批页/待办页渲染与设计器预览一致。
US-4 S 级L2 业务 Agent:项目/客户主数据 popbox 接入
- 新增主数据源:继承 AbstractMasterDataPopService,实现拉取与检索;注册到 MasterDataRegistry。
- 在
dictionary.json的popSources维度补一条映射(字段语义 → popSource id)。 POST /reload重建索引。- 表单转换流程中该字段自动映射为 popbox 复合组件(comboxInput + 弹层),apiCall 指向 PopService。
- 预期:设计器预览与运行态弹选数据一致;新增主数据源零规则改动(仅配置 + PopService)。
US-5 L3L4 补偿生成 → 知识库 → RAG 加速(副环全链)
- 触发一次 NLP 意图无法直接路由的请求 → L2 编排判定走补偿链路 →
llm-fallback-subflow(L3 BGM3 通道)。 - LLM 补偿结果持久化到知识库(L4 沉淀节点)。
- 用相同语义的问法重新请求。
- 预期:第二次不再走补偿链路,高精度向量库 RAG 直接命中;
/feedback/stats中补偿次数环比下降。
效果对比:快速、精准、专业
知识库的最终检验标准在用户侧:快速 agent 构建一个业务应用时,流程、交互、回答、诊断四个方面是否可感知地变好。下表对比同一构建任务在「无知识库 / 有知识库」两种状态下的体验差异(构建任务:一条审批流 + 一张含枚举与主数据弹选字段的表单):
维度 | 无知识库 | 有知识库 |
|---|---|---|
流程(构建步骤数) | 每张表单都要走「猜字段类型 → 生成 → 人工逐字段确认 → 返工修正」的完整循环,步骤多且不可跳过;枚举字段几乎必错一次 | S 级规则命中 → field:resolve 直出类型与显隐规则,零确认跳过;仅低置信字段进 human_confirm,流程被压缩到必要步骤 |
交互(确认次数) | human_confirm 频繁弹出,用户在大量同质化裁决中疲劳;问题措辞随意,模型反复追问澄清 | 术语表 + 别名消歧使模型一次理解业务名词,追问显著减少;确认集中在真正的歧义点上,每次交互都有裁决价值 |
回答(口径与质量) | 同一问题不同会话答案不一致;字段含义靠模型泛化解释,偶发幻觉;「审批人」「单据类型」等术语各说各话 | namingTerms 统一口径、BGM3 + 高精度向量库做 RAG,回答措辞专业、跨会话口径一致;JVE 预判的确定性问题毫秒级返回且可回归 |
诊断(问题定位) | 字段值异常时从翻代码开始排查,缺乏业务语义线索;主数据来源说不清 | 按 popSources 直接追溯到 PopService 与业务字典源头;规则命中情况、补偿触发记录都在 /feedback/stats 流水里,诊断从「翻代码」变为「查规则」 |
四个维度收敛为三个体验关键词:
- 快速——流程被规则裁短:确定性字段直出、确定性回答毫秒级返回,构建步骤只随真实歧义线性增长;
- 精准——类型、枚举、显隐规则来自业务字典与工程逆向枚举,不再依赖模型猜测;分值运算让候选排序可解释;
- 专业——回答带着客户自己的术语、编码与业务口径,且随字典版本持续校准,越用越贴合现场。
CHAPTER 07结语:飞轮是否在转,只看三条门禁
回到开篇的问题:知识库的价值不在"存了多少",而在"下一次是否少问一次、少错一次"。本系统的答案可以收敛为三句话。
第一,分档是前提。S 级是地基,能逆向的绝不靠猜;A 级只做关联打分与候选,不上规则;P 级只做生成式回答的语义增强,不进确定性通道;B 级全量留痕、单向晋升。四档混在一起,知识库就会同时失去可信度和可维护性。
第二,接口是契约。三类 Agent 消费同一个 OntologyIndex,接口不变、维度可扩,Agent 侧零改造。统一接口不是抽象口号,而是让新增知识维度不必重新改造每个消费者。
第三,飞轮靠门禁。入口埋点、晋升门禁、回归门禁,三者缺一不可。没有埋点就没有原料;没有晋升门禁,噪声会进规则库;没有回归门禁,字典更新可能打破既有命中。飞轮与数据漂移的区别,只在这三道门禁。
◆ 一句话
知识库的价值不在"存了多少",而在"下一次是否少问一次、少错一次"。
落地顺序:先把可从字典与工程逆向的字段全部落成 S 级;再把 A/P 级接进关联打分、RAG 与语义环境层;最后打开 /feedback → /promote → /harness 的闭环。顺序反过来,飞轮就会空转。
APPENDIX附录
A. 核心类路径速查
层 | 类 | 路径 |
|---|---|---|
本体索引 | OntologyIndex | ooder-biz-form/.../chat/ontology/OntologyIndex.java |
本体 API | OntologyController | ooder-biz-form/.../chat/ontology/OntologyController.java |
反馈 | OntologyFeedbackService | ooder-biz-form/.../chat/ontology/OntologyFeedbackService.java |
晋升 | OntologyPromotionService | ooder-biz-form/.../chat/ontology/OntologyPromotionService.java |
回归 | OntologyHarness | ooder-biz-form/.../chat/ontology/OntologyHarness.java |
表单转换 | FormConvertService / FormConvertCapability | ooder-biz-form/.../chat/form/convert|tool/ |
三路线编排 | DesignerFirst/DBFirst/ViewFirstOrchestrator | ooder-biz-form/.../chat/form/orchestrator/ |
模板导入 | YouCheng/DingTalkFormImportProvider | ooder-biz-form/.../chat/form/importing/ |
生成链 | FormEntityBundle / FormFieldProcessor / FormLayoutBuilder / ExportJavaCompiler / FormOntologyBridge / BusinessNaming | ooder-biz-form/.../chat/gen/form/ |
主数据弹选 | MasterDataRegistry / AbstractMasterDataPopService / PopService 家族 | ooder-biz-form/.../chat/masterdata/ |
流程定义 | ProcessDefinitionLoader / Validator / LegacyProcessDefinitionAdapter | ooder-biz-form/.../chat/process/definition/ |
知识回流 | FormKnowledgeProvider | ooder-biz-form/.../chat/form/knowledge/ |
SSE 契约 | SseEventPushService(human_confirm 统一出口 L776) | ooder-pro/.../chat/engine/ |
B 层样例 | LeaveForm | workflow/ooder-domain-workflow/.../domain/form/LeaveForm.java |
LLM 补偿子流程 | llm-fallback-subflow | data/skillflow-vfs/process-def/llm-fallback-subflow/definition.json |
B. 数据文件
文件 | 角色 | 分档 |
|---|---|---|
data/finance-dictionary/dictionary.json | base 字典(唯一真源,人工可审计) | S |
data/finance-dictionary/overlays/promotions.json | 飞轮晋升层(自动写、可回滚) | B→S 候选 |
data/ontology/feedback/YYYYMM.jsonl | 月度反馈流水 | B |
关联打分表 / RAG 索引(FormKnowledgeProvider 侧) | A 级文档抽取与多维关联 | A |
语义增强语料库 | P 级公共/行业语料(清洗后) | P |
C. 技术规格补充
C-1 A 级多维关联分值运算
score(field, docTerm) =
    w1 · sim(field.semantic, docTerm.semantic)      // 语义相似度(向量余弦)
  + w2 · hit(field.label,   docTerm.label)          // 字段标签命中率
  + w3 · overlap(field.scene, docTerm.scene)        // 场景重合度
  + w4 · auth(docTerm.source)                       // 来源权威度(产品规格 > 手册 > 流程描述)
  + w5 · fresh(docTerm.updatedAt)                   // 时效衰减因子

决策规则:score ≥ θ_high → 进入 suggest 首位候选;
         θ_low ≤ score < θ_high → 进入候选列表(human_confirm 展示);
         score < θ_low → 丢弃,仅留痕。建议初始 w = (0.35, 0.20, 0.20, 0.15, 0.10)。
C-2 P 级语义环境增强管线
公共/行业语料 → 清洗(去重 / 去噪 / 术语抽取 / 约束抽取)
            → 适用范围标注(domain, region, version)
            → 语义索引入库
            → 运行期按 (domain, region) 过滤后注入提示词上下文
约束:P 级内容只允许出现在「生成式输出」的上下文里,
     禁止进入确定性规则通道(typeRules 等),防止外部口径覆盖内部真源。
C-3 L3 双通道分流规格
请求 → L2 统一接口编排:
  ├─ S 级规则命中 → JVE(小模型组合,本地预判,目标 P95 < 50ms)→ 确定性回答
  ├─ S 级未命中 / 语义型问题 → 高精度向量库检索(A/P 级语料)
  │     ├─ 检索置信 ≥ θ  → BGM3 生成式回答(RAG 注入)
  │     └─ 检索置信 < θ  → LLM 补偿 → 沉淀 → 反哺
  └─ 全部失败 → human_confirm(SSE 契约统一出口)
C-4 SSE 契约要点
human_confirm 事件唯一出口:SseEventPushService(ooder-pro)L776 统一键名;
所有 Agent 不得自行拼装 confirm 键——保证前端一次适配、全 Agent 通用。
— END —
Sources · 本报告依据的仓库内证据
- OntologyIndex.java — 六维规则加载与双索引构建ooder-biz-form/src/main/java/net/ooder/studio/chat/ontology/OntologyIndex.java
- OntologyController.java — /api/ontology 全部 12 个端点ooder-biz-form/src/main/java/net/ooder/studio/chat/ontology/OntologyController.java
- OntologyFeedbackService.java — 反馈模型与月度 jsonl 写入ooder-biz-form/src/main/java/net/ooder/studio/chat/ontology/OntologyFeedbackService.java
- OntologyPromotionService.java — corrected 晋升门禁与 overlays 写入ooder-biz-form/src/main/java/net/ooder/studio/chat/ontology/OntologyPromotionService.java
- llm-fallback-subflow/definition.json — LLM 补偿子流程与飞轮持久化节点data/skillflow-vfs/process-def/llm-fallback-subflow/definition.json
- SseEventPushService.java — human_confirm 统一出口(L776)ooder-pro/src/main/java/net/ooder/studio/chat/engine/SseEventPushService.java
- LeaveForm.java — B 层表单元数据样例(枚举 key:label、子表、附件)workflow/ooder-domain-workflow/src/main/java/net/ooder/workflow/domain/form/LeaveForm.java
- nlp-intent-dispatch-loop SKILL.md — 补偿生成 → 知识库 → RAG 加速闭环.trae/skills/nlp-intent-dispatch-loop/SKILL.md
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号