AI 数字员工不是聊天机器人:中间差的是编排、工具调用和幂等
原创
AI 数字员工不是聊天机器人:中间差的是编排、工具调用和幂等
原创
苏州海睿数科运营部
发布于 2026-11-09 12:49:45
发布于 2026-11-09 12:49:45
最近常被问:"AI 数字员工到底靠不靠谱?"
这个问题不好答,因为它把两件完全不同的事混在了一起。技术上,"聊天机器人"和"能上岗的数字员工"差的不是模型大小,而是四层工程能力:触发方式、有状态编排、工具调用与副作用控制、审计与回滚。
判断靠不靠谱,别看 demo,看这四层有没有做。
一、触发方式:被动应答 vs 主动上岗
聊天机器人是无状态请求-响应:你问,它答,不问就没有。
数字员工必须能被事件驱动:
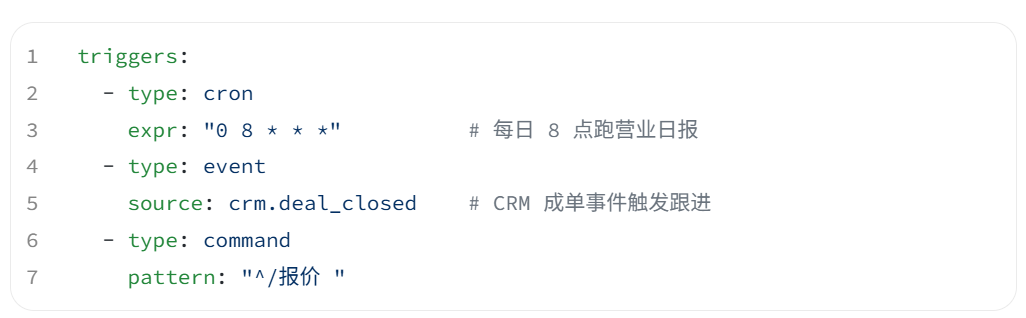
差别在工程上很具体:请求-响应只需要一个 HTTP handler;事件驱动需要任务队列、去重、失败重投、可见性超时。少了这些,一次漏触发就是业务事故。
二、编排:单轮生成 vs 有状态状态机
真实业务从来不是一问一答。"拉取本月成交→核对合同→生成对账单→推送财务"是四步,中间任何一步失败都要能续跑,而不是从头再来。
做法是把流程显式建模成状态机,每一步落盘:
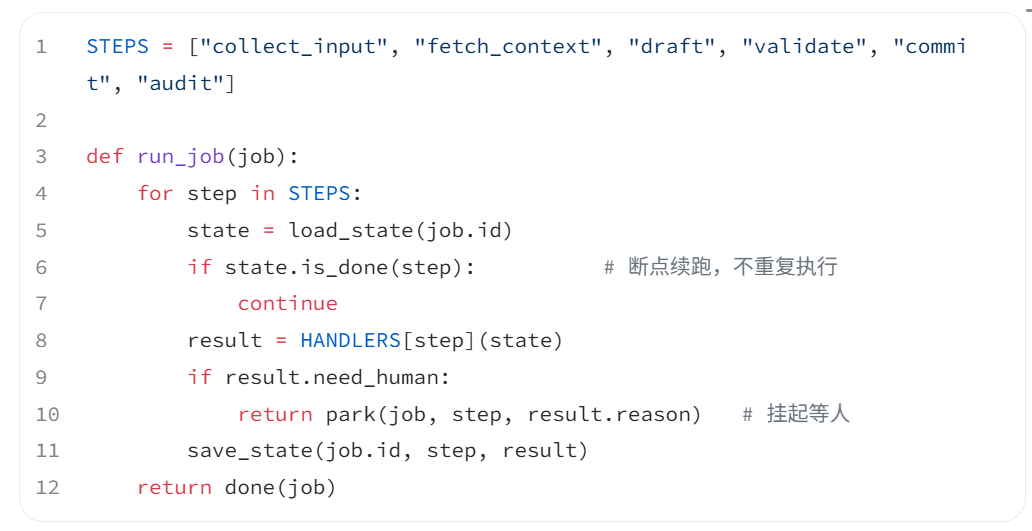
- 幂等前置:is_done 判断必须在执行前,而不是执行后;
- 可挂起:需要人工确认的步骤要能停下来等人,而不是硬着头皮往下走;
- 可续跑:进程崩了,从最后一个已完成步骤恢复。
用一段超长 Prompt 让它"自己想清楚六步",本质上是把状态放在模型上下文里——上下文一截断,流程就断。
三、工具调用:只读问答 vs 有副作用的写操作
这是聊天机器人和数字员工最实质的差别:前者只读,后者会改数据。
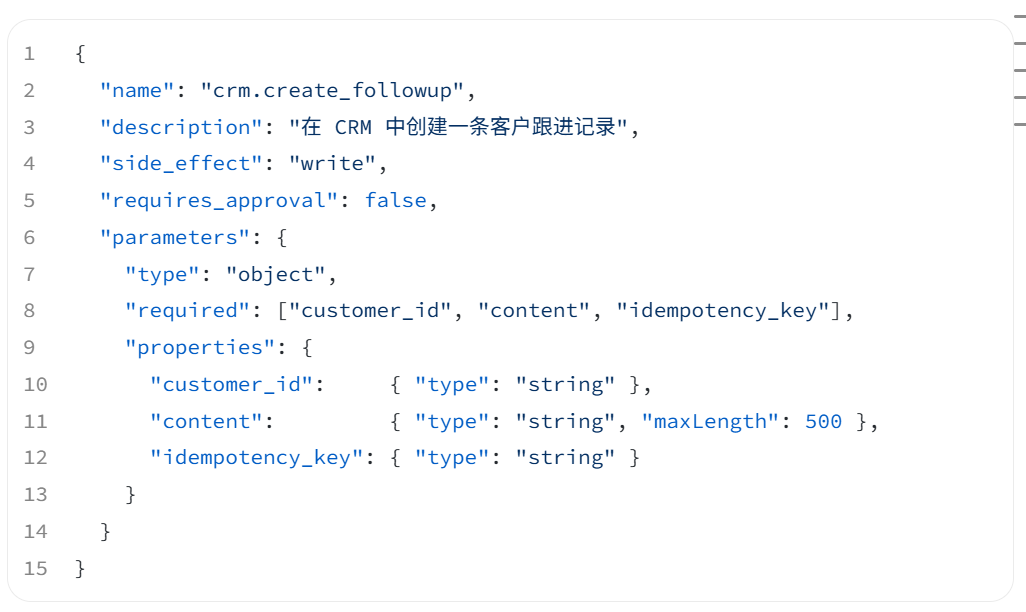
改数据就必须有工具契约,而不是让模型自由拼 SQL:
ide_effect 和 requires_approval 这两个字段是必须的:前者让运行时知道哪些操作要进事务,后者决定哪些操作必须人工确认。 四、副作用控制:幂等键是数字员工的生命线 Agent 最常见的生产事故不是"答错",是重复写入——网络超时重试一次,客户收到两张工单、两条跟进、两笔退款。 标准解法是幂等键,且必须在写之前判重:
 容易踩的坑:
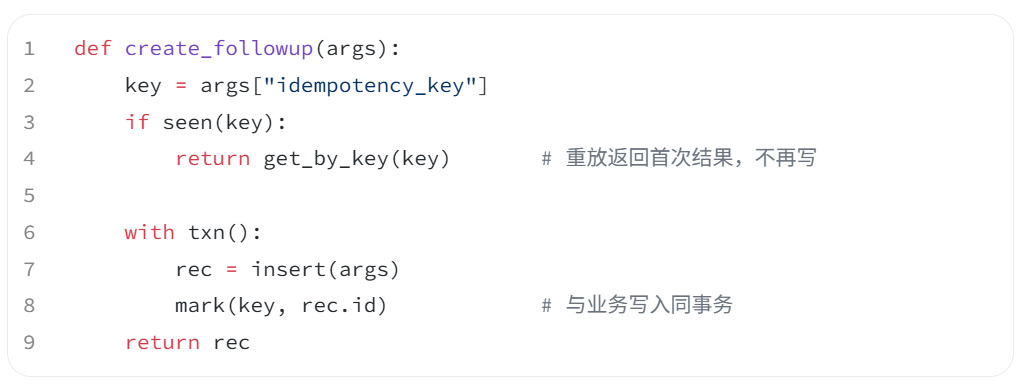
- 幂等键由调用方(编排层)生成并随任务持久化,不能让模型每次现编——模型每次编出来的都不一样;
- mark 必须和业务写入在同一个事务里,否则中间崩溃依然会重复。
五、审计与回滚:没有日志的 Agent 不能上线
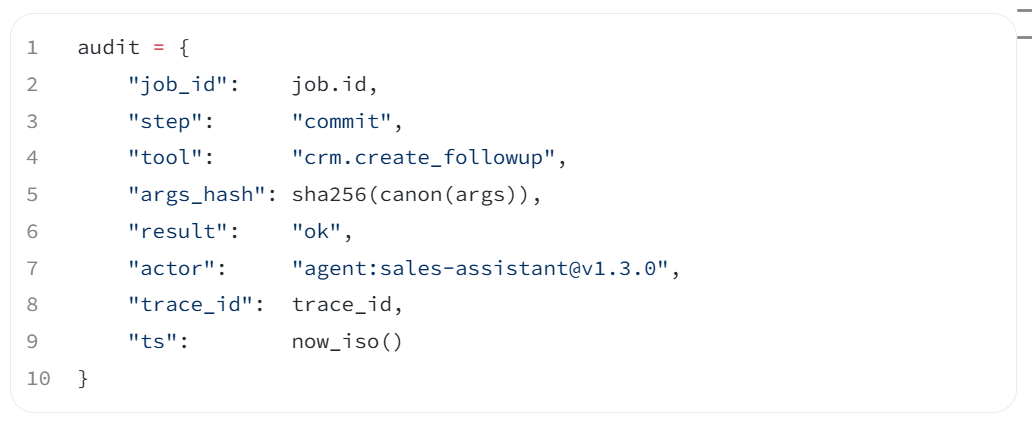
数字员工动了业务数据,就必须能回答三个问题:谁改的、改了什么、能不能撤回。
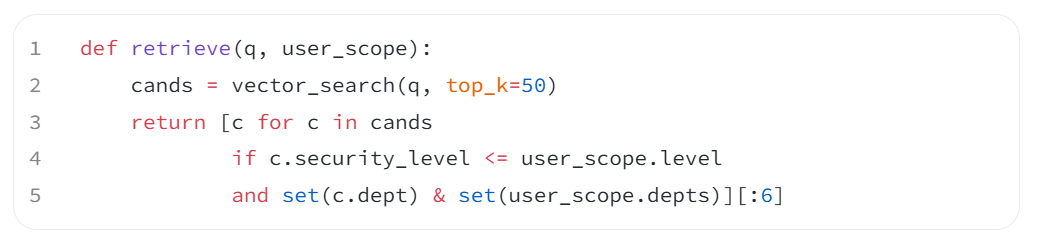
actor 里带版本号——出问题时你要能定位到"是哪个版本的 Agent 干的"。这个字段缺失,事故复盘基本做不了。 六、知识层与权限:一条容易被忽略的约束 数字员工要"懂本单位规定",就需要挂知识库;但知识库必须带权限,且权限要在检索前生效,而不是在 Prompt 里写一句"不要回答机密内容"。 工程上的做法是给每个知识块打 scope 与 security_level,检索时先过滤再匹配:
 示词做权限隔离,等于没做。 七、"自建还是买":技术上看是四个变量 很多人把它当成成本问题,其实四个技术变量更关键:
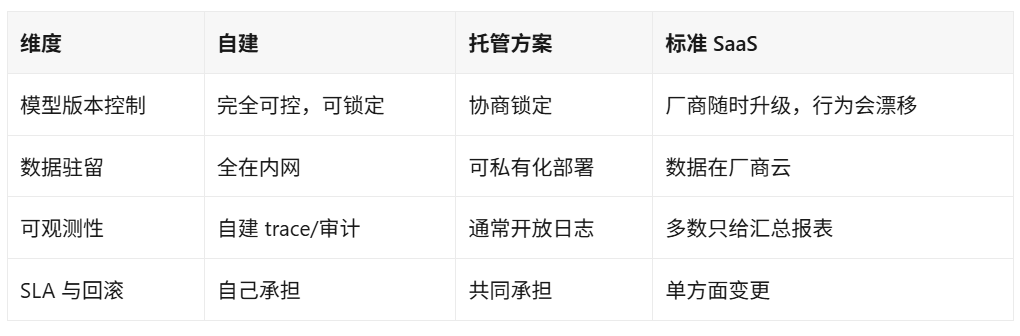
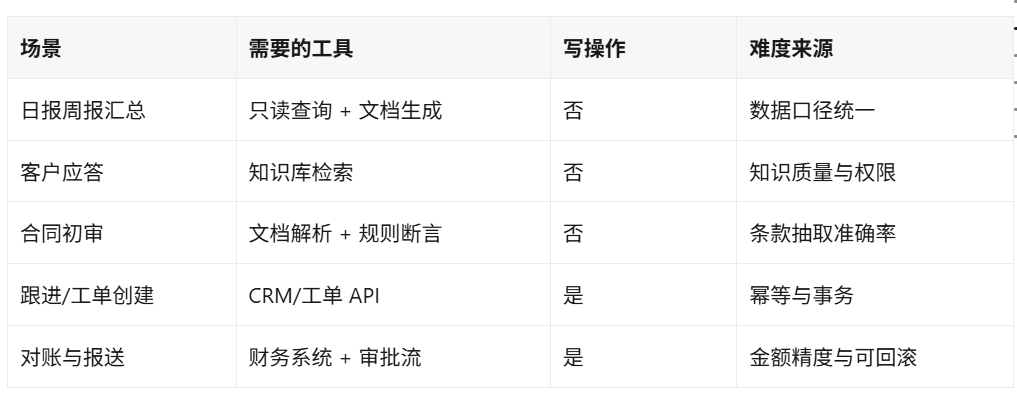
 为漂移"值得单独说:厂商升级模型后,同一个 Prompt 的输出风格、格式遵循度都可能变化。如果你的流程依赖结构化输出,就必须有 schema 校验兜底,否则一次静默升级就能让下游全挂。 八、能力矩阵:不同场景要接的系统不一样 落地难度不取决于行业名字,而取决于要接几个系统、有没有写操作:
 场景拼的是知识质量,写场景拼的是工程严谨度。 前者可以快速验证,后者必须先补幂等和审计再上线。 九、验收四指标 不要用"感觉挺智能"验收,用可统计的四个数:
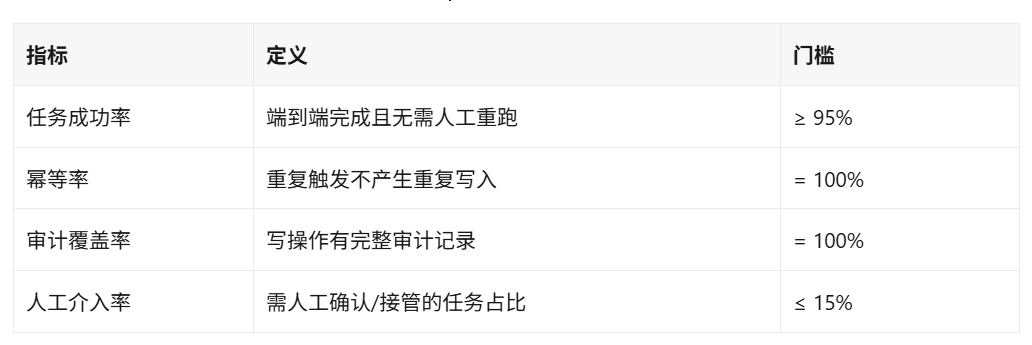
 项必须是 100%:审计缺一条,就等于没有审计。 结语 判断一个"数字员工"靠不靠谱,其实有个很简单的技术检查:问它有没有幂等键、有没有审计日志、失败能不能续跑和回滚。 这三样有,它才是个能上岗的系统;没有,它就是个包装得比较像员工的聊天窗口。 你们在做 Agent 落地时,是先补幂等和审计,还是先调 Prompt?欢迎在评论区聊聊踩过的坑。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号