P-Tuning解析:大模型参数高效微调,冻结主模型,仅微调少量提示参数落地行业大模型27.1
原创
P-Tuning解析:大模型参数高效微调,冻结主模型,仅微调少量提示参数落地行业大模型27.1
原创
未闻花名
发布于 2026-11-08 18:53:05
发布于 2026-11-08 18:53:05
一、前言
记得我刚接触大模型微调时,一开始就被全参数微调劝退了。我们拿到一个几十亿、上百亿参数的基座大模型,如果想让它学会我们自己的业务任务,比如抽取合同信息、做领域问答、分类产品工单,第一想法就是把整个模型全部拉过来重新训练一遍。但现实问题非常扎心,大模型全量微调,需要多张高端显卡,训练一次的算力成本动辄几万甚至十几万,普通开发者、中小企业根本承担不起。
而且全参数微调还有额外隐患,训练过程很容易发生灾难性遗忘,模型在学习新任务的同时,把基座模型原本学到的通用知识丢掉;同时每新增一个业务任务,就要保存一整套完整的模型权重,多个任务会占用海量存储。于是摸索新的路径,探索有没有办法,不动大模型主体权重,只训练一小部分参数,就能让大模型学会新任务,后来发现P-Tuning,就是为了解决这个痛点诞生的参数高效微调方案。
基本我们都听过Prompt提示词工程,手写文字提示,引导大模型输出指定结果。但手写提示词有明显上限:人的语言表达有限,很难找到最优提示;不同模型对文字提示敏感度不一样,提示词稍微改动,效果就剧烈波动。P-Tuning跳出了纯文本提示的思路,提出提示不一定必须是人写的文字,可以是模型内部可学习的连续向量。我们不去修改大模型主干,只优化这一小批连续提示向量,就能完成下游任务适配。
二、大模型微调基础认知
1. 传统微调的困境
大语言模型本质是一个预训练完成的巨大神经网络,预训练阶段,模型在海量通用文本上学习语言规律、常识、逻辑。预训练结束后,模型的权重已经固化了大量通用知识。
全参数微调过程:
- 拿到基座模型,加载全部权重;
- 用下游任务数据集做反向传播;
- 更新模型全部参数。
如果算力足够、数据质量高,全量微调通常能拿到任务上的最优效果。但短板同样突出:
- 算力开销巨大:模型参数量越大,显存需求越高。以7B模型举例,全参数微调需要占用数十GB显存;百亿级模型,单机单卡基本无法完成训练,必须多卡分布式训练,硬件门槛极高,个人开发者和小型团队很难落地。
- 灾难性遗忘风险:更新全部权重时,会修改预训练学到的基础知识。当新任务数据量比较少时,模型很容易“学歪”,丢失原本的通用能力,泛化能力受损。
- 存储成本高:每训练一个任务,就要保存一份完整模型权重。如果有10个业务场景,就要存10套完整大模型,存储压力成倍上涨,部署非常麻烦。
另一种方式提示词工程,不改动模型任何权重;直接在输入文本前拼接人工写好的提示,比如“你是合同抽取专家,请提取合同金额、签订日期”;零成本、上手简单,但缺点明显:
- 提示词依赖人工经验,需要反复试错调优;
- 模型对提示措辞极其敏感,一个词语改动,输出结果就不稳定;
- 复杂任务、领域专有任务,很难靠一段文字提示达到理想效果;
- 大模型理解离散文本token,最优提示不一定是人类能写出来的自然语言。
正是全量微调成本高、手写提示不稳定,于是演化出了折中方案:冻结基座大模型权重,只训练少量额外参数,实现高效适配。这一类技术统称为PEFT,全称Parameter-Efficient Fine-Tuning,即参数高效微调,P-Tuning就是PEFT大家族里非常经典的成员。
2. PEFT技术整体概览
PEFT的核心思想统一:基座模型权重冻结;训练时只更新少量新增参数;训练完成后,只保存这一小部分参数;推理时把新增参数并入基座模型一起使用。
不同PEFT方案,新增参数的位置、形式各不相同,主流方案分为几类:
方案 | 参数插入位置 | 特点 |
|---|---|---|
Prefix Tuning | Transformer每一层的注意力模块,追加前缀向量 | 生成任务表现不错,但训练不稳定 |
P-Tuning | 输入层增加可学习连续伪提示向量,只作用在输入嵌入阶段 | 参数量最小,深层模型效果易衰减 |
P-Tuning v2 | P-Tuning升级版,每一层都加入可学习提示 | NLU任务效果好,工程最常用 |
LoRA | Attention权重旁增加低秩矩阵,只训练低秩矩阵 | 生成任务优秀,推理无额外开销 |
Adapter Tuning | Transformer层之间插入小型Adapter子网络 | 参数量可控,结构侵入性强 |
通常最容易混淆P-Tuning、Prefix Tuning、P-Tuning v2,先简单划清边界:最早P-Tuning只在输入嵌入层增加提示,属于浅层提示;Prefix Tuning每一层都添加前缀;P-Tuning v2吸收Prefix Tuning思想,把可学习提示放到Transformer全部层,性能大幅提升。现在工程里说P-Tuning,很多时候实际指P-Tuning v2,后面章节会详细对比。
PEFT方案共同优势:训练显存低、训练速度更快;不改动基座权重,遗忘风险低;任务切换只需要加载不同小参数文件,存储开销极小。但不同方案适用场景不一样,P-Tuning系列在NLU自然语言理解任务(文本分类、实体抽取)表现亮眼;LoRA在生成类任务,对话、续写、摘要更常用。
三、P-Tuning核心原理拆解
1. 从离散提示到连续提示
普通Prompt,输入全部是离散的文本Token。比如我们输入:
【请做情感分类】这句话:今天天气很差,我非常难过。输出标签:
这段文字会经过Embedding层,映射成一组固定的向量;这些向量由模型词表决定,不可训练;提示词是人写的自然语言,向量固定,训练过程不会变化。
P-Tuning做出了一个关键创新:引入可学习的连续伪提示(Continuous Prompt)。它不再完全依靠人类写的文字Token;在原始输入的前面,插入一段特殊的、不属于真实词表的虚拟token,一般叫伪提示token(pseudo prompt token);这些伪token同样经过Embedding,生成对应向量,这些向量是模型可以训练、可以优化的参数;原始基座大模型所有Transformer权重全部冻结,训练过程只更新这一小批伪提示向量。
用一个通俗的比喻帮助理解:
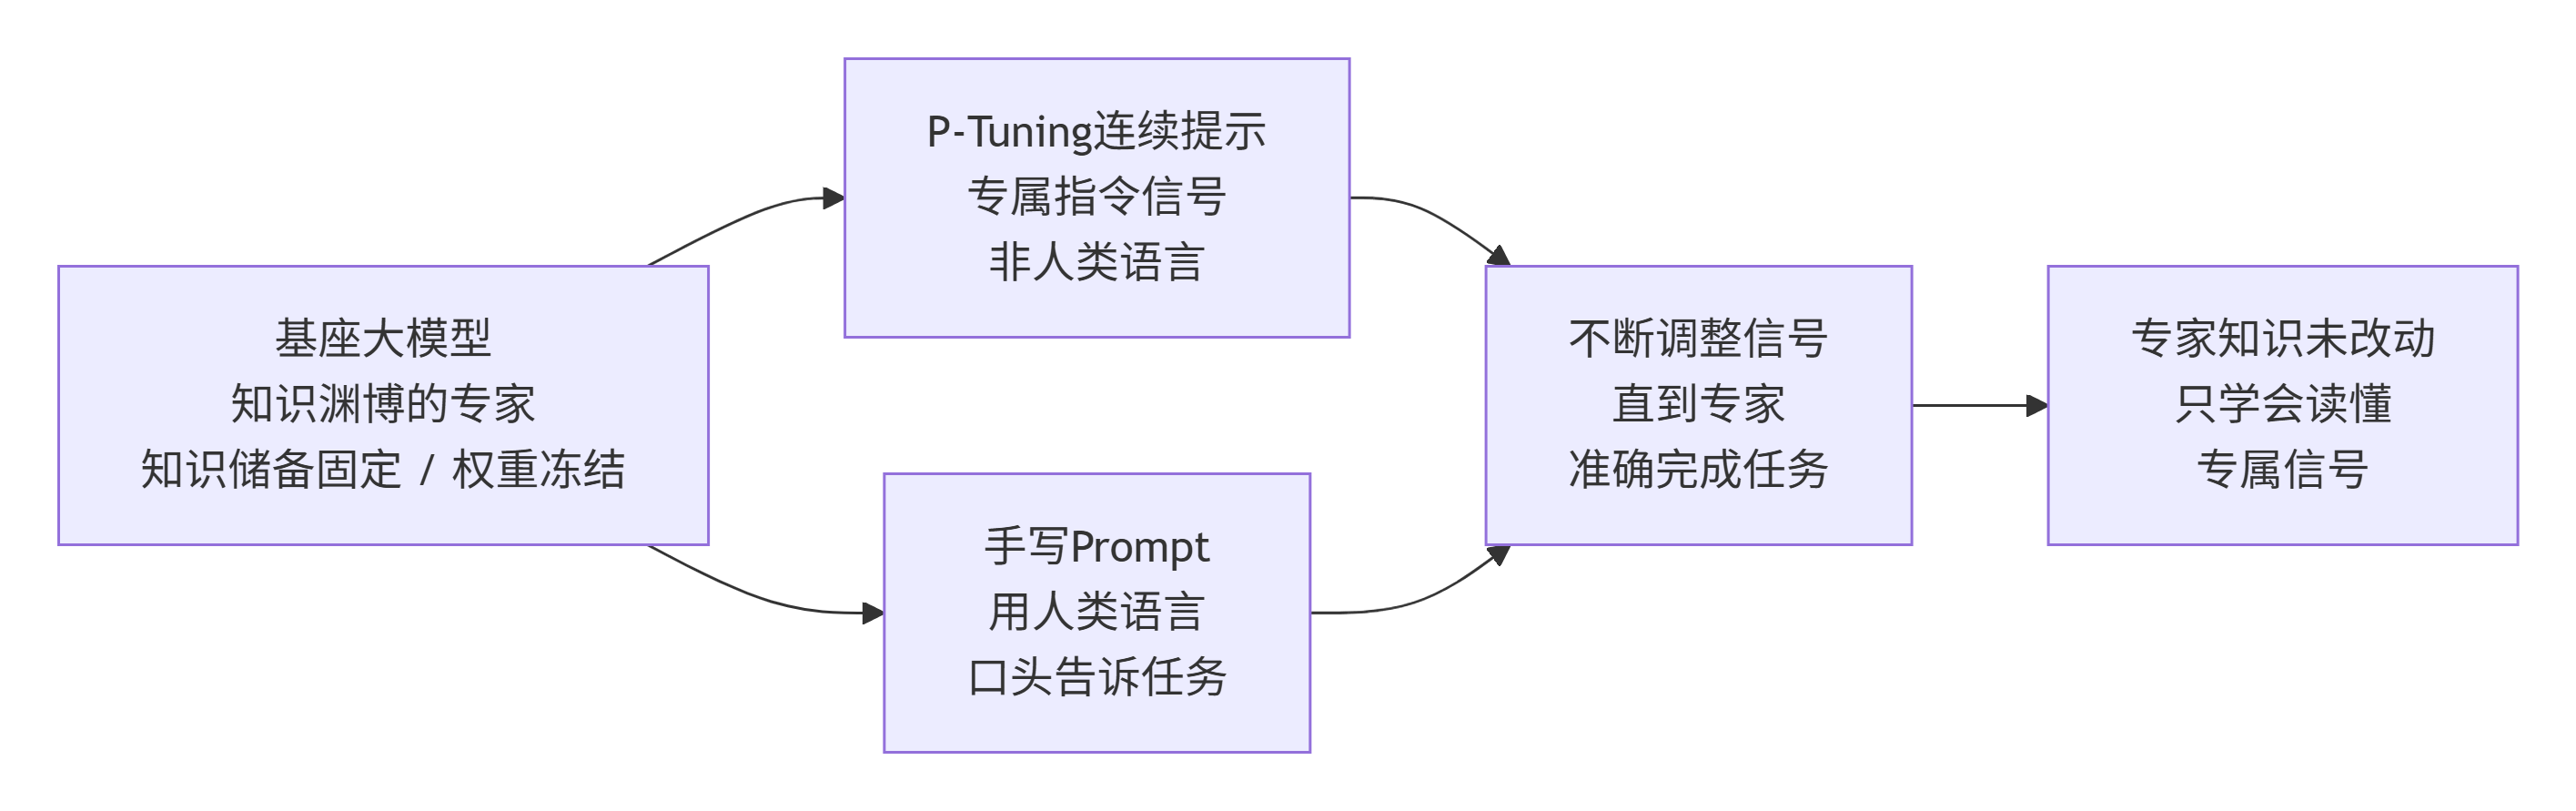
- 基座大模型就像一个知识渊博的专家,本身的知识储备固定不变,即权重冻结。
- 手写Prompt相当于我们用一段话口头告诉他任务;
- P-Tuning的连续提示,相当于给专家一套专门适配他思维模式的“指令信号”。
- 这套信号不是人类语言,我们不断调整它,直到专家接收到信号后能准确完成我们的任务。
- 整个过程,专家本身的知识没有改动,只需要学会读懂这套专属信号。
训练流程简化描述:

- 1. 加载预训练基座大模型,冻结全部模型权重,不参与梯度更新;
- 2. 初始化一组固定长度的可学习伪提示向量;
- 3. 把【伪提示向量】+【真实输入文本的embedding】拼接在一起,作为Transformer的输入;
- 4. 前向传播,计算任务损失;
- 5. 反向传播,只更新伪提示向量,大模型参数保持不变;
- 6. 迭代收敛后,保存训练好的提示向量。推理阶段,每次输入样本,拼接这组提示向量送入模型。
重点区分:伪提示向量不是人类可读文字。训练完成之后,我们无法把这组向量还原成一段中文句子。它是模型空间内的连续向量,只对这个基座模型有效,换一个模型,这组提示向量就失效。
示例:伪提示向量微调
示例实现了大模型的参数高效微调(PEFT)方案,属于Prompt Tuning类方法。核心思路是冻结基座大模型的全部参数,仅定义一个可学习的连续伪提示向量(20×768),在前向传播时将其拼接到真实输入embedding之前,再送入冻结的Transformer主干进行推理。相比全量微调,该方法可训练参数量极低(仅约 0.01%),大幅降低训练显存与存储开销,同时避免灾难性遗忘,适配多任务快速切换部署。
核心设计:
- 参数冻结:遍历backbone所有参数并设置requires_grad=False,确保基座权重不被更新。
- 伪提示向量:定义20个768维的可学习连续向量,替代人工设计的离散提示词。
- 输入拼接:将伪提示向量按 batch 维度扩展后,拼接在真实输入embedding前端。
- 前向推理:拼接后的embedding序列送入冻结的Transformer主干完成正常前向计算。
import torch
import torch.nn as nn

# 假设隐藏层维度为768,伪提示长度为20
HIDDEN_SIZE = 768
PSEUDO_LEN = 20

class PseudoPromptModel(nn.Module):
    def __init__(self, backbone):
        super().__init__()
        self.backbone = backbone
        # 1. 冻结基座大模型全部参数
        for p in self.backbone.parameters():
            p.requires_grad = False

        # 2. 唯一可学习的连续伪提示向量
        self.pseudo_prompt = nn.Parameter(
            torch.randn(PSEUDO_LEN, HIDDEN_SIZE)
        )

    def forward(self, input_embeds, attention_mask):
        # 3. 伪提示向量拼接在真实输入embedding之前
        batch_size = input_embeds.size(0)
        prompt = self.pseudo_prompt.unsqueeze(0).expand(batch_size, -1, -1)
        concat_embeds = torch.cat([prompt, input_embeds], dim=1)

        # 4. 送入冻结的Transformer主干前向计算
        return self.backbone(inputs_embeds=concat_embeds)
2. P-Tuning原版本的结构细节
原版P-Tuning论文提出的架构,核心特点:可学习提示只加在输入Embedding层,Transformer中间层不增加参数。输入的完整embedding序列由三部分拼接而成:
[可学习伪提示] + [原始输入文本Embedding] + [可选的人工提示Token Embedding]
这里有几点设计细节:
- 保留手写提示:原版P-Tuning允许保留少量手写文本提示,和可学习伪提示混合使用。一部分提示是可优化连续向量,一部分是固定离散文本token,二者拼接送入模型。
- 伪提示长度是超参数:需要开发者设定,比如10、20、50个伪token。伪token数量越多,可学习参数越多,任务表达能力越强,但训练开销随之上升,也更容易过拟合;伪token太少,表达不足,任务效果上不去。
- 梯度流向:训练时损失梯度只能传到伪提示向量,不会流入后面Transformer主干网络,主干网络全程冻结,不会被更新。
原版P-Tuning有一个短板:
- 只在输入层增加提示;
- 当模型层数很深,仅输入层的提示信号,经过多层Transformer计算后,信息会逐步衰减;
- 在很多复杂长文本任务上,效果不如Prefix Tuning。
所以后续推出P-Tuning v2,专门解决这个短板。
3. P-Tuning v2主流版本
P-Tuning v2是P-Tuning的升级版,也是应用落地最常用的版本,核心改动包括不再只在输入Embedding增加提示,在Transformer每一层的Attention模块,都增加独立的可学习前缀向量。
工作原理:
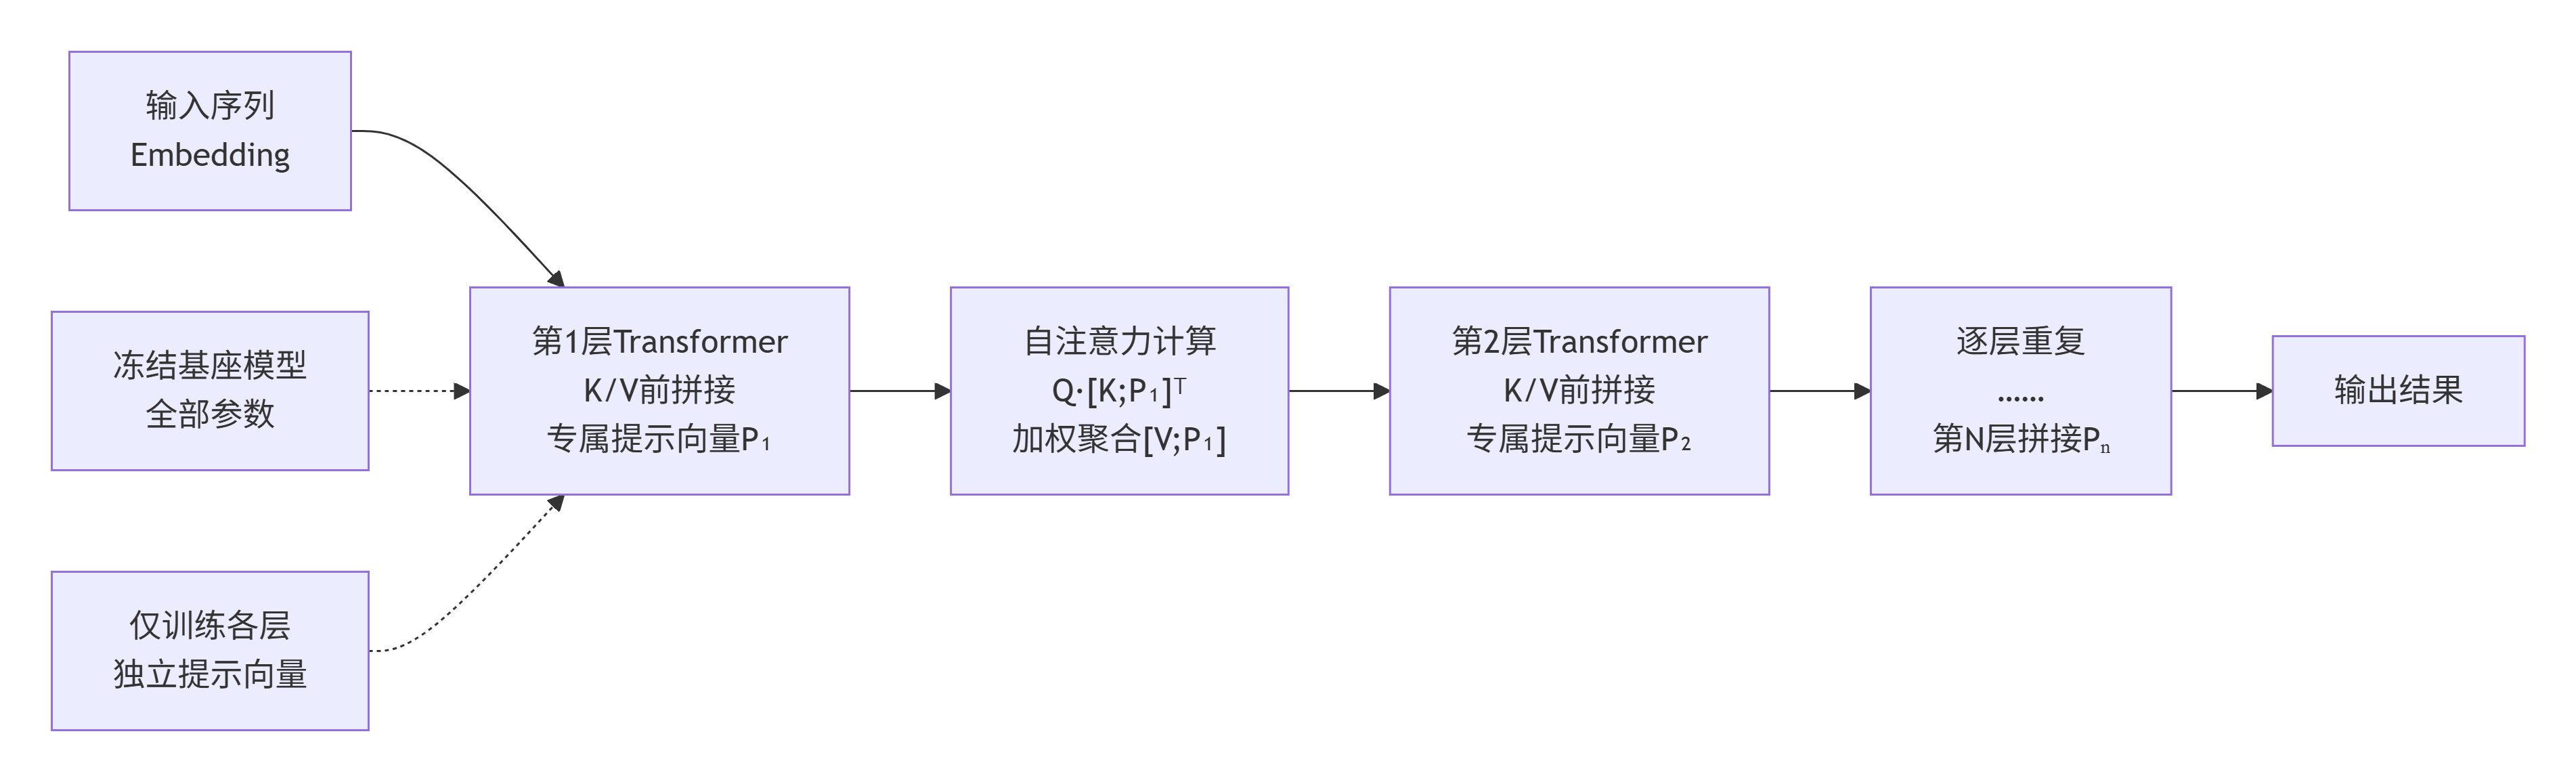
- 每一层Transformer,在计算自注意力时,Key、Value序列前面拼接上这一层专属的可学习提示向量;
- 每一层都有独立可训练参数;
- 提示信号贯穿模型所有层,不会随着深度增加快速衰减;
- 这个思路借鉴Prefix Tuning,同时简化优化,降低训练难度。
用代码直观理解“每层KV前缀”的形态:
import torch
import torch.nn as nn

class PTuningV2LayerPrefix(nn.Module):
    """P-Tuning v2:给每一层自注意力追加KV前缀"""
    def __init__(self, hidden_size, prefix_len, num_layers):
        super().__init__()
        self.prefix_len = prefix_len
        # 每一层都有一组独立的可学习前缀向量
        # 结构: [层数, 前缀长度, 2(K和V), 隐藏维度]
        self.prefix = nn.Parameter(
            torch.randn(num_layers, prefix_len, 2, hidden_size)
        )

    def forward(self, layer_idx, key, value):
        # 取第 layer_idx 层对应的前缀
        kv = self.prefix[layer_idx]          # [prefix_len, 2, hidden]
        k_prefix = kv[:, 0, :].unsqueeze(0)  # 前缀Key
        v_prefix = kv[:, 1, :].unsqueeze(0)  # 前缀Value
        # 拼接到当前层的Key/Value前面,参与注意力计算
        key = torch.cat([k_prefix, key], dim=1)
        value = torch.cat([v_prefix, value], dim=1)
        return key, value
P-Tuning v2的优势:
- 信号在每一层都生效,深层模型也能稳定传递任务指令;在文本分类、命名实体识别、关系抽取这类NLU任务,效果可以逼近全参数微调;
- 优化更稳定,相比Prefix Tuning,调参门槛更低;
- 保持PEFT核心特性:基座模型冻结,训练参数量极少,显存占用低。
但代价是,相比原版P-Tuning,可训练参数量有所上升:
- 原版P-Tuning只在输入层,参数量 = 伪token数量 × 隐藏层维度;
- P-Tuning v2每一层都有前缀,参数量和Transformer层数成正比。
即便如此,可训练参数依然只占模型总参数0.1%~1%,对比全参数微调,算力消耗依然有数量级下降。
4. 直观对比:P-Tuning、Prefix Tuning、LoRA
在选型时容易混淆这几个PEFT方法,这里做清晰对比:
P-Tuning(原版)
- 参数位置:仅输入embedding层
- 训练参数:少
- 优点:参数量最小,显存开销最低
- 缺点:深层模型效果衰减,复杂任务上限有限
- 适合:简单短文本分类任务
P-Tuning v2
- 参数位置:Transformer每一层Attention,添加KV前缀
- 训练参数:中等
- 优点:NLU任务效果优秀,接近全微调,稳定性好
- 缺点:生成类任务表现一般,每一层都需要拼接前缀,推理会增加少量计算开销
- 适合:实体抽取、文本分类、关系抽取、事件抽取等理解类任务
Prefix Tuning
- 参数位置:每一层Attention KV前缀
- 训练参数:中等
- 优点:生成任务表现不错
- 缺点:训练不稳定,调参难度高,容易出现训练震荡
LoRA
- 参数位置:Attention Query、Value旁新增低秩矩阵
- 训练参数:少
- 优点:推理阶段无额外计算开销,推理速度和原始模型完全一致;生成任务表现优秀
- 缺点:部分NLU任务,效果略弱于P-Tuning v2
总的来说,做文本理解、信息抽取优先P-Tuning v2;对话、文本生成优先LoRA。
四、P-Tuning训练、推理流程
1. 训练阶段完整步骤

第一步:环境与基座准备
- 选择基座大模型,比如BERT、GPT、Llama等;
- 注意:P-Tuning v2在编码器模型(BERT类NLU模型)表现效果最好,解码器生成模型也可以使用,但工程上生成场景更多选用LoRA;
- 加载模型,设置requires_grad=False,冻结模型全部主干参数,保证反向传播时主干权重不会更新。
第二步:初始化可学习提示参数
- 设定伪token长度;
- 初始化提示向量矩阵,这是唯一参与训练的参数;
- 可以随机初始化,也可以用真实文本embedding做初始化,后者收敛速度更快。
第三步:数据集预处理
- 和普通微调数据集格式一致,输入文本+标签;
- 例如实体抽取:输入一段合同文本,标签为实体名称和位置;
- 将文本转成token序列,保留标签用于计算损失。
第四步:前向传播
- 将伪提示向量和输入embedding拼接;
- 送入Transformer网络;
- 模型输出预测结果,计算预测结果和真实标签之间的损失(交叉熵等)。
第五步:反向传播与参数更新
- 开启梯度计算,但只有提示向量会计算梯度;
- 优化器(AdamW)只更新提示参数,大模型主干权重不更新;
- 重复多轮epoch直到损失收敛。
第六步:保存产物
- 训练结束,不需要保存完整大模型;
- 只保存训练完成的提示向量参数文件,文件体积很小,几十MB级别;
- 基座模型仍然使用原始预训练权重。
下面是一段简化训练循环示例代码:
import torch.optim as optim
from transformers import AutoTokenizer, AutoModel

# 加载基座模型并冻结主干
backbone = AutoModel.from_pretrained("bert-base-chinese")
for p in backbone.parameters():
    p.requires_grad = False

model = PseudoPromptModel(backbone)  # 复用2.1节的封装
optimizer = optim.AdamW(model.parameters(), lr=1e-3)  # 只含伪提示参数

for epoch in range(5):
    for batch in train_dataloader:
        input_ids, labels = batch
        input_embeds = backbone.embeddings(input_ids)  # 真实文本embedding
        logits = model(input_embeds, attention_mask=None)

        loss = criterion(logits, labels)
        optimizer.zero_grad()
        loss.backward()   # 梯度只流向伪提示参数
        optimizer.step()

# 只保存可学习提示向量,不保存大模型
torch.save(model.pseudo_prompt, "tuned_prompt.pt")
2. 推理阶段流程
推理阶段不需要重新训练,完整流程说明:
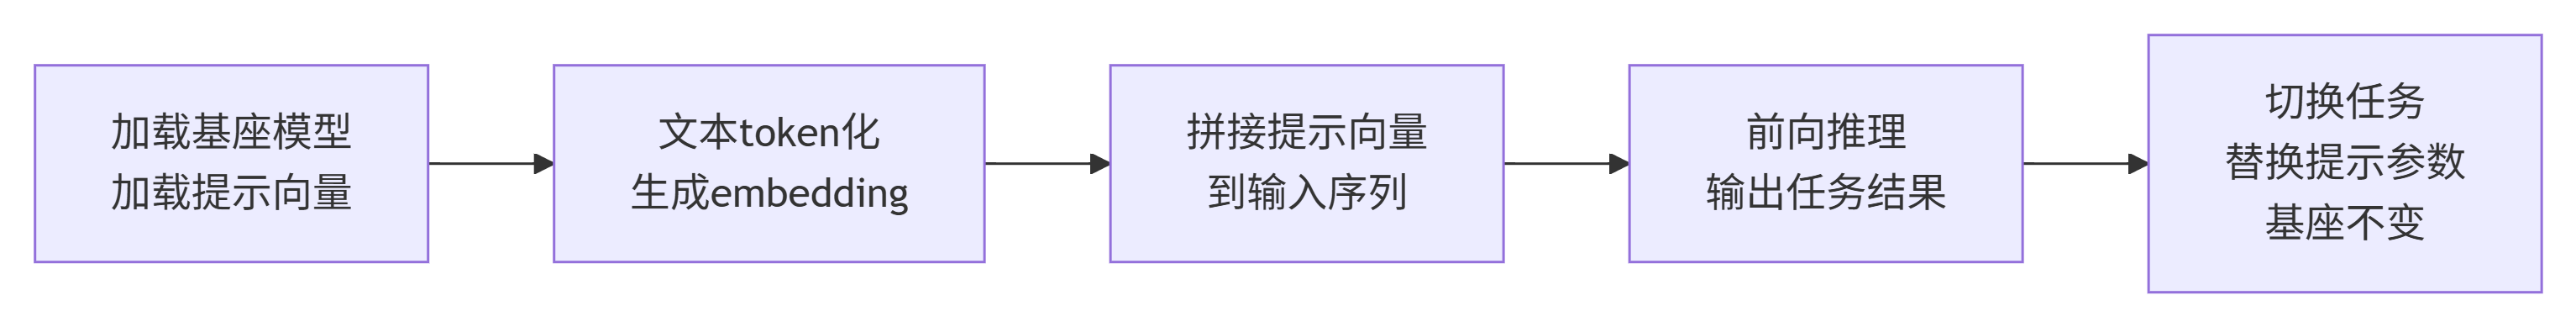
- 1. 加载原始冻结基座大模型,加载训练好的提示向量参数;
- 2. 对待预测文本做token化,得到文本embedding;
- 3. 将保存的可学习提示向量拼接到输入序列;
- 4. 送入大模型前向推理,输出任务结果;
- 5. 任务切换时,只需要替换加载的提示参数文件,基座模型不变。
# 推理:加载基座 + 加载提示向量
backbone = AutoModel.from_pretrained("bert-base-chinese")
pseudo_prompt = torch.load("tuned_prompt.pt")

model = PseudoPromptModel(backbone)
model.pseudo_prompt.data = pseudo_prompt  # 替换为训练好的提示

# 对单个样本推理
input_embeds = backbone.embeddings(input_ids.unsqueeze(0))
logits = model(input_embeds, attention_mask=None)
pred = logits.argmax(dim=-1)
这里要注意一个工程细节:
- P-Tuning v2在推理时,每一层Attention都需要拼接KV前缀,相比原生模型会带来少量额外计算开销,推理速度会轻微下降。
- 而LoRA推理时,可以将低秩矩阵合并进原始权重,推理没有额外开销,这也是生成场景偏好LoRA的核心原因。
3. 超参数调优要点
P-Tuning训练有几个关键超参数,直接决定效果好坏:
- 伪提示Token长度:
- 伪token数量太短,指令表达不足,效果差;
- 太长会增加参数量,容易过拟合;
- NLU任务一般选择10~100之间;
- 任务越复杂、文本越长,需要更长提示;
- 需要做对比实验找到最优值。
- 学习率:
- P-Tuning只训练少量参数,学习率不能像全微调那么大;
- 一般设置1e-4 ~ 1e-2区间;
- 学习率过高容易震荡、过拟合;过低收敛极慢。
- 训练epoch
- 因为参数量小,模型拟合速度快;
- epoch不宜过多,一般3~10轮就收敛;
- 过多迭代极易过拟合,尤其是小数据集场景。
- 初始化策略:
- 随机初始化简单,但收敛慢;
- 使用真实文本embedding初始化提示向量,模型更容易找到优质提示,训练更稳定,是推荐方案。
4. 常见训练问题
- 过拟合
- 小数据集场景高频出现;
- 表现为训练集损失持续下降,验证集效果不提升甚至变差;
- 解决方案:减少伪token数量,降低epoch,增加dropout,加入早停策略。
- 训练震荡不收敛
- 大多是学习率设置过高,或者提示初始化不合理;
- 解决方案:降低学习率,改用文本embedding初始化。
- 效果远差预期
- 优先排查伪token长度是否不足;
- 其次确认数据集标注质量,PEFT对数据质量同样敏感,脏数据会严重拖累效果。
五、P-Tuning的应用场景
1. P-Tuning核心优势
- 极低算力成本:主干模型全程冻结,只优化少量提示参数,显存占用大幅下降;一张普通消费级显卡,就可以完成7B模型P-Tuning v2训练,不需要多卡集群;个人开发者、中小企业都可以尝试。
- 规避灾难性遗忘:全程不改动基座大模型权重,模型原始知识完整保留;新增任务训练,不会破坏基座模型原有能力;多个任务之间完全隔离,不同任务只需要保存独立提示参数。
- 存储轻量化,多任务部署友好:每个任务产出的提示参数文件体积很小;如果有几十个业务任务,只保留一份基座模型,搭配多套提示参数,按需加载;相比每个任务保存完整模型,存储成本降低几百倍,多任务服务部署非常方便。
- 小数据集适配能力强:在标注数据量有限的场景,P-Tuning v2的表现稳定;全参数微调在少量标注数据上极易过拟合;P-Tuning只优化少量参数,拟合能力可控,在领域小样本任务里性价比很高。
2. P-Tuning的局限性
- 任务偏向性明显:P-Tuning v2在NLU理解类任务很强;但在长文本生成、对话续写场景,效果通常不如LoRA;生成场景,业界更多选择LoRA。
- 推理存在少量额外开销:P-Tuning v2推理时,每一层Attention都要拼接KV前缀,增加计算量;当高并发线上服务,对延迟极其敏感时,这个开销需要评估。
- 提示向量模型绑定:训练得到的连续提示向量,只能用于当前这个基座模型;一旦基座模型版本更换,这套提示参数就失效,无法跨模型复用;不像手写自然语言提示,具备一定跨模型通用性。
- 超参数敏感:伪token长度、学习率、初始化策略都会显著影响最终效果;需要一定实验调参,不是拿到数据直接跑就能得到最优结果。
3. 应用场景适配
推荐使用P-Tuning v2场景:
- 领域文本分类:工单分类、新闻分类、产品评论情感分析;
- 信息抽取:命名实体识别、合同要素抽取、关系抽取、事件抽取;
- 小样本NLU任务,标注数据少,算力资源有限;
- 一套基座大模型,需要支持数十个独立理解类业务任务,希望轻量化保存任务参数。
不推荐优先选用场景:
- 长文本对话、故事生成、文案续写这类生成任务,优先LoRA;
- 极致低延迟、超高并发线上生成服务;
- 希望一套提示跨多个不同基座模型直接复用。
六、P-Tuning实践经验
相信大家和我一样,初次接触会产生一个疑问,我也是核实了一些细节,这里分享一些总结:既然P-Tuning只是优化提示向量,那它到底是属于提示工程还是属于微调呢?
本质上,P-Tuning属于参数高效微调,不是单纯的提示词工程:手写提示词完全没有参数更新;P-Tuning通过反向传播优化可学习向量,利用标注数据拟合任务分布,属于训练过程;但它又和全参数微调不同,不触碰基座主干。
在实际工程选型上,不存在绝对最好的PEFT方法,只有最匹配业务目标的方案:如果任务是合同抽取、医疗文本实体识别,标注样本几百到几千条,显卡资源有限,P-Tuning v2是首选,效果上限高,成本可控;如果做智能客服对话、小说生成、翻译这类生成任务,优先LoRA,推理无额外开销,生成质量更好。
同时也要客观看待PEFT的边界,P-Tuning不是魔法:它不能凭空创造信息,数据质量依旧是核心;如果标注数据混乱、标注错误多,哪怕使用P-Tuning v2,也无法得到好效果;PEFT解决的是训练成本问题,无法弥补脏数据带来的缺陷。
P-Tuning和提示词工程可以结合使用:先用手写提示词做零样本测试,确认任务可行;再用P-Tuning基于标注数据训练连续提示,进一步稳定效果,降低对人工提示的依赖;很多业务落地,会采用这套组合路线。还有一个容易踩坑的点:模型架构适配。原版P-Tuning最早基于BERT编码器模型开发;解码器架构的GPT类模型虽然支持P-Tuning v2,但效果和稳定性不如编码器;选型前要提前做小实验验证。
七、总结
全参数微调算力昂贵,手写离散提示词不稳定,这两个痛点催生了PEFT参数高效微调,P-Tuning就是其中代表方案。P-Tuning跳出了提示必须是人类文字的固有认知,提出可学习连续伪提示。原版P-Tuning仅在输入嵌入层增加可训练提示向量;升级后的P-Tuning v2在Transformer每一层增加KV前缀,解决深层信号衰减问题,在文本理解类任务上,效果可以逼近全参数微调。整个训练过程冻结基座大模型主干,只训练极少一部分提示参数,极大降低显存、算力、存储成本,适合小样本领域NLU任务。
P-Tuning最重要的思想启示:大模型的能力藏在模型的向量空间里,不一定非要修改模型主体权重,找到合适的指令信号,就可以调动基座模型已有的能力完成下游任务。这套思路也启发了后续大量提示学习、参数高效微调方向的研究。掌握P-Tuning原理,能更深理解大模型是如何接收指令、执行任务,在后续大模型项目选型、方案设计时,能做出更理性的判断。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号