成稿自动投递:把早报和周报一键推到 IM 与知识库
原创
成稿自动投递:把早报和周报一键推到 IM 与知识库
原创
华东子
发布于 2026-11-03 08:11:11
发布于 2026-11-03 08:11:11
写给已经把早报、周报都跑成自动流水线、却还得每天手动打开文件转到群里的你:#13 把早报产到
archive/、#15 把周报产到weekly/、#14让它们到点自动跑——但跑完的东西还躺在文件夹里。这篇把"交作业"这最后一步也自动化:一条脚本把两份成稿拼成一条摘要,多端推到企业微信群、邮件、知识库。企业微信这一段已实测跑通;邮件与知识库两端给的是接线骨架,填上你自己的凭据、自测通过再接,别一上来就三端全开。
一、问题场景:定时跑 ≠ 有人收
先把账算清。到上一篇为止,这条工作流长这样:
- #13 把科技早报产到
archive/科技早报-YYYY-MM-DD.md; - #15 把周报产到
weekly/周报-{repo}-{window}.md; - #14 让上面两步"到点自己跑",还配了失败推送。
看起来闭环了,对吧?但有个被忽略的断点:产物还躺在文件夹里。你会遇到三件真实的事:
- 报告产出无人收。早报生成了,但你得自己打开、复制、贴到群里——"自动生成"省了写的时间,没省"发"的时间;
- 跨端手动搬运。"重要的发群、要留档的发邮件、要能检索的存知识库",三件事手动做三遍,比写报告还烦;
- 断更无感知。某天流水线因为路径问题产出空文件(#14 坑 1 讲过),#14 的推送只报"任务成功"——它不知道内容是不是空的,你也不会去看,于是安静断更一周。
根子是:#14 的推送是"任务级"的(成功/失败/0 条),不是"内容级"的(今天早报有 3 条重要资讯)。任务跑没跑、和跑出了什么,是两件事。本篇补的就是内容级投递这一层:把成品文件"发现 → 拼成一条 → 推到人面前"。
二、解决方案:四步投递,先接后推
核心思路一句话:把"交作业"拆成 发现报告 → 解析摘要 → 组装成一条 → 多端投递 四步,每步单一职责、可单独验证;接在 #13/#14/#15 之后跑,让流水线从"生成"走到"送达"。
2.1 全景图:每步的判定标准
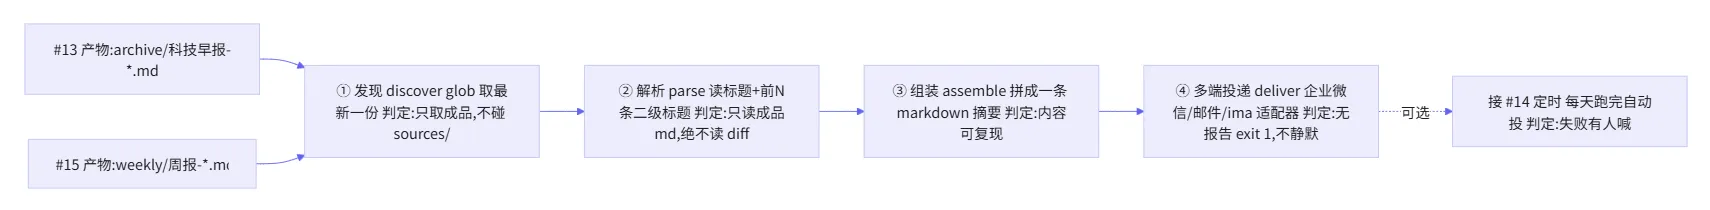
flowchart LR
A["#13 产物:archive/科技早报-*.md"] --> B["① 发现 discover<br />glob 取最新一份<br />判定:只取成品,不碰 sources/"]
C["#15 产物:weekly/周报-*.md"] --> B
B --> D["② 解析 parse<br />读标题+前N条二级标题<br />判定:只读成品md,绝不读 diff"]
D --> E["③ 组装 assemble<br />拼成一条 markdown 摘要<br />判定:内容可复现"]
E --> F["④ 多端投递 deliver<br />企业微信/邮件/ima 适配器<br />判定:无报告 exit 1 且 errcode=0"]
F -.->|"可选"| G["接 #14 定时<br />每天跑完自动投<br />判定:失败有人喊"]注释(判定标准):四步各自独立——发现失败不影响解析,投递挂了不影响组装。每个节点的"判定"就是它的自检点,哪步出问题一眼定位。最后一跳"接 #14 定时"是可选升级,把投递本身也变成自动流水线的末道工序。
2.2 完整代码(已实测跑通)
只用标准库 + 本地文件,零第三方依赖。代码语法兼容 Python 3.9+(list[Path] 这类内置泛型自 3.9 起支持),本文的实测环境为 Python 3.13——这两件事不要混:3.9 能跑是语法层面成立,3.13 跑通是这次的实测结论。
"""
deliver.py —— 成稿自动投递(示例代码,已实测可运行)
流程:发现报告文件 -> 解析摘要 -> 组装成一条投递消息 -> 通过适配器推送到 IM/邮件/知识库
依赖:仅 Python 标准库;推送目标(webhook)由参数或环境变量注入。
文中已用本地 mock 服务器实测「企业微信机器人 webhook」通路。
"""
import argparse
import datetime as dt
import glob
import json
import os
import re
import urllib.request
from pathlib import Path

# 报告发现规则:每类取"最新修改"的一份
REPORT_GLOBS = {
"早报": "archive/科技早报-*.md",
"周报": "weekly/周报-*.md",
}

def discover(pattern: str) -> list[Path]:
files = sorted(glob.glob(pattern), key=os.path.getmtime, reverse=True)
return [Path(f) for f in files]

def parse_digest(path: Path, kind: str, limit: int = 5) -> dict:
"""读报告正文,取标题 + 前 limit 条二级标题作摘要。只读成品文件,绝不碰源数据/脚本。"""
text = path.read_text(encoding="utf-8")
title_m = re.search(r"^#\s+(.+)$", text, re.M)
title = title_m.group(1).strip() if title_m else path.name
items = re.findall(r"^##\s+(.+)$", text, re.M)[:limit]
return {"kind": kind, "file": path.name, "title": title, "items": items}

def build_message(reports: list[dict]) -> str:
lines = [f"# 今日投递 · {dt.date.today().isoformat()}", ""]
total = 0
for r in reports:
lines.append(f"## {r['title']}({len(r['items'])} 条预览)")
for it in r["items"]:
lines.append(f"- {it}")
lines.append(f"  _来源文件:{r['file']}_")
lines.append("")
total += len(r["items"])
lines.append(f"> 共投递 {len(reports)} 份报告、{total} 条内容预览")
return "\n".join(lines)

def fit_bytes(content: str, limit: int = 4096) -> str:
    """按 UTF-8 字节截断,且不切坏多字节字符——企业微信按字节而非字符计算长度"""
    raw = content.encode("utf-8")
    if len(raw) <= limit:
        return content
    return raw[:limit].decode("utf-8", errors="ignore")

class WebhookAdapter:
"""企业微信机器人 webhook(markdown 类型)。其他 IM(钉钉/飞书)同理,只换 payload 结构。"""

def __init__(self, url: str, timeout: int = 15):
self.url = url
self.timeout = timeout

def send(self, content: str) -> tuple[int, int, str]:
# 企业微信 markdown 消息体上限 4096 字节,超长截断
payload = json.dumps({
"msgtype": "markdown",
"markdown": {"content": fit_bytes(content)},
}).encode("utf-8")
req = urllib.request.Request(
self.url,
data=payload,
headers={"Content-Type": "application/json"},
)
# 企业微信在内容超限、参数非法、频率超限时会返回 HTTP 200 但 errcode 非 0,只判状态码等于假成功
with urllib.request.urlopen(req, timeout=self.timeout) as resp:
status = resp.status
body = json.loads(resp.read().decode("utf-8"))
return status, body.get("errcode", -1), body.get("errmsg", "")

def main() -> int:
ap = argparse.ArgumentParser()
ap.add_argument("--root", default=".", help="报告根目录(含 archive/ 与 weekly/)")
ap.add_argument("--limit", type=int, default=5, help="每份报告取前几条作预览")
ap.add_argument("--webhook", default=os.environ.get("DELIVER_WEBHOOK", ""),
help="企业微信机器人 webhook URL(或设环境变量 DELIVER_WEBHOOK)")
ap.add_argument("--dry-run", action="store_true", help="只打印将要投递的内容,不真正发送")
args = ap.parse_args()

reports = []
for kind, pat in REPORT_GLOBS.items():
hits = discover(os.path.join(args.root, pat))[:1]  # 每类取最新一份
for p in hits:
reports.append(parse_digest(p, kind, args.limit))

if not reports:
# 守卫:没报告还"成功投递"就是静默失败,必须喊
print("[error] 未发现任何报告文件(期望 archive/科技早报-*.md 或 weekly/周报-*.md)")
return 1

msg = build_message(reports)
print("===== 将要投递的内容 =====")
print(msg)
print("==========================")

if args.dry_run:
print("[dry-run] 未发送,仅验证内容组装")
return 0

if not args.webhook:
print("[error] 未配置 --webhook(或 DELIVER_WEBHOOK 环境变量),无法投递;加 --dry-run 仅预览")
return 1

adapter = WebhookAdapter(args.webhook)
status, errcode, errmsg = adapter.send(msg)
print(f"[done] 投递完成,HTTP {status},errcode={errcode} {errmsg}")
return 0 if (status == 200 and errcode == 0) else 1

if __name__ == "__main__":
raise SystemExit(main())
2.3 实测运行(真实输出,非示意图)
我用托管 Python 3.13 在一个演示目录(含 #13 风格的早报、#15 风格的周报各一份)真跑了一遍,配一个本地 mock 企业微信服务接收 POST:
$ python deliver.py --root . --dry-run
===== 将要投递的内容 =====
# 今日投递 · 2026-10-25

## 科技早报 2026-10-24(3 条预览)
- 示例:某开源框架发布 2.0 版本,启动速度提升明显
- 示例:某云厂商上线 Agent 编排服务,支持可视化拖拽
- 示例:研究称小模型在垂直领域已逼近大模型水平
  _来源文件:科技早报-2026-10-24.md_

## 周报 · repo(窗口:7 days ago)(4 条预览)
- 新功能(1)
- 缺陷修复(1)
- 文档(1)
- 性能优化(1)
  _来源文件:周报-repo-7_days_ago.md_

> 共投递 2 份报告、7 条内容预览
==========================
[dry-run] 未发送,仅验证内容组装
确认内容组装无误后,实投到本地 mock(模拟企业微信机器人)。mock 按企业微信格式返回 HTTP 200 与 {"errcode":0},确认 webhook 适配器发出的 POST、markdown 报文结构与成功判定逻辑都对:
$ python deliver.py --root . --webhook "http://127.0.0.1:8899/webhook"
...(内容与上同,略)...
[done] 投递完成,HTTP 200,errcode=0无报告守卫也实测过——root 指向一个空目录时,脚本直接判失败、退出码 1,绝不"假成功":
$ python deliver.py --root empty_root --webhook "http://127.0.0.1:8899/webhook"
[error] 未发现任何报告文件(期望 archive/科技早报-*.md 或 weekly/周报-*.md)
两点如实说明:
- 企业微信那一段是接本地 mock 实测的,证明 webhook 通路、markdown 报文结构与 errcode 判定都正确;真实环境把
--webhook换成你的企业微信机器人地址即可(下文讲怎么拿、怎么保管)。 - 邮件 / ima 知识库是接线骨架,网络部分没在这跑——它们需要你的 SMTP 凭据或 IMA 凭据,文中给出最小可用代码,你填进去自测即可(ima 部分按 #12 的方法接)。ima 那段的接口路径、鉴权头字段与响应字段以 IMA 开放平台官方文档为准,本文给的是骨架而非已验证调用;另外 import_doc 只是创建笔记,要真正关联进知识库还需再调一次 add_knowledge(media_type=11),不能一句"写入知识库"带过。和 #13 的 AI 摘要模式、#15 的 ima 一样,我不会因为"没跑过"就假装它通。
2.4 扩展适配器:邮件与知识库(接线骨架)
投递目标多变,但"发现 → 解析 → 组装"不变。把可变部分收口成一个 send(content) 接口,加渠道 = 加一个适配器,主干不动(这就是适配器模式,Adapter Pattern)。下面两段是接到主干上的"插座":注意这两段是未实测的接线骨架,参数按公开的接口形式写,但凭据与环境差异需要你自己验证——路径、字段名以官方文档为准。
# ---- 扩展适配器(接线骨架,需你的凭据;网络部分未在此环境实跑,填后自测) ----
import smtplib
from email.header import Header
from email.mime.text import MIMEText

class EmailAdapter:
    """SMTP 邮件投递:适合"留档"。正文用纯文本,避免把格式带进邮件。
    465 走 SMTP_SSL 直连,587 走 SMTP + starttls。"""
    def __init__(self, smtp_host: str, smtp_user: str, smtp_pass: str, to: str, port: int = 587, use_ssl: bool = False):
        self.host, self.user, self.passwd, self.to = smtp_host, smtp_user, smtp_pass, to
        self.port, self.use_ssl = port, use_ssl

    def send(self, content: str) -> int:
        msg = MIMEText(content, "plain", "utf-8")
        # 中文主题必须用 Header 编码,否则容易出现头部编码异常
        msg["Subject"] = Header("今日投递", "utf-8").encode()
        msg["From"], msg["To"] = self.user, self.to
        if self.use_ssl:
            with smtplib.SMTP_SSL(self.host, self.port) as s:
                s.login(self.user, self.passwd)
                s.send_message(msg)
        else:
            with smtplib.SMTP(self.host, self.port) as s:
                s.starttls()
                s.login(self.user, self.passwd)
                s.send_message(msg)
        return 0

class ImaAdapter:
    """写入 IMA 知识库笔记:适合"可检索问答"。按 #12 方法打标签,攒一个月能问。
    需你的 IMA 凭据;路径与鉴权以官方文档为准;此为骨架,未实测。"""
    def __init__(self, api_base: str, client_id: str, api_key: str, knowledge_base_id: str):
        self.base, self.cid, self.key, self.kb = api_base, client_id, api_key, knowledge_base_id

    def send(self, content: str) -> int:
        title = "今日投递"
        # 第一步:import_doc 创建可编辑笔记(note/v1,注意是单数;content_format=1 表示 markdown)
        body = json.dumps({"title": title, "content": content, "content_format": 1}).encode("utf-8")
        req = urllib.request.Request(
            f"{self.base}/openapi/note/v1/import_doc",
            data=body,
            headers={
                "Content-Type": "application/json",
                "ima-openapi-clientid": self.cid,
                "ima-openapi-apikey": self.key,
            },
        )
        with urllib.request.urlopen(req, timeout=30) as resp:
            result = json.loads(resp.read().decode("utf-8"))
        if result.get("code") != 0:
            return result.get("code", -1)
        note_id = result["data"]["note_id"]

        # 第二步:add_knowledge 关联进知识库(wiki/v1;media_type=11 表示笔记)
        # 注意:笔记走 note_info.content_id,不要传 media_id,否则报 220001
        add_body = json.dumps({
            "knowledge_base_id": self.kb,
            "media_type": 11,
            "note_info": {"content_id": note_id},
            "title": title,
            "folder_id": self.kb,  # 根目录时传 knowledge_base_id
        }).encode("utf-8")
        add_req = urllib.request.Request(
            f"{self.base}/openapi/wiki/v1/add_knowledge",
            data=add_body,
            headers={
                "Content-Type": "application/json",
                "ima-openapi-clientid": self.cid,
                "ima-openapi-apikey": self.key,
            },
        )
        with urllib.request.urlopen(add_req, timeout=30) as add_resp:
            add_result = json.loads(add_resp.read().decode("utf-8"))
        return add_result.get("code", -1)
企业微信(即时看)+ 邮件(留档)+ ima(可检索问答)三条不互斥,按需要接线。建议先接企业微信跑通闭环,再加另外两端。
三、原理解析:为什么这么拆
1. 投递层和"任务状态推送"是两件事,别混。 #14 里 WorkBuddy 的推送是任务级:告诉你"脚本跑没跑、有没有报错"。本文 deliver.py 是内容级:把报告内容推到人面前。两者互补——任务推送回答"跑没跑",内容推送回答"跑了什么"。只配任务推送,你永远不知道"今天早报到底有没有料"。
2. 适配器模式(Adapter Pattern)把"多变"收口。 投递渠道今天是企业微信、明天加邮件、后天加飞书——变的是渠道,不变的是"把成品拼成一条摘要"。把渠道收口成统一的 send(content),新增渠道只写一个类,主干一行不动。这是让流水线"抗扩展"的关键。
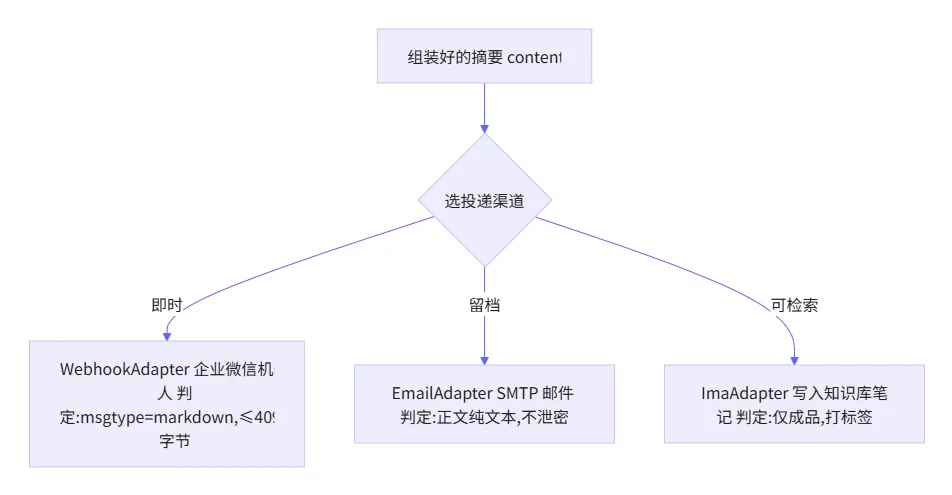
flowchart TD
C["组装好的摘要 content"] --> R{"选投递渠道"}
R -->|"即时"| W["WebhookAdapter<br />企业微信机器人<br />判定:msgtype=markdown,≤4096字节(UTF-8)"]
R -->|"留档"| M["EmailAdapter<br />SMTP 邮件<br />判定:正文纯文本,不泄密"]
R -->|"可检索"| I["ImaAdapter<br />写入知识库笔记<br />判定:仅成品,打标签"]
注释(判定标准):同一份
content三端各投一次,避免每端各拼一次导致不一致;任一端失败只重试该端,不影响其他端。
3. 推摘要,不推全文。 群消息太长没人看。代码里 parse_digest(..., limit=5) 只取前 5 条二级标题作预览,全文仍在 archive/ 和 weekly/ 里可查。推送是"通知",文件才是"归档"——这点和 #14 的"产物留档"一脉相承。
4. 多端可组合,不互斥。 企业微信给你"即时看到"、邮件给你"事后留档"、ima 给你"攒一个月能问答"(参考 #12)。三条一起开,报告的价值从"当天看一眼"变成"长期可检索的知识资产"。
5. 脚本跑通,才是接 Agent 的起点。 和前三篇同一个道理:先让 deliver.py 在本地手动跑熟、日志可见,再接到 #14 的自动化任务里当末道工序。没验证的步骤交给自动调度,等于让自动系统定时放大你的 bug。
四、提示与避坑(5 个真实踩坑)
投递出问题,按这张决策树定位,别从头翻代码:
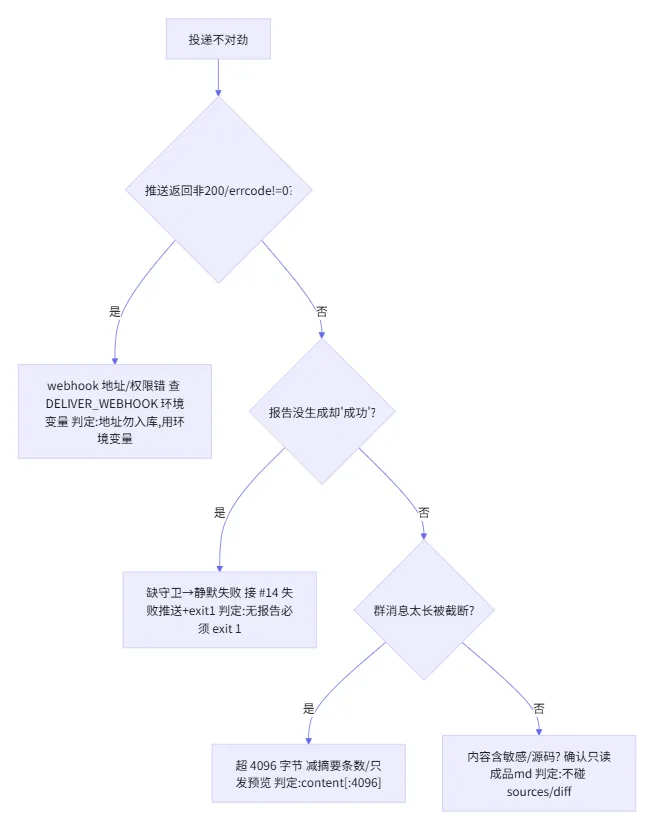
flowchart TD
E["投递不对劲"] --> Q1{"推送返回非200/errcode!=0?"}
Q1 -->|"是"| C1["webhook 地址/权限错<br />查 DELIVER_WEBHOOK 环境变量<br />判定:地址勿入库,用环境变量"]
Q1 -->|"否"| Q2{"报告没生成却'成功'?"}
Q2 -->|"是"| C2["缺守卫→静默失败<br />接 #14 失败推送+exit1<br />判定:无报告必须 exit 1"]
Q2 -->|"否"| Q3{"群消息太长被截断?"}
Q3 -->|"是"| C3["超 4096 字节<br />减摘要条数/只发预览<br />判定:按UTF-8字节截断,不按字符数"]
Q3 -->|"否"| C4["内容含敏感/源码?<br />确认只读成品md<br />判定:不碰 sources/diff"]注释(判定标准):每个症状先对应一个信号(HTTP 状态码 / 退出码 / 截断现象 / 内容检查)——排错入口永远是信号,不是猜。
这 5 个坑按重要度排:
- 推送内容超限。 企业微信 markdown 上限是 4096 字节,注意单位是字节不是字符——中文一个字 3 字节,按字符截 4096 位的中文摘要实际约 12KB,照样触发 40058 报错。代码里
fit_bytes()按 UTF-8 字节切且不切坏多字节字符,这才是真兜底;content[:4096]那种写法只是看起来兜底。长报告(周报条目多)仍建议把--limit调小或只发预览。 - 静默失败最阴。 "没报告却显示投递成功"是最贵的坑:某天流水线没产出,
deliver.py没守卫就会"顺利"发一条空摘要,你一周后才发现。解法是exit 1守卫 + errcode 校验 + 接 #14 的失败推送,三者缺一不可:exit 1 防"没产出也算成功",errcode 校验防"发不出去也算成功"——没有告警的自动化等于没有刹车的车。 - webhook 地址别入库。 企业微信机器人 URL 是"谁有 URL 谁就能发",泄露等于任何人能往你群发消息。用环境变量
DELIVER_WEBHOOK注入,.env文件加进.gitignore,绝不提交进仓库(这条和所有密钥同理)。 - 别把密钥/源码带进推送。 报告只含成品(#13/#15 本就只写成品信息),
deliver.py只读成品.md,绝不碰sources/或仓库 diff——复用前三篇"只读成品"的安全边界。有人为了"周报更细"把 git diff 也贴进推送,一旦仓库含密钥就泄露,坚决不干。 - 多端顺序与重试。 先内容组装一次,再分别投递三端,避免每端各拼一次导致不一致;单端失败只重试该端(企业微信挂了不影响邮件)。投递是流水线的"出口",出口乱了前面全白干。另外频率约束别忘:每个 webhook 每分钟最多 20 条消息,超限返回 45009,而且打到上限之后哪怕只发一条也会被拒,得等下一分钟窗口重置才恢复。多端重试要加最小退避(比如失败后等 3 秒、最多重试 2 次),否则连续撞限只会把一次失败拖成雪崩。
跑通之后,完整路线和硬规矩:
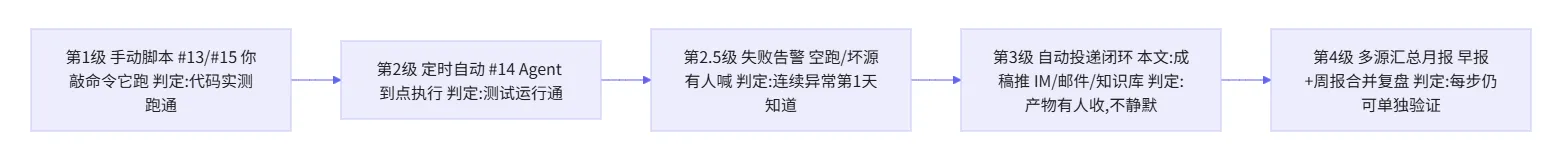
flowchart LR
    L1["第1级 手动脚本<br />#13/#15 你敲命令它跑<br />判定:代码实测跑通"] --> L2["第2级 定时自动<br />#14 Agent 到点执行<br />判定:测试运行通过"]
    L2 --> L3["第2.5级 失败告警<br />空跑/坏源有人喊<br />判定:连续异常第1天知道"]
    L3 --> L4["第3级 自动投递闭环<br />本文:成稿推 IM/邮件/知识库<br />判定:产物有人收,不静默"]
L4 --> L5["第4级 多源汇总月报<br />早报+周报合并复盘<br />判定:每步仍可单独验证"]注释(管控要求):顺序的硬规矩还是每一步稳定跑至少一周再进下一步;第 3 级(自动投递)不能跳——生成了却没人收,等于没生成。
今晚就能做的行动清单(按顺序,别跳):
- 归位:把
deliver.py放进D:\NewsBot(和 #13/#14 同目录),--root指向含archive/、weekly/的目录,先--dry-run跑通一次,确认摘要拼对; - 拿 webhook:企业微信里"群机器人 → 添加 → 复制 webhook 地址",设成环境变量
DELIVER_WEBHOOK,别写进脚本、别提交 git; - 实投一次:cmd 用
python deliver.py --root . --webhook "%DELIVER_WEBHOOK%",PowerShell 用python deliver.py --root . --webhook "$env:DELIVER_WEBHOOK",去群里确认收到 markdown 摘要。变量没设上时脚本会直接报"未配置 webhook"退出 1,看到这句先查环境变量而不是查代码; - 接定时:把投递作为 #14 自动化任务的末道工序(在早报/周报生成之后跑),让"生成→投递"全自动;
- 加两端:稳一周后,按 2.4 接 EmailAdapter(留档)和 ImaAdapter(参考 #12 进知识库打标签),让报告既能看、又能查。
披露声明(AI 辅助创作,含 AI 生成内容):本文由作者基于真实的脚本搭建与实跑过程撰写,使用 AI 工具辅助起草与润色;文中含 AI 生成内容,经作者审核修订。核心观点、代码设计与踩坑结论均由作者负责。示例代码
deliver.py的实测范围仅覆盖三项:dry-run 预览、本地 mock 投递(HTTP 200 且 errcode=0)、无报告守卫 exit 1,环境为 Python 3.13;3.9+ 为语法兼容声明,未在 3.9 环境实跑;邮件与 ima 适配器为未实测骨架,ima 的接口路径与鉴权字段以官方文档为准。企业微信 markdown 4096 字节上限、机器人 webhook 机制以官方文档为准。另:文中插图为带签名的临时链接,对外发布前需导出为独立图片重新上传,否则外部读者可能无法加载。
企业微信(即时看)+ 邮件(留档)+ ima(可检索问答)三条不互斥,按需要接线。建议先接企业微信跑通闭环,再加另外两端。三端都接之前,先把企业微信这一段真正跑通。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号