#WorkBuddy# 实战:熊大「本店商品导出」715 个商品,我踩遍了所有坑才拿到全字段表格
原创
#WorkBuddy# 实战:熊大「本店商品导出」715 个商品,我踩遍了所有坑才拿到全字段表格
原创
用户12814938
发布于 2026-10-12 18:04:45
发布于 2026-10-12 18:04:45
#WorkBuddy# 实战:熊大「本店商品导出」715 个商品,我踩遍了所有坑才拿到全字段表格
一、场景:为什么要把商品导出做成数据库
做电商代运营,手里多家店铺的商品都是从一家"母店"复制过去的。每次给新店上品,都要挂店内分类——不回去查母店这个商品原来挂哪个分类,凭感觉挂错类目,流量和搜索全受影响。我的目标很明确:把母店全字段商品表导出成本地数据库,以后跨店复制直接查库推断分类,不用反复回母店翻。
工具是 WorkBuddy——它驱动 Edge 走完整浏览器自动化,我全程只在旁边看。这篇文章记录整个实操过程,重点是把踩过的坑完整摊开,都是真金白银的时间换来的。
二、正流程:五步拿到表格
以熊大(电商店铺管理系统)为例,导出入口在左侧:商品管理 → 商品导出下拉 → 本店商品导出,页面是 /se/item/item_export/index.jsp。
流程本身不复杂:
- 勾选字段。页面主体是三个字段表:SKU 属性(18 个)、商品属性(57 个)、SKU 交易信息(23 个),每张表有「全选/取消全选/反选」。下方还有「合并相同 SKU」复选框——不勾才是每个 SKU 一行,细节最全,我们要的就是这个。
- 点「开始导出」。
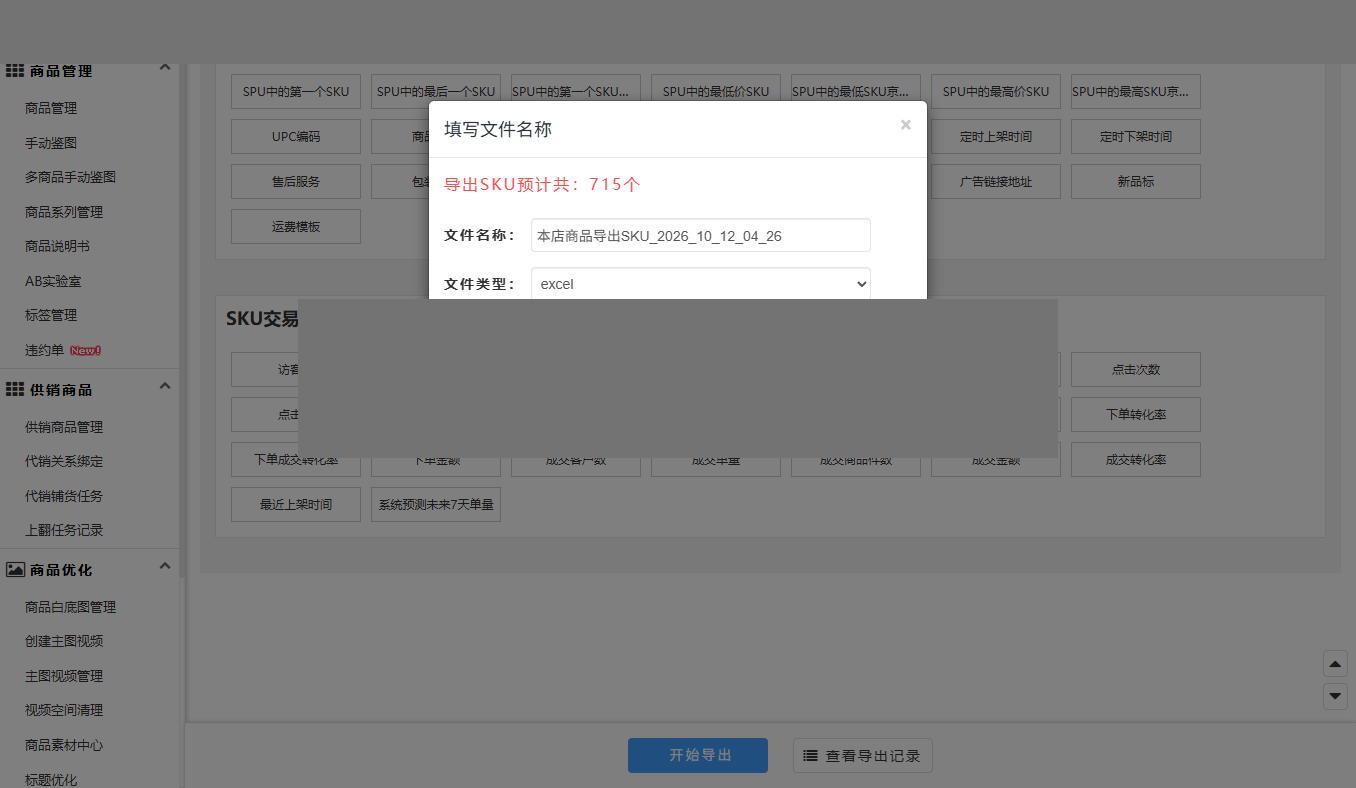
- 弹出「填写文件名称」对话框(见图2),文件类型选 excel——注意提示"EXCEL 文件最大支持导出 65535 行",715 个商品约 3100 行 SKU,远没到顶。
- 确定后自动跳到导出记录页(
/se/item/item_export/list.jsp),等任务状态变成「已完成」。 - 点记录行的「下载文件」拿表格。
听起来半小时搞定?我折腾了整整一夜。
三、坑一:字段全选,必倒在「第 100 个商品」
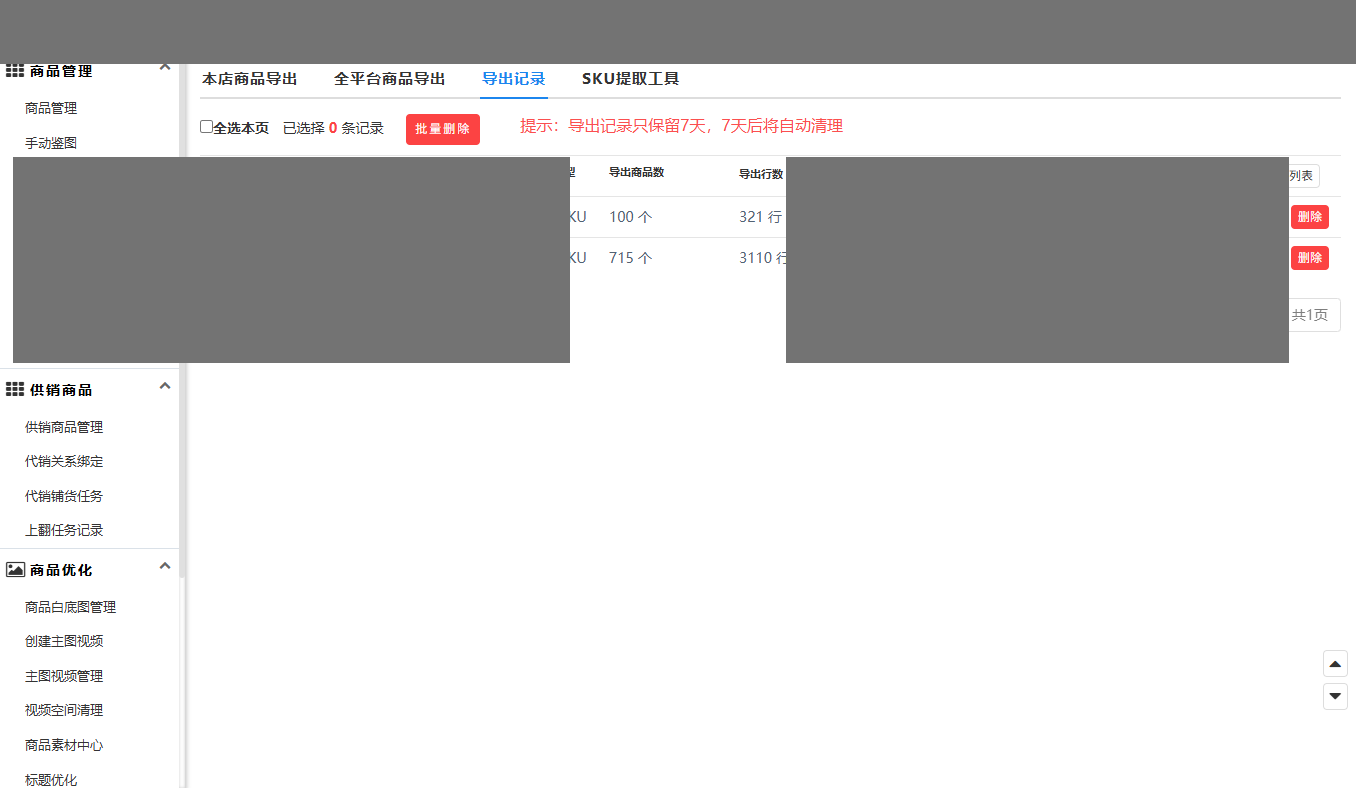
第一个坑最诡异。我把三个表 98 个字段全部勾上(见图1),提交导出,任务显示"已完成"——点开记录,导出数 100 个,321 行,还挂着「错误信息」。715 个商品的店,只导出了 100 个。
我做了三轮降级测试:去掉 SKU 交易信息表,挂;再去掉图片类字段,还挂。每次都是整整齐齐的第 100 个。这个整数太典型了——是接口限流,不是偶发错误。导出记录页的错误信息点开只有一句 "unknown error.",没有任何字段级提示,只能自己试。
结论:图片、划线价、商智流量类字段会触发京东接口限流,全选必挂。
解法是精选字段:只留 16 个核心字段——商品维度(商品 ID、商品名称、店铺分类、京东四级分类、品牌、货号、商品状态、京东价)+ SKU 维度(SKU ID、SKU 编码、SKU 名称、库存、价格、颜色、尺码、sku 属性)。这次 40 秒导完 715 个商品、3097 行,一次成功(见图3 两条失败记录和最后一条成功记录的对比)。
四、坑二:Bootstrap 模态框 position:fixed,可见性判断全部失效
第二个坑是自动化的经典陷阱。点「开始导出」后页面会弹 Bootstrap 模态框(填写文件名称)。我的脚本用 el.offsetParent 判断模态框是否可见——对话框明明弹在屏幕上,脚本永远判定"不可见",来回空跑十几轮。
排查半天恍然大悟:Bootstrap 模态框是 position: fixed 定位,fixed 元素的 offsetParent 永远返回 null。可见性判断必须换成:
const visible = m.classList.contains('in') || m.classList.contains('show')
  || getComputedStyle(m).display !== 'none';
改完之后对话框链路一次打通。这类坑文档里不会写,只有被 fixed 定位毒打过的人才记得。
五、坑三:页面会记忆上次勾选,"跳过不点"≠取消
第三个坑是逻辑陷阱。字段页有"勾选记忆"——上次提交时选了哪些字段,下次打开页面还是那些。我做降级重试时,天真地以为"不点交易信息表就是不要它",结果三次失败全部带着交易信息字段——因为它本来就已经是全选状态躺在那里。
"跳过不点"和"显式取消"是两回事。 每一轮重试都必须先把三张表全部清空(取消全选),再按当轮清单精确勾选,不能偷懒。
六、坑四:下载按钮开新标签页,expect_download 抓不到
第四个坑在最后一步。记录页的「下载文件」按钮,源码是:
onclick="window.open('/se/item_export/download?taskId=xxx&sign=xxx')"window.open 开的是新标签页,Playwright 的 page.expect_download() 在页面级根本捕获不到,干等超时。
解法:不点按钮,直接从 onclick 里提取 URL,用 Playwright 的 context.request.get(url) 请求下载——request 共享浏览器 cookie,HTTP 200 直接落盘,比模拟点击稳得多。
七、成果与用法
最终拿到 1.3MB 的 xls,715 个商品、3097 行 SKU、19 列全字段,解析入库后:
- 商品级索引:标题 → 店内分类 / 京东分类 / 品牌 / SKU 列表;
- 查询工具支持标题关键词模糊匹配,输入商品标题关键词(如"某品牌 爬楼机")直接定位它在母店挂的分类;
- 跨店复制商品时,先查库拿到母店分类,再推断目标店该挂哪个分类——不用再回母店一页页翻。
八、写给同样要做浏览器自动化的你
复盘这一夜,五个坑分两类:两类是平台限制(字段限流、勾选记忆、window.open 下载),一类是自动化通病(fixed 定位的可见性判断)。平台限制只能绕——精选字段、显式清空、提取 URL 直下;自动化通病可以防——判断元素可见性,永远别只依赖 offsetParent。
WorkBuddy 在整个过程里承担的是"执行者":所有点击、轮询、降级重试、下载解析都是它驱动 Edge 完成的,我要做的只是在每个坑出现时判断原因、改策略。一夜五个坑,人做判断,AI 做苦力——这个分工我觉得挺值。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号