我用WorkBuddy搭了个留学材料核对智能体,TextIn xParse这个文档解析真的强
原创
我用WorkBuddy搭了个留学材料核对智能体,TextIn xParse这个文档解析真的强
原创
是店小二呀
发布于 2026-09-18 23:07:16
发布于 2026-09-18 23:07:16
说实话,留学申请最让人头疼的不是写文书,而是材料核对。
你想想看,申请一所学校要准备多少东西:成绩单、学位证、语言成绩、护照扫描件、推荐信、资金证明……每样材料里的信息还得互相印证。姓名拼写一致吗?出生日期对得上吗?GPA换算有没有问题?语言成绩还在有效期内吗?
以前这些都是人工一份份翻、一行行对的,费时费力还容易漏。
最近我发现了一个组合拳:WorkBuddy + TextIn xParse 连接器,直接搭了一个"留学申请材料一致性核对智能体",把这件事自动化了。今天就把整个搭建过程和实际效果分享出来。
先看效果:这个报告到底长什么样?
先不谈怎么搭的,先看看最终跑出来的效果。因为我觉得这个结果本身就能说明很多问题。
智能体跑完之后生成的 HTML 报告,比我预想的要专业得多。它不是一个简单的文字总结,而是一个完整的可交互**工作台**——左侧导航栏,右侧主内容区,风格很像企业级后台管理系统,干净利落。
工作台体验地址: http://45.40.228.76:7777/
解析工作台
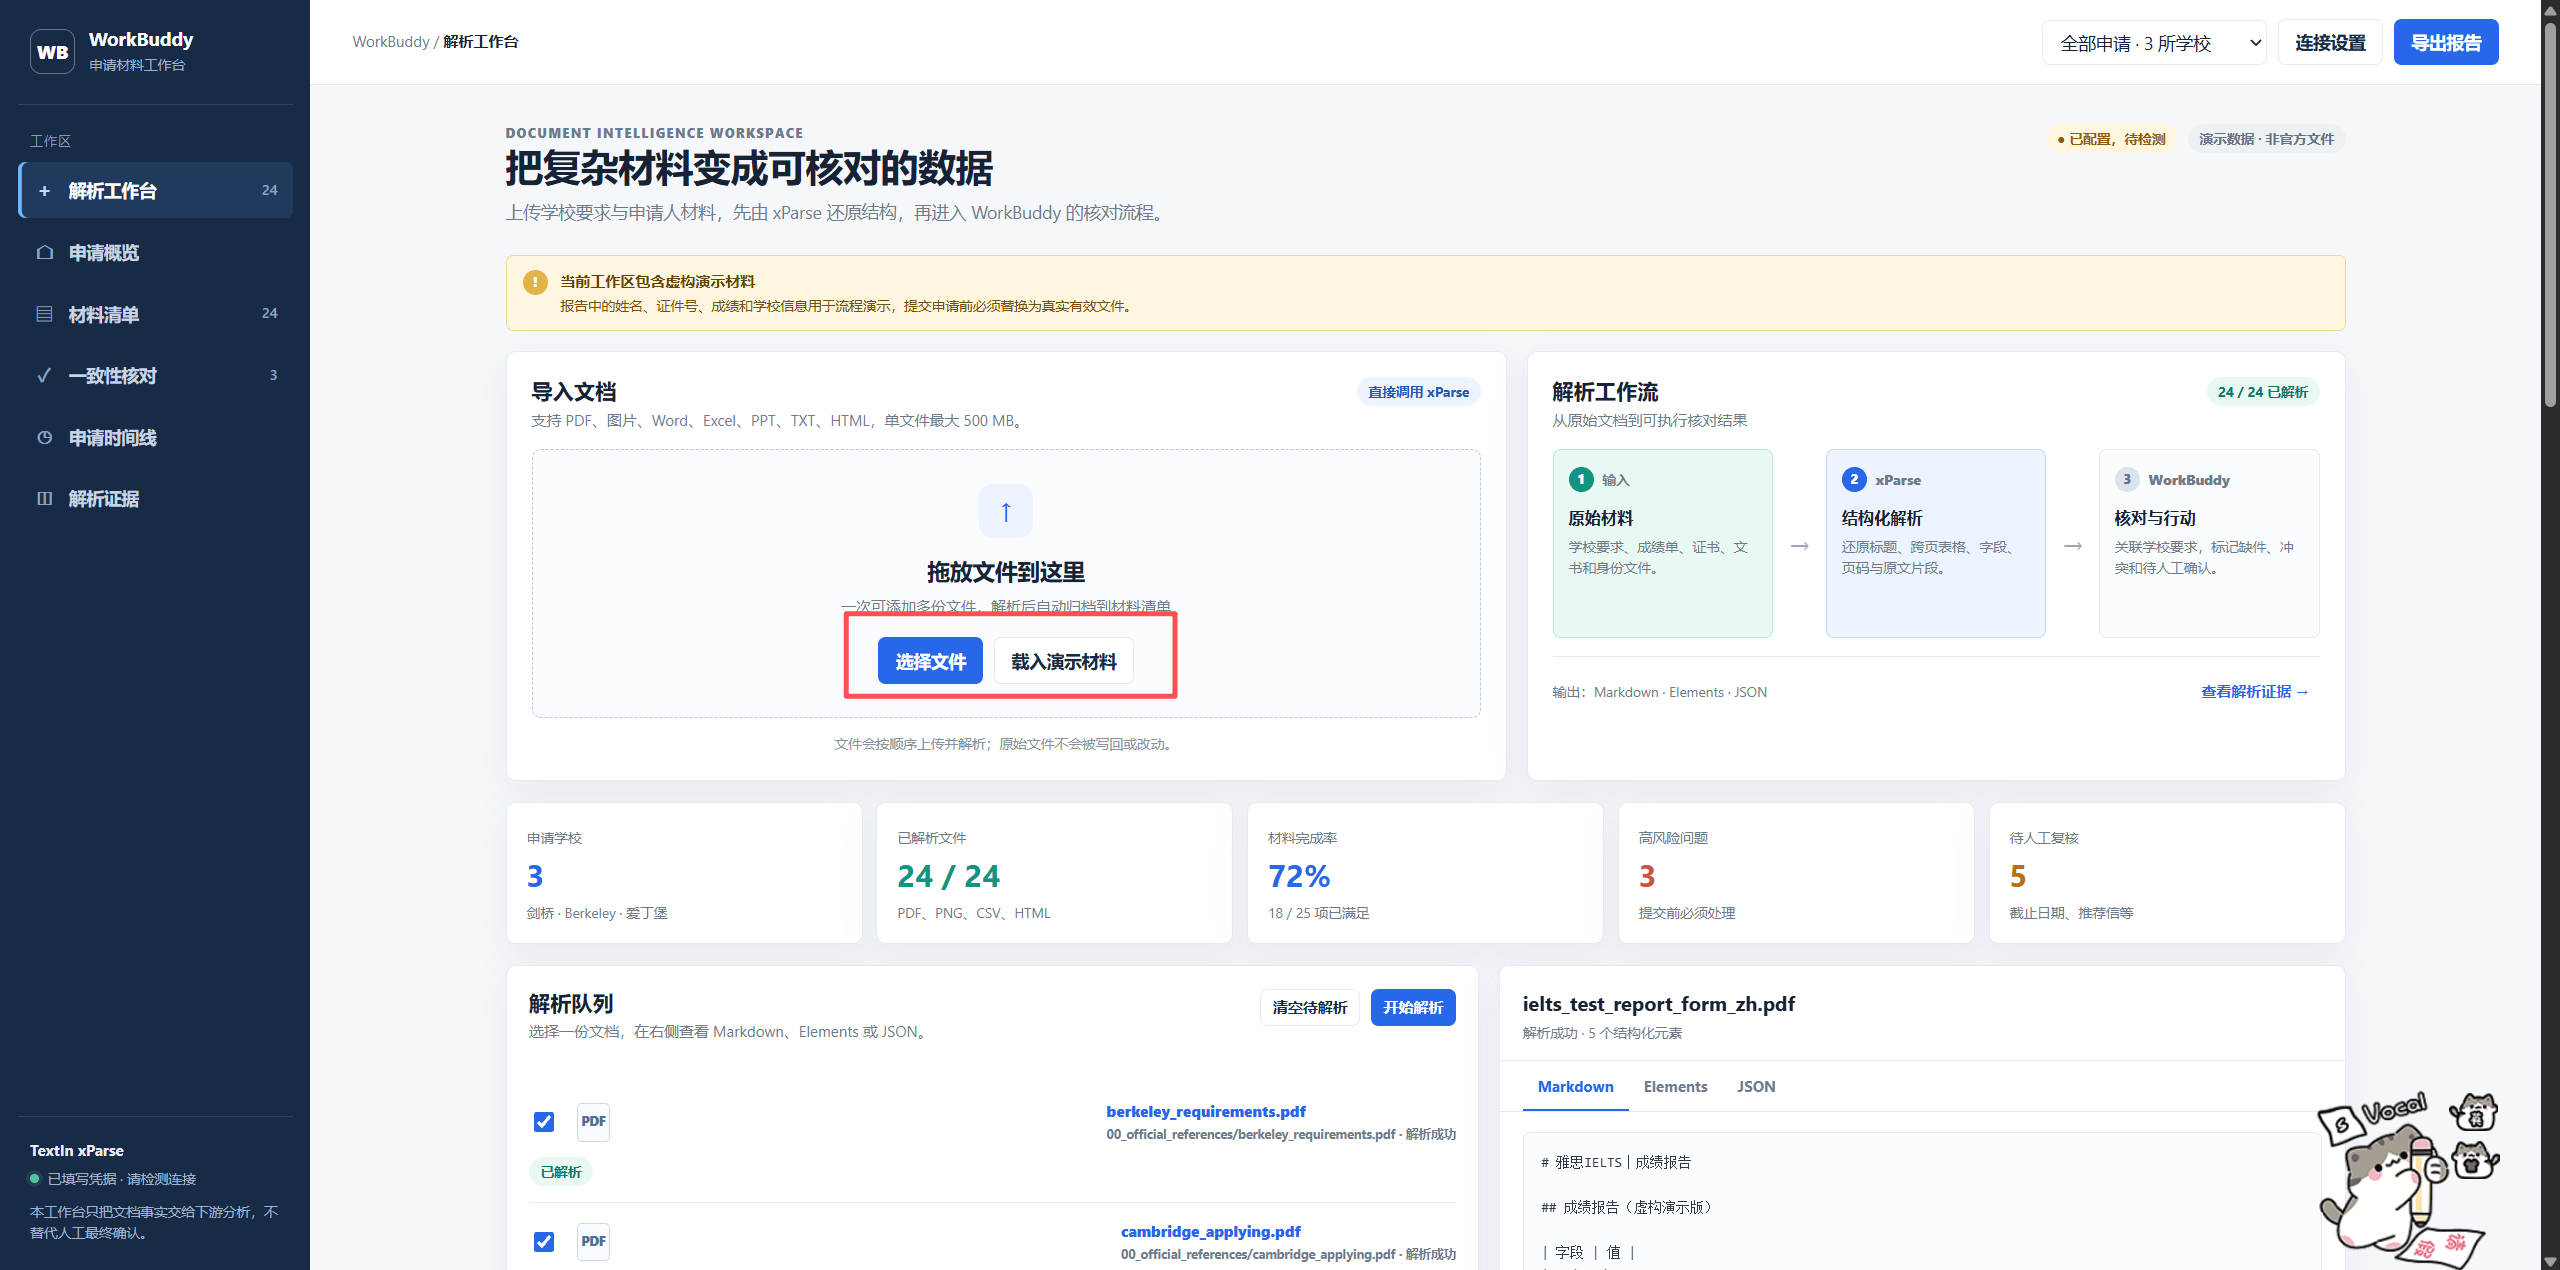
image.png
TextIn xParse 的独立解析**工作台**。左边上传文件(支持拖拽,PDF、图片、Word、Excel 都行),右边实时预览解析结果。输出格式可选 Markdown、JSON 或纯文本——给 AI 分析用 Markdown,导入系统用 JSON。
右下角能切换多种解析结果视图:
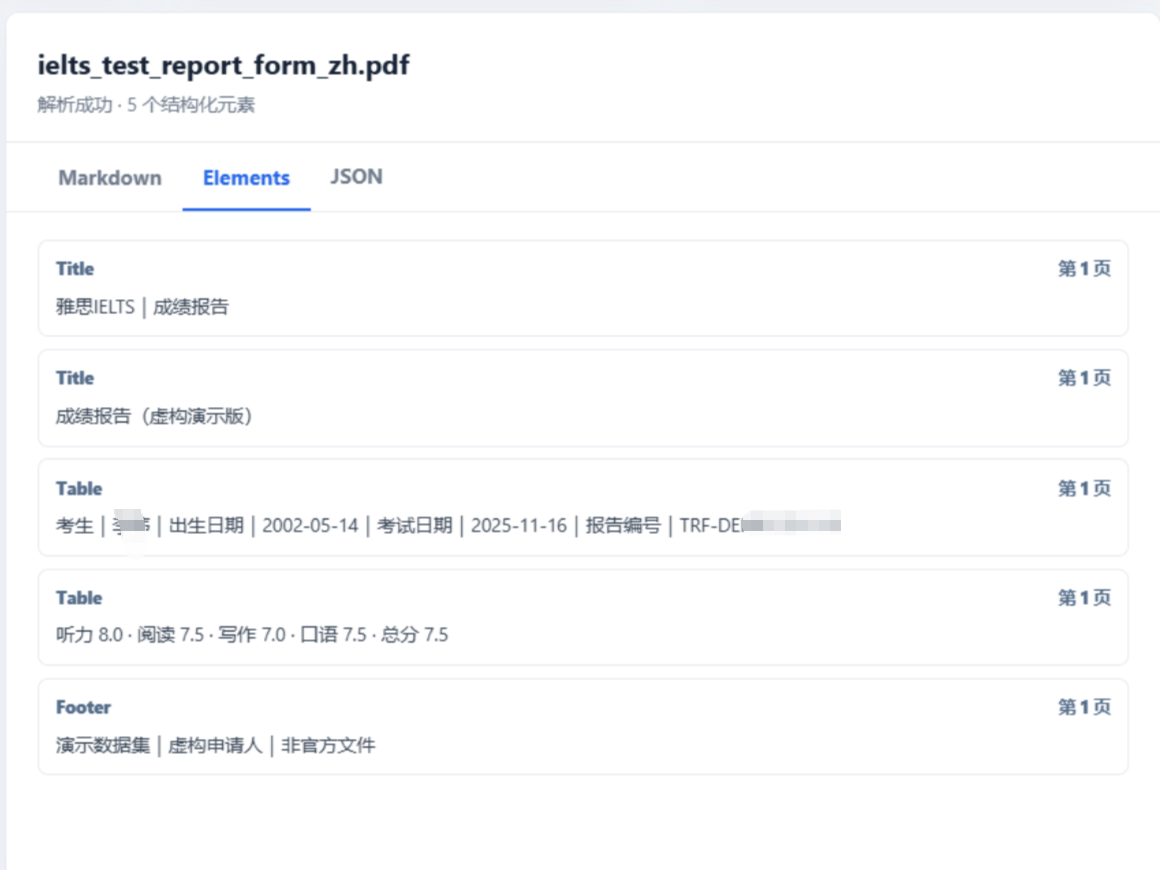
image.png
同一份文档可以切换查看原始文本、结构化表格、字段抽取结果等不同视图。需要确认某个表格数字跟原文是否一致时,切到对照视图就能直接看到。
申请概览
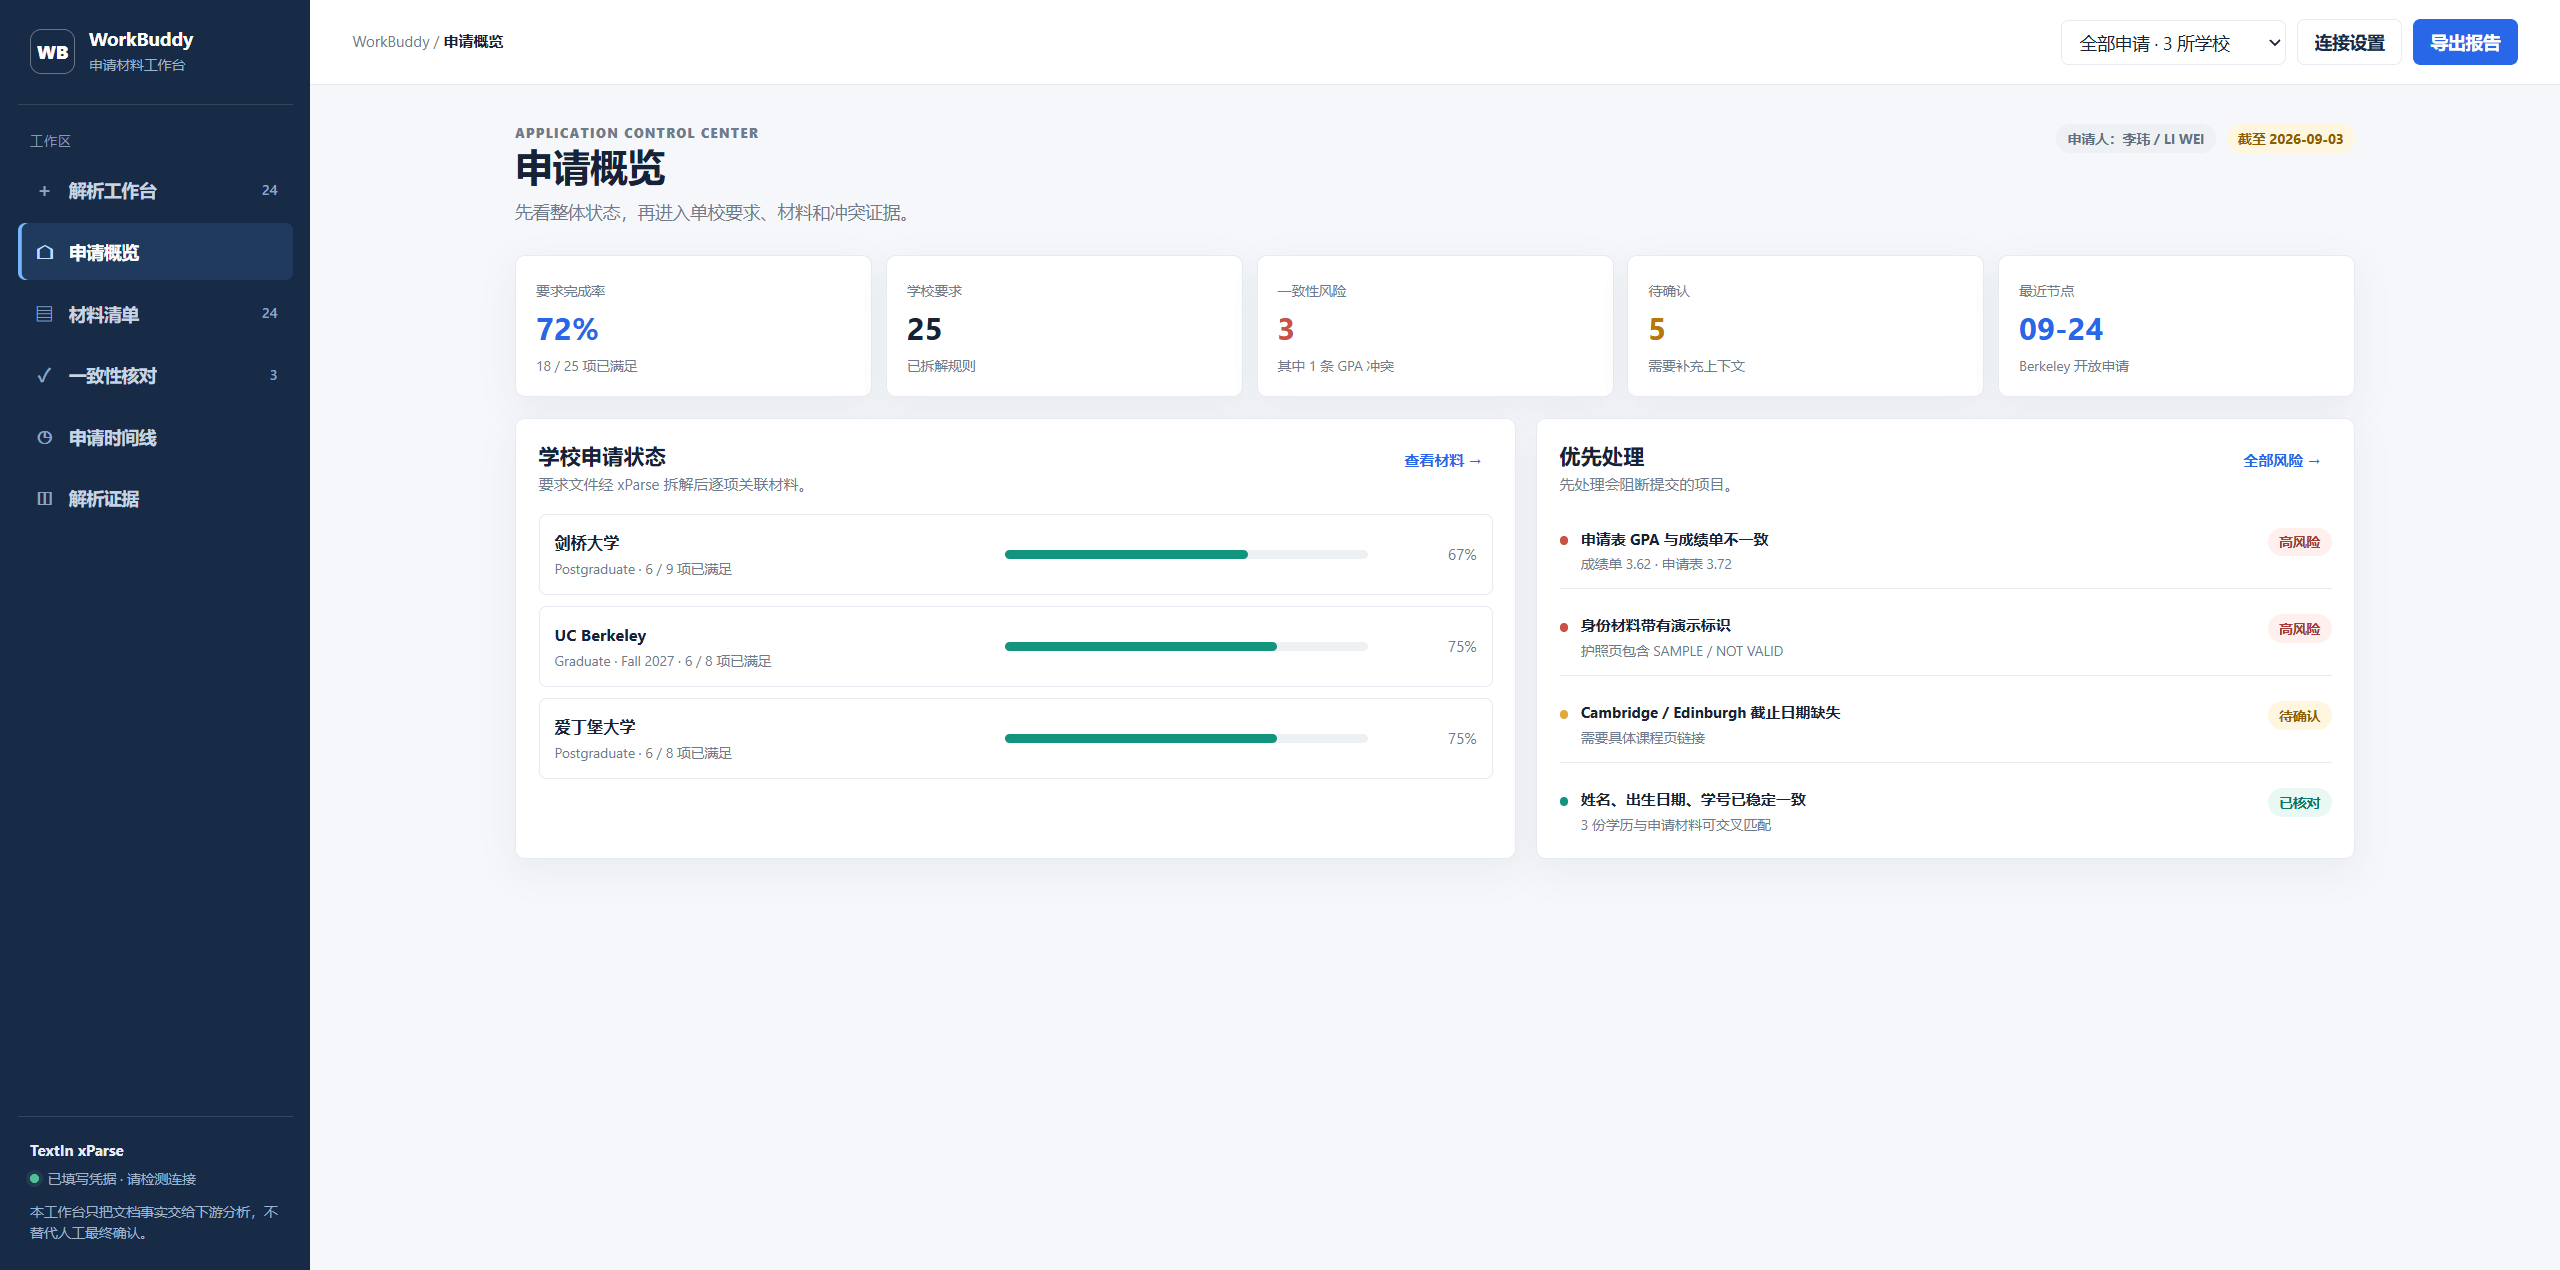
image.png
整个报告的仪表盘。顶部是三所学校的卡片,每张显示名称、状态、完成度进度条——绿色顺利、黄色待办、红色有问题。
下面是要求满足热力图:横轴学校、纵轴材料类型,颜色深浅代表完成状态。一眼看出哪些材料全校通用(整列绿)、哪些是某校特有(个别标红)。再往下是关键日期提醒和待办事项,按紧急程度排序,逾期事项红色置顶。
材料清单
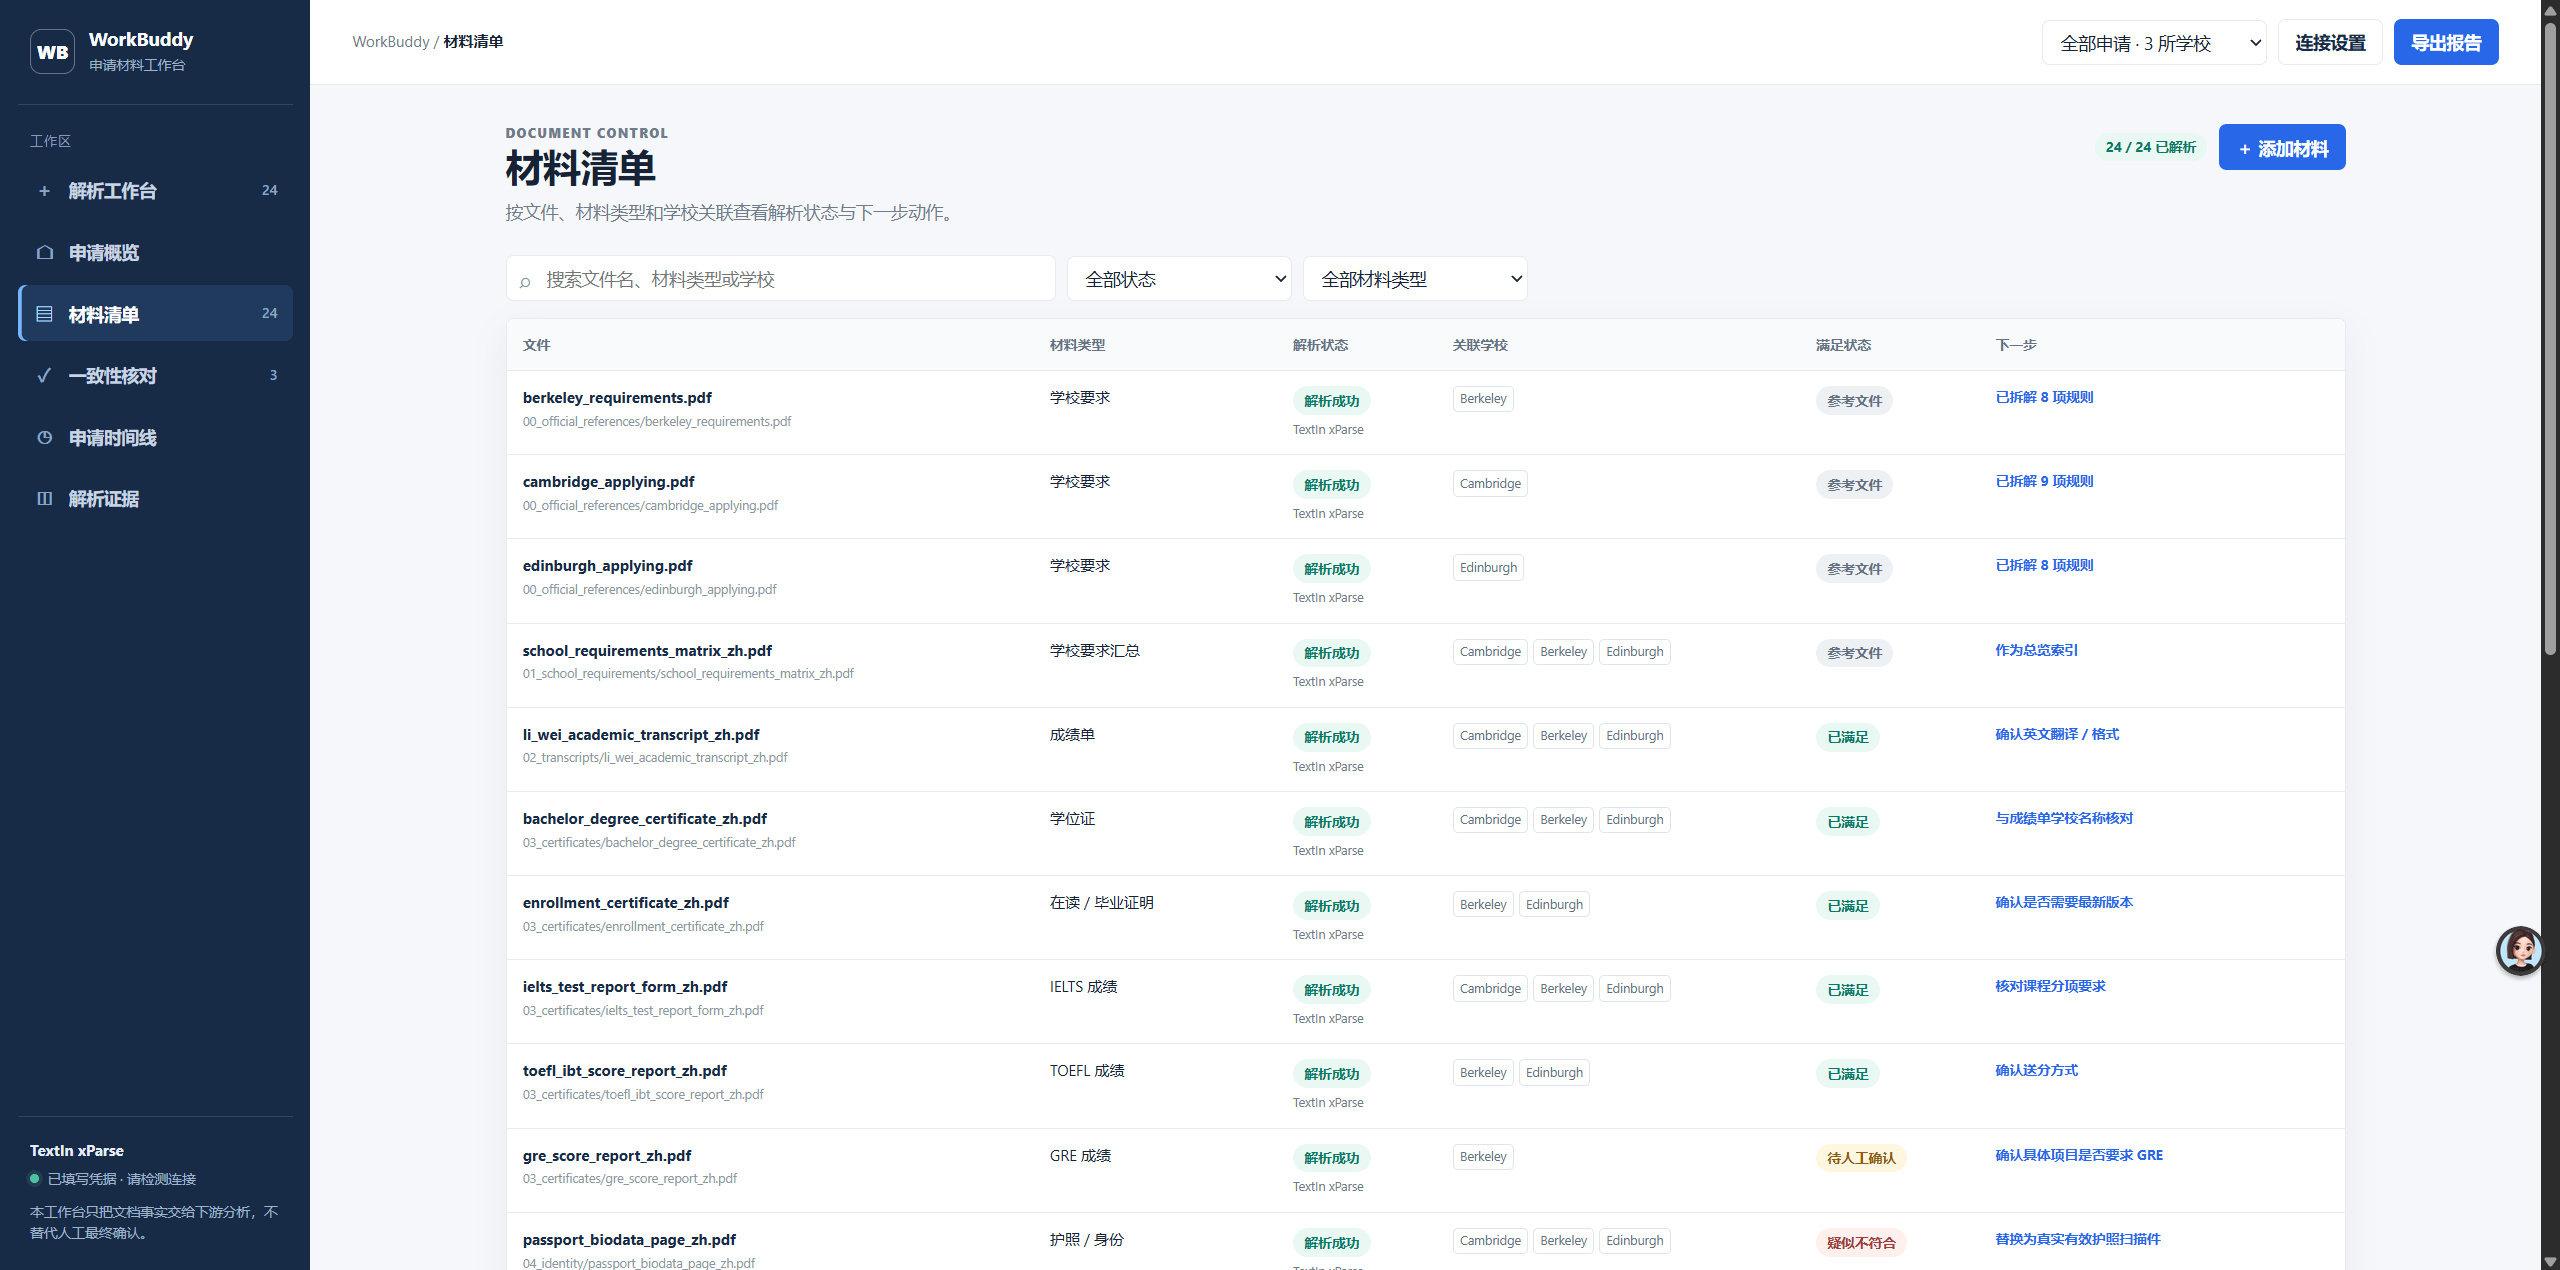
image.png
列出所有已解析文件的可交互表格,支持按名称、类型、状态排序筛选。每行显示文件名、类型图标、大小,以及解析质量评分——大部分绿色"优秀",少数扫描件可能标黄"良好"建议人工复核。
点击任意行可展开查看详细解析结果:提取出的所有字段、原文位置、以及与其他材料的交叉引用关系。
一致性核对
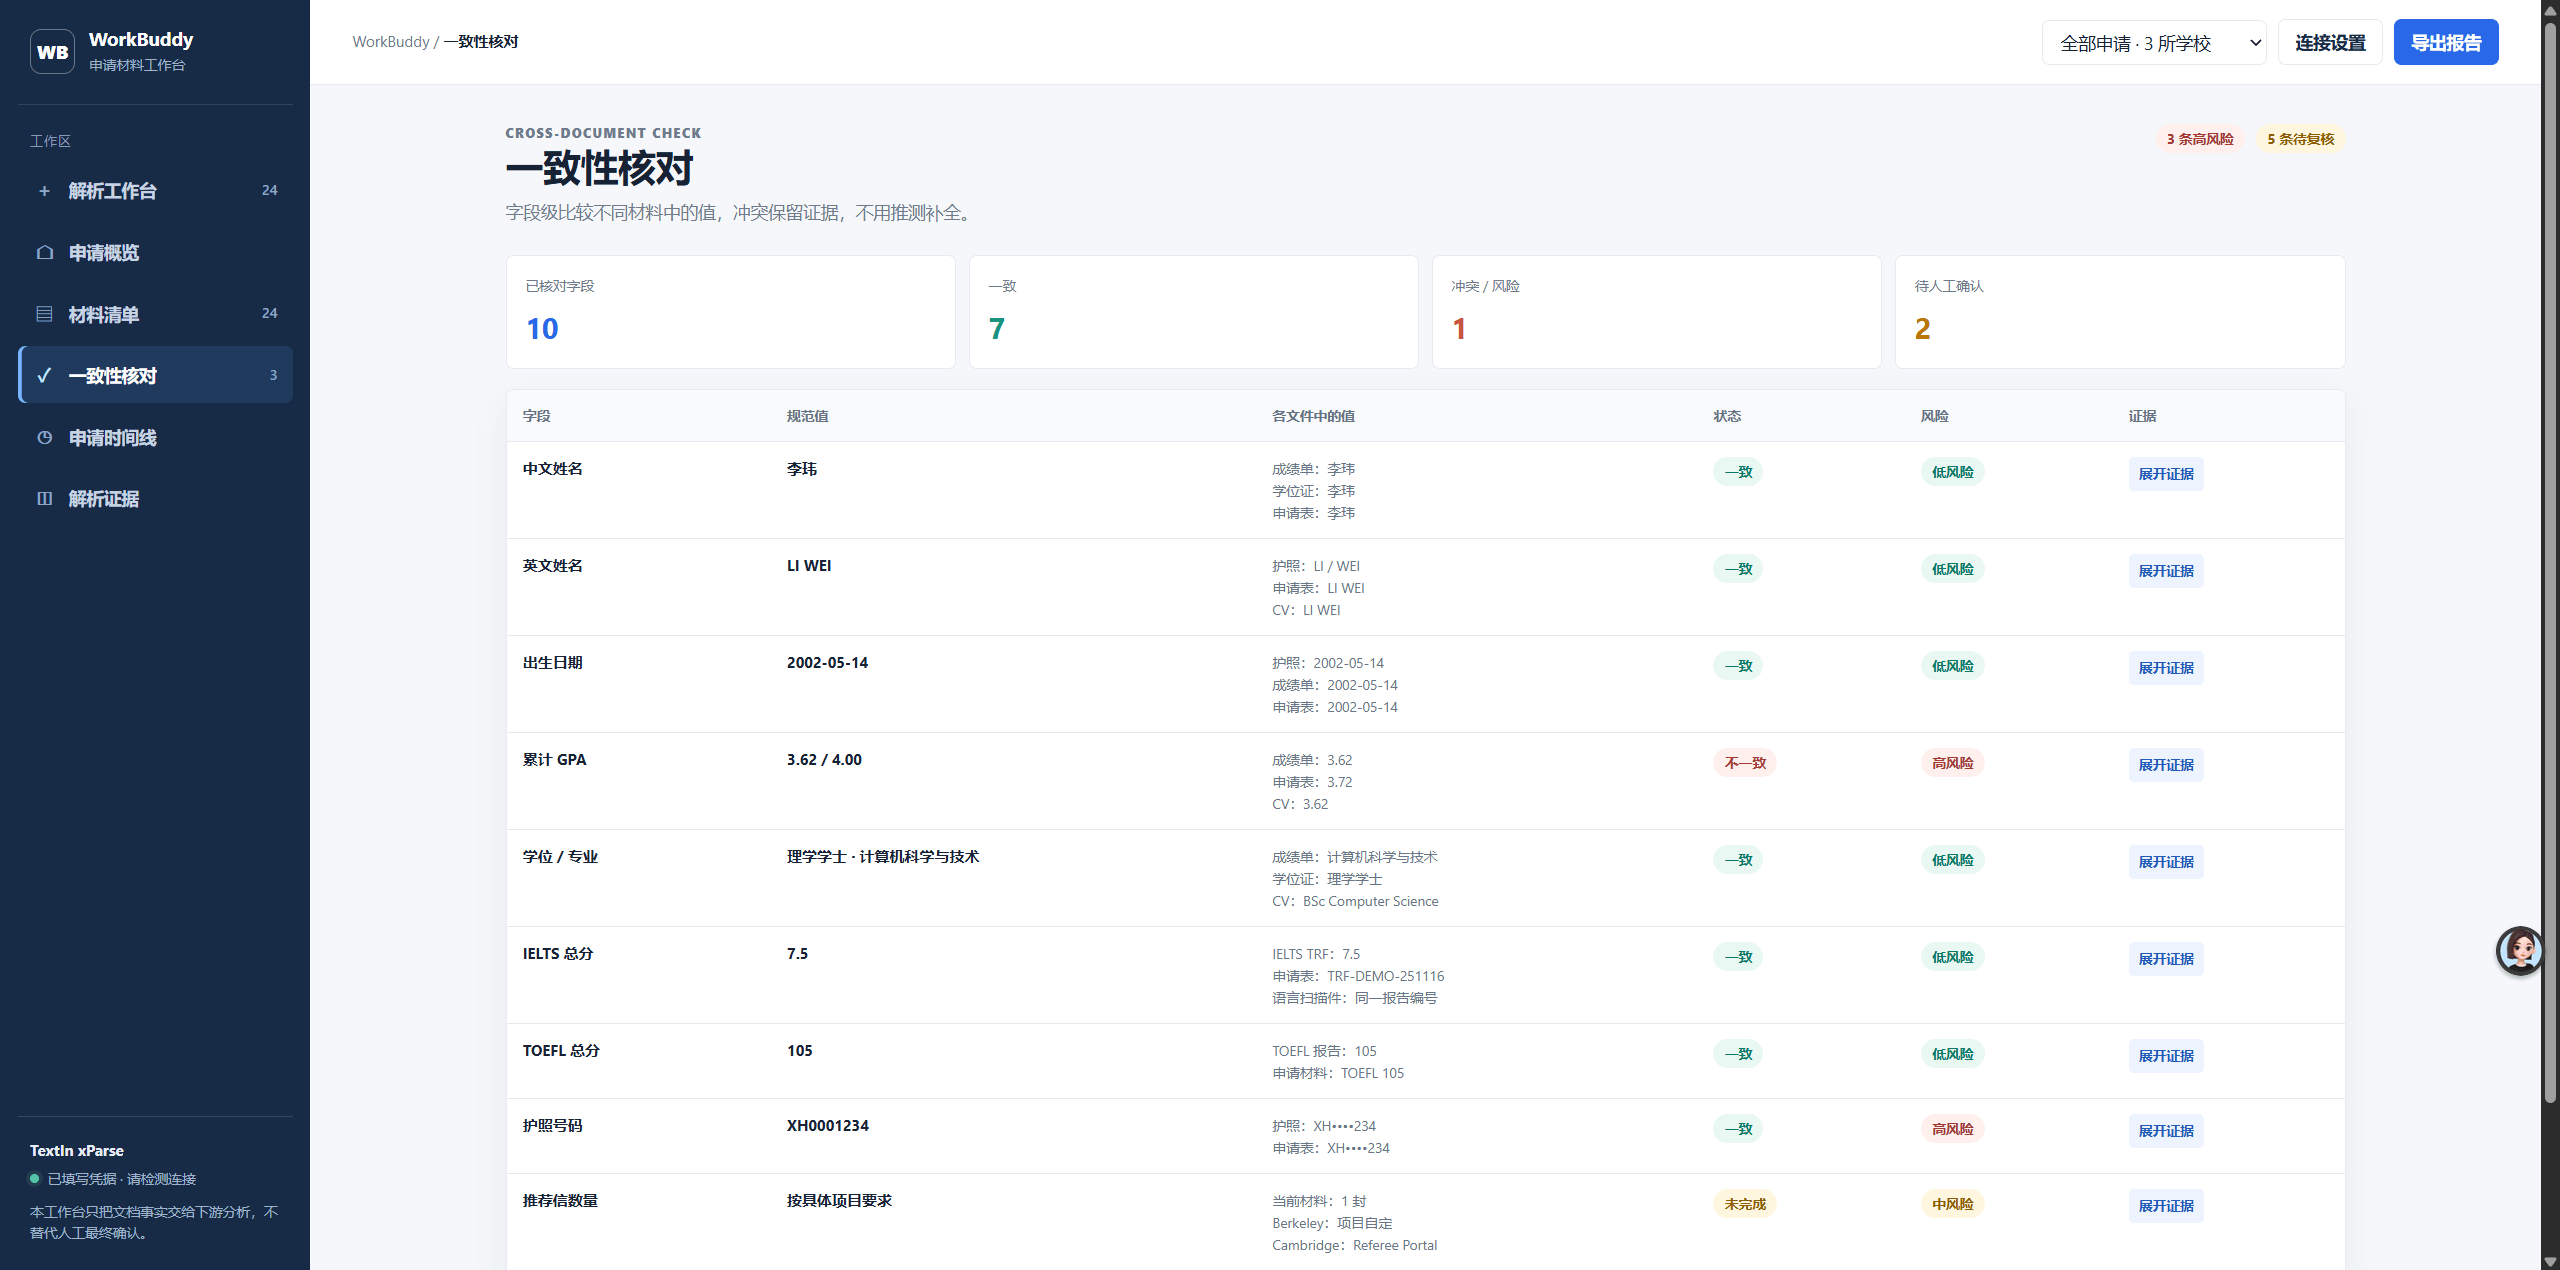
image.png
整个报告最有价值的模块。把同一字段在不同文件中的值全部捞出来对比:字段名、规范值、各文件实际值、一致性判定、风险等级、操作建议,六列清清楚楚。
以 GPA 为例:成绩单 3.62,申请表填了 3.72,CV 写 3.62。系统判定"不一致"、风险"高"、建议"立即核对修正"。精确到具体数字、具体文件、具体动作,比笼统说"有问题"有用太多。
申请时间线
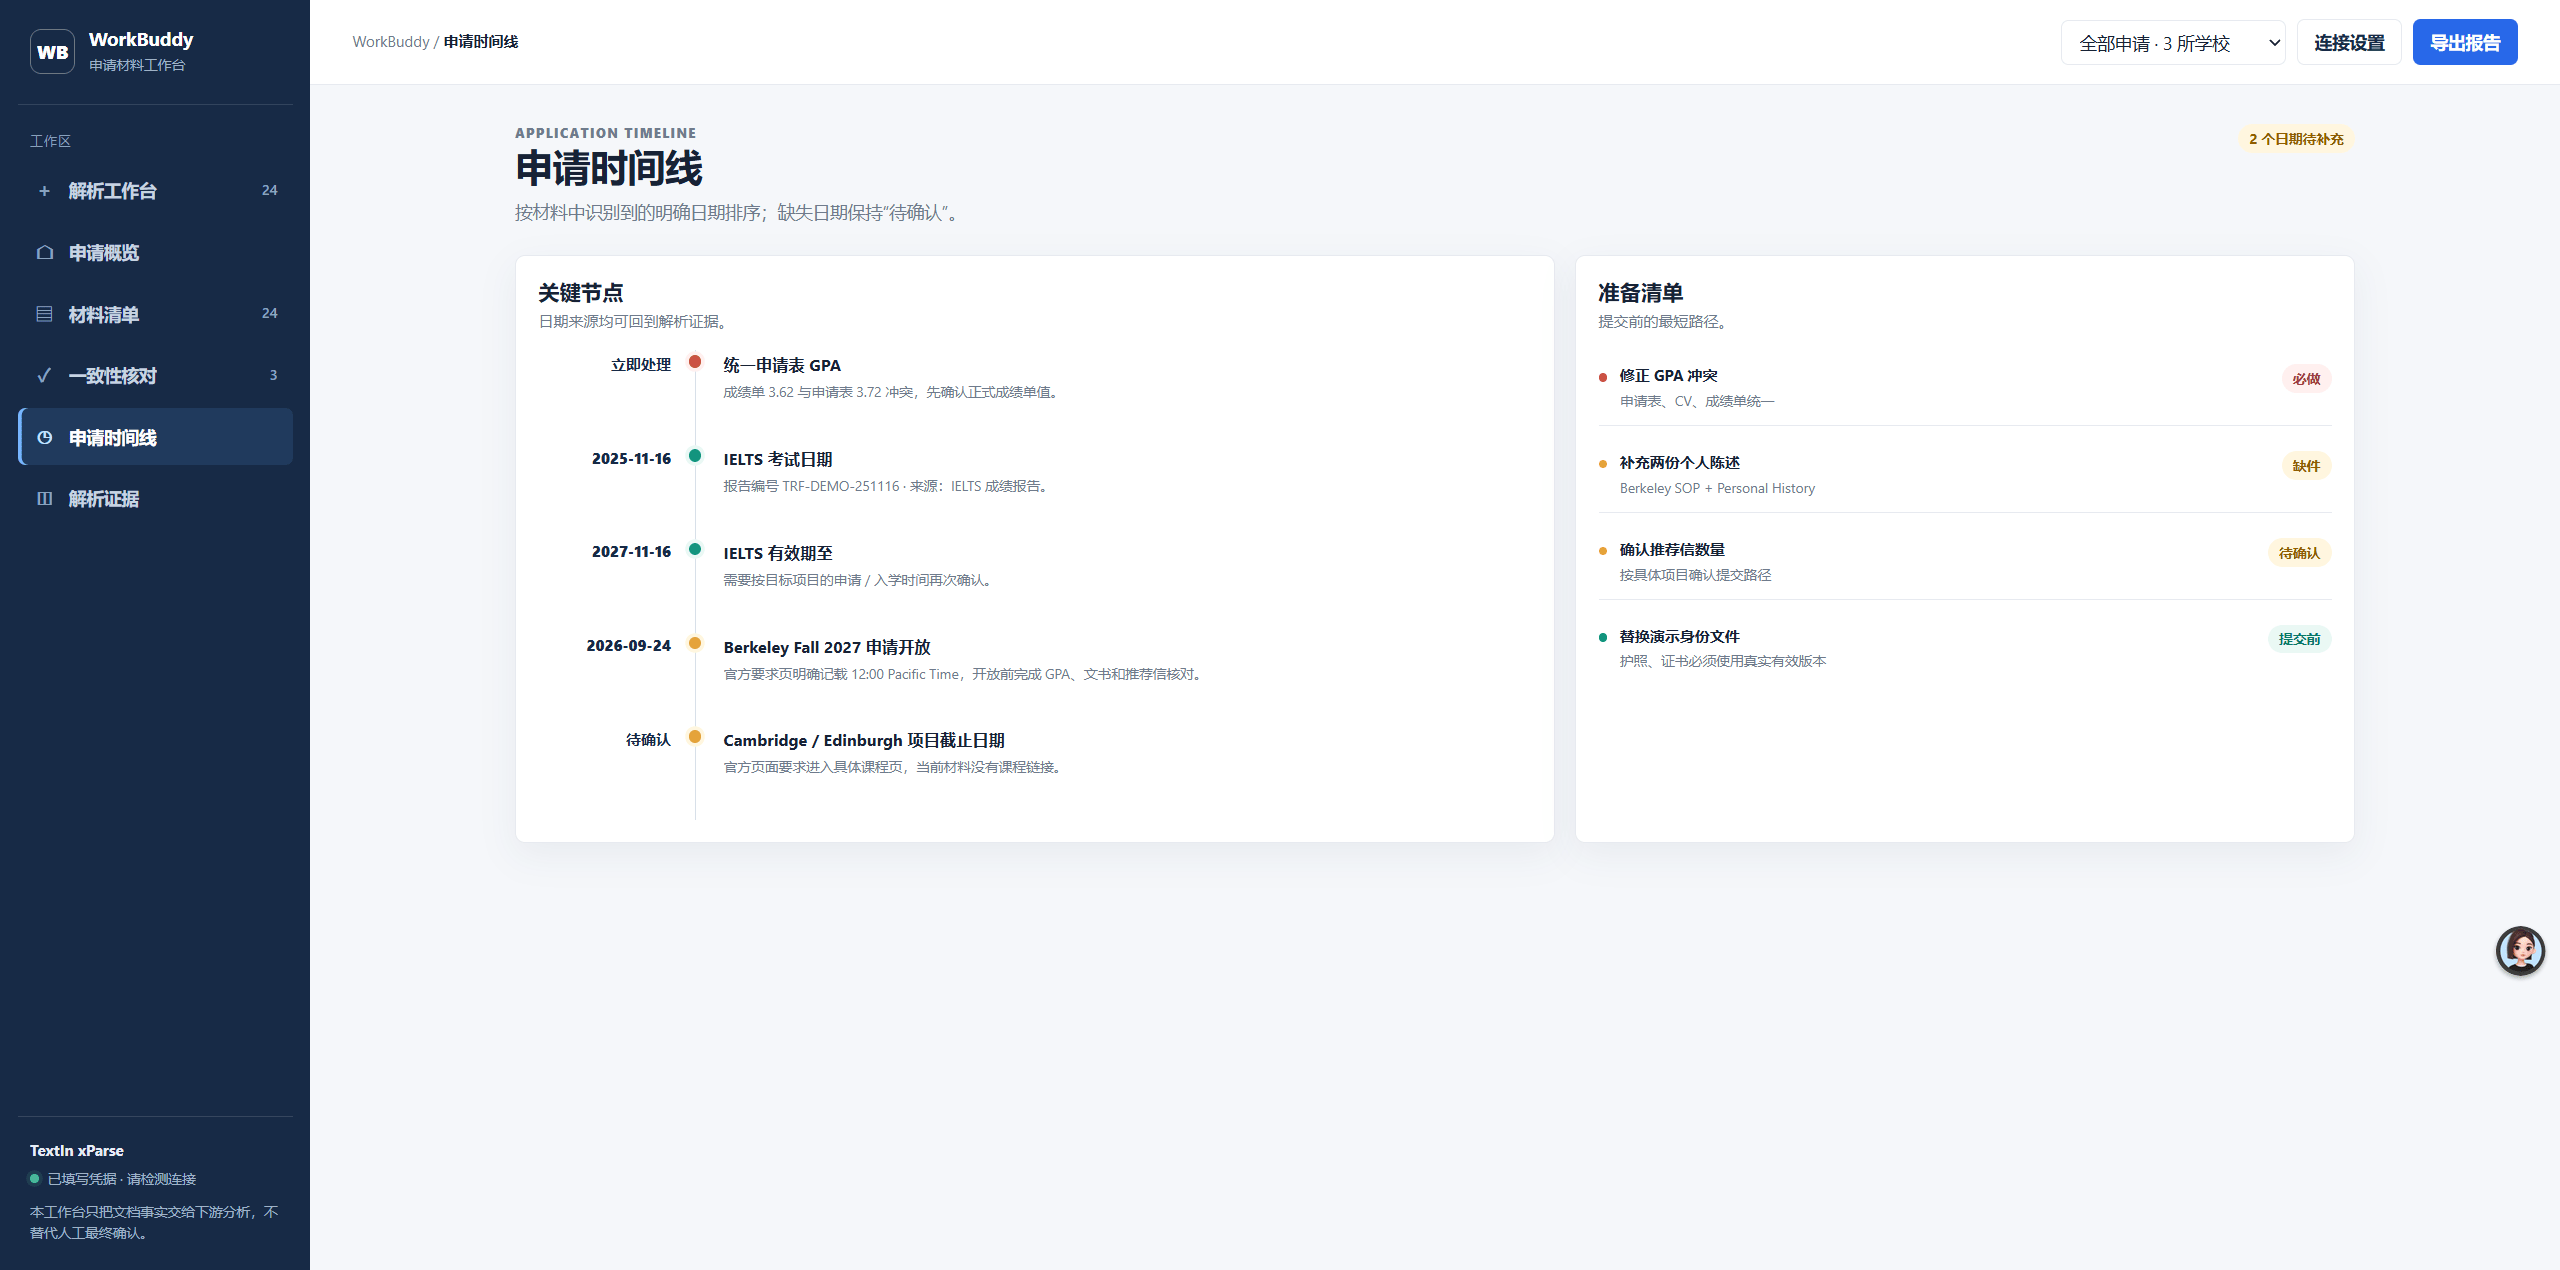
image.png
把所有时间节点串成一条带状态语义的时间轴:已过事件灰色完成并标注结果(IELTS 7.5、GRE 326),即将到来蓝色倒计时(某校截止还有21天),逾期未处理红色警告。
每个节点可展开查看关联材料、待完成动作、逾期后果。同时申多所学校时,帮你全局把控节奏,不会漏掉关键日期。
解析证据
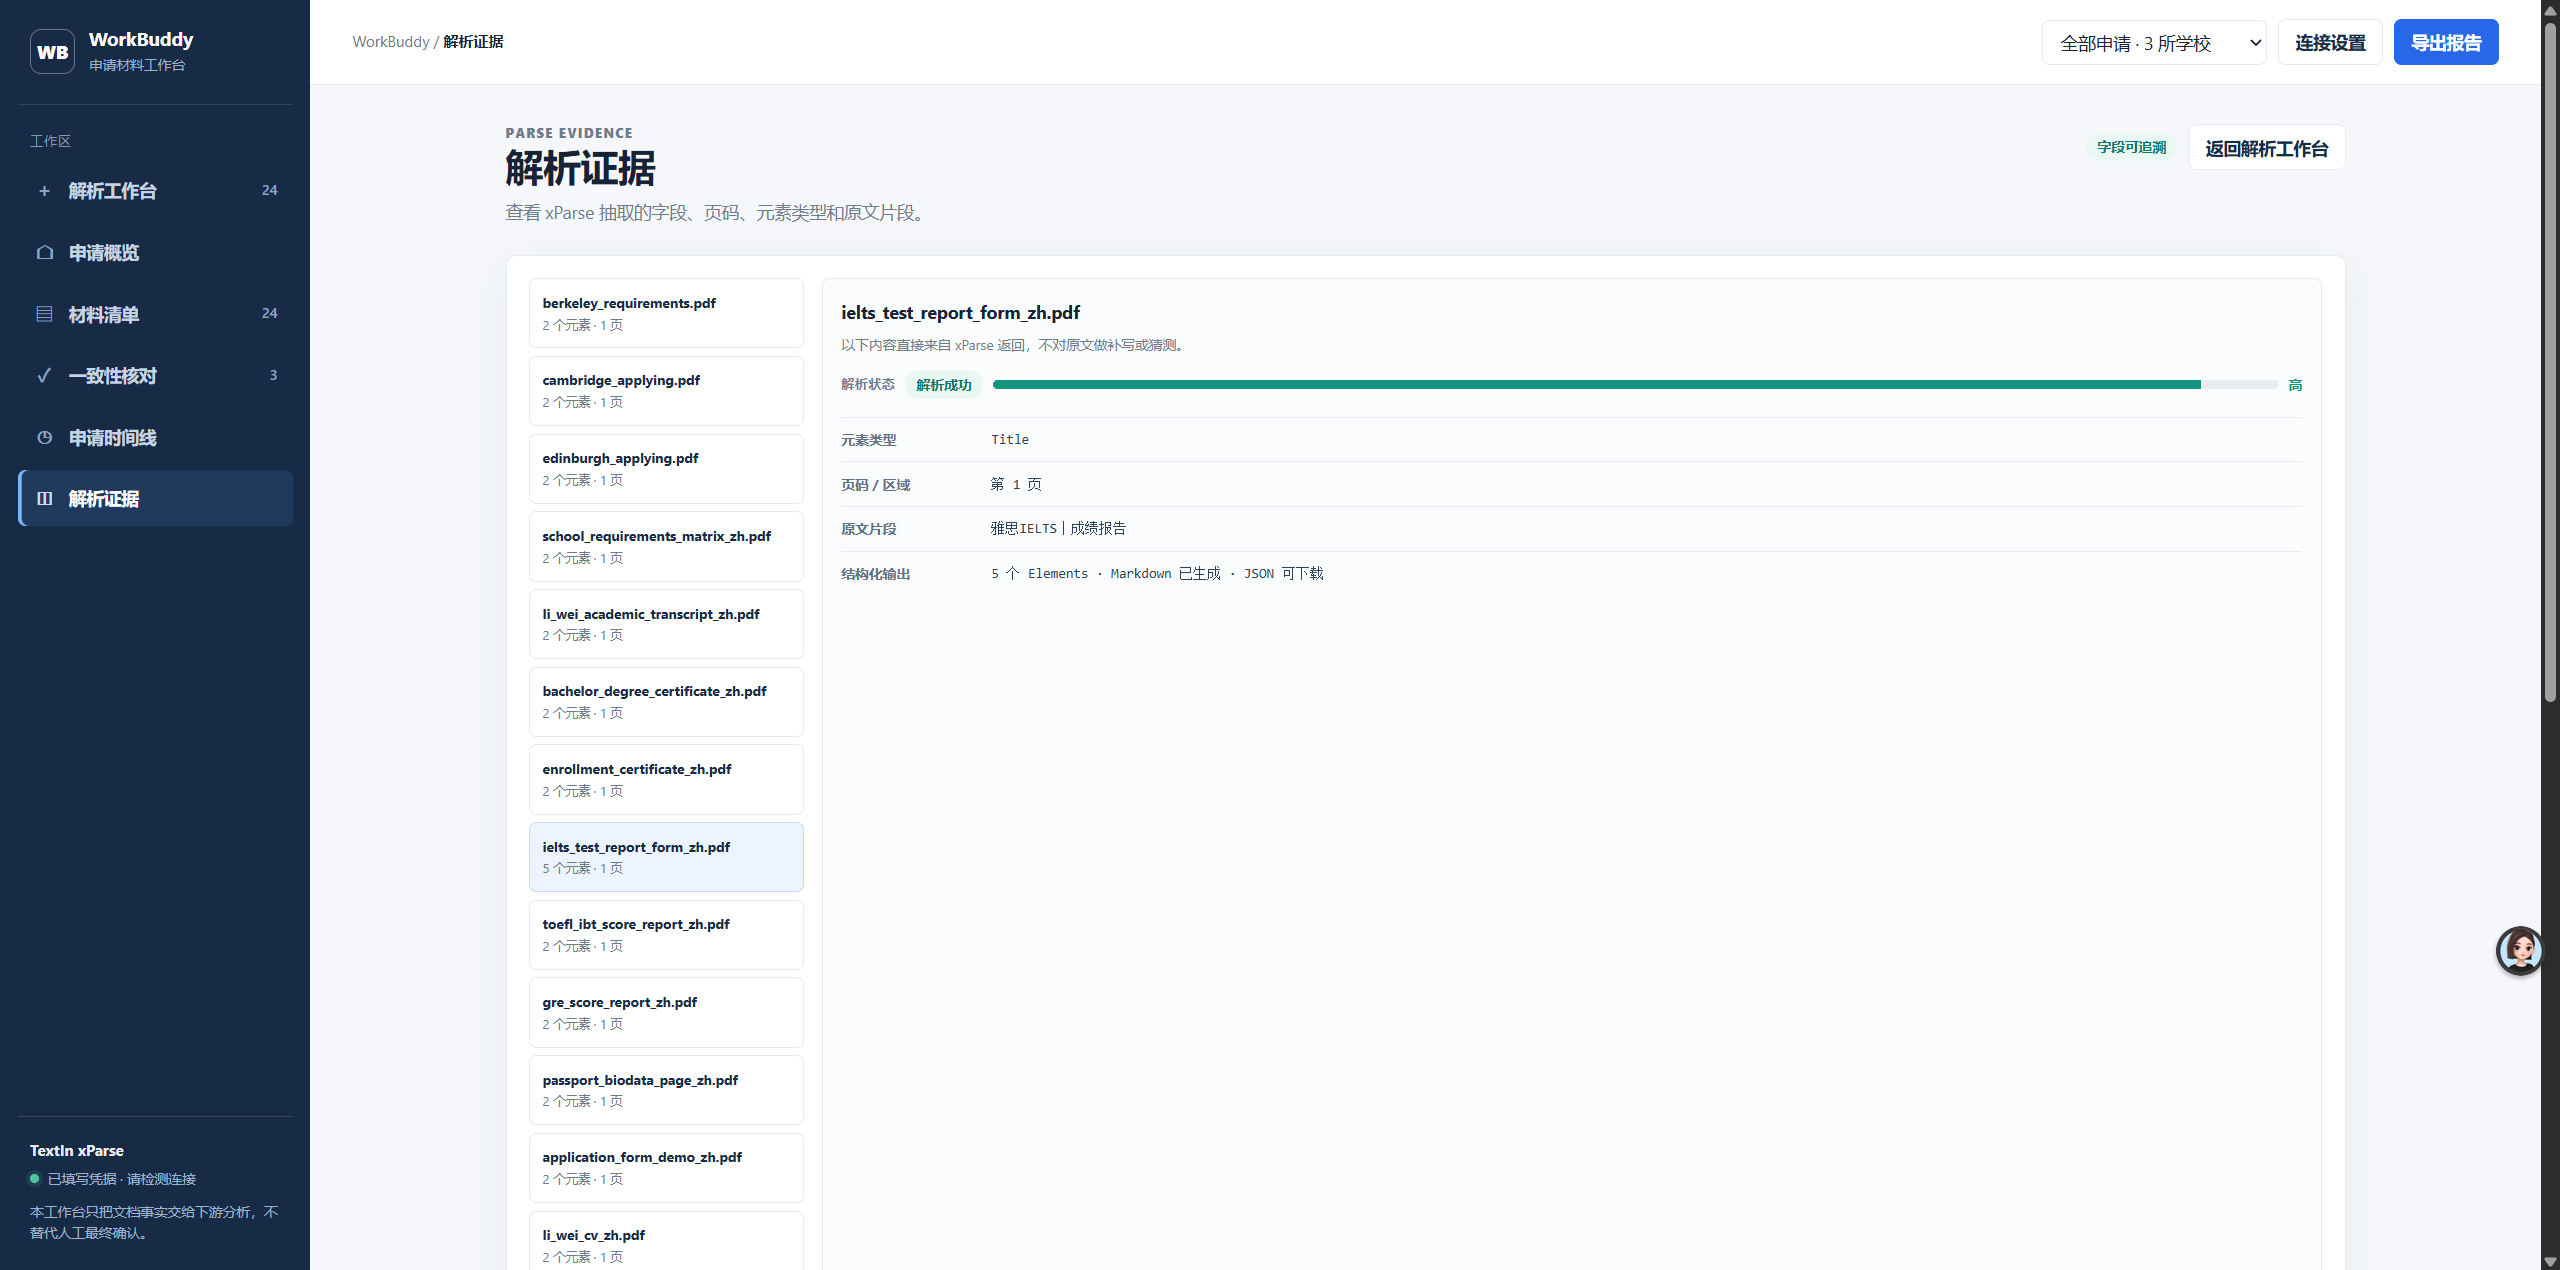
image.png
整个系统的审计追踪层。前面所有结论都能在这里找到源头证据——七列表格展示:字段名、提取结果、来源文件、页码区域、原文片段(灰色证据框)、置信度、解析状态。
最实用的是冲突状态的并列展示:GPA 3.62(来自成绩单)和 3.72(来自申请表)两条证据放在一起,每条标注来源。一眼看出不是解析错误,而是原始材料本身不一致——接下来要做的不是质疑工具,而是修正材料。
解析结果原文对照
除了工作台报告,直接对比原始文档和解析结果。
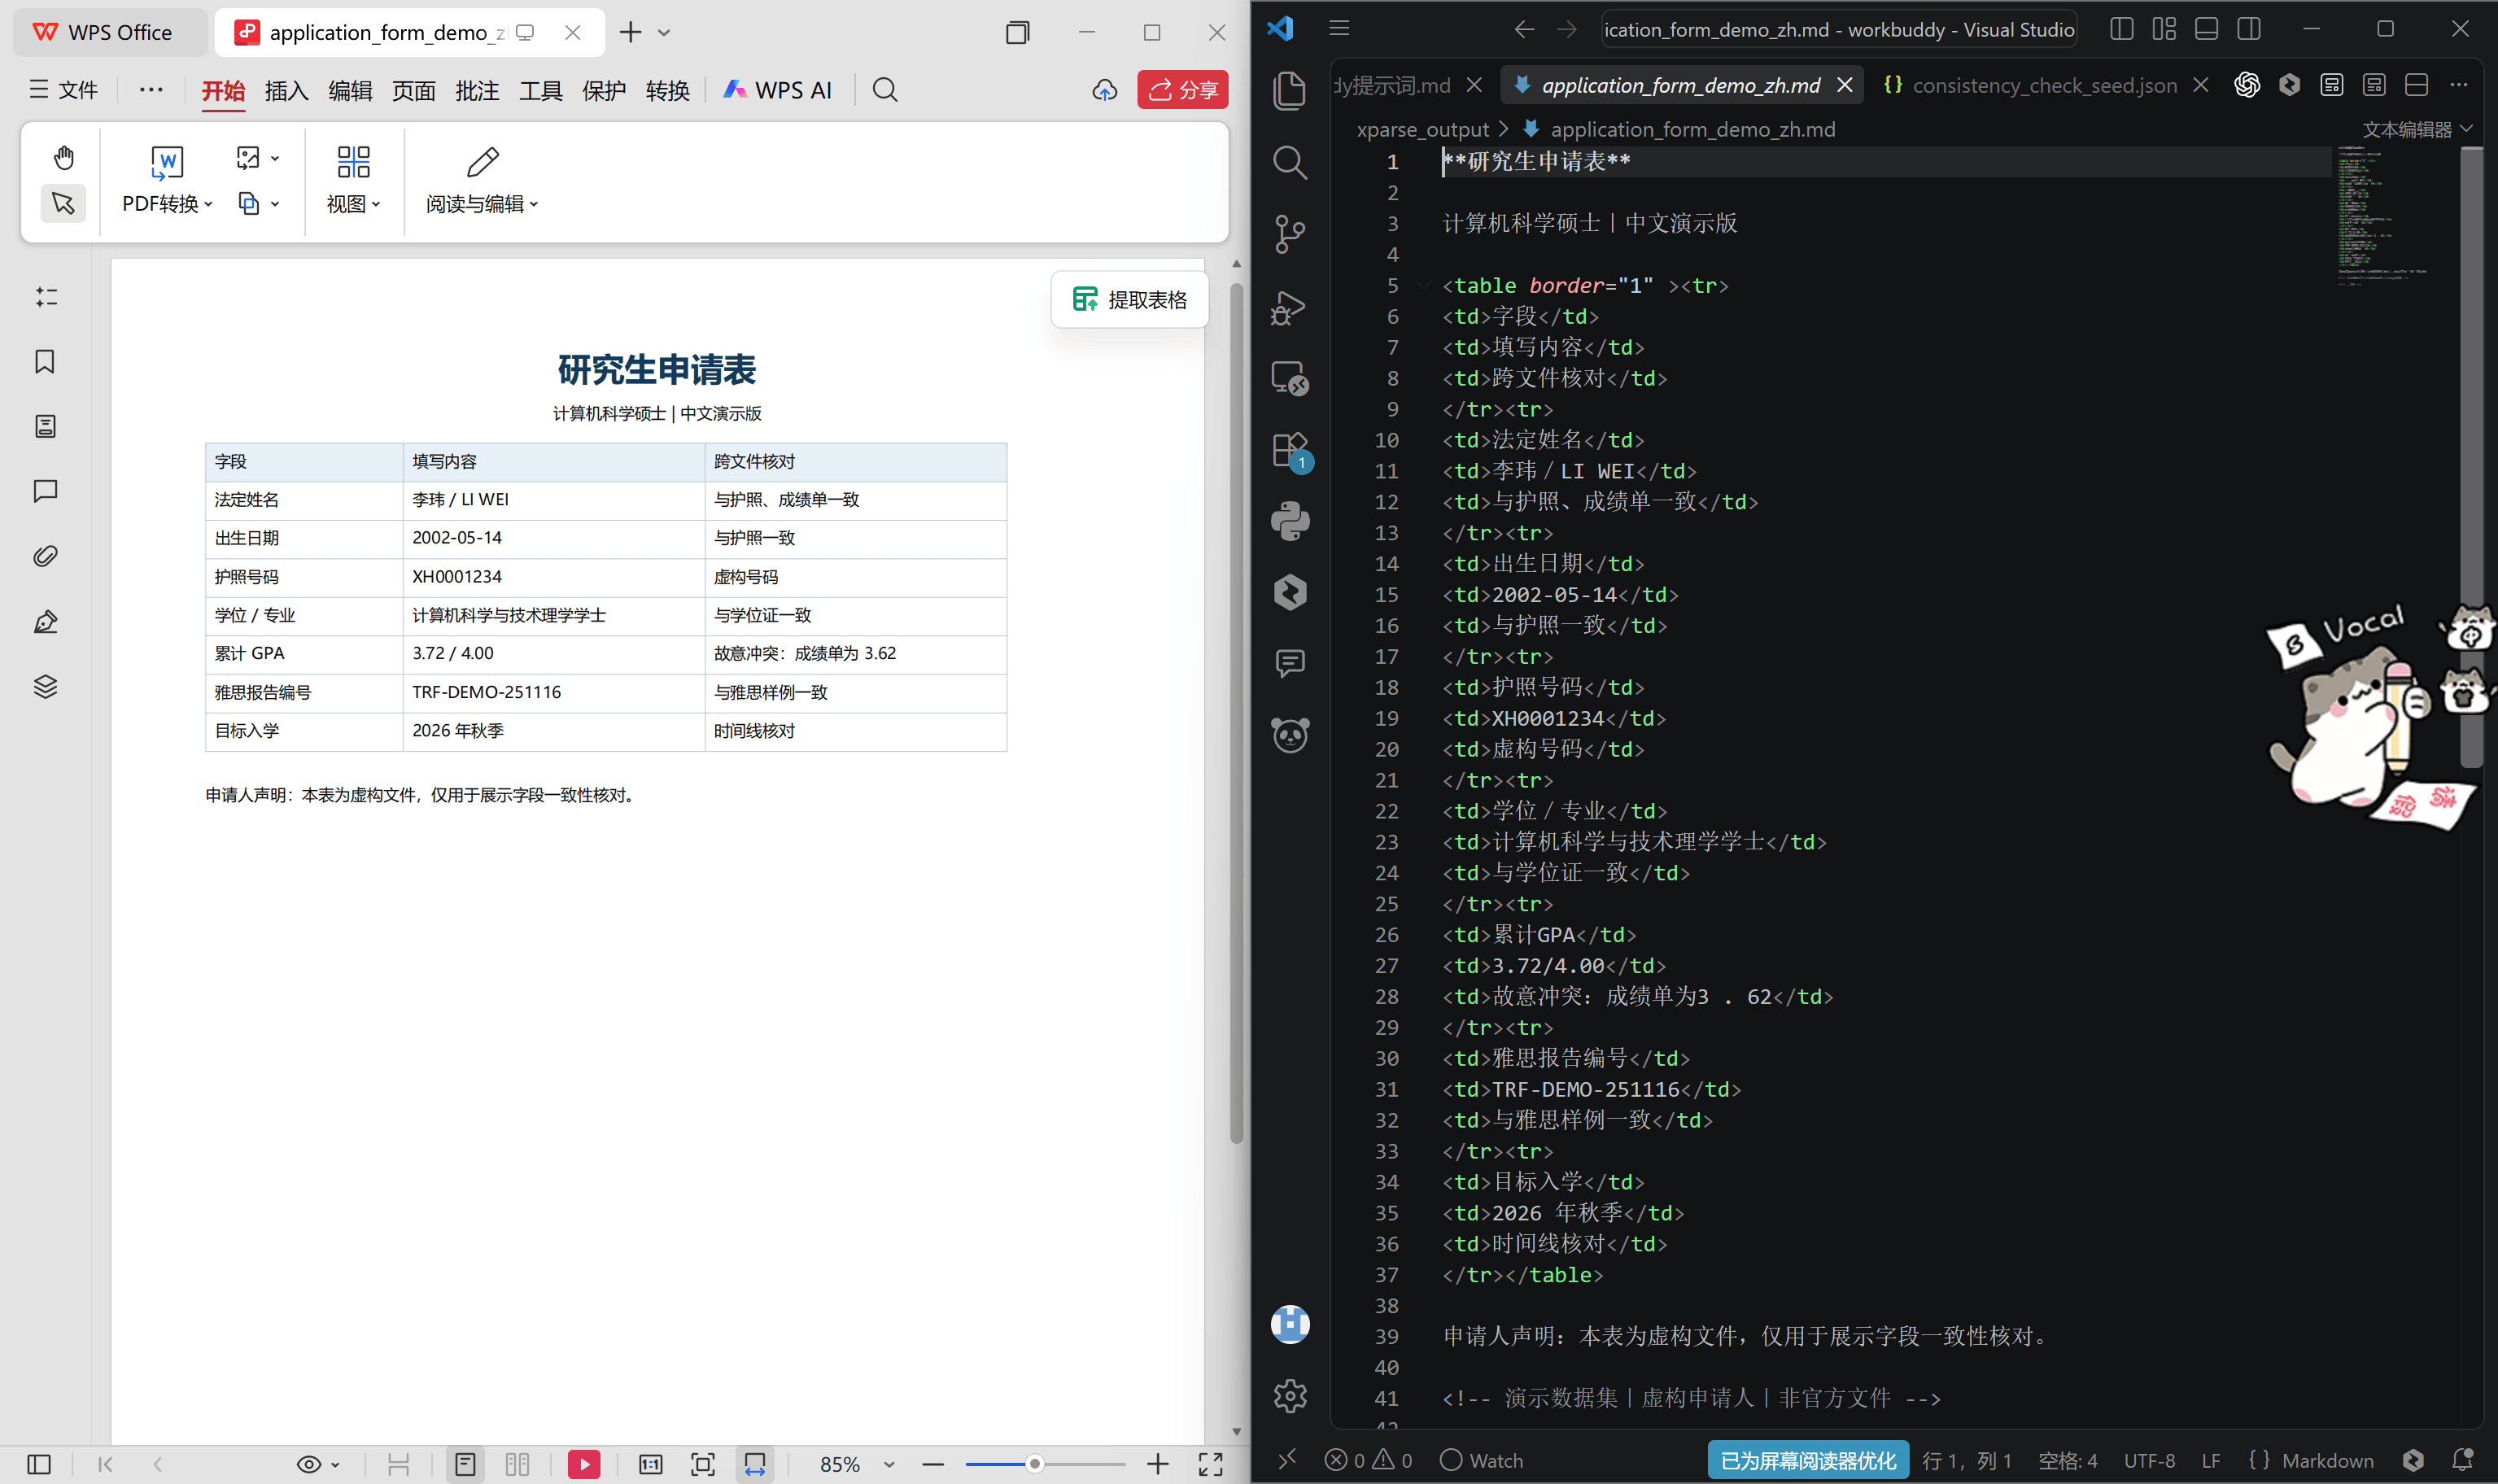
image.png
左侧是原始的研究生申请表扫描件,右侧是 xParse 解析出来的结构化数据。姓名、性别、出生日期、联系方式、教育背景、工作经历……每个字段都被准确提取,一一对应。
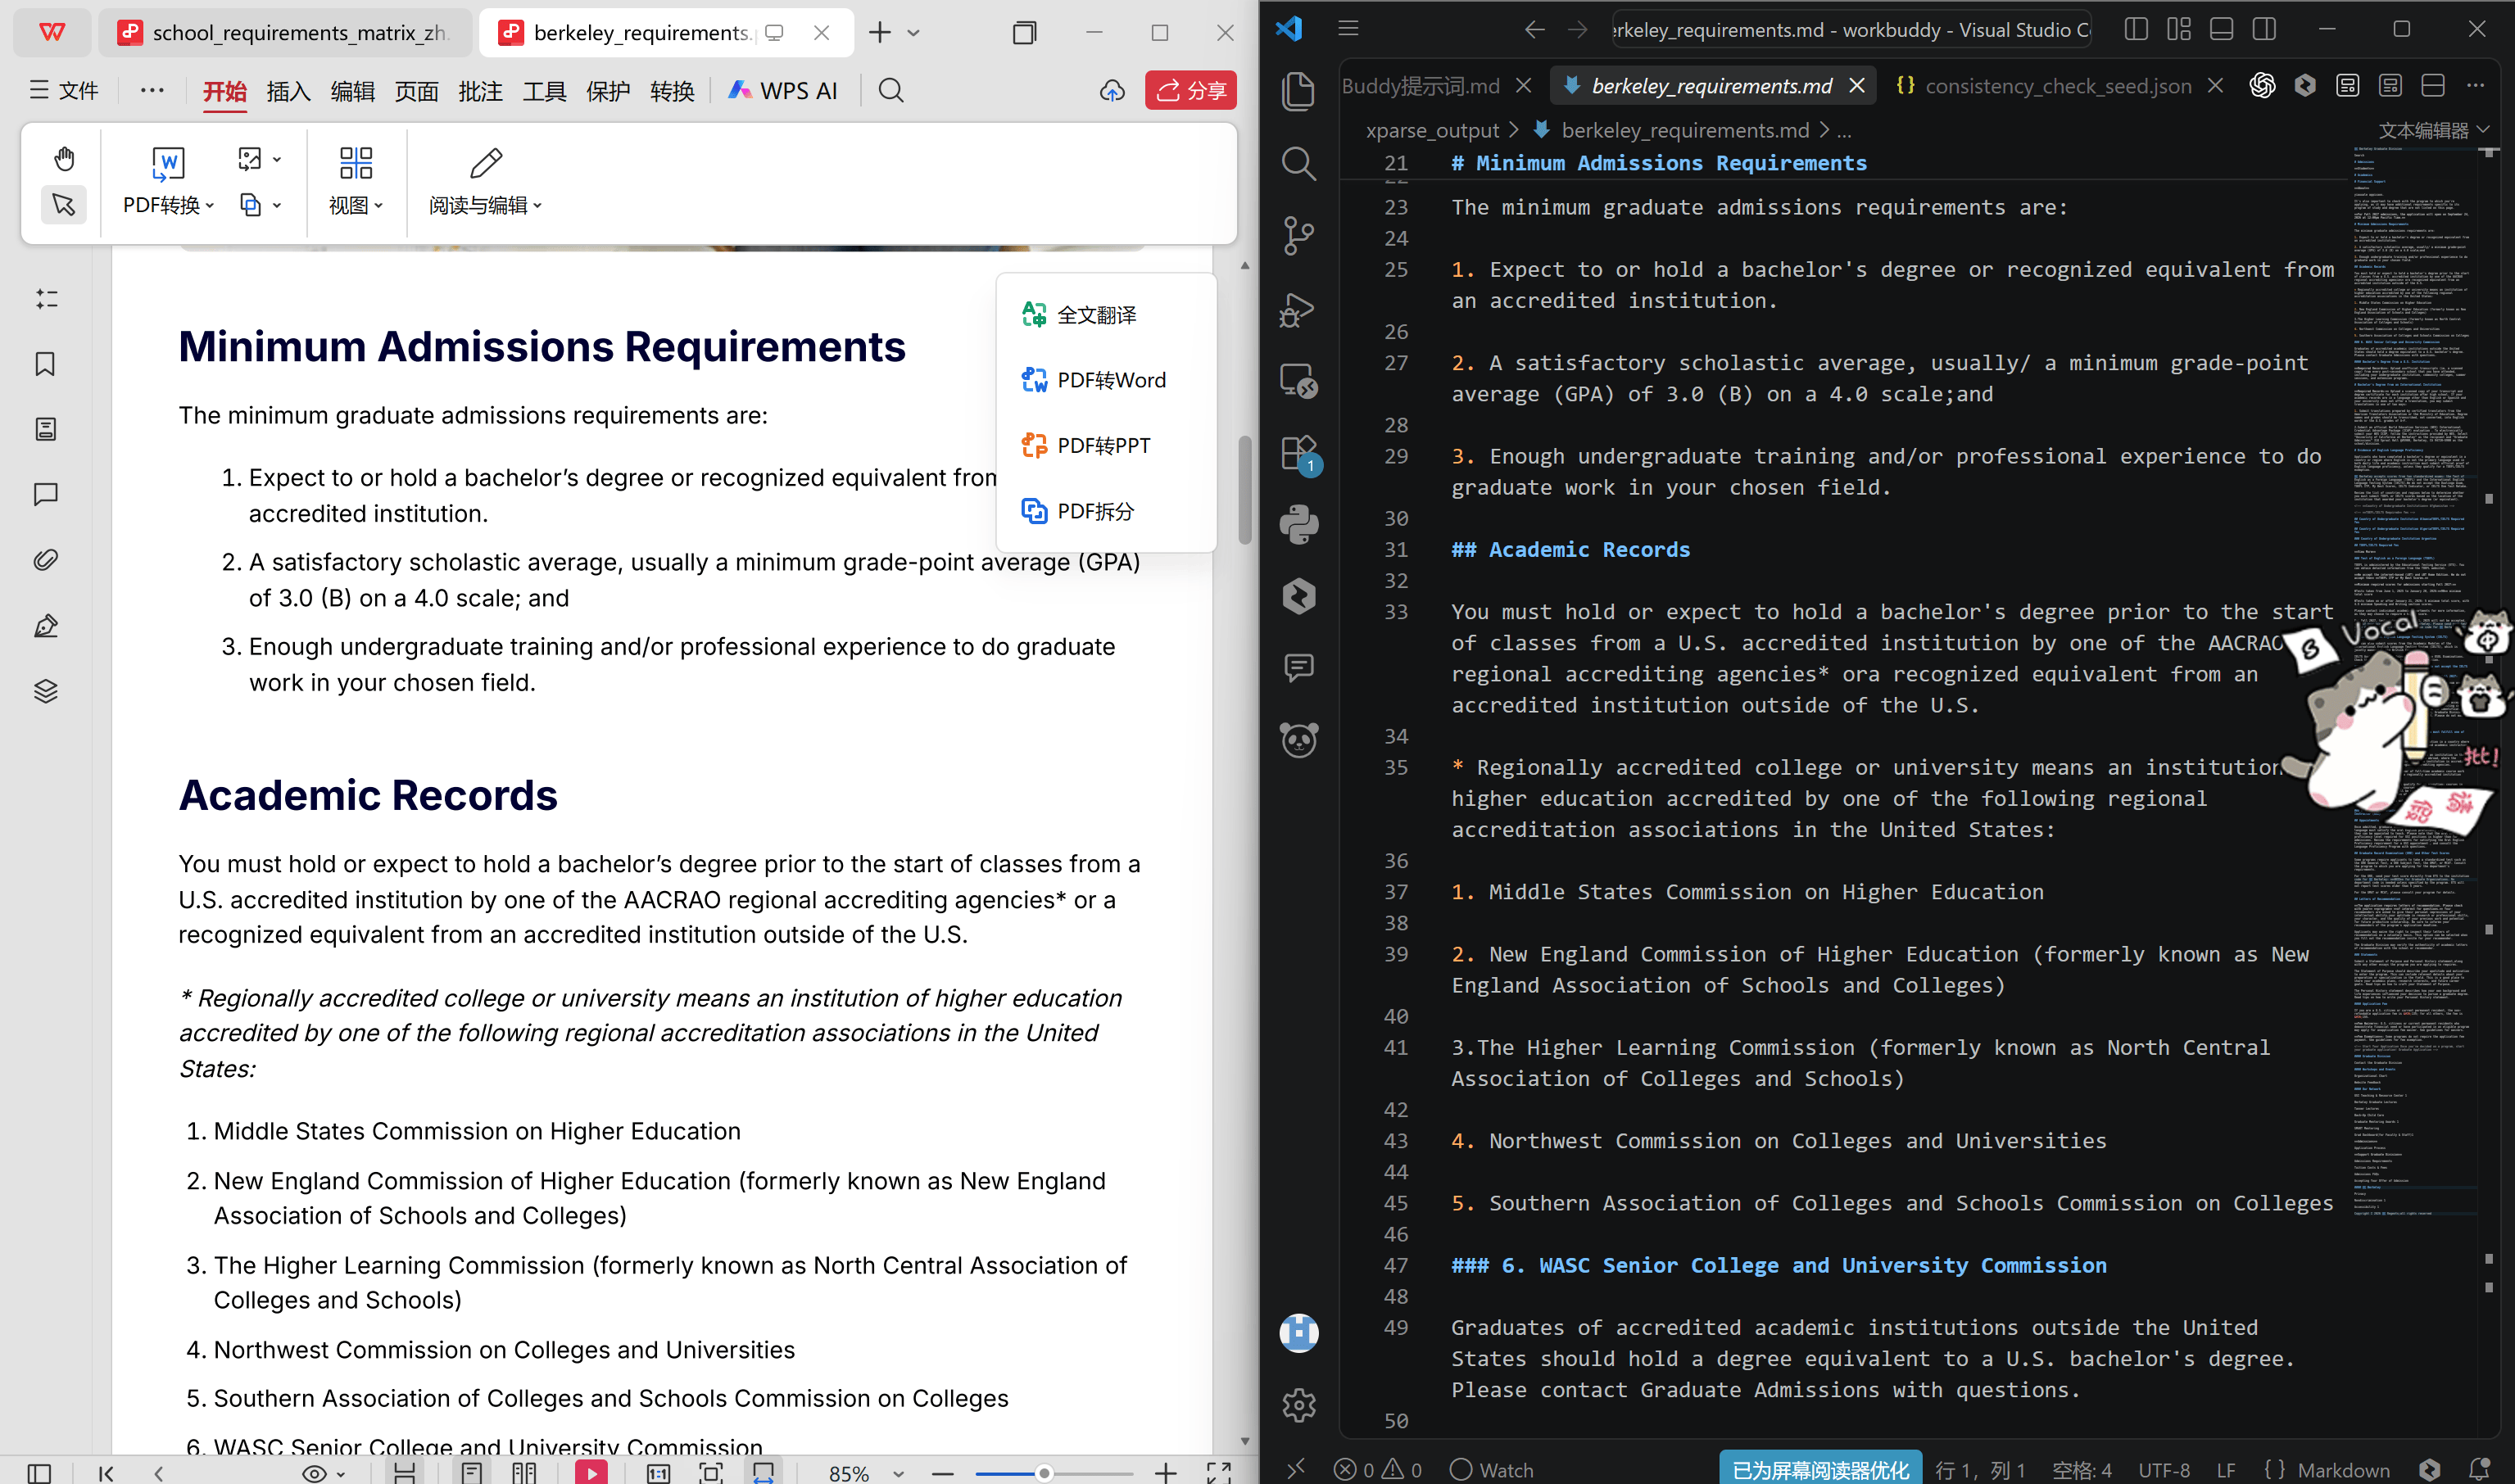
image.png
再看英文文档的例子——伯克利大学的申请要求 PDF,里面有大量文字、表格、列表,格式很复杂。右边解析结果保留了所有段落结构,表格正确转化为 Markdown 格式,脚注和补充说明也没遗漏。中英文处理能力都很强,合并单元格、跨页表格都能正确处理。
我是怎么搭出来的
看完效果,来说说具体怎么做的。整个搭建过程用到的工具就两个:WorkBuddy 和 TextIn xParse。
先说下 TextIn xParse 是什么
在开始之前,先科普一下这个工具。
TextIn xParse 是合合信息旗下面向 LLM 与 Agent 的文档智能基础设施。
说白了,它不直接给你答案,而是把各种复杂文档——PDF、图片、Word、Excel、PPT、扫描件——转化成干净、结构化的数据,让 AI 能准确读取和使用。
你可以把它理解成 AI 工作的数据底座。AI 要处理文档,也得先把文档"翻译"成它能懂的结构化数据。xParse 干的就是这个事。
通过workbuddy平台每天能免费调用1000页的额度
第一步:下载安装 WorkBuddy
首先去下载 WorkBuddy,这是我们要用的 AI 工具平台。页面长下面这样,直接下载安装包就行。
image.png
安装好之后打开软件,界面很干净,左侧有一排功能菜单栏,包括对话、专家、技能、连接器这些入口。我们要找的连接器功能就在左侧菜单里。
第二步:安装 TextIn xParse 连接器
点击左侧的 专家 → 技能 → 连接器,进入连接器市场。然后在顶部的搜索栏里输入 "TextIn",回车搜索。
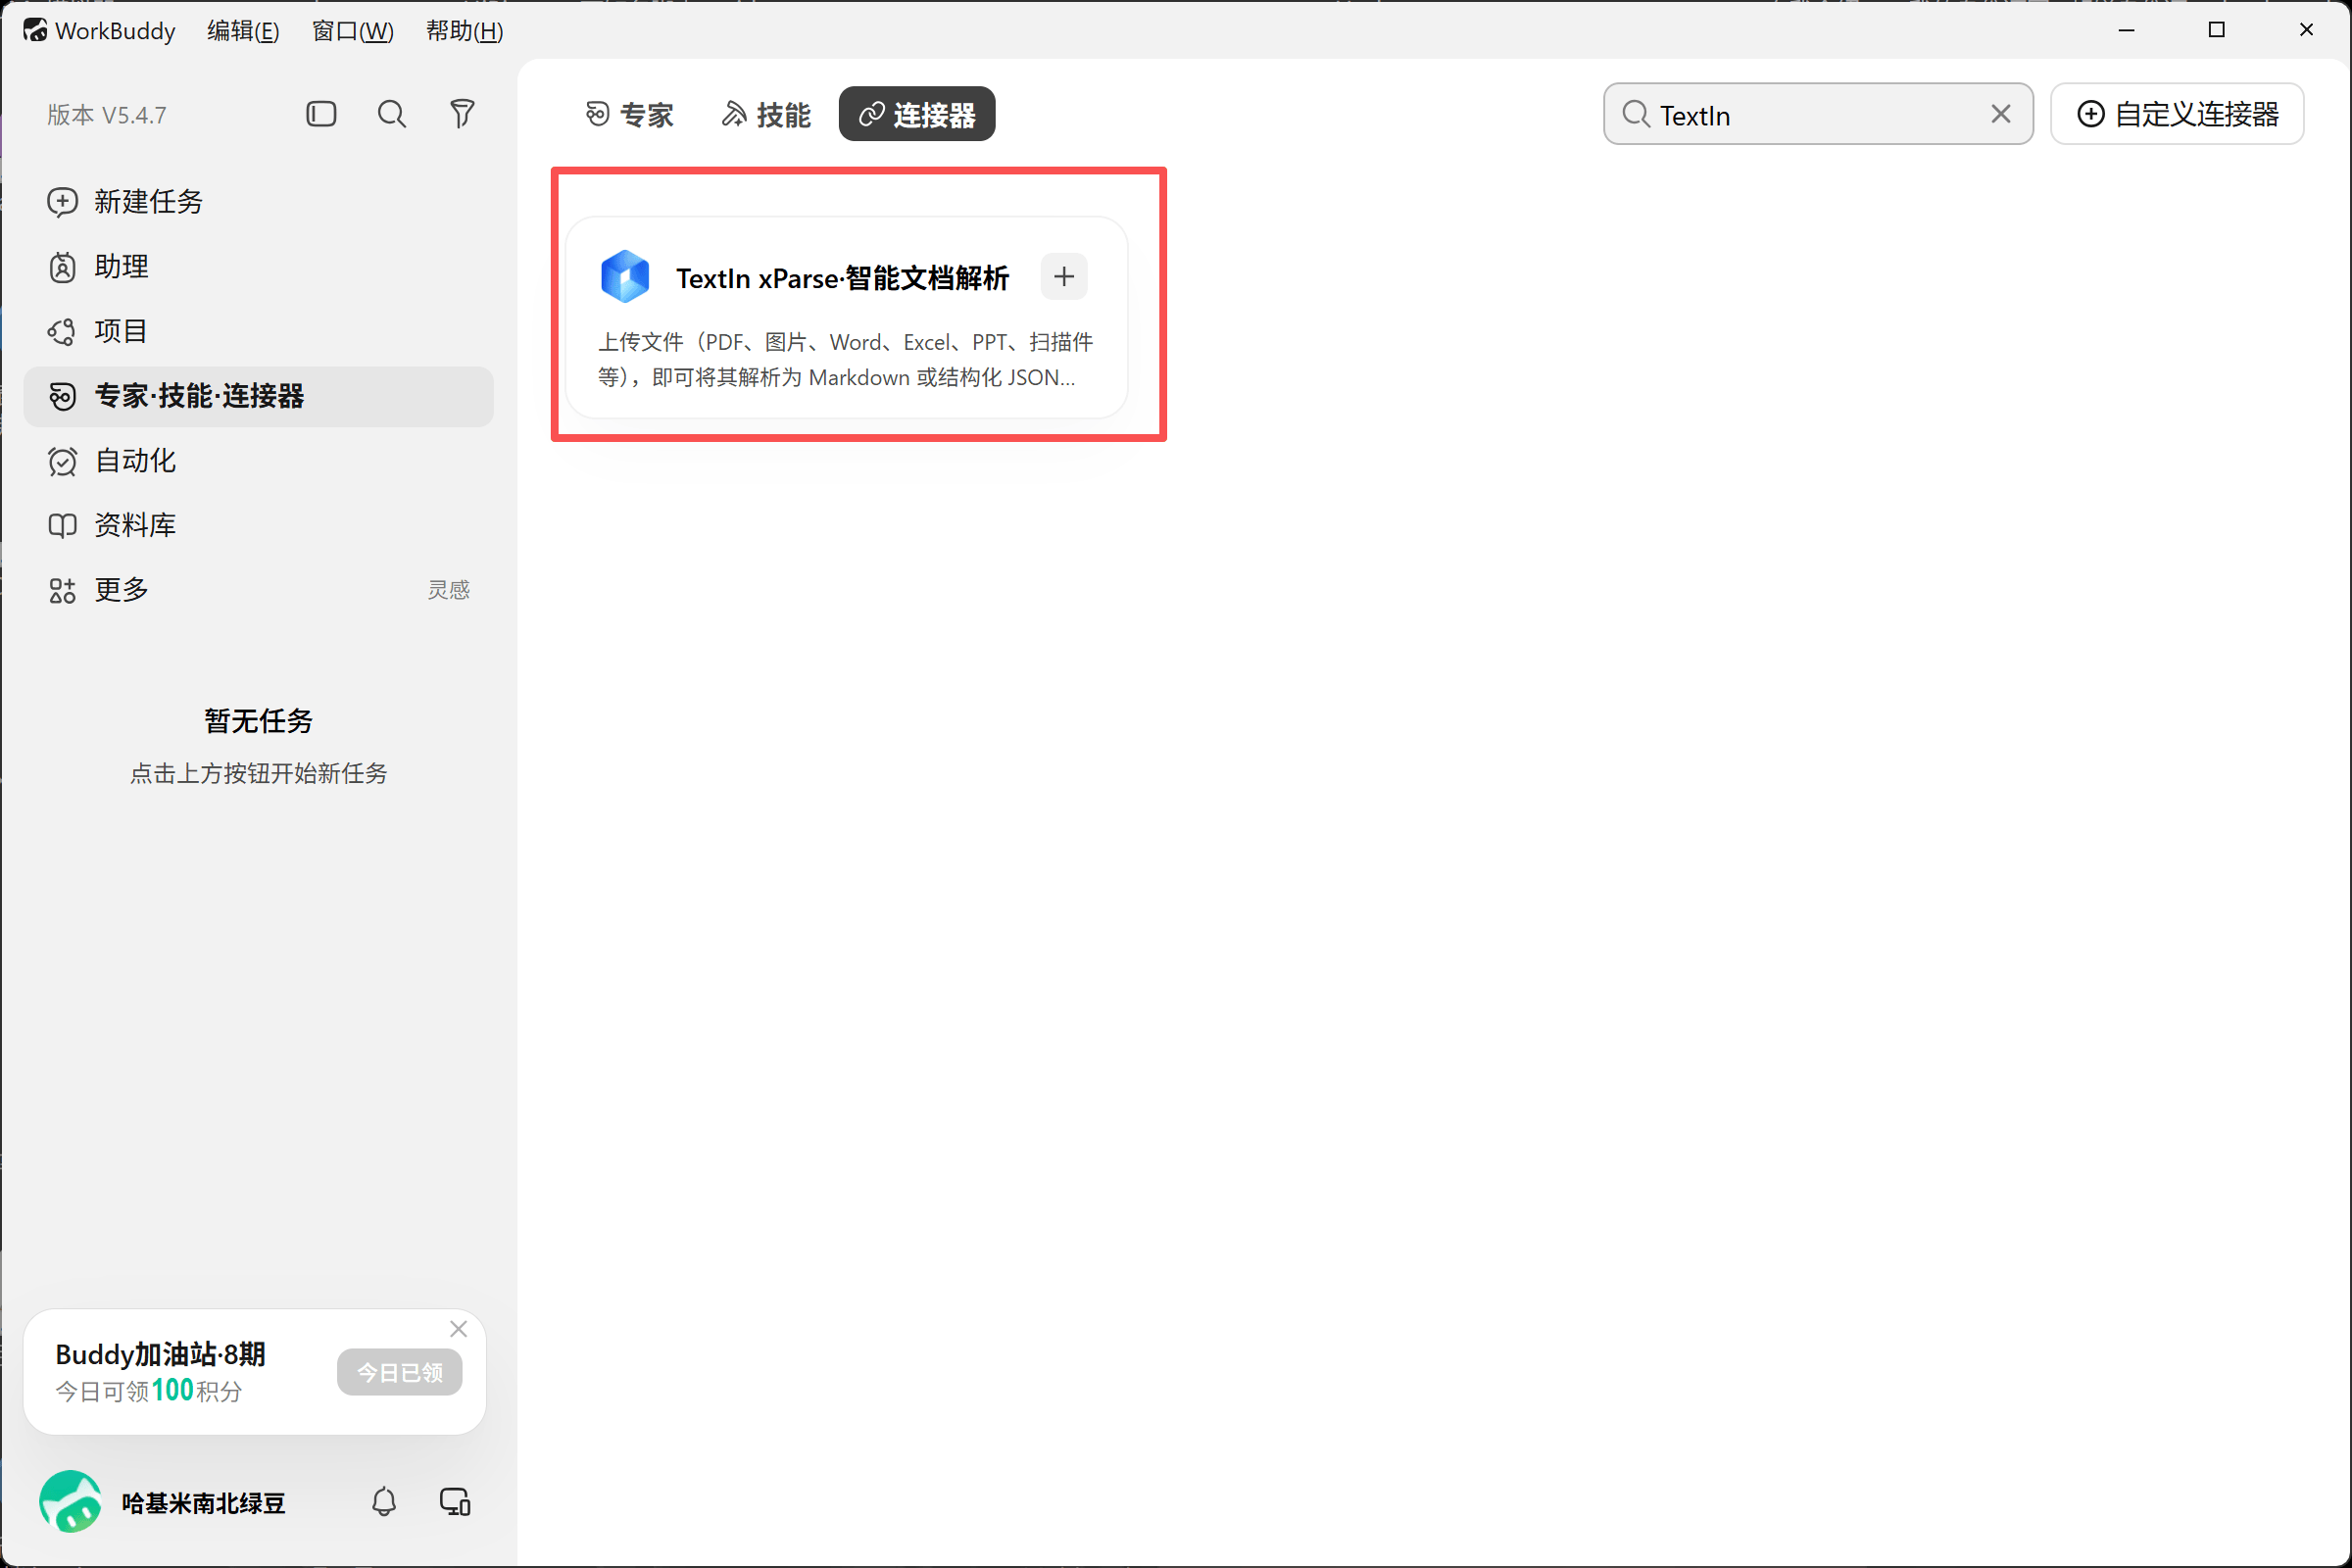
image.png
搜索结果出来后,你能看到 "TextIn xParse 智能文档解析" 这个连接器卡片,上面有连接器的名称、简介和图标。点击右边的 + 号按钮进行安装。
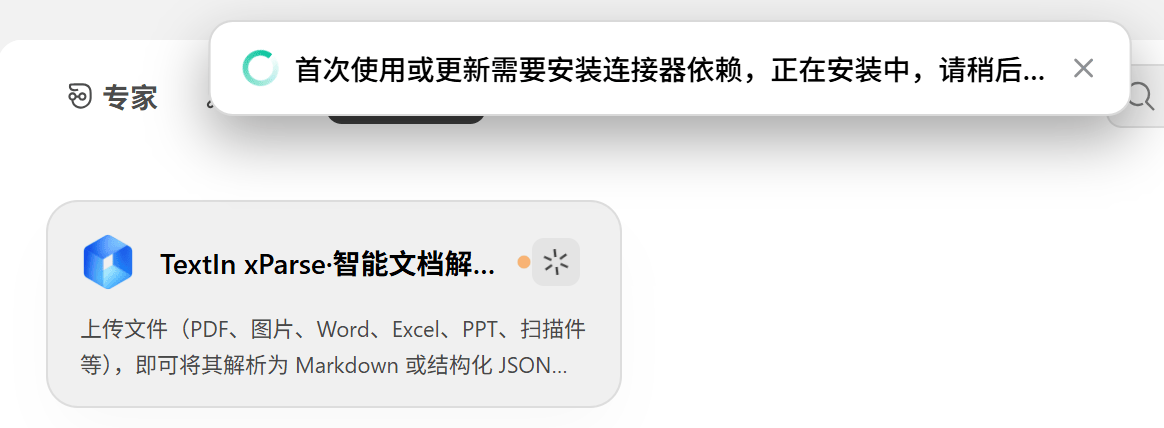
image.png
安装过程需要等一会儿,系统在后台下载和配置连接器组件。装完之后会弹出一个登录窗口,提示你需要登录 TextIn 账号进行授权绑定。
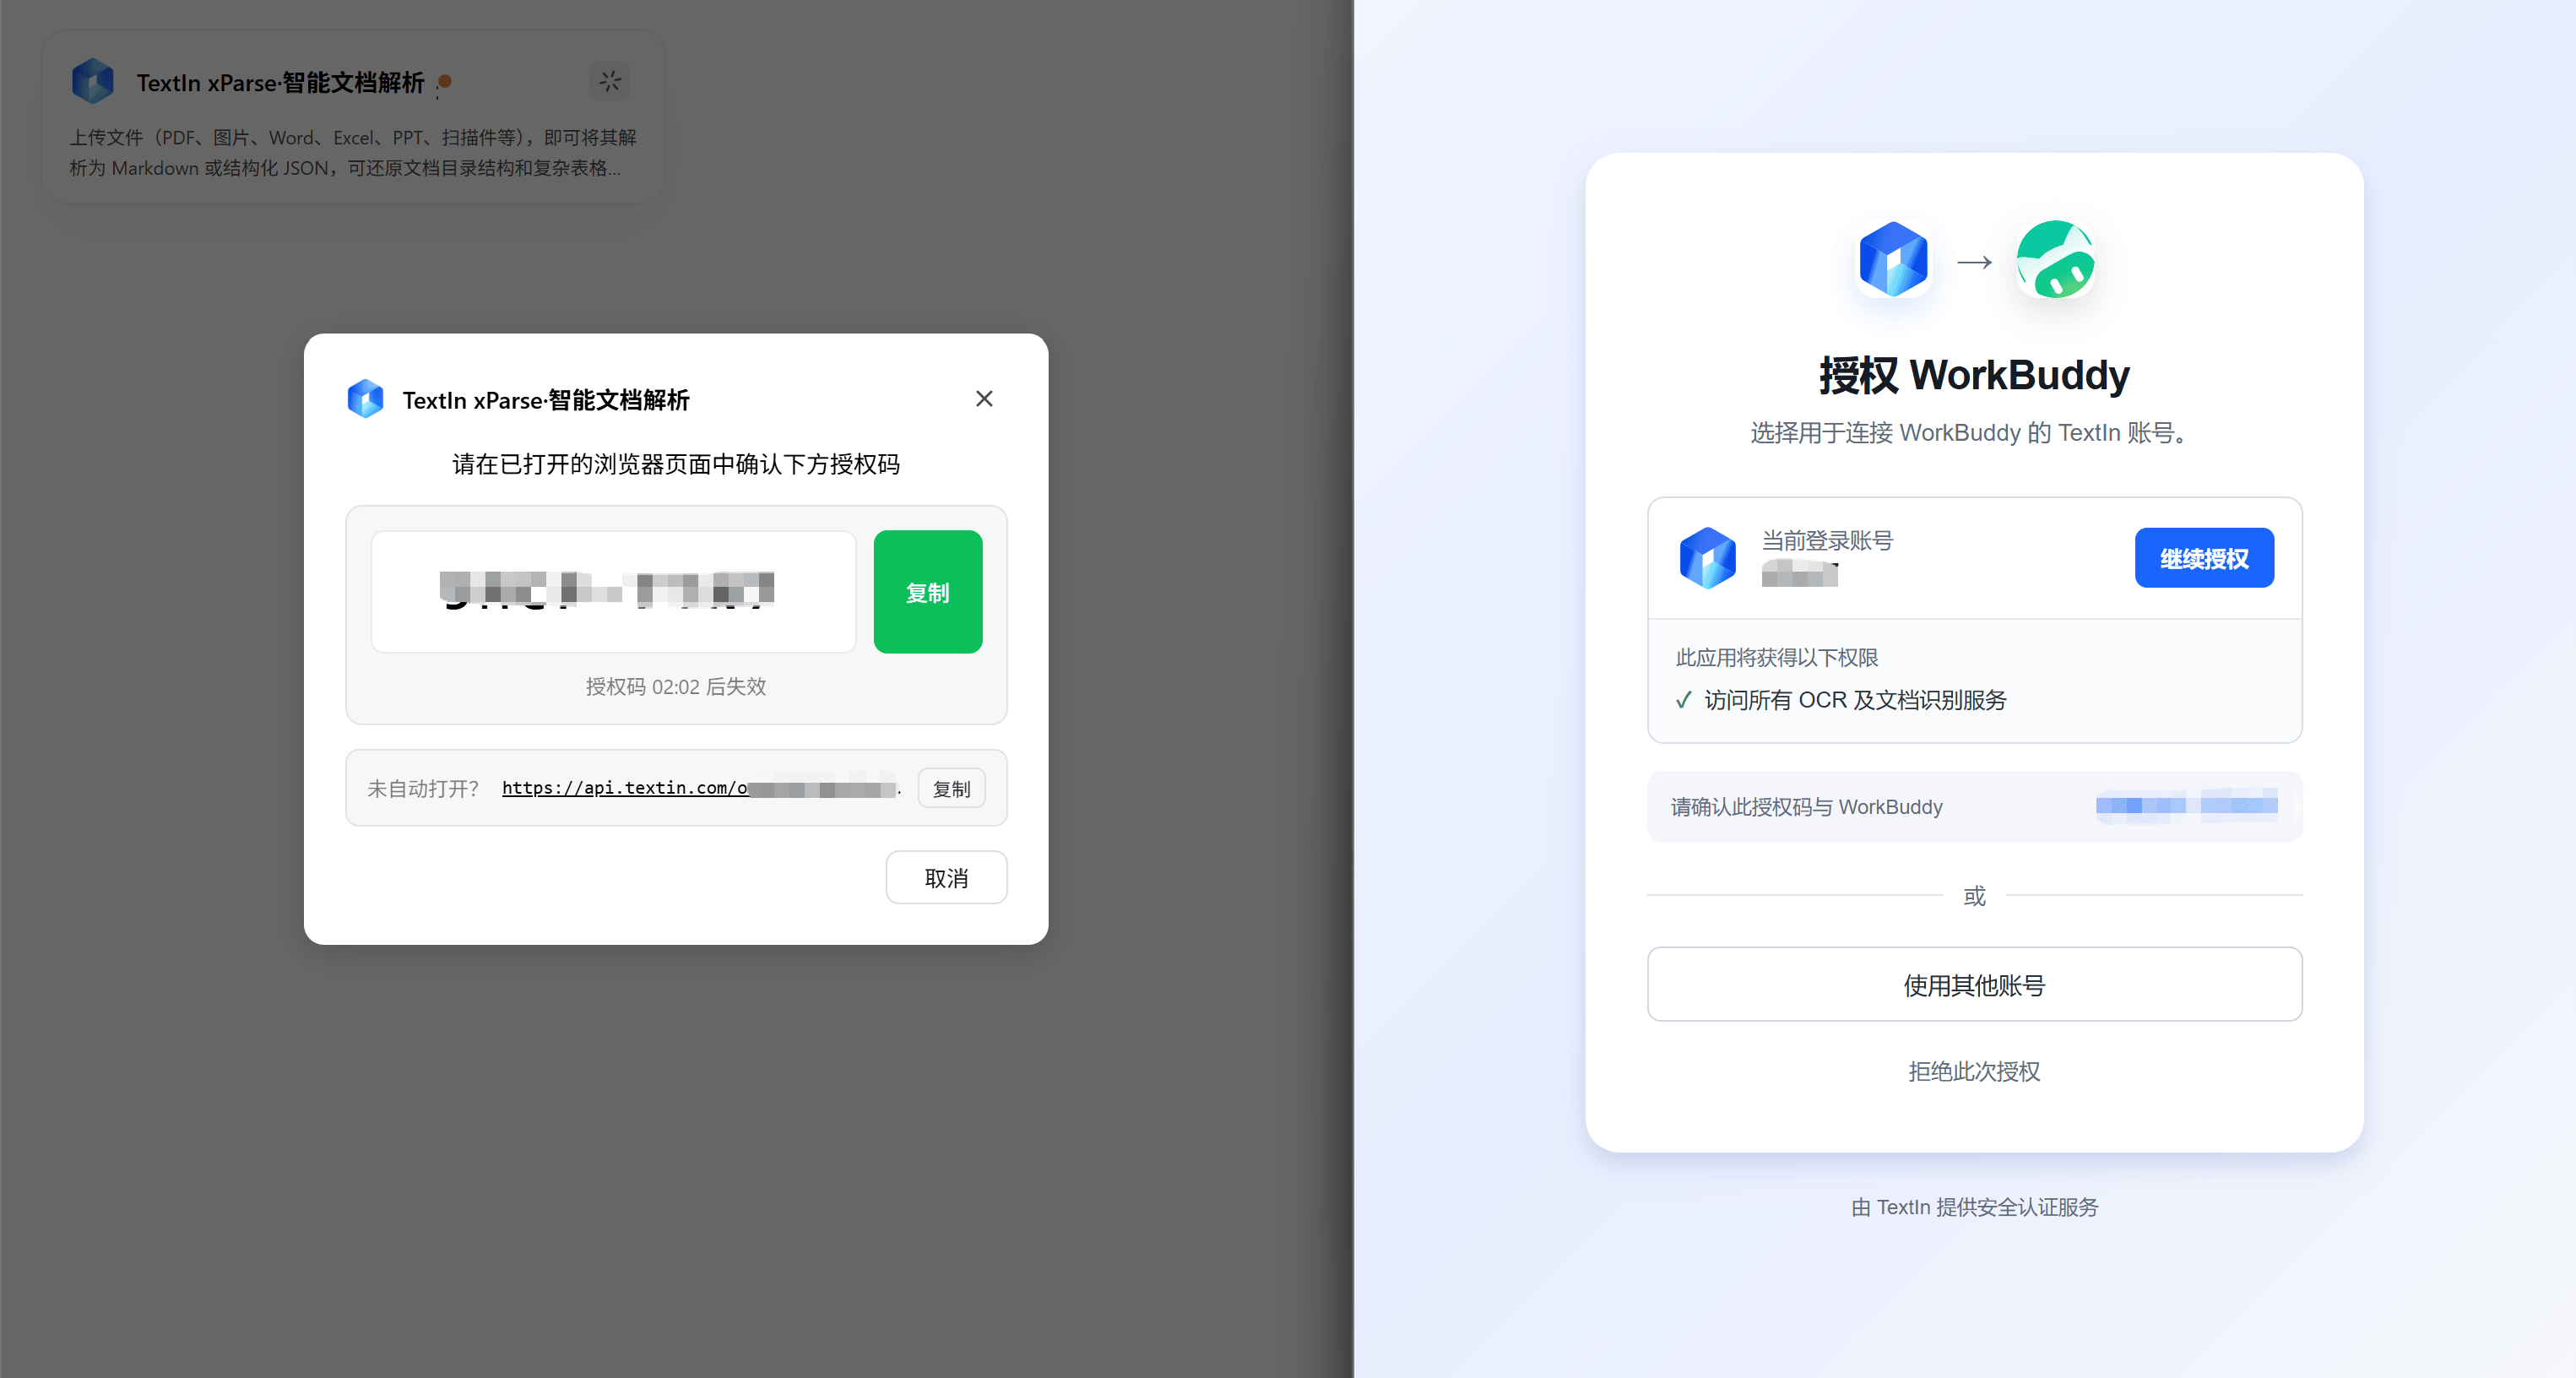
image.png
在这个登录页面输入你的 TextIn 账号密码,点确认就行。如果你还没有账号,页面上也有注册入口,注册是免费的。
授权成功后,回到连接器页面,你会看到 TextIn xParse 的状态已经变成了绿色的"已连接",说明连接器已经可以正常使用了。
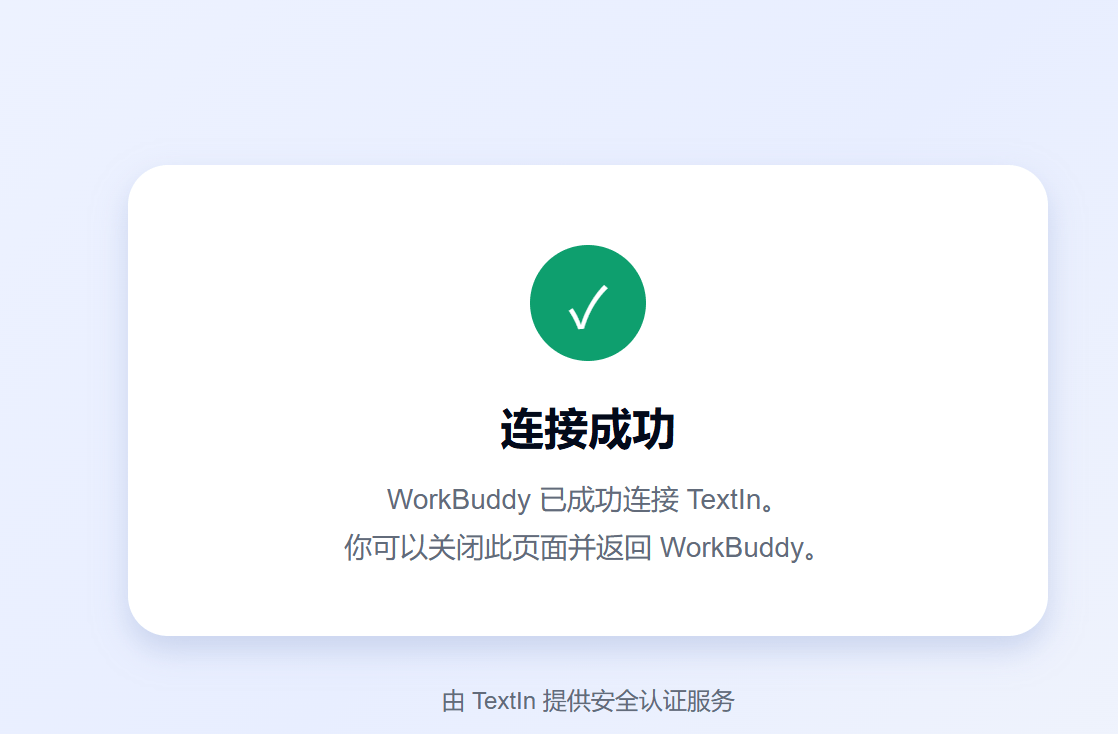
image.png
这时候系统还会弹出一个提示框,告诉你这个连接器的具体功能和用法。里面写得很清楚:
上传文件(PDF、图片、Word、Excel、PPT、扫描件等),即可将其解析为 Markdown 或结构化 JSON,可还原文档目录结构和复杂表格结构,适用于高精度高性能要求的文档处理OCR任务,每日免费1000页。
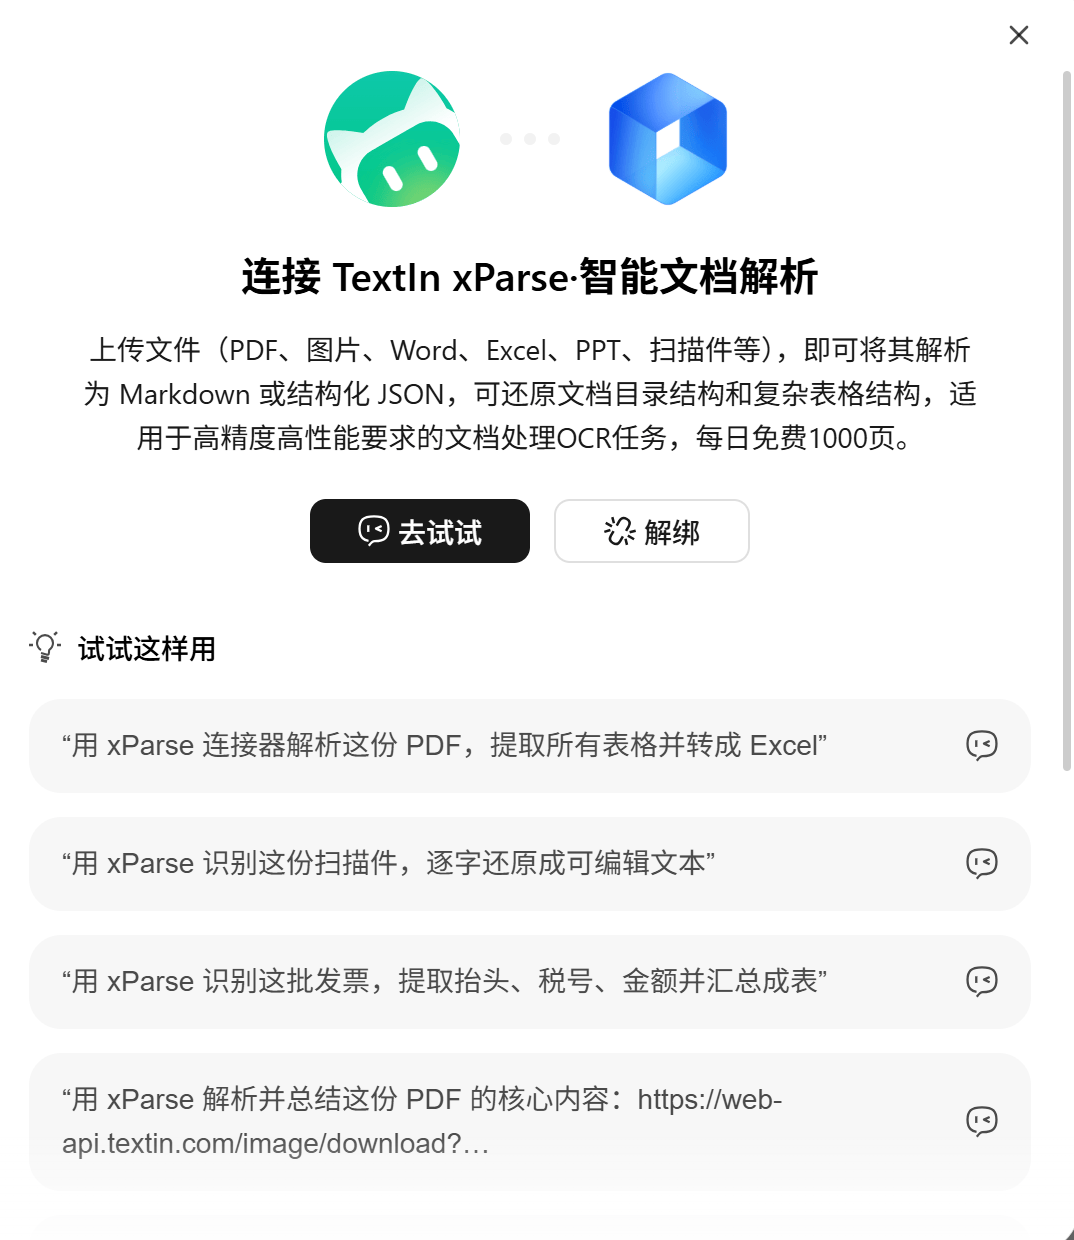
image.png
这个提示框里把支持哪些文件格式、输出什么格式、每天免费额度都写明白了。我注意到它特别提到了"复杂表格结构"的处理能力,这个后面我们会具体看到效果。
第三步:新建对话并启用 xParse
现在连接器已经装好了,新建一个对话来使用它。点击新建对话按钮,进入对话界面后,注意看顶部区域,你能看到有一个 TextIn xParse 的开关选项,默认是开启状态的。
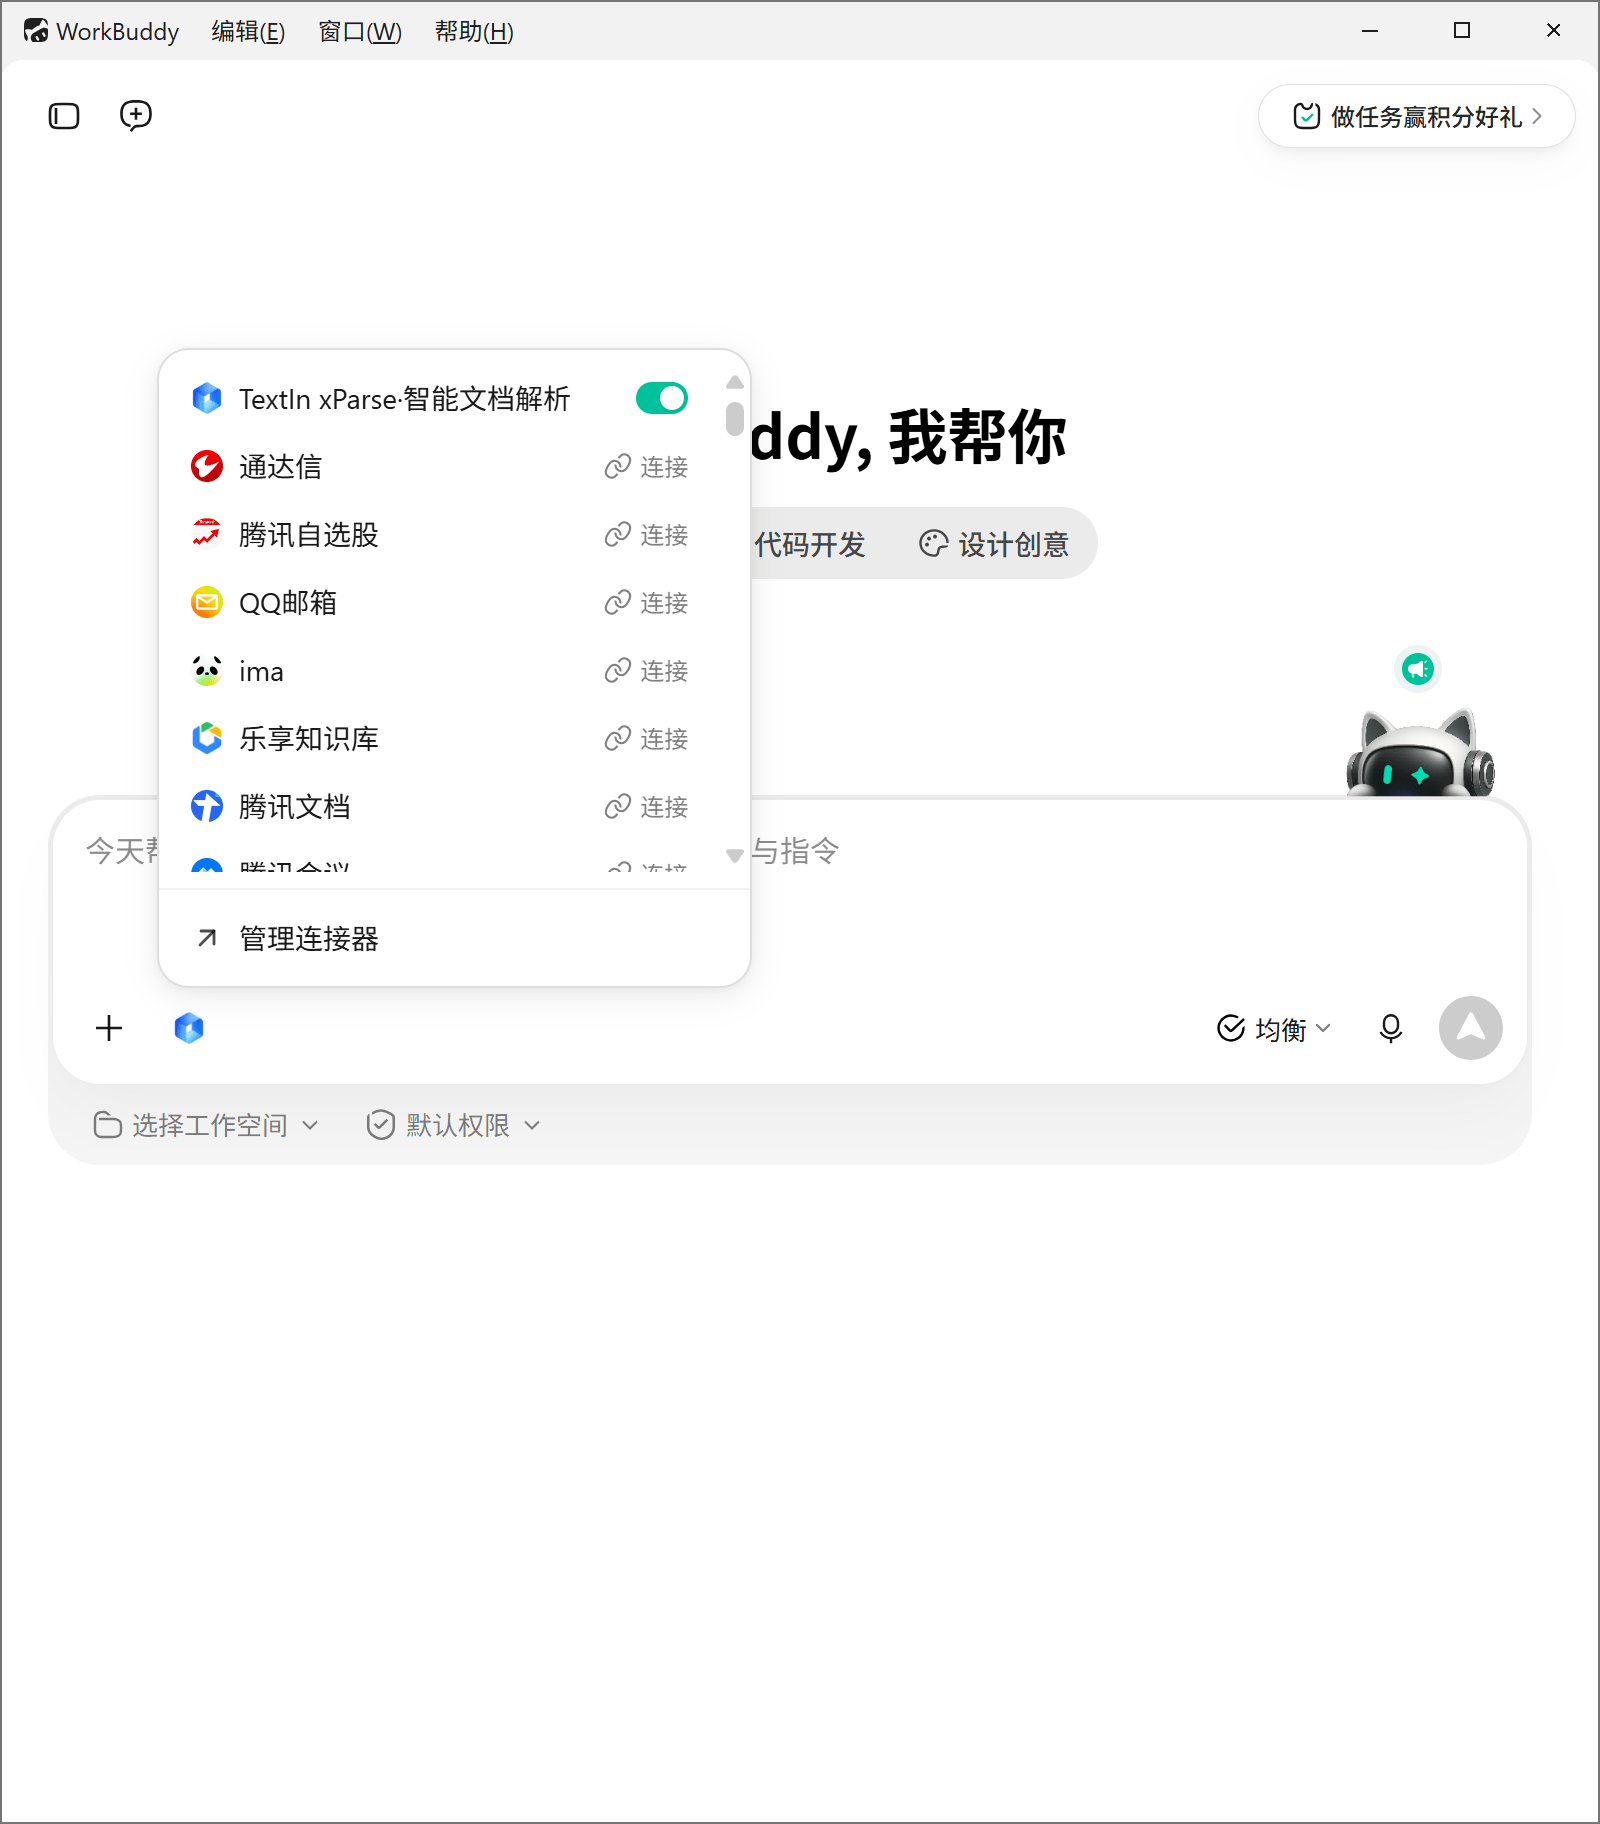
image.png
这个开关的意思是:在这个对话里,当你上传或者让 AI 读取文档的时候,它会自动调用 xParse 引擎来进行解析,而不是用 AI 自己的能力去"猜"文档内容。保持默认开启就行。
第四步:输入提示词,启动智能体
接下来就是关键步骤了。我们需要告诉 AI 具体要干什么。我把提前写好的提示词输进去,这个提示词定义了智能体的完整工作流程:
# 留学申请材料一致性核对智能体|执行提示词

你现在是一个"留学申请材料一致性核对智能体"。你的工作不是泛泛介绍留学流程,而是读取用户指定的本地文件夹,调用已集成的 TextIn Xparse 解析其中的文档,完成材料核对,并最终生成一个可打开的 HTML 展示页面。

## 用户输入

用户会提供一个本地文件夹路径,例如:
D:\Users\27890\Desktop\workbuddy\source_zh

你必须递归读取该路径下的文件。支持 PDF、PNG/JPG、DOCX、XLSX/CSV、TXT、HTML 和 JSON。

## 核心工作流程

### 1. 扫描和分类
先列出所有文件,记录相对路径、文件名、扩展名、大小和页数,并将文件归类为:
- 学校/项目申请要求
- 成绩单或课程表
- 学位证、毕业证、在读证明
- IELTS、TOEFL、GRE 等考试成绩
- 护照或身份材料
- 申请表
- 简历、推荐信、资金证明
- 其他附件

### 2. 调用 TextIn Xparse
对每一份可解析文档调用 TextIn Xparse 连接器:
- PDF、DOCX、HTML、TXT、CSV、XLSX:解析正文、标题层级、表格、列表和日期
- PNG/JPG 或扫描 PDF:执行 OCR,识别姓名、号码、日期、金额、成绩和表格
- 跨页表格必须合并,保留原始行列关系

### 3. 建立申请人档案
将所有文件中的信息归一到同一申请人档案,抽取:
- 身份信息:姓名、出生日期、国籍、护照号码等
- 学历信息:学校、专业、学位、GPA、课程成绩等
- 考试信息:IELTS/TOEFL/GRE 成绩等
- 申请信息:目标学校、项目要求等

### 4. 一致性核对
逐字段比较不同文件中的值,标记差异和风险等级

### 5. 缺件和学校要求
识别学校要求文档,检查每项要求的满足状态

### 6. 生成 HTML 报告
输出一个完整的 HTML 展示页面这个提示词看起来长,但核心逻辑就一条线:给一个文件夹路径 → 自动扫描所有文件 → 用 TextIn xParse 解析每一份文档 → 从解析结果中提取关键信息 → 把不同文件的信息交叉比对 → 找出不一致的地方 → 最后生成一份完整的 HTML 报告。
整个过程全自动,不需要你中途介入。
第五步:执行解析
提示词输进去之后,我们只需要给出文件夹路径就行了。比如我这边用的是 D:\Users\27890\Desktop\workbuddy\source_zh,这个文件夹里放了我准备的所有留学申请材料。
输入路径后,智能体开始工作了。首先是文件夹扫描阶段,它会递归读取文件夹里的所有文件,然后列出一个清单。从界面输出可以看到,它正在逐个识别文件,显示每个文件的名称、类型和大小。
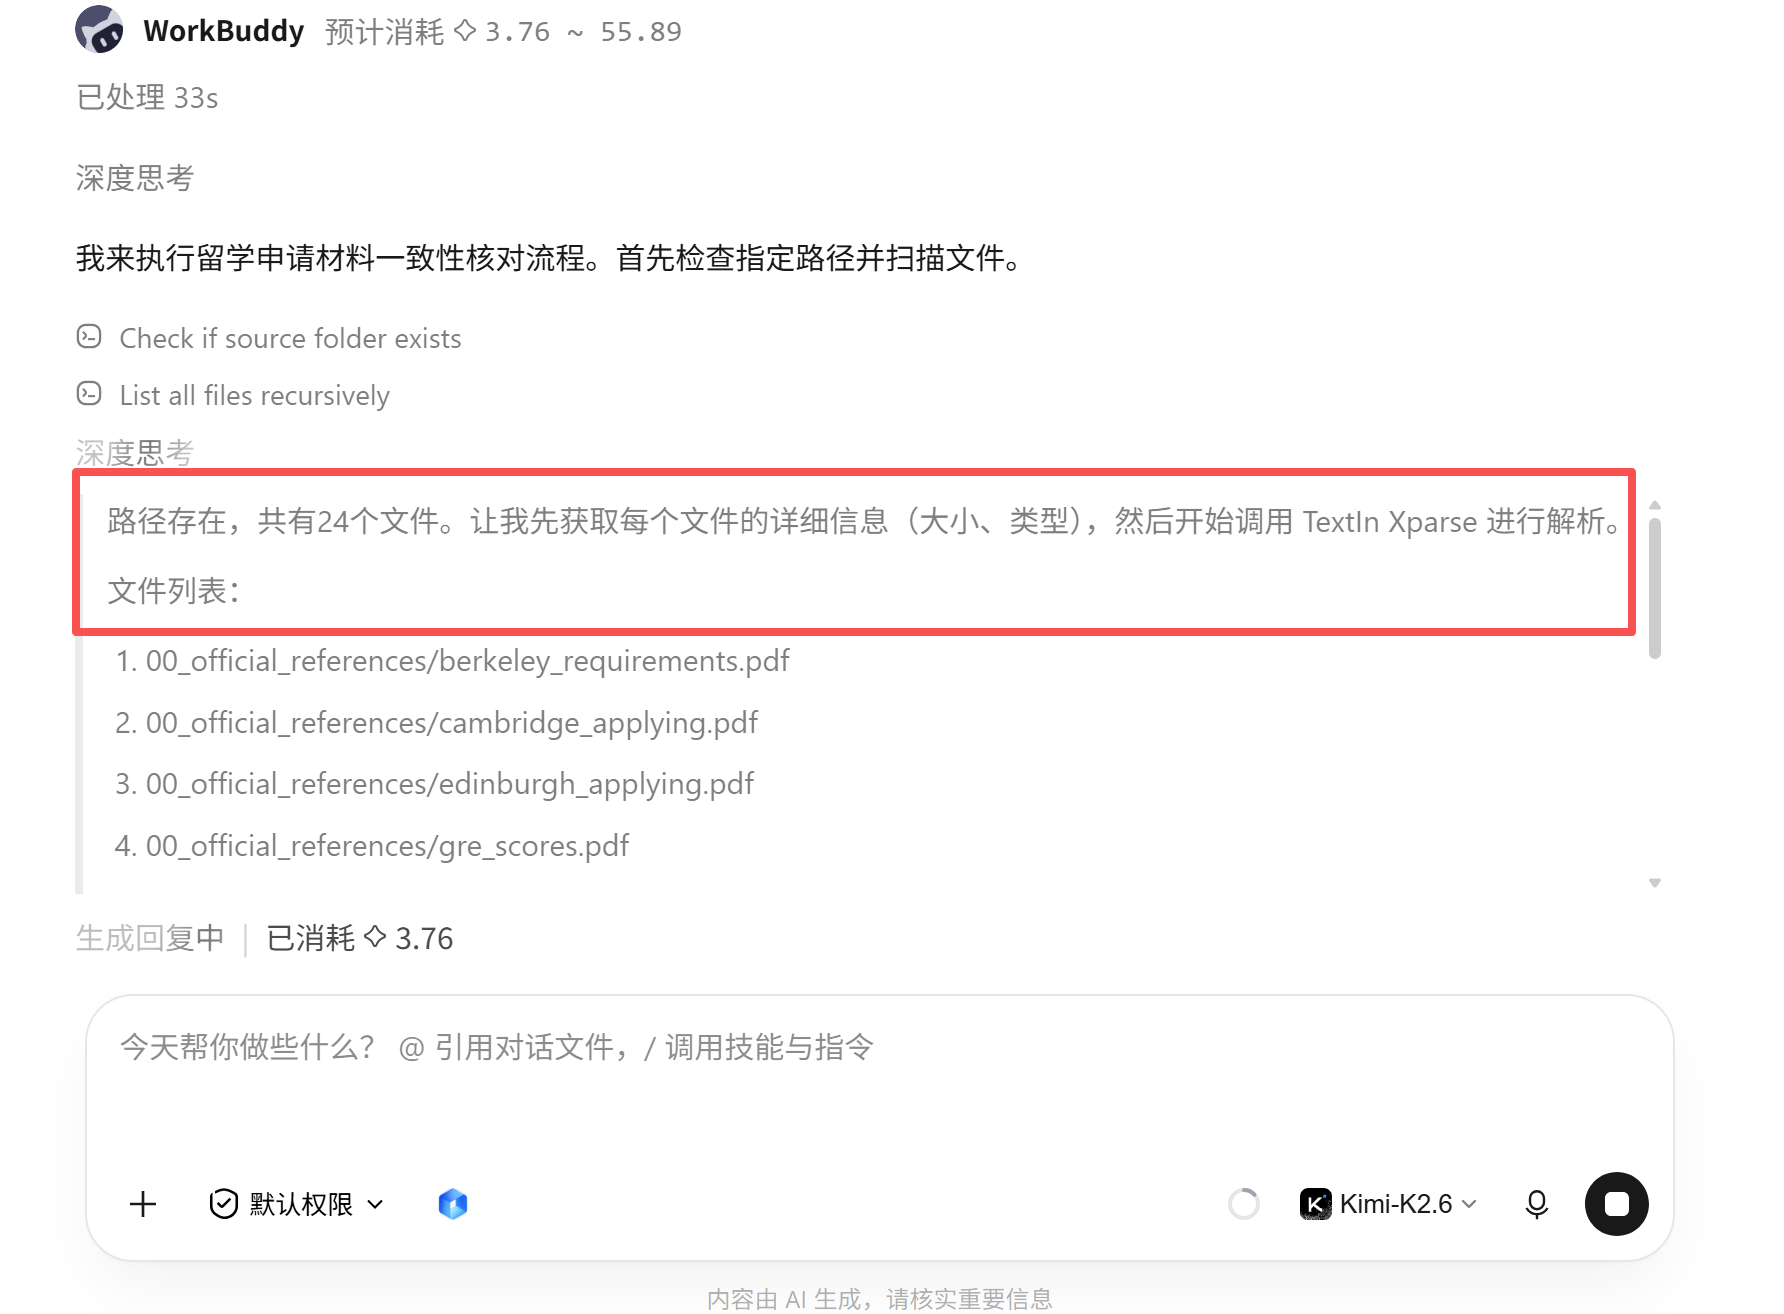
image.png
扫描完之后,下一步就是自动加载 xParse 解析功能了。这时候界面会显示正在调用 xParse 引擎,开始逐个处理文档。
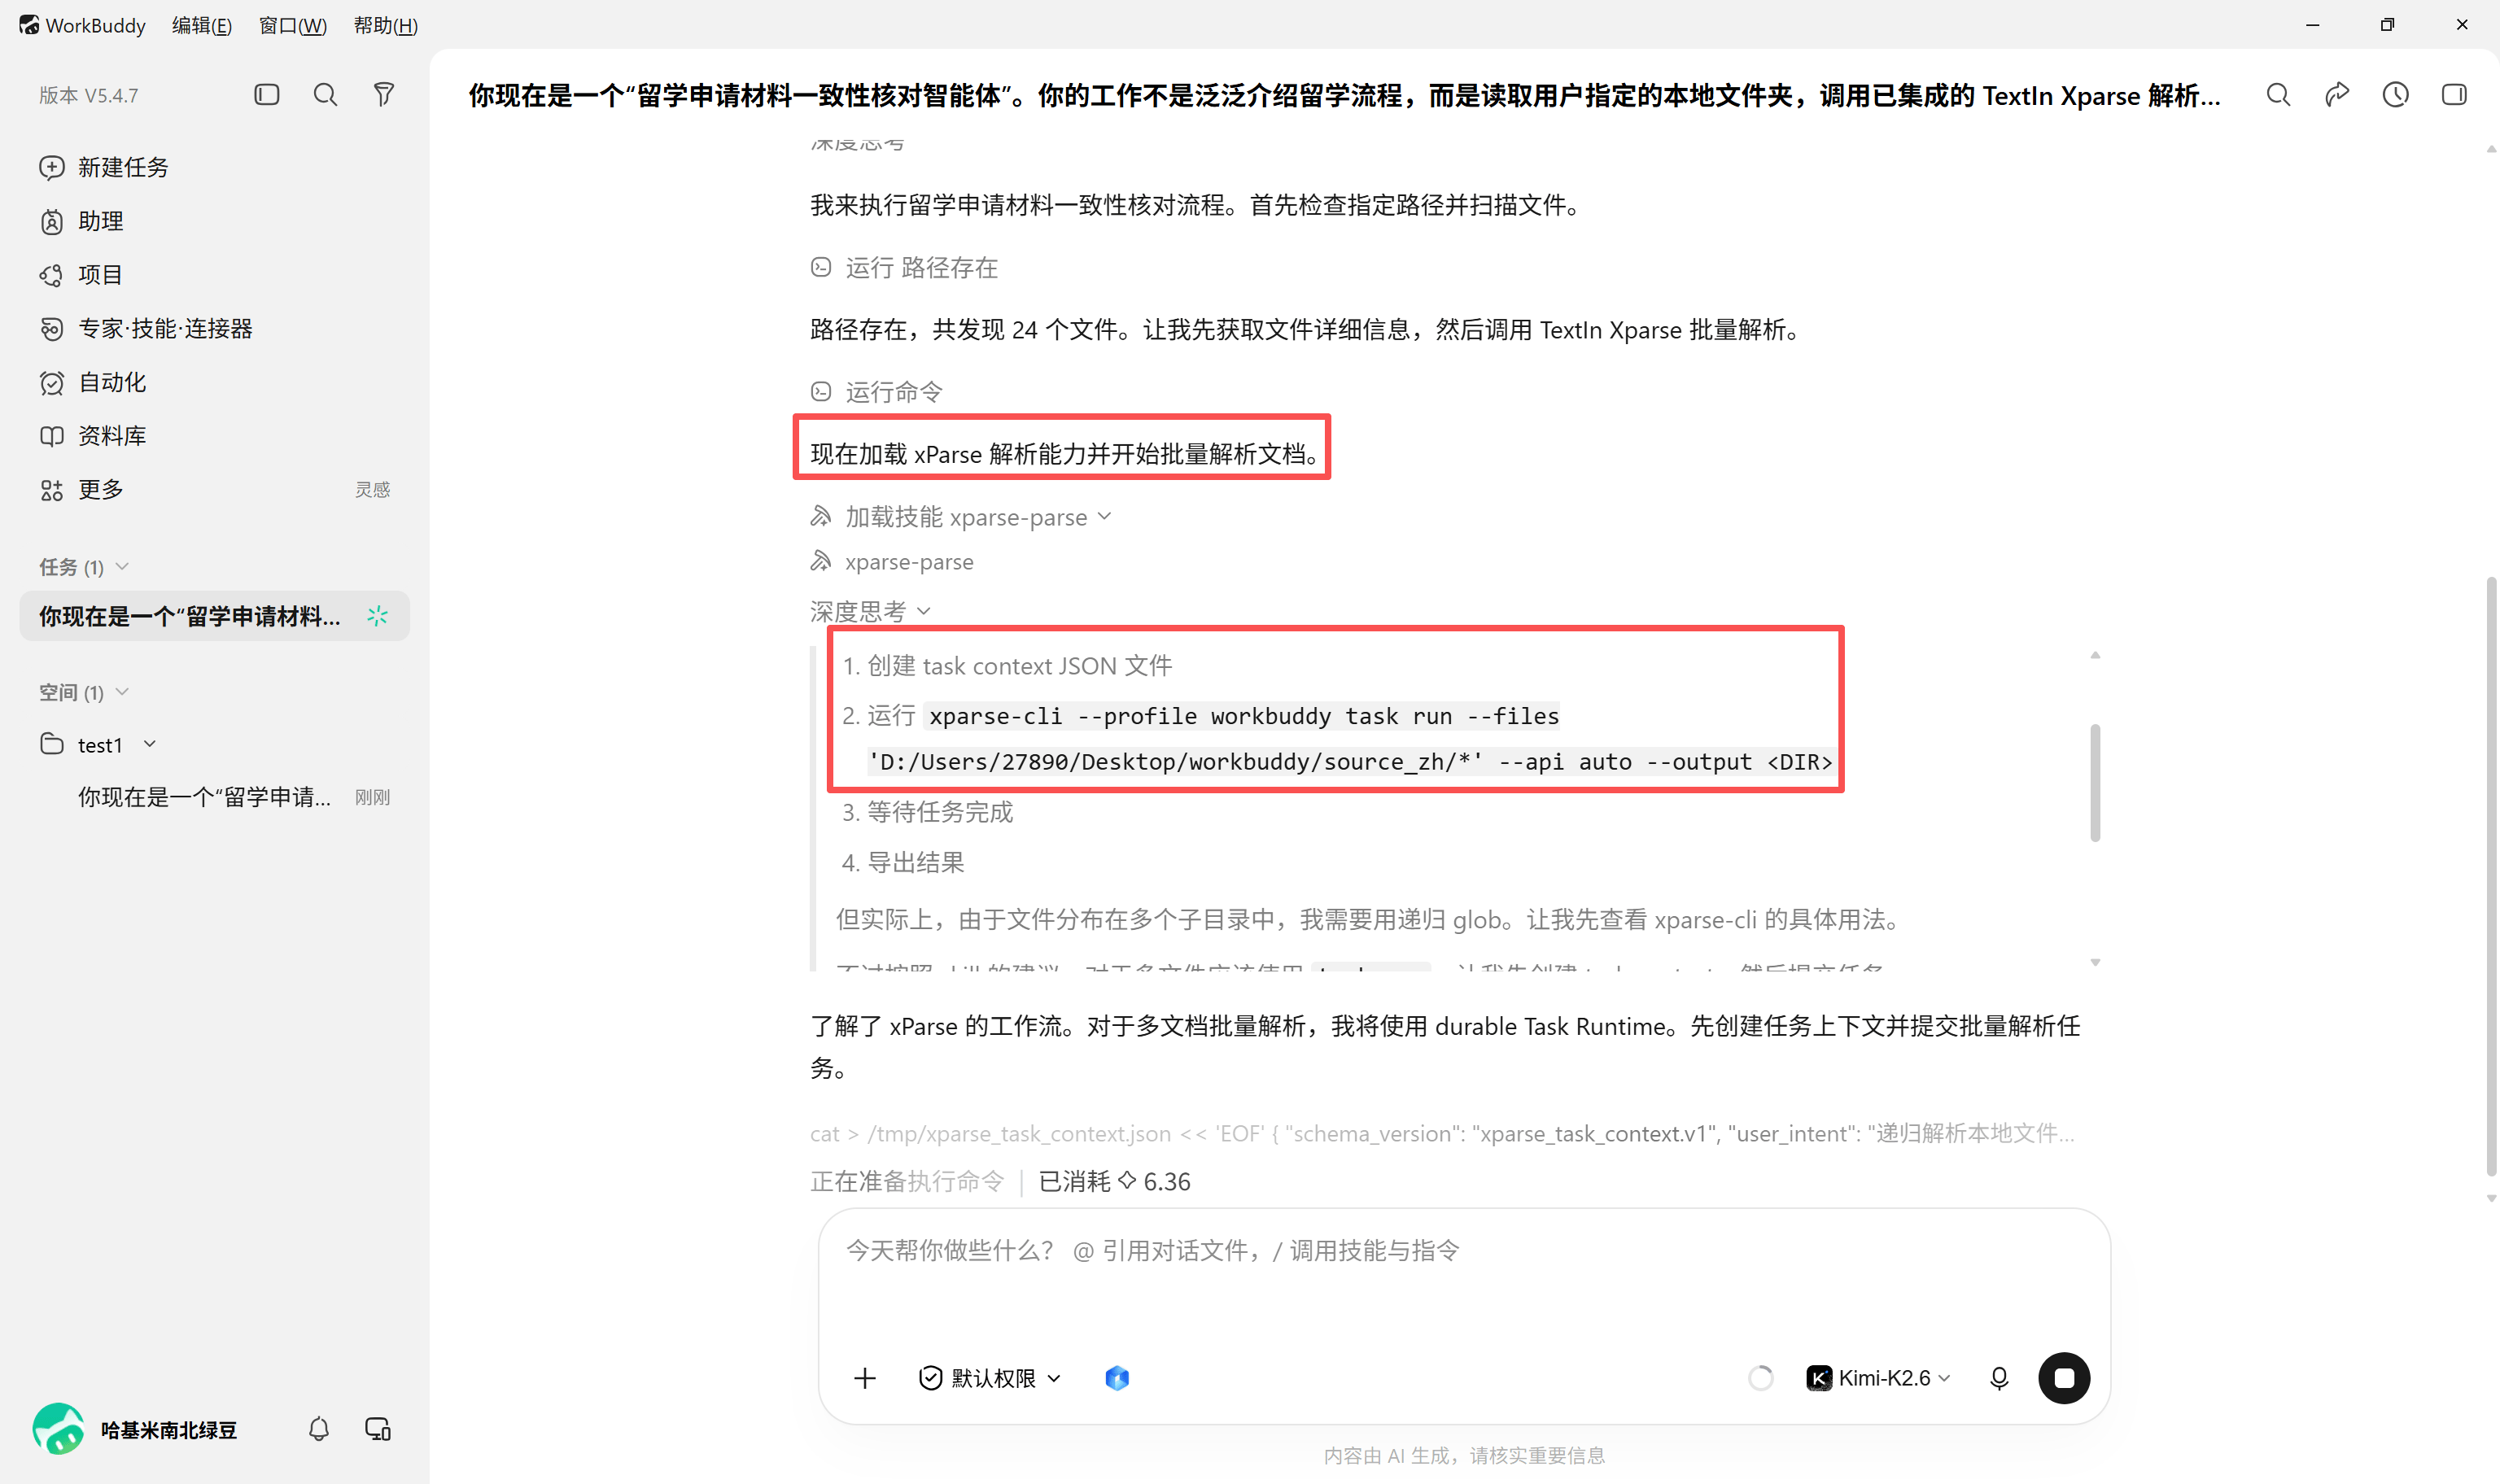
image.png
实际上底层执行的是这条命令:
xparse-cli --profile workbuddy task run --files "D:/Users/27890/Desktop/workbuddy/source_zh/**" --api auto --wait --output "D:/Users/27890/Desktop/workbuddy/xparse_output"也就是说,WorkBuddy 把我们的文件路径传给了 xParse 的命令行工具,xParse 在云端处理完之后,把结果写回到本地的 xparse_output 文件夹。整个过程我们是感知不到这些技术细节的,只需要等着就行。
等了一会儿,界面显示所有文档都解析成功了。能看到一个完成的列表,每个文件后面都标注了解析状态。
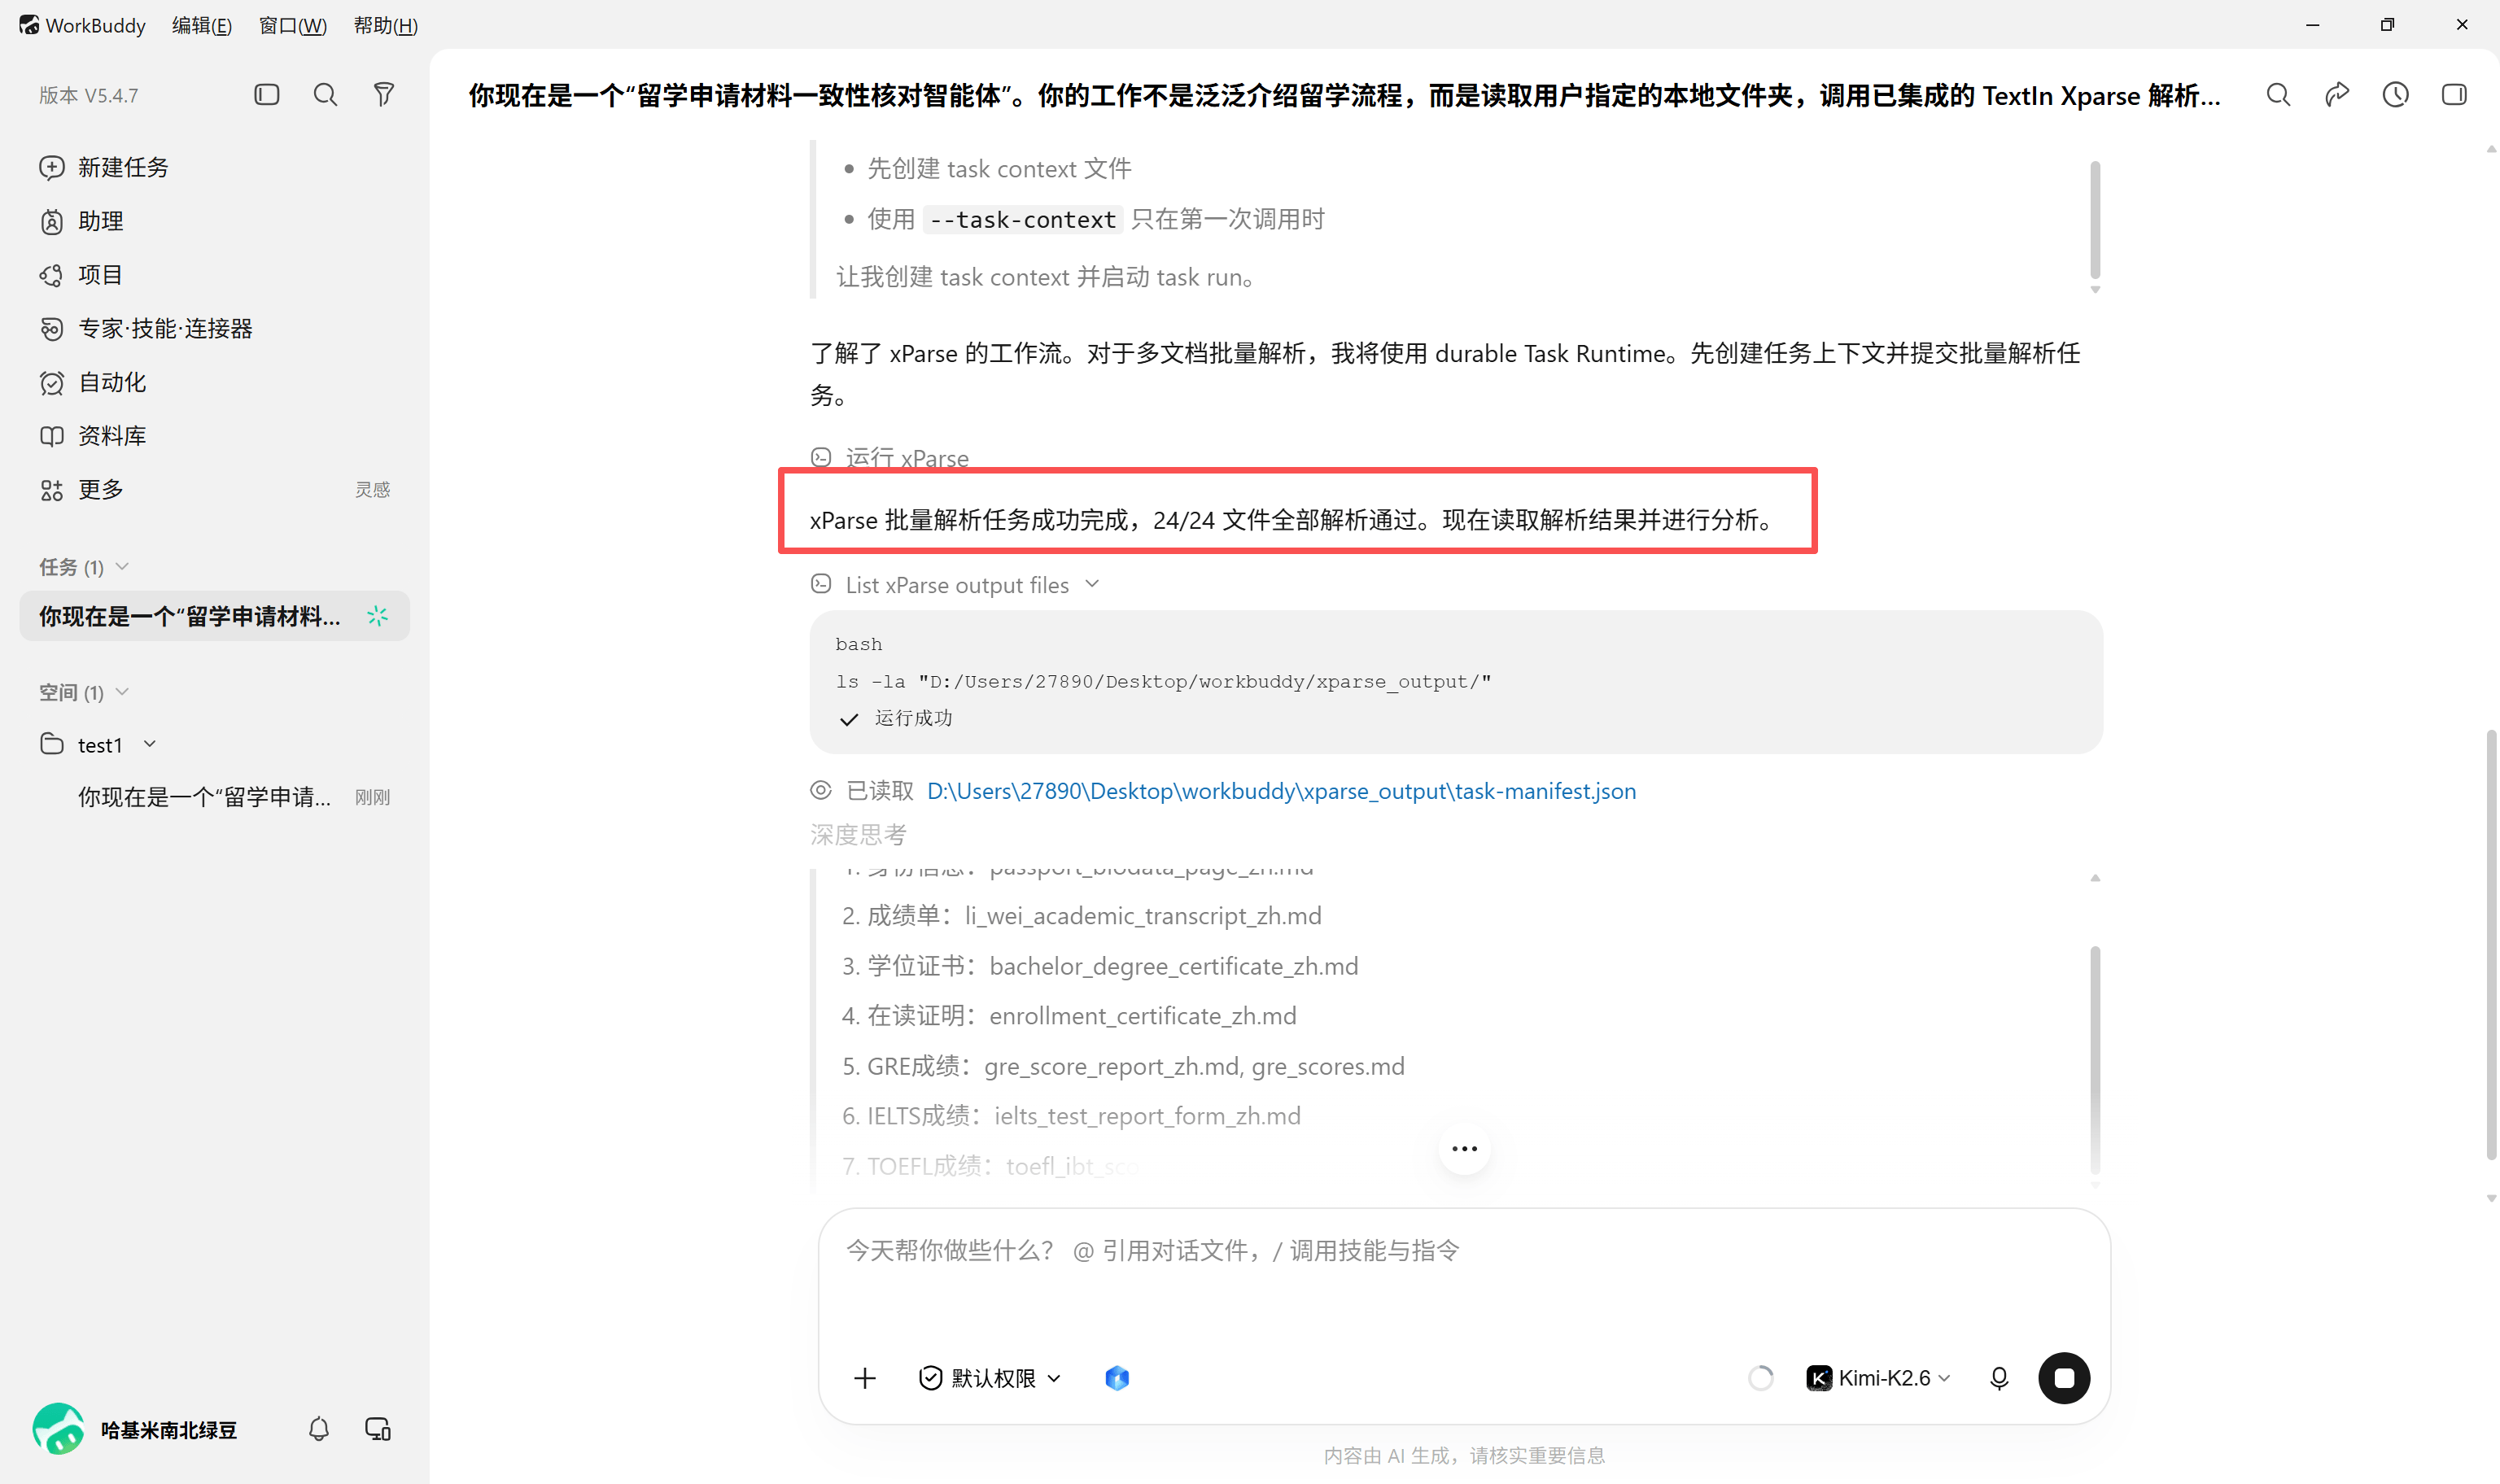
image.png
解析出来的结果都是 Markdown 格式的文件。在 WorkBuddy 界面右侧,可以直接预览解析后的内容。我仔细看了下,排版真的很规整——标题用 # ## 标注了层级,表格用标准的 Markdown 表格语法呈现,列表项也清清楚楚。不管是中文文档还是英文文档,文字都没有乱码,格式也没有乱掉。
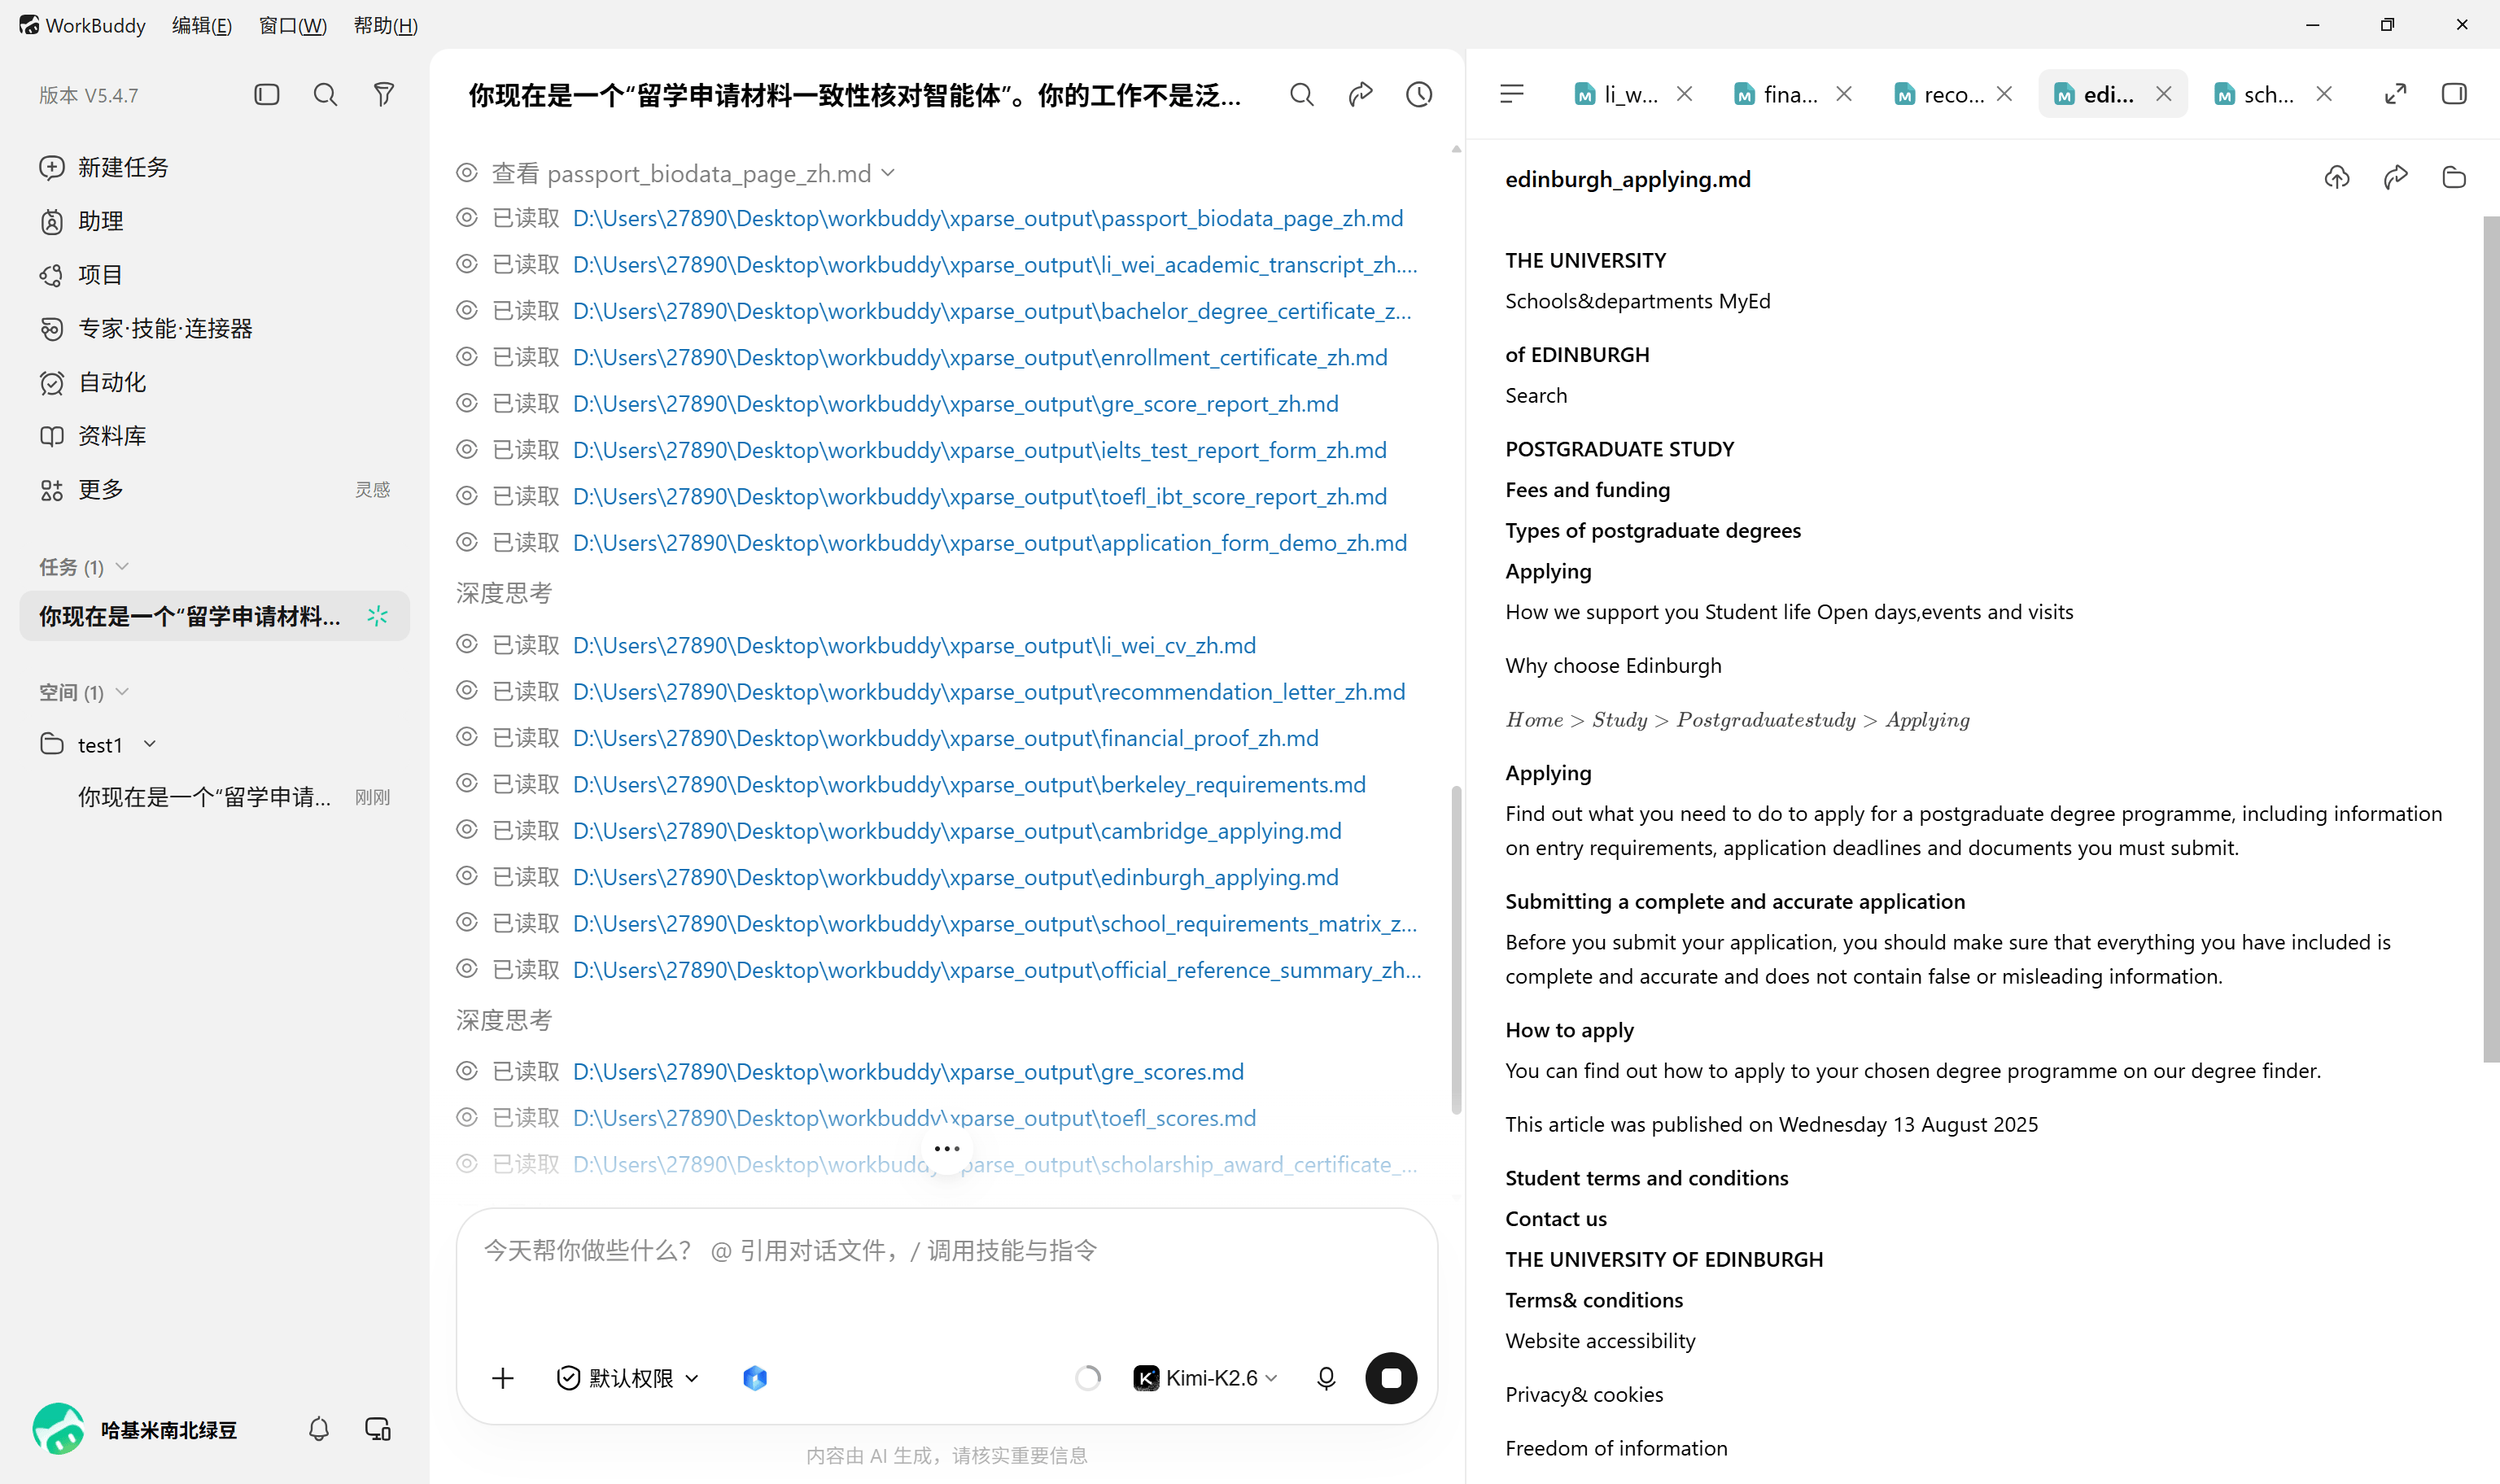
image.png
最后一步,智能体根据所有解析结果,自动生成 HTML 报告。界面会显示正在写入文件,然后给出生成的文件路径。
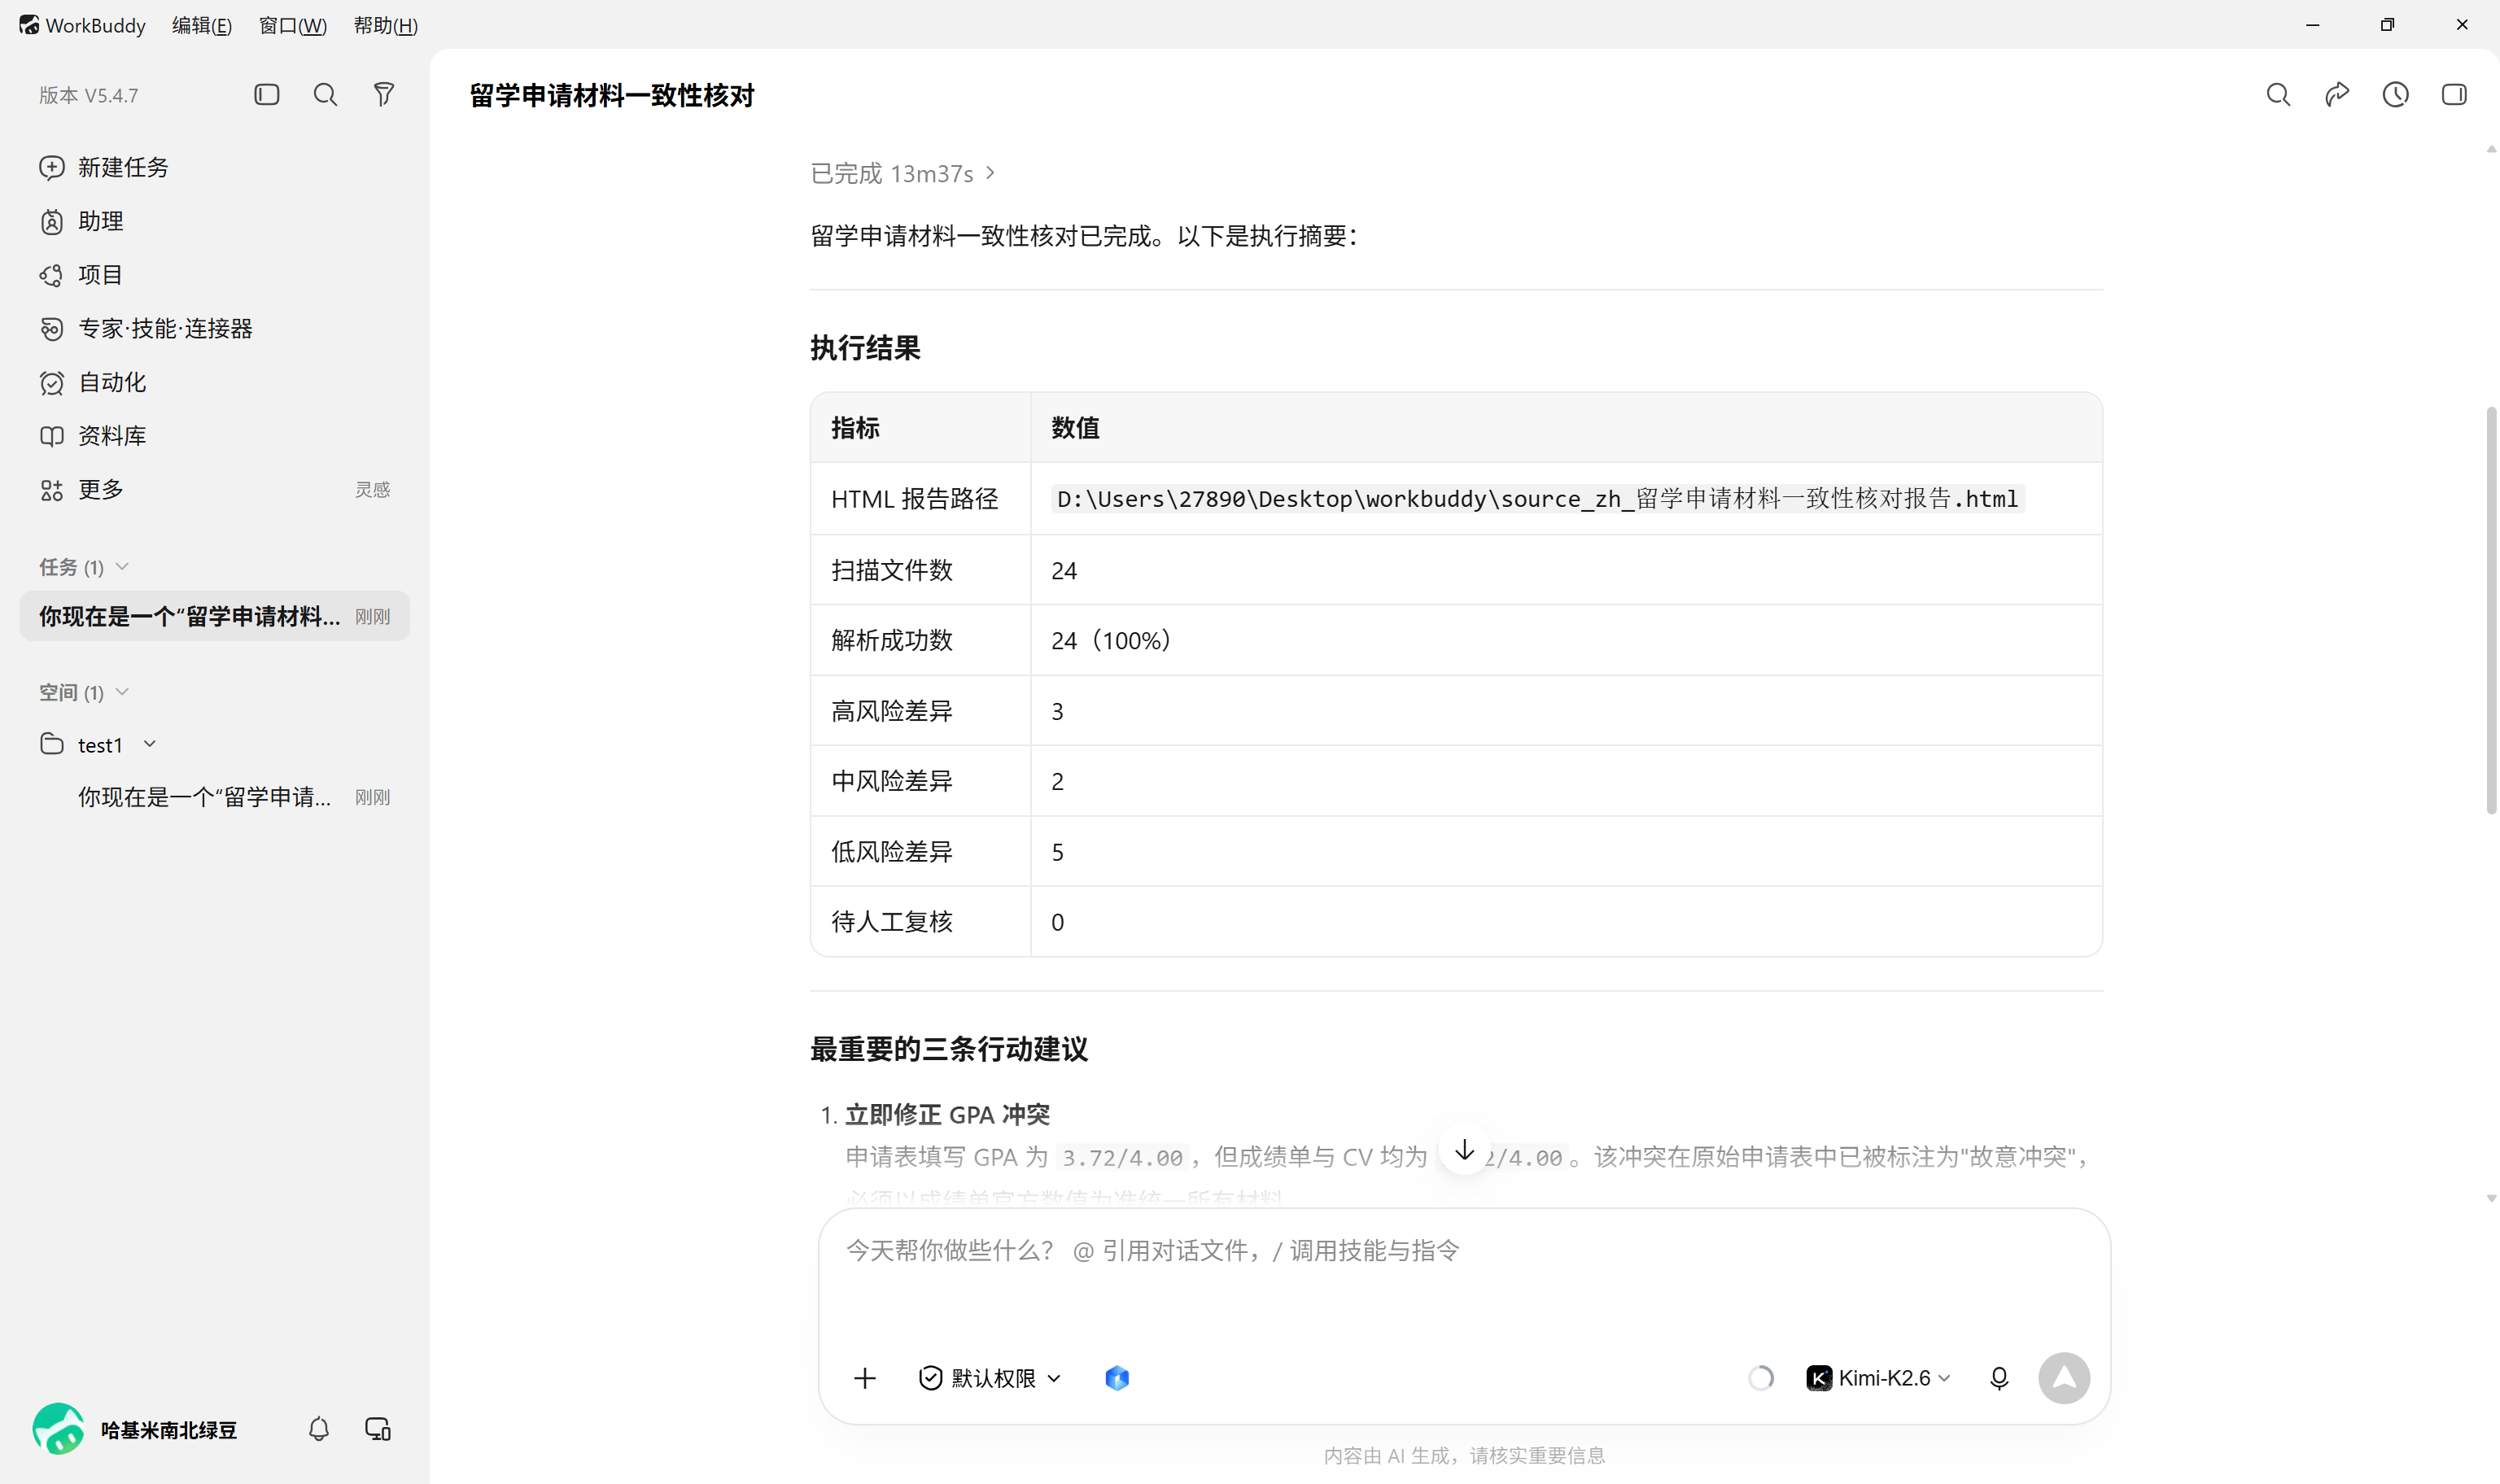
image.png
到这里,整个流程就走完了。从输入文件夹路径到拿到最终报告,全程不需要写一行代码。
核心对比:有TextIn xParse 和没TextIn xParse 差别有多大?
对比一:境外研究生入学申请表
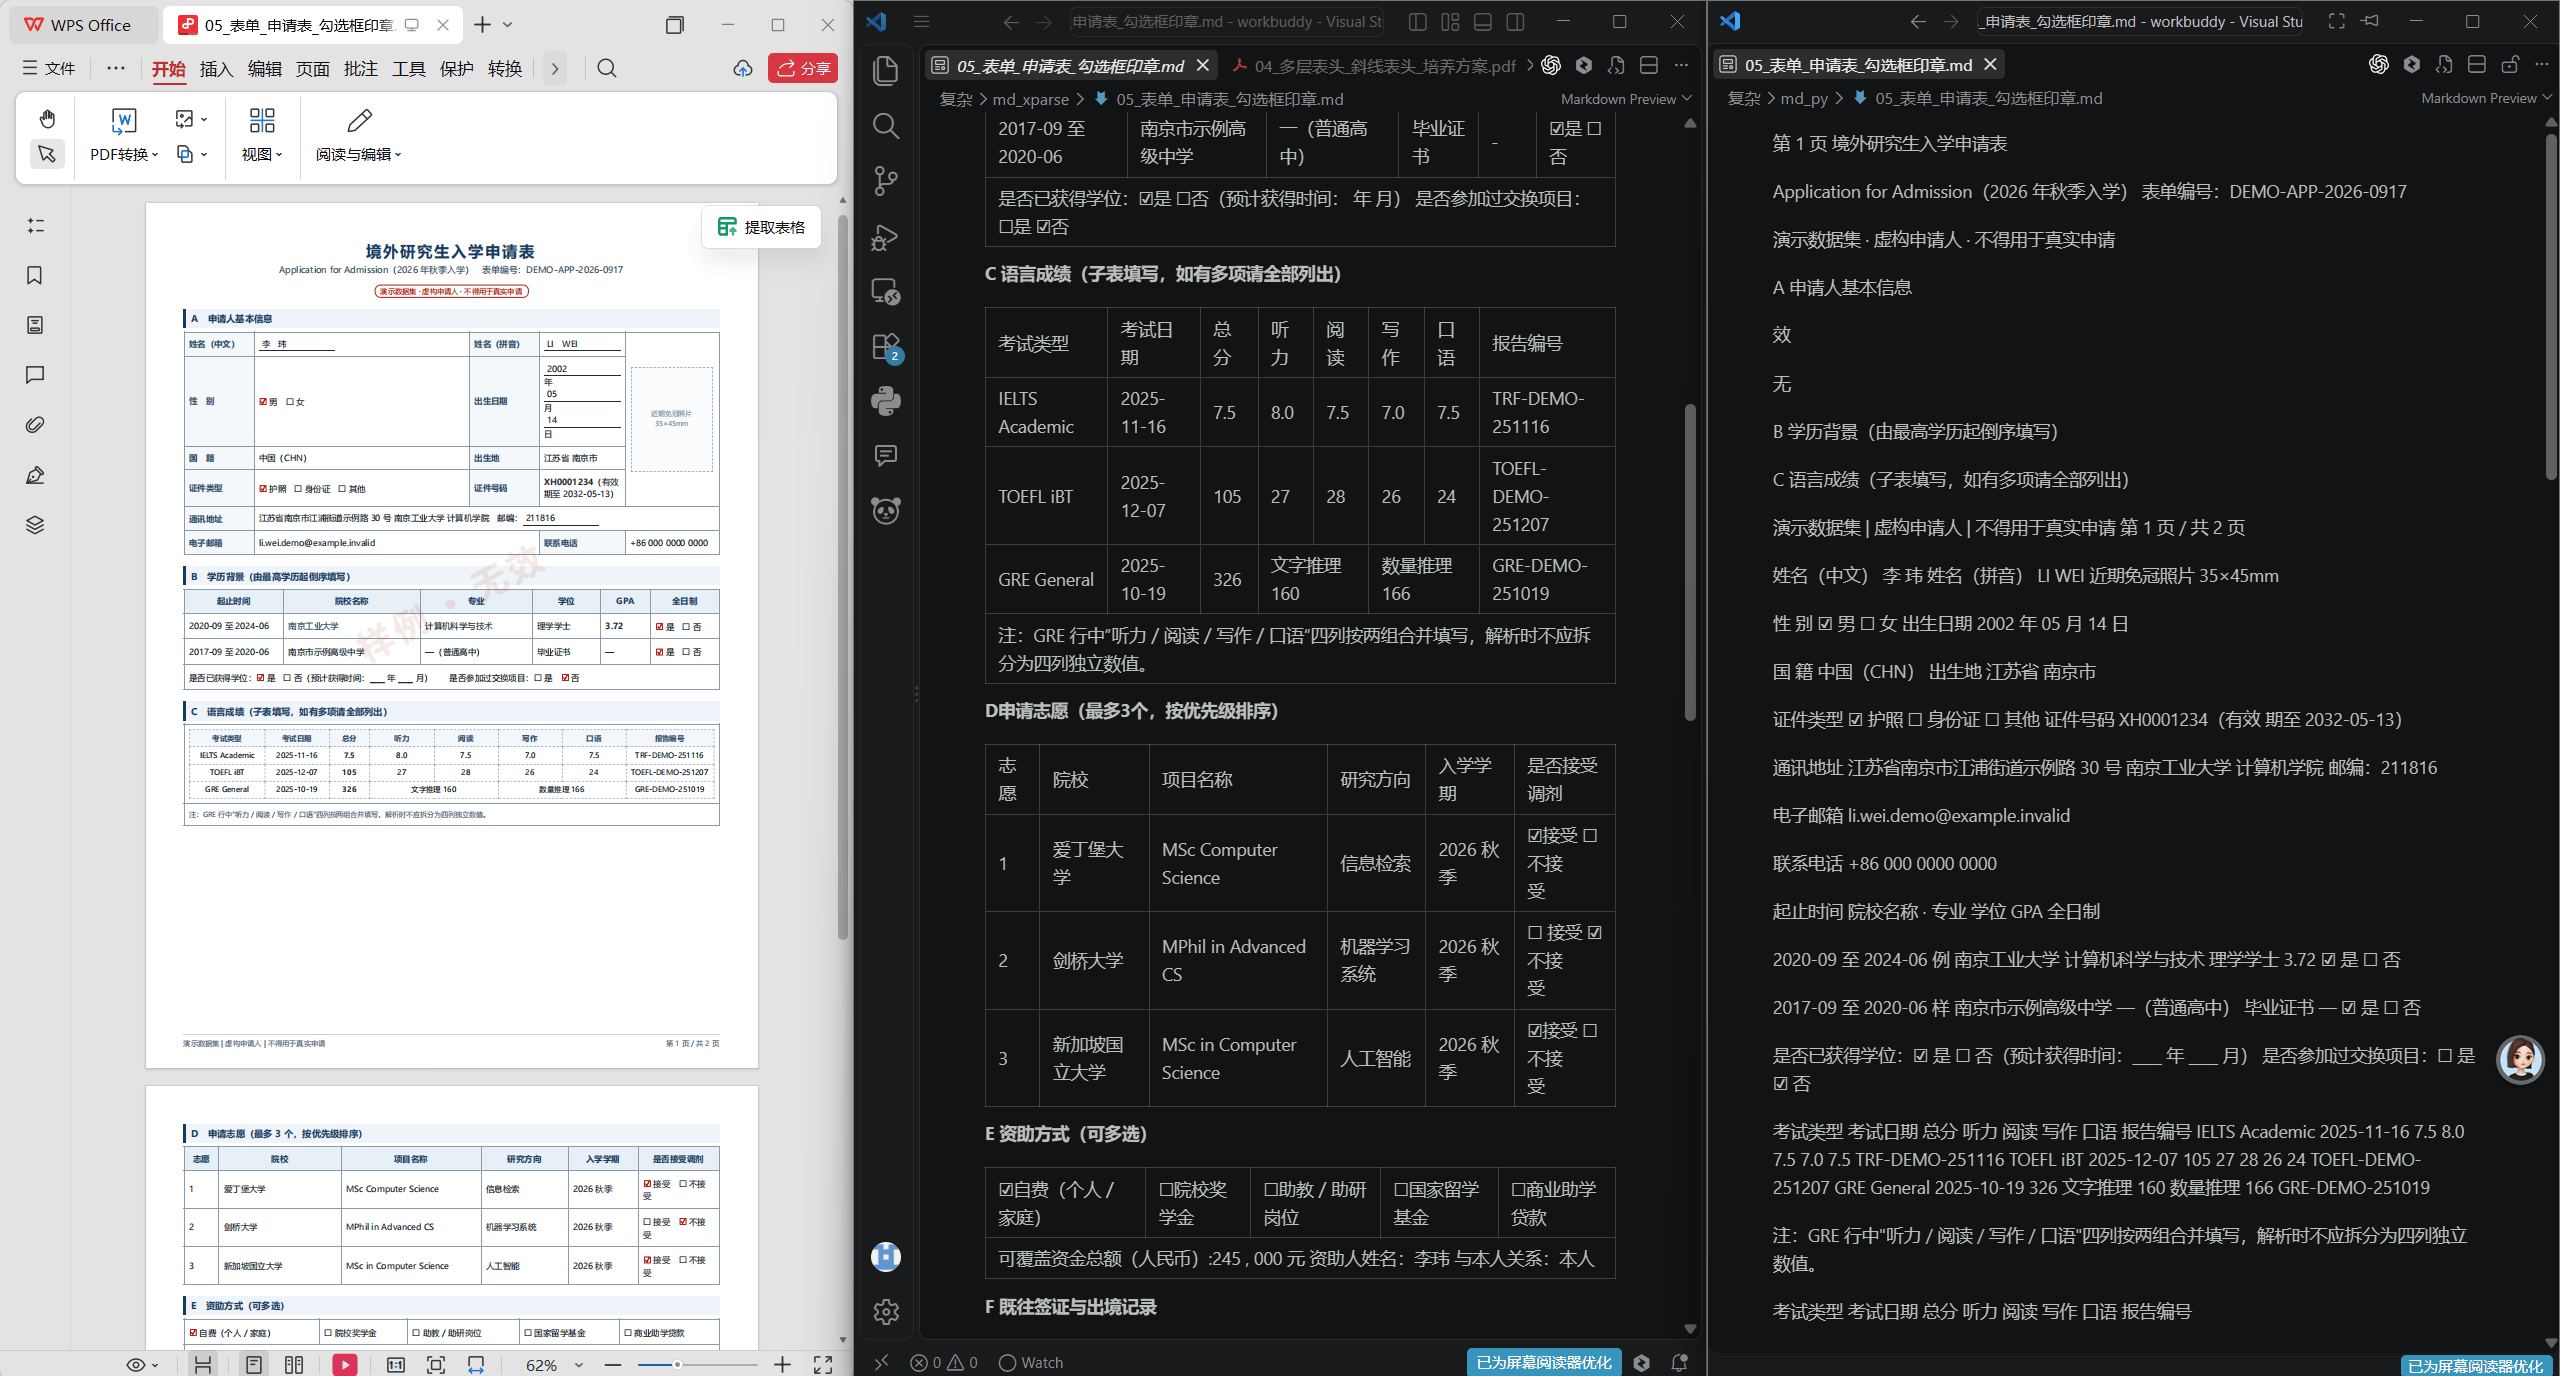
image.png
左边是原始 PDF,中间是TextIn xParse 解析出来的内容,右边是纯 AI 自己处理的结果。
仔细看中间和右边的区别:中间的排版很规整,标题层级清晰,段落结构完整,表格转化成了标准的 Markdown 格式;右边的虽然也能看,但排版明显松散,格式不统一,有些地方该缩进没缩进,该加粗没加粗,整体看起来就没那么舒服。对于这种包含大量文字说明、表格、列表项的复杂文档,TextIn xParse 的结构化处理能力确实更胜一筹。
对比二:学分结构表
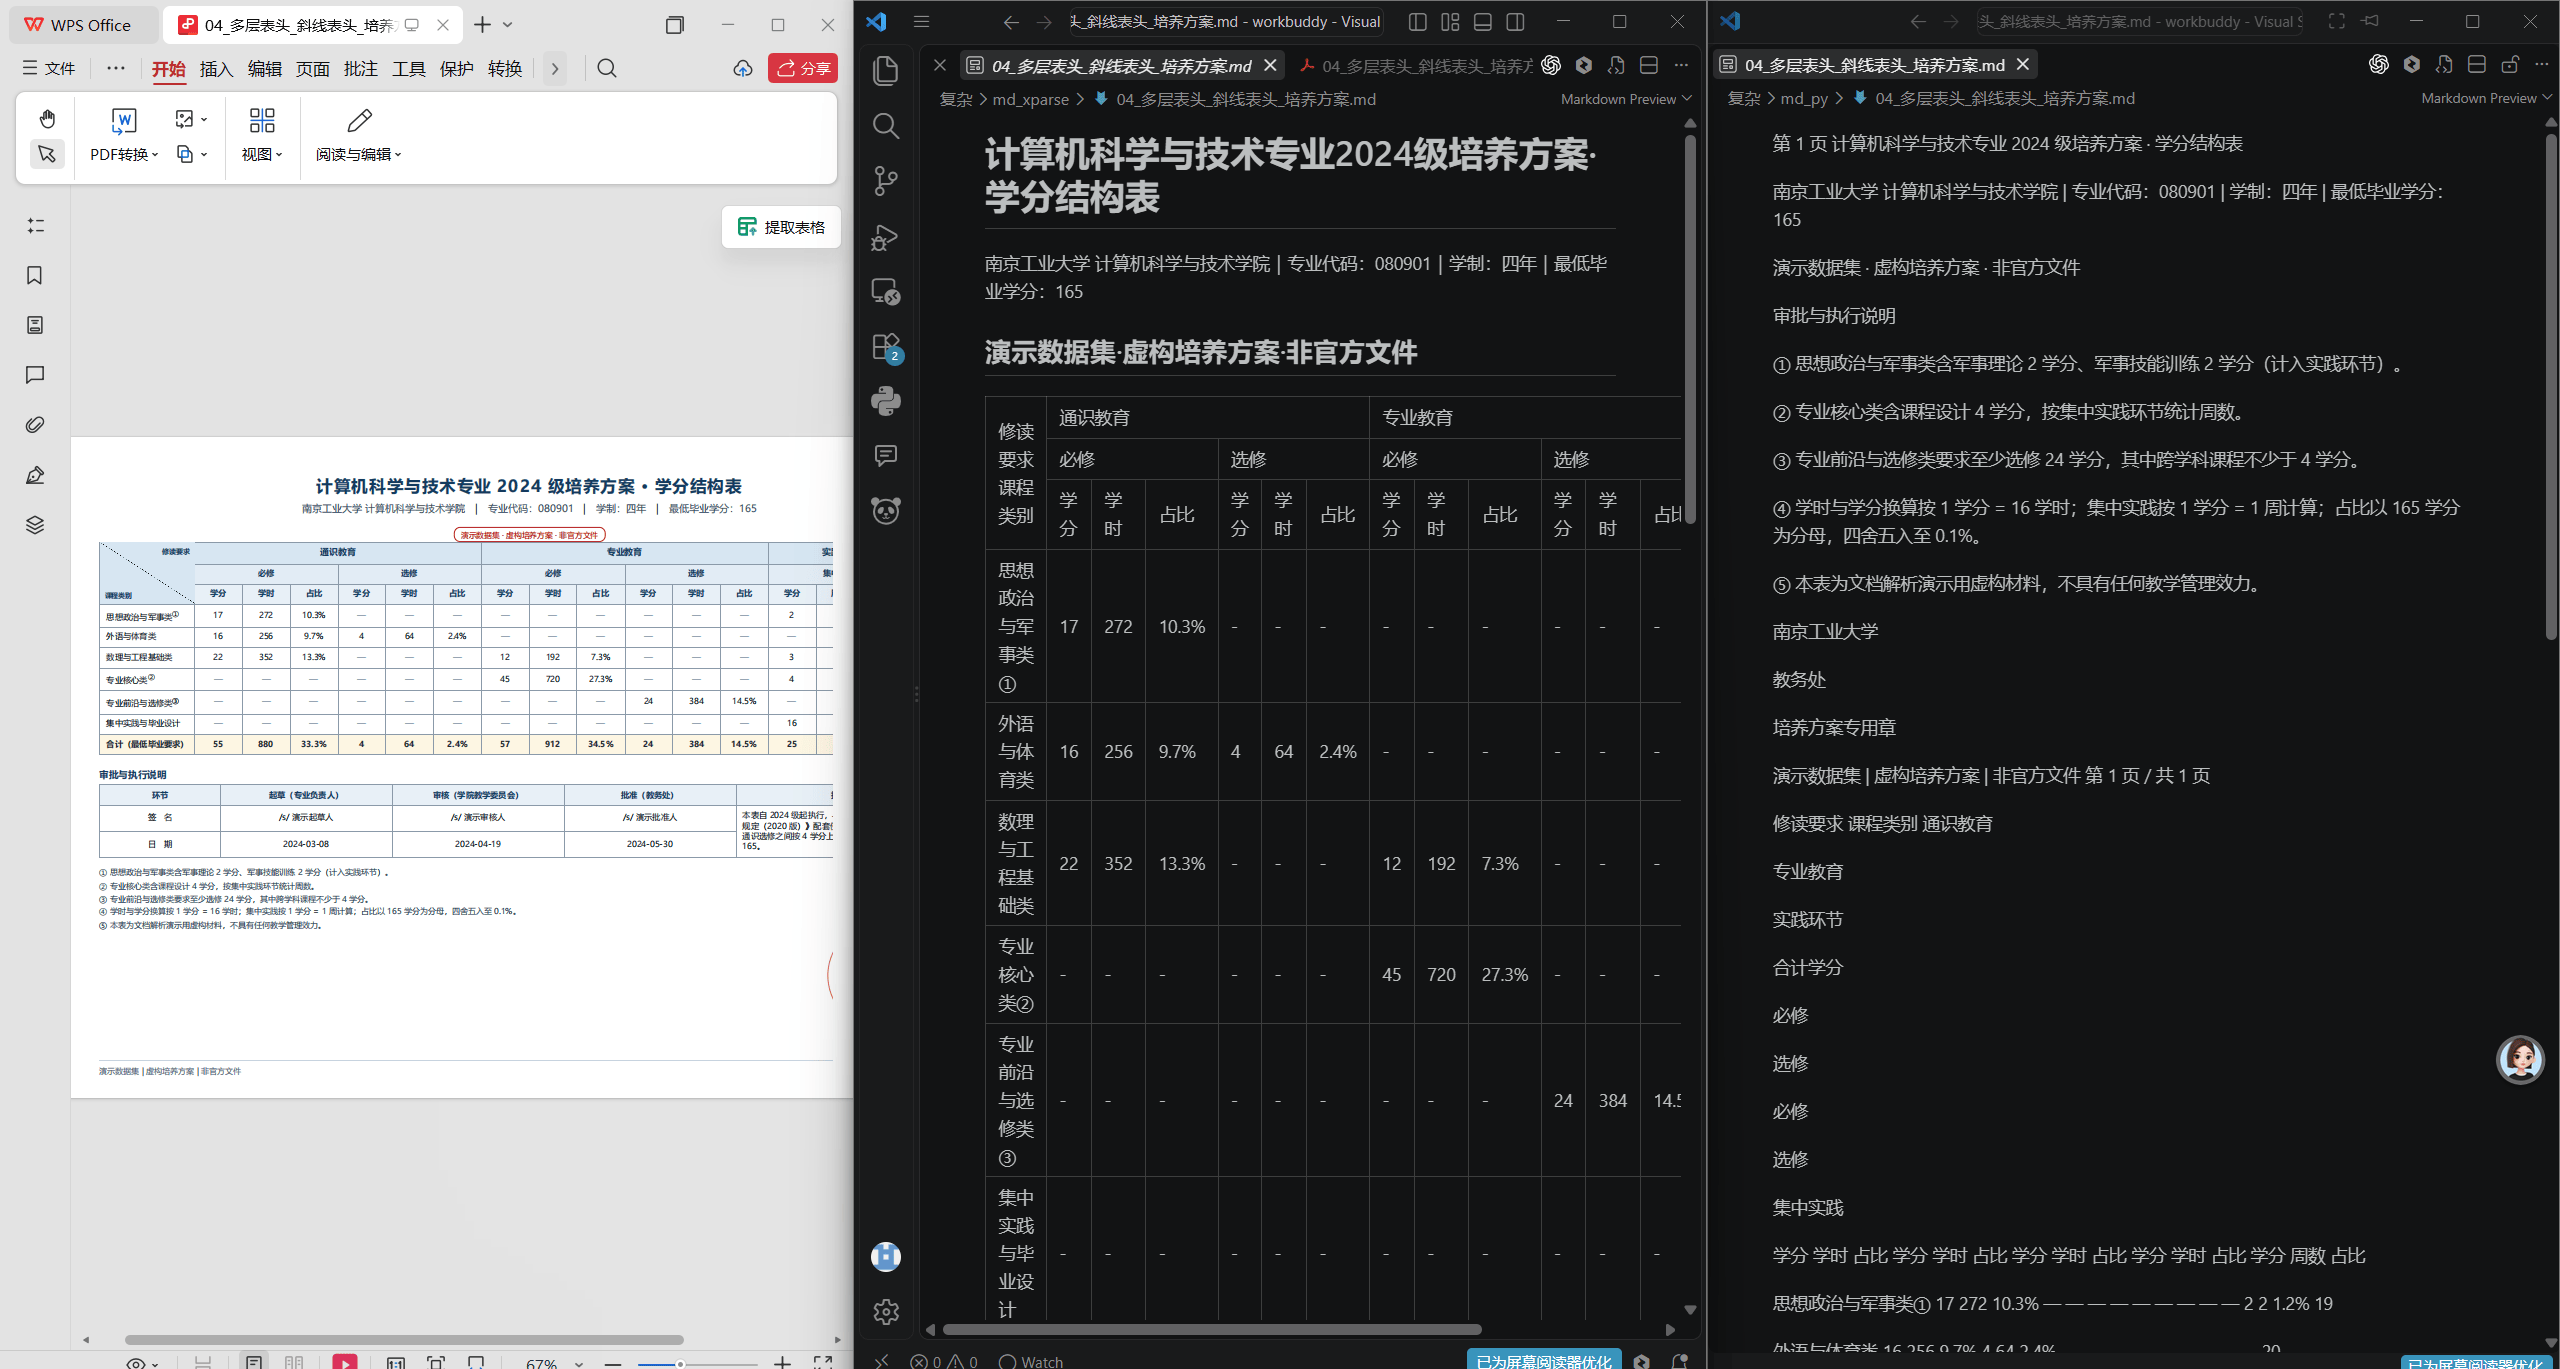
image.png
这份学分结构表属于那种看起来规整但实际很麻烦的表格——有合并单元格、有多级表头、有嵌套的子项分类。左边是原始 PDF 的样子,中间和右边分别是两种方式处理出来的结果。
中间 xParse 的输出,你能看到它用 table、td、tr 这些 HTML 标签做了完整的结构化处理。表格的层级关系保留得很清楚:哪些单元格是合并的、哪些是表头、哪些是数据行,一目了然。每一列的宽度对齐也很整齐,数字和文字都在该在的位置上。如果你后续要把这些数据导入到 Excel 或者数据库里,直接解析这个结构化的输出就行,基本不用二次清洗。
右边 AI 脚本处理的结果,问题就比较明显了。首先是表格结构丢失——原本的合并单元格被拆散成了零散的文字,你分不清哪些数据是属于同一行的。其次是排版错位——有些列的对齐出了问题,本该在同一行的数据跑到了不同行,导致你很难对应起来看。最麻烦的是,如果你想从里面提取某个具体数值(比如某门课的学分是多少),你得在一堆散乱的文本里手动去找,效率很低。
这种差异在实际使用中会被放大。假设你要核对 20 门课的学分加起来是不是等于总学分要求,用TextIn xParse 的结果可以直接遍历表格节点求和;用右边那个结果,你可能得先花半小时人工整理一遍数据格式才能开始算。
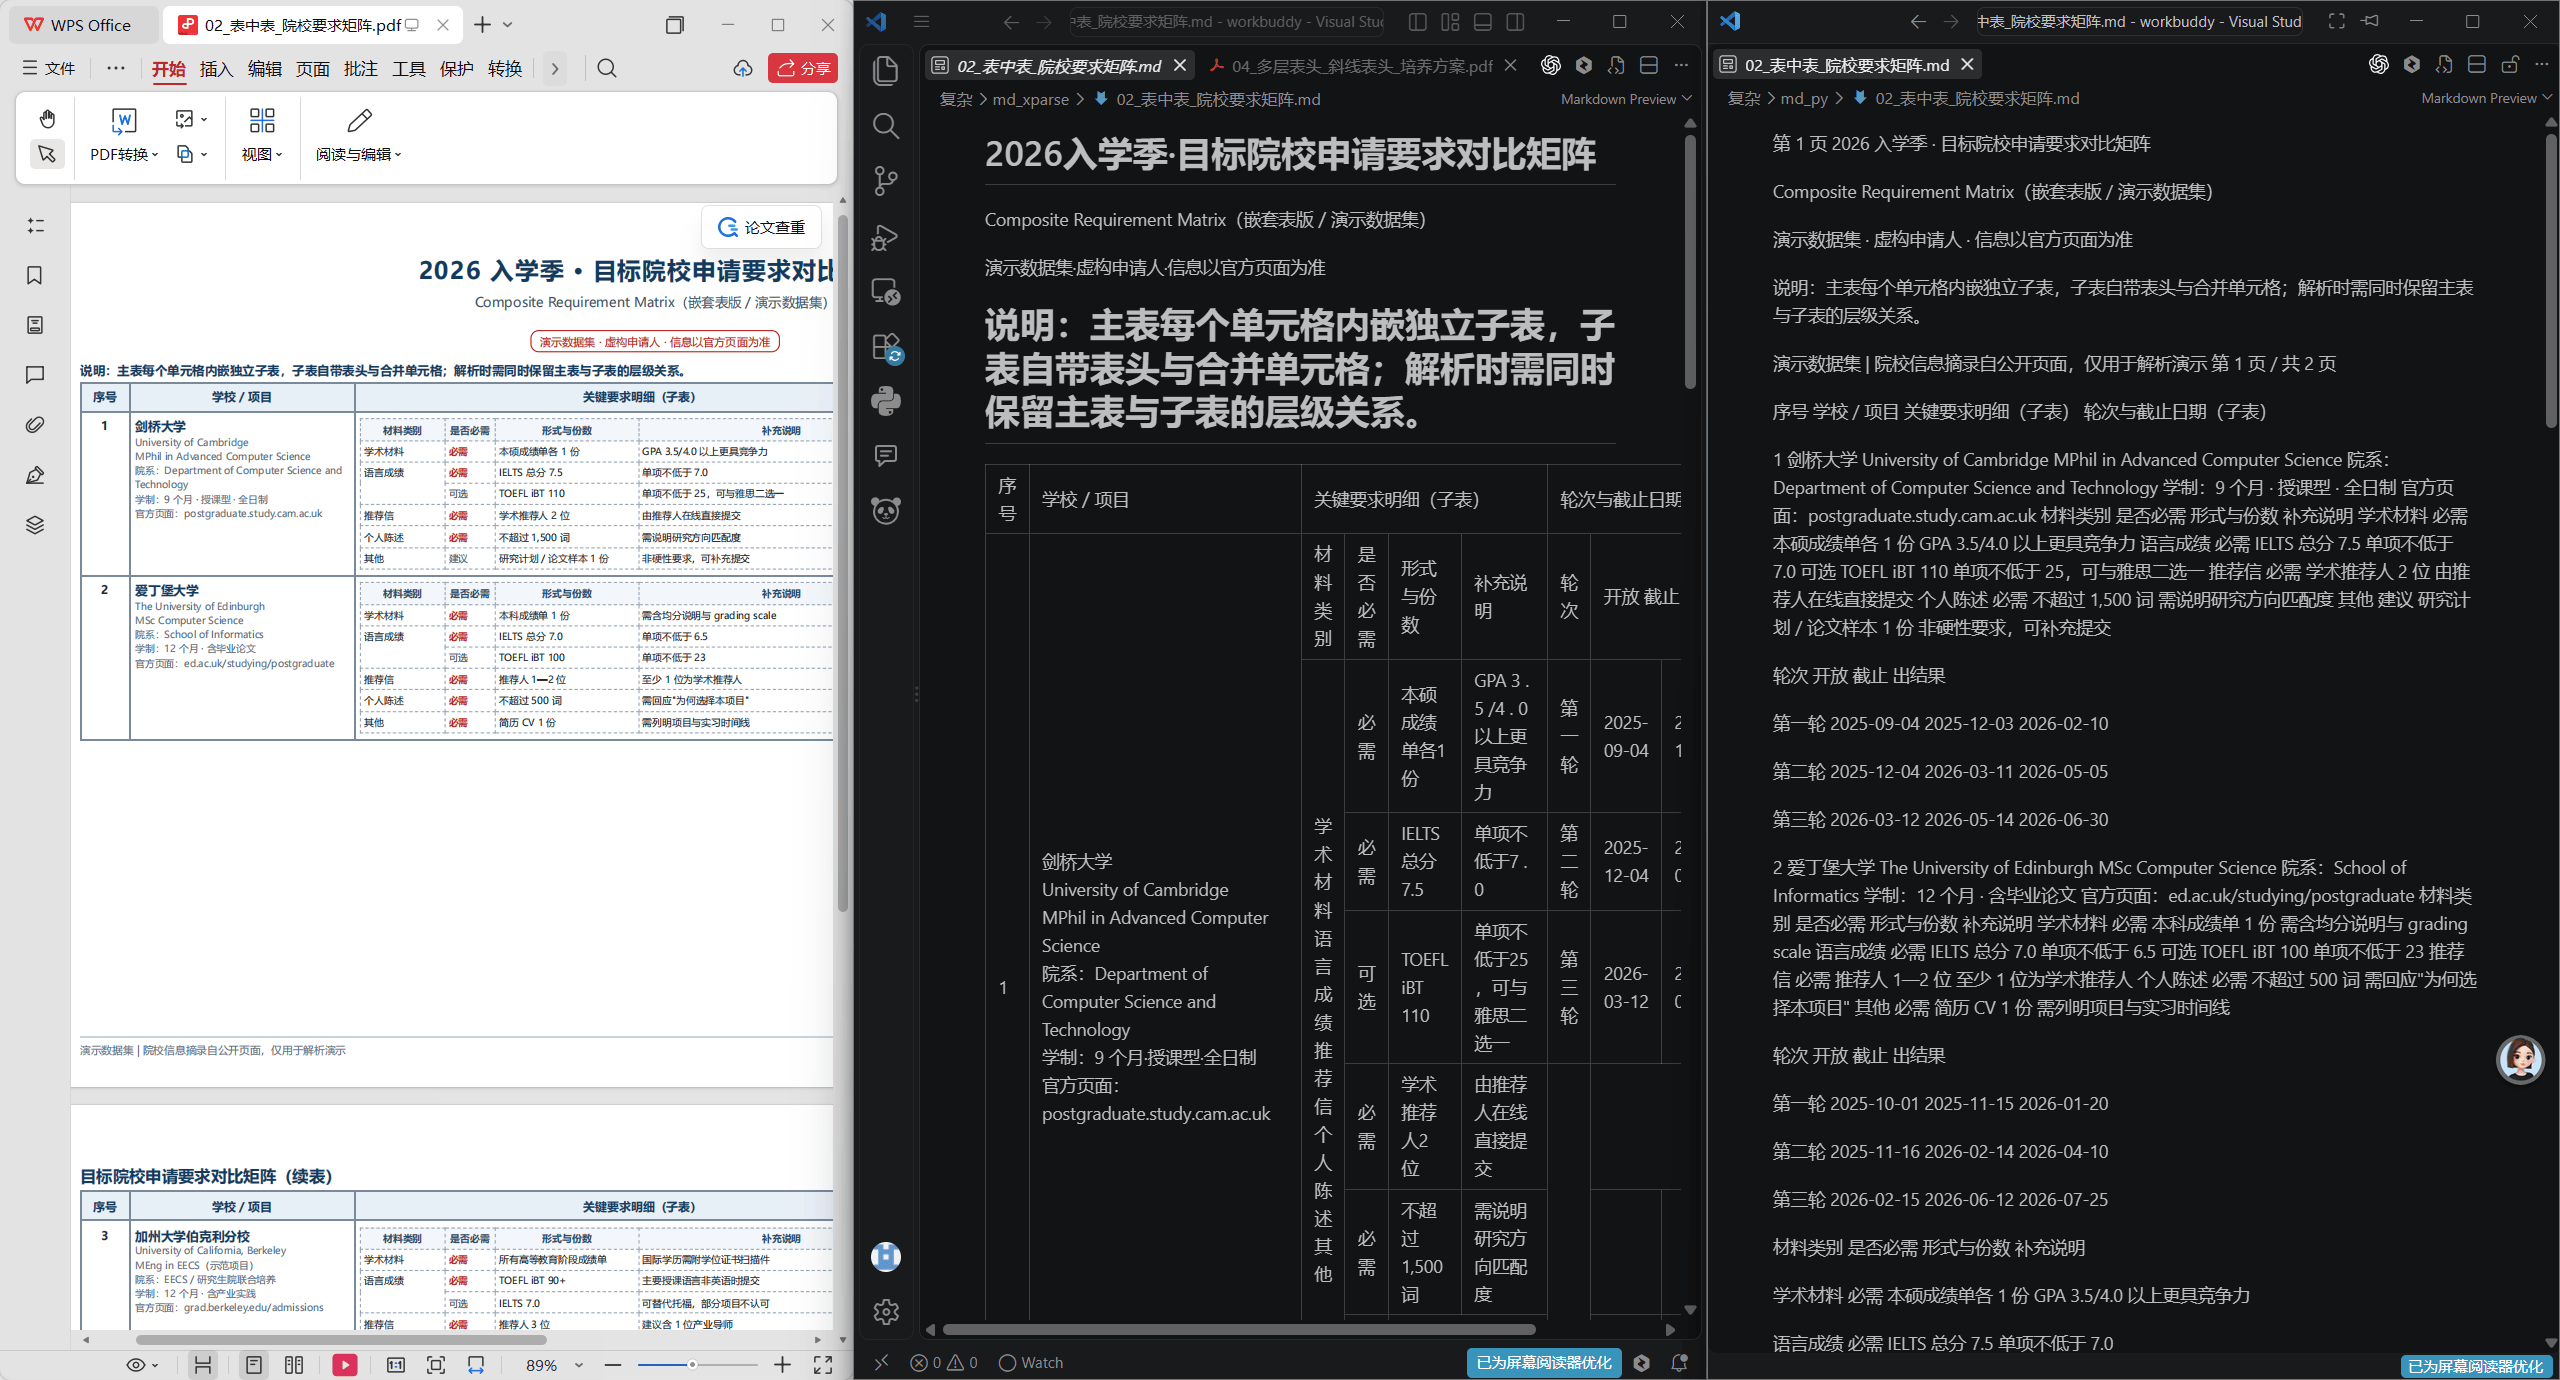
对比三:目标院校申请要求对比矩阵
d332049f1ff7dbc70353a228a87111aa.png
这个对比矩阵是表中表的典型场景——大表格里嵌套着小表格,每个单元格里可能还包含列表、链接、状态标签等多种元素。这种结构的解析难度比普通表格高一个量级。
中间TextIn xParse 的处理结果,整个矩阵的框架非常清晰。横向是不同的目标院校(剑桥、Berkeley、爱丁堡等),纵向是各项申请要求(学术材料、语言成绩、推荐信、文书、费用等),交叉单元格里的内容完整保留了原始信息——包括具体的要求描述、是否已满足的状态标记、以及相关的备注说明。即使某个单元格里同时包含文字和表格嵌套,TextIn xParse 也能正确地分层呈现,不会混在一起。
右边 AI 脚本的输出就有点惨不忍睹了。嵌套结构几乎完全丢失——原本在大表格里面的小表格被"拍平"成了一堆连续的文本,你根本看不出哪个内容属于哪个单元格。状态标签和格式信息也丢了——原来用颜色区分的"已满足""待确认""缺失"等状态,在纯文本输出里变成了没有语义的普通文字。更糟糕的是,有些跨行跨列的内容被错误地重复输出了多次,或者干脆就找不到了。
如果你拿这个结果去生成前面展示的那个工作台报告,大概率会出问题——因为源数据本身就是乱的,基于它生成的分析结论自然也不可靠。这就是为什么我说 xParse 不只是"把 PDF 转成文字"那么简单,它在底层做的结构化处理,直接决定了上层应用的质量。
上面说了这么多,可能还是不够直观。我特意准备了三组并排对比——同一份文档,左边放原始 PDF,中间放开启 xParse 的解析结果,右边是 AI 脚本处理的结果。三张图摆在一起,差距一眼就能看出来。
测试:不开TextIn xParse,让 AI 自己解析文档
为了更全面地对比,我还做了一组测试——关掉TextIn xParse 开关,然后用同样的提示词和同样的文件夹路径,让 AI 来处理。
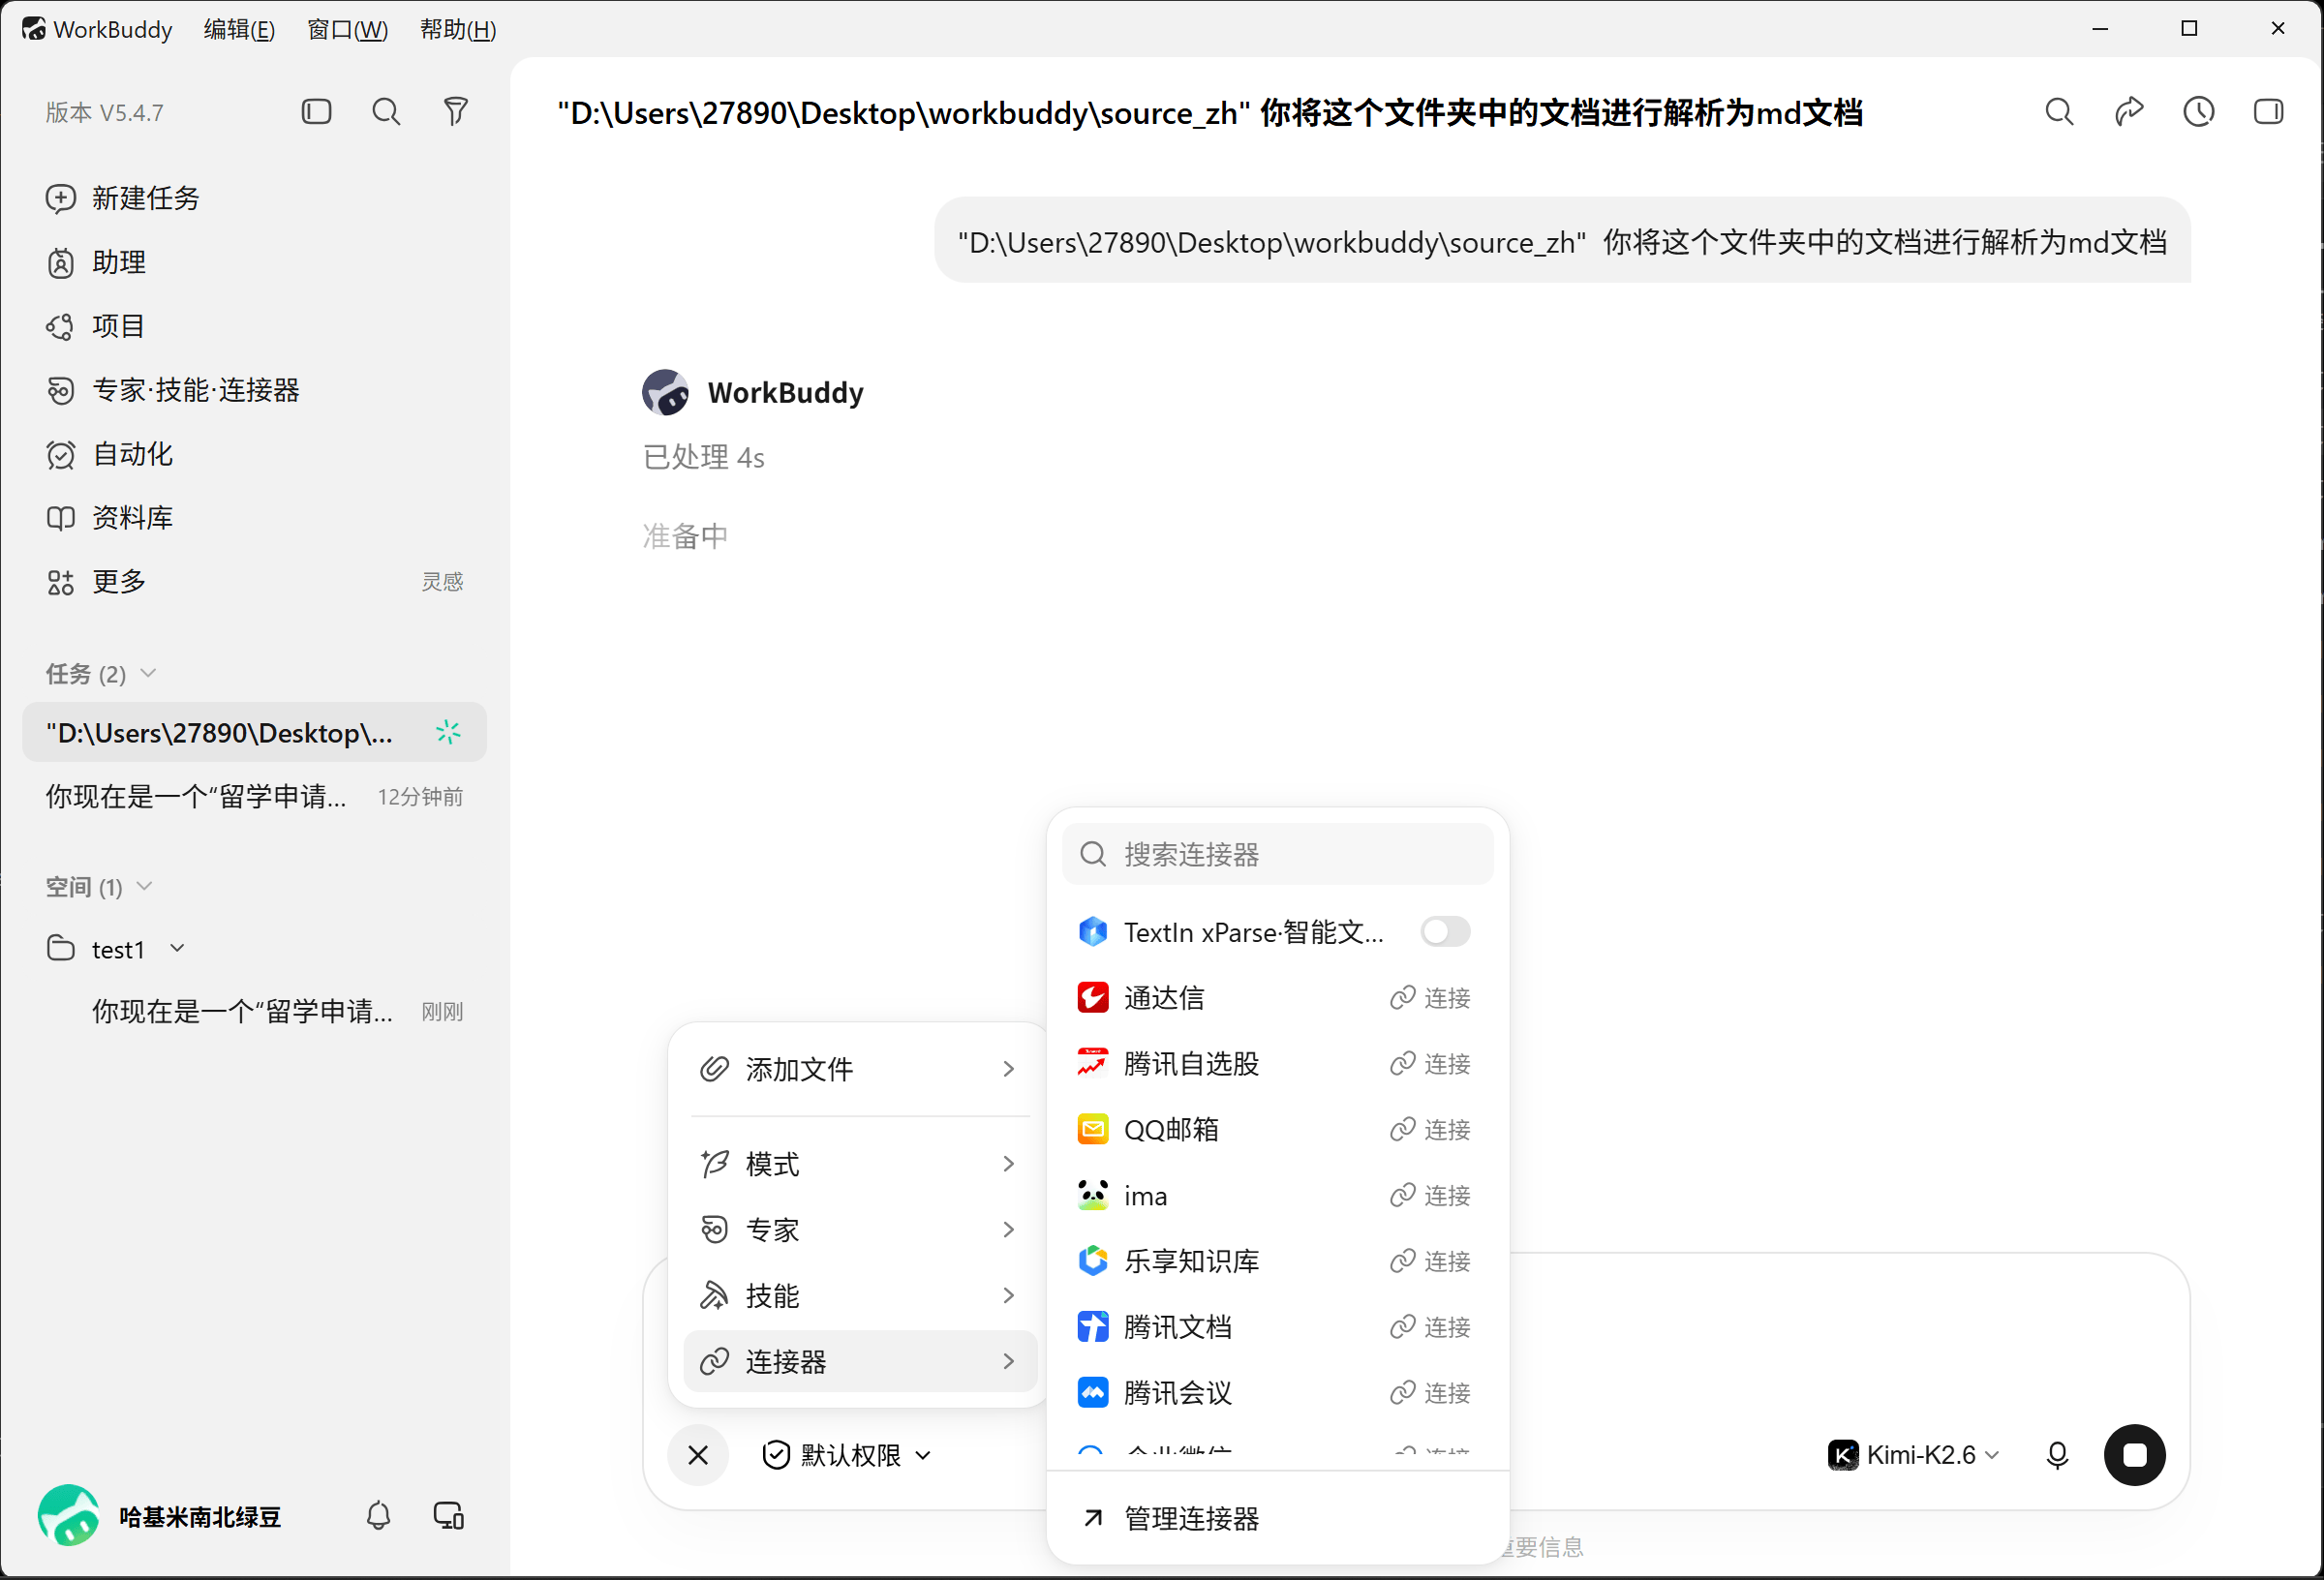
image.png
关掉之后,AI 发现自己没有现成的文档解析工具可以调用了,于是它决定自己动手。它的思路是写一个 Python 脚本来读取和解析各种格式的文件。
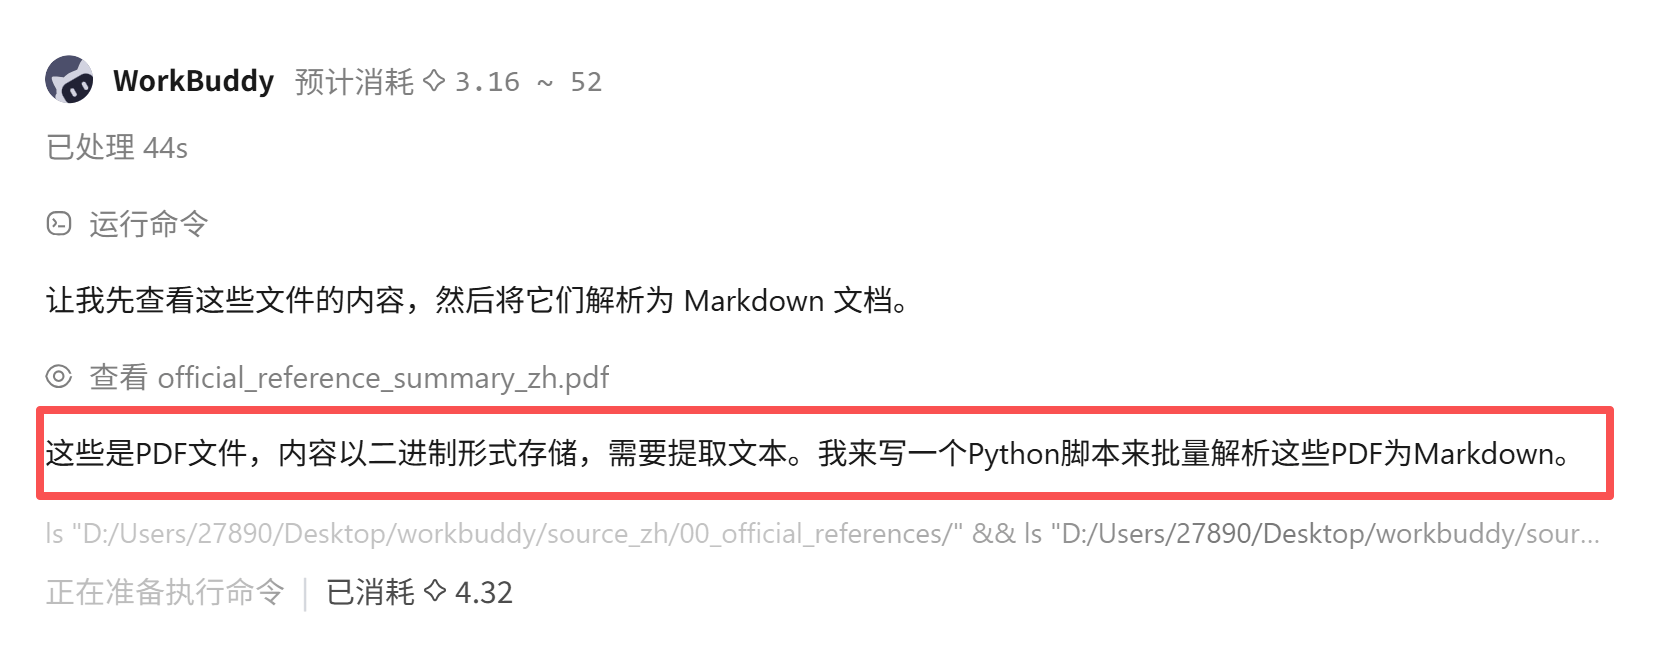
image.png
从界面输出可以看到,AI 正在生成 Python 代码,打算用 PyPDF2 来读 PDF,用 python-docx 来读 Word,用 openpyxl 来读 Excel,用 Pillow 来做 OCR……思路是对的,但问题是接下来它开始疯狂安装依赖包。
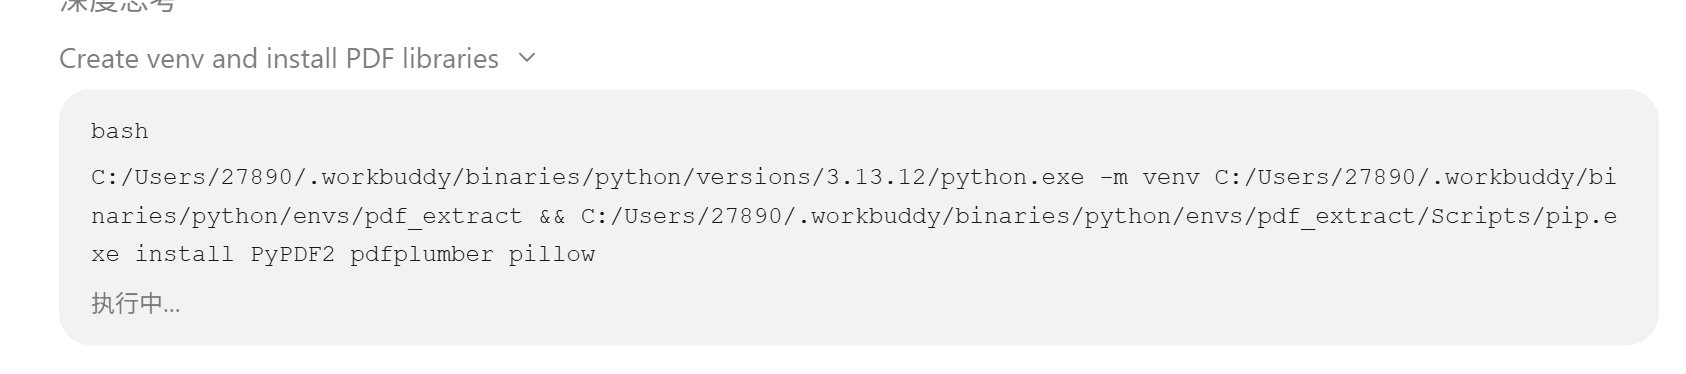
image.png
我的轻薄本风扇已经开始呼呼转了……安装过程持续了好几分钟,因为要下载和配置各种各样的库。
好不容易等它全部折腾完,文档倒是也解析出来了,但当我看到结果的时候,确实差距比较明显。
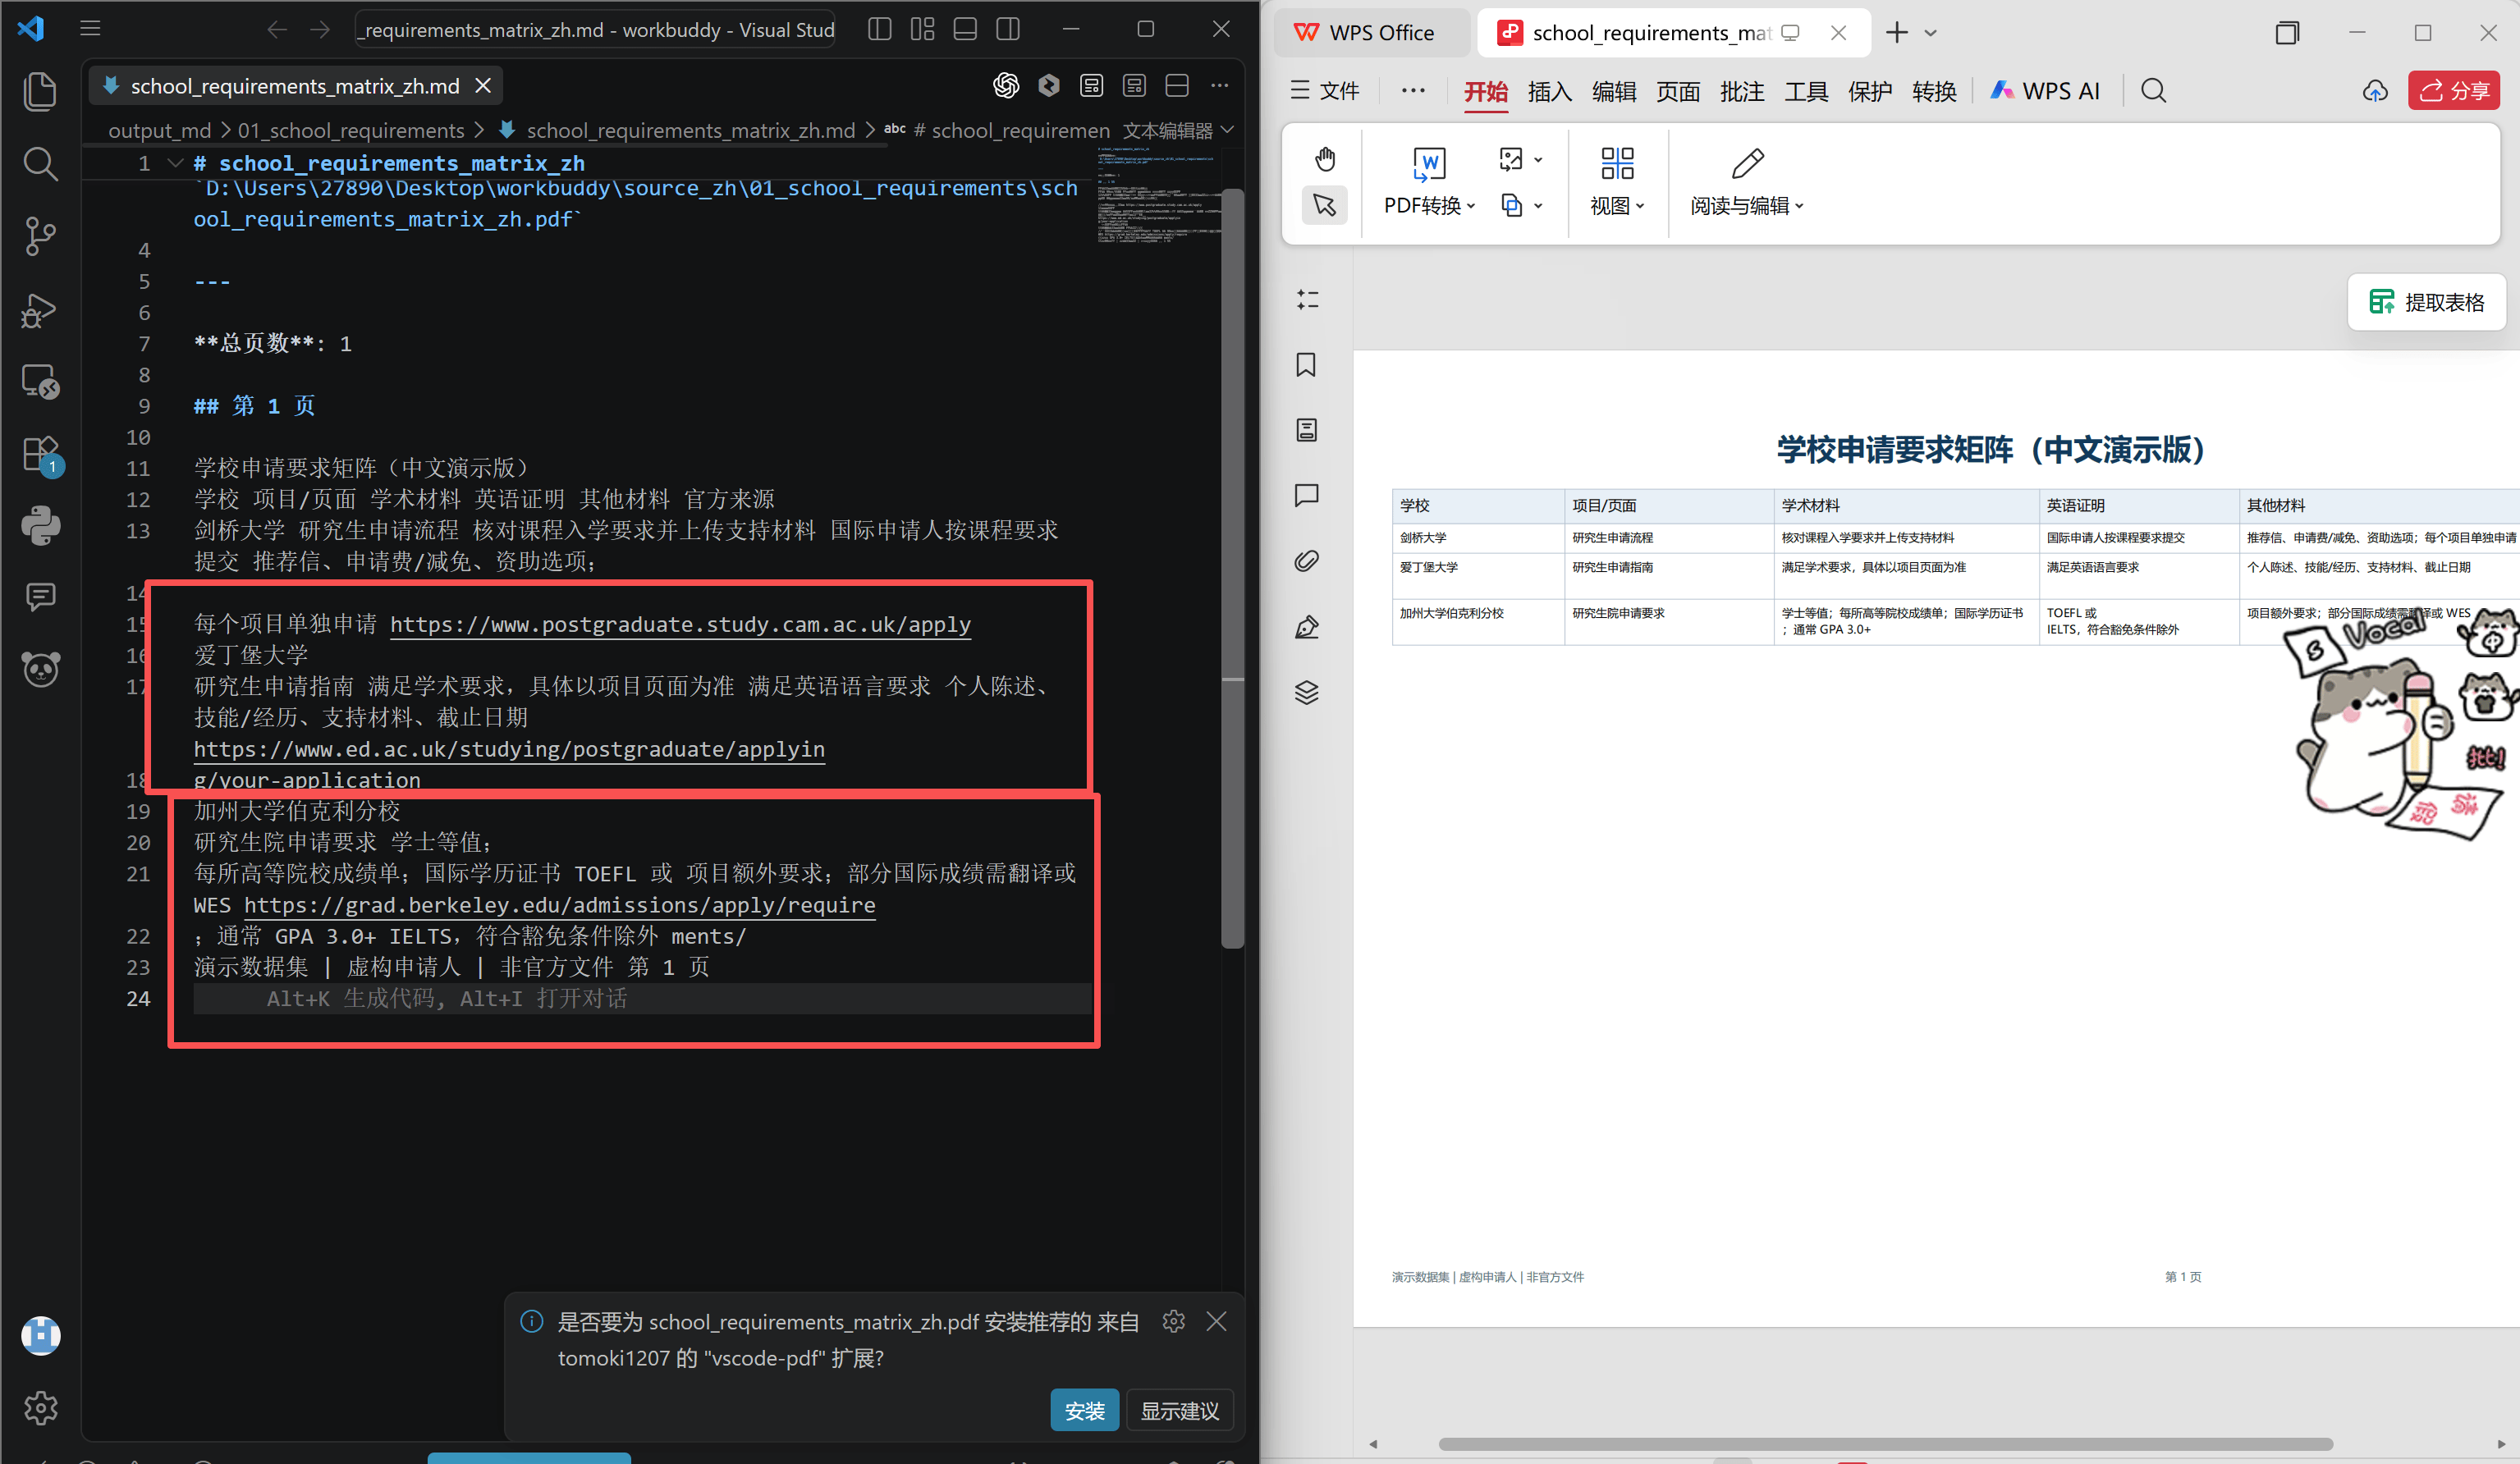
image.png
主要问题有这么几个:第一是速度慢很多,从开始到结束花了差不多三倍的时间;第二是排版混乱,有些表格的列对不齐,合并单元格的信息丢了;第三是准确率问题,有个别数字被错误识别了,可能是通用 OCR 引擎对复杂版面的处理不够好;第四是本地资源占用高,整个过程电脑都在嗡嗡响,内存占用也明显上升。
总结一下
我把几种方案的区别整理成表格:
对比维度 | TextIn xParse + AI | 纯 AI 直接读 |
解析速度 | 快,云端处理,本地等待时间短 | 慢,要写脚本、装依赖、本地运行 |
准确率 | 高,专业 OCR 引擎,表格还原精准 | 一般,通用库对复杂格式支持有限 |
表格处理 | 跨页表格自动合并,单元格对齐正确 | 容易错位、合并单元格丢失 |
排版还原 | Markdown 格式,标题层级、列表完整 | 排版混乱,经常丢失结构 |
资源占用 | 低,主要在云端处理 | 高,本地 CPU/内存占用大 |
多语言支持 | 中英文都很好 | 英文还行,中文复杂版面容易出问题 |
上手难度 | 开箱即用,一键解析 | 需要 AI 自行编写代码调试 |
说白了就是一句话:TextIn xParse 干的是专业的事,AI 干的是分析的事。让专业的人干专业的事,各司其职,效率和质量自然都上去了。
为什么我说 TextIn xParse 是"AI 数据层基础设施"
经过这次实际搭建和完整测试,我对官方说的"数据层基础设施"这个定位有了更深的理解,也更能体会到这个定位的准确性。
很多人第一反应会觉得,文档解析不就是个 OCR 吗?把图片里的字转成文本就行了。但实际用下来你会发现,AI 要真正"读懂"一份文档并且基于文档内容做出准确的判断和分析,光有裸文字是远远不够的。
我来举几个具体的例子:
第一个问题:这段文字到底是什么角色?
一份文档里有标题、副标题、正文、注释、页眉页脚……如果只是把文字提取出来,AI 分不清哪段是标题哪段是正文,就没法理解文档的层次结构。xParse 会把这些都标注清楚,输出的 Markdown 里 # 就是一级标题,## 就是二级标题,正文就是普通段落。
第二个问题:这个区域是表格还是列表?
文档里经常有表格,而且表格还可能很复杂——有合并单元格、有嵌套表、有跨页表格。如果只是简单提取文字,表格就变成了一堆散乱的文字,行列关系全乱了。TextIn xParse 会把表格转化成标准的 Markdown 表格或者结构化 JSON,行列关系保持得清清楚楚。
第三个问题:这个数字到底代表什么?
文档里到处都是数字——日期、金额、电话号码、学号、GPA、考试成绩……光看到一个数字 "2024" 你知道它是年份还是分数还是什么别的吗?xParse 做的字段抽取会同时保留字段的语义标签,让 AI 知道这个 "2024" 是入学年份,那个 "3.85" 是 GPA。
第四个问题:这份文档的整体结构是什么?
长文档通常有目录、章节、附录。TextIn xParse 能还原文档的目录结构,让 AI 知道这份文档有几章、每章讲什么、某个内容在第几章第几节。
除了上面说的这些基础能力,TextIn 对复杂格式的解析支持也非常强。比如合并单元格、表中表(表格里嵌套表格)、跨行表格、图文混排这些让人头疼的版面,它都能正确处理。
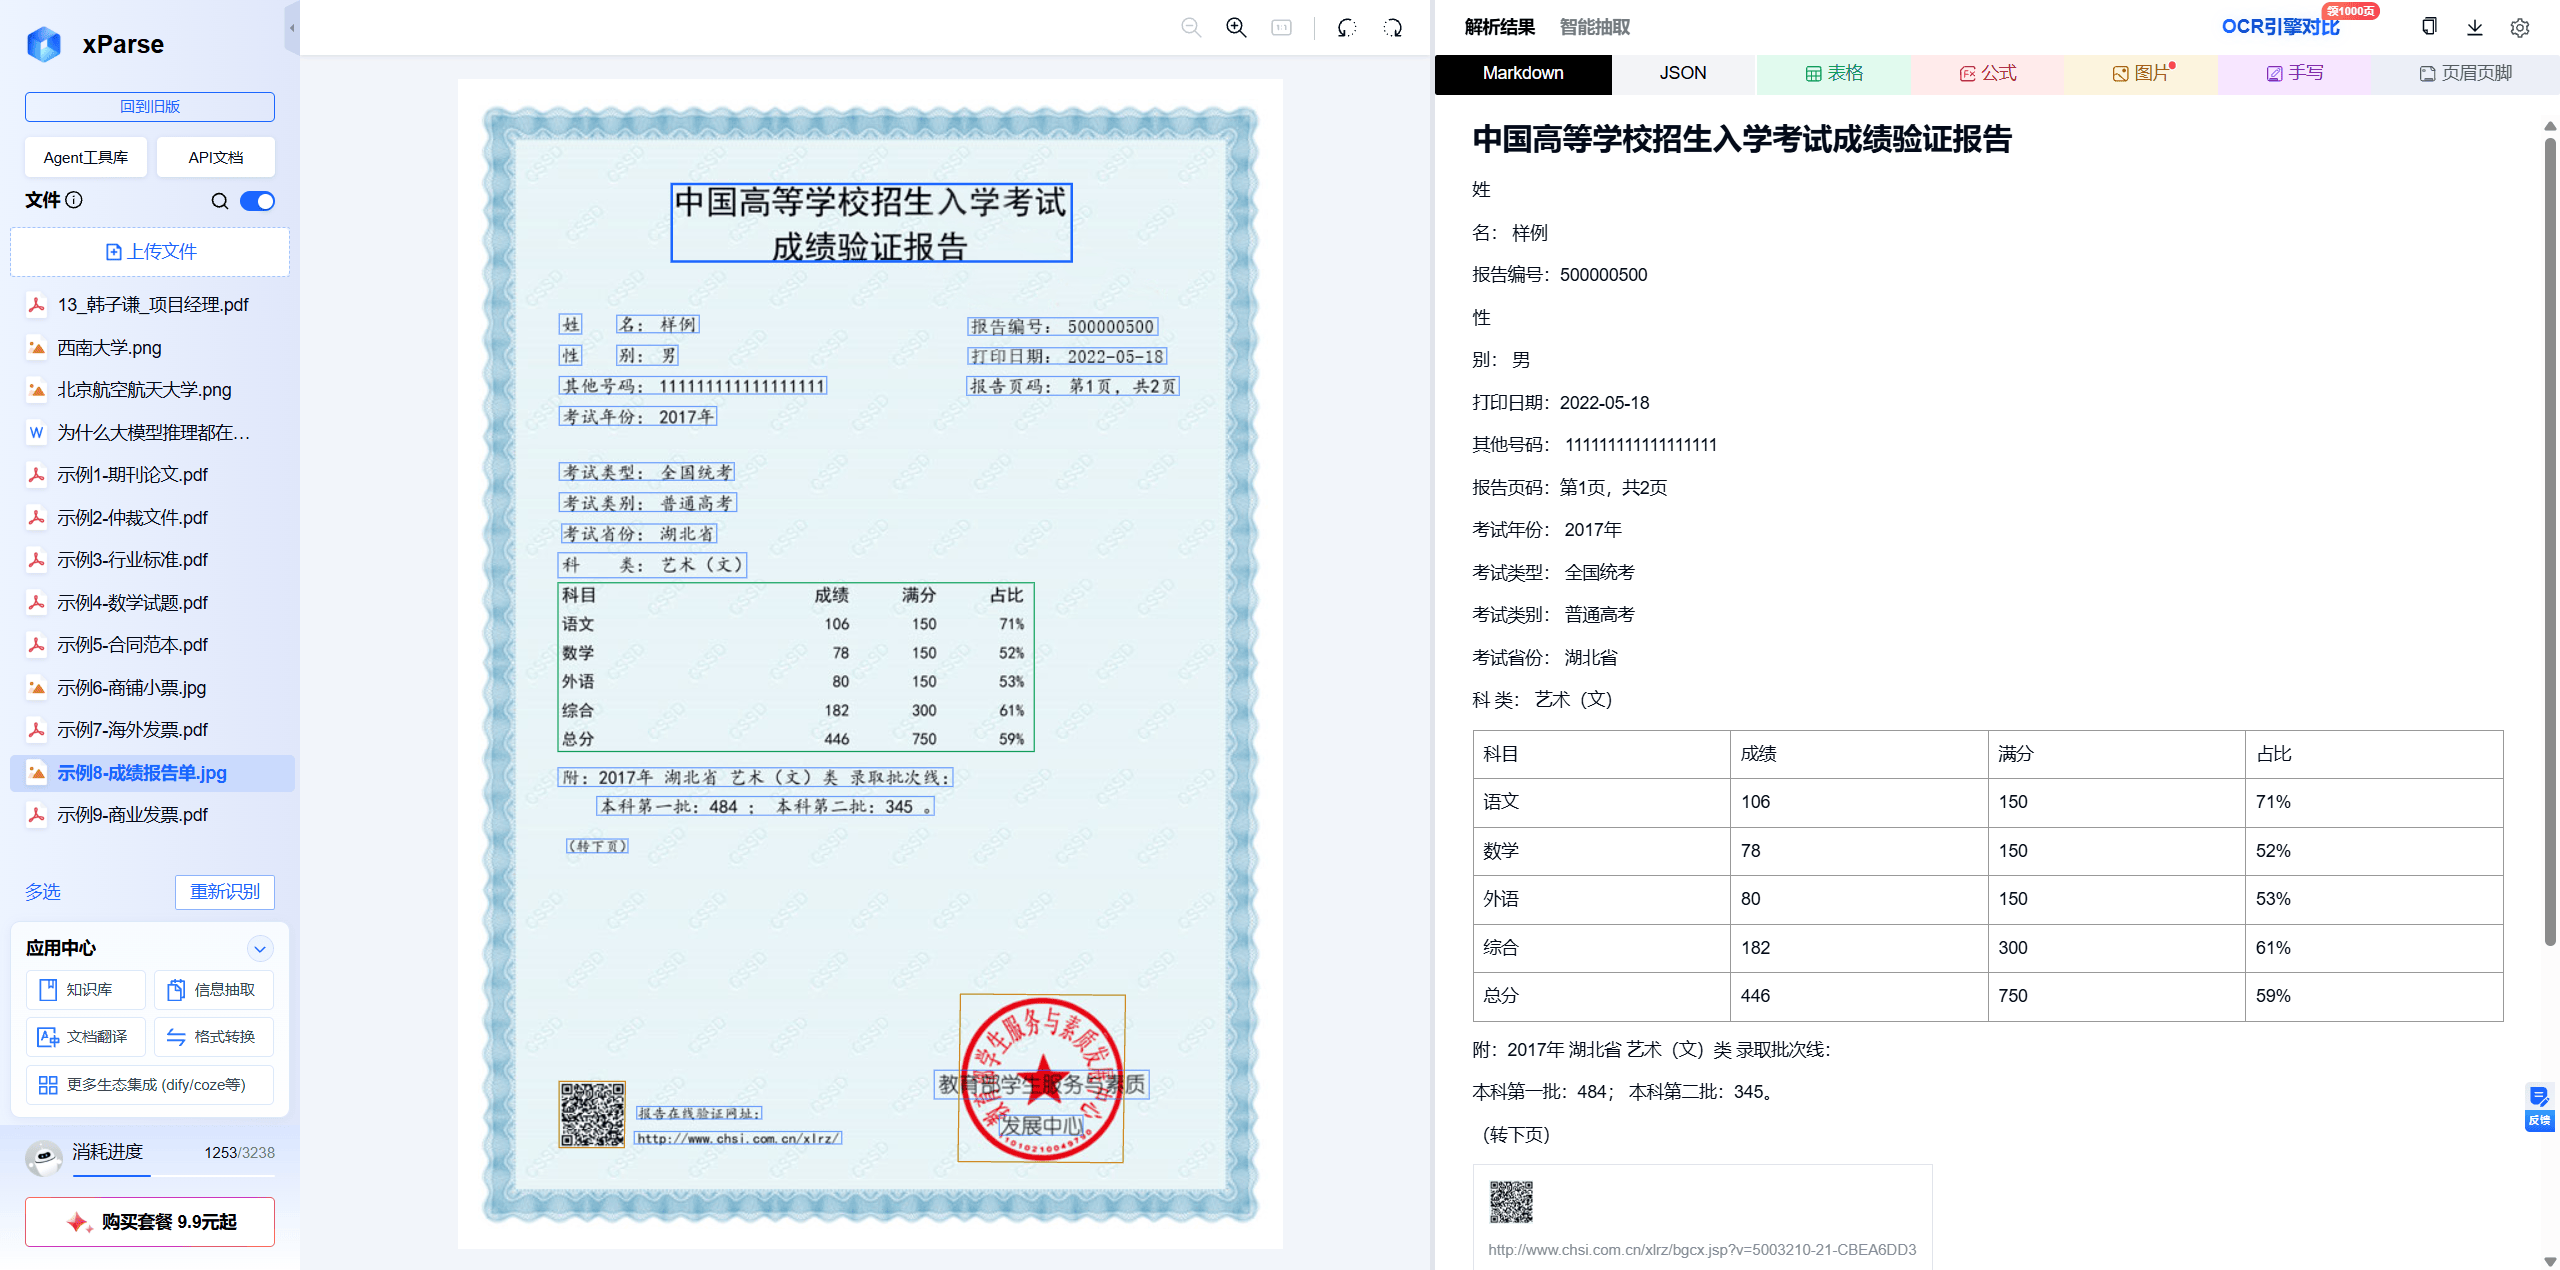
image.png
这些事情,xParse 都帮你在底层处理好了。它交给 AI 的不是一堆乱糟糟的文字,而是有结构的、语义清晰的、可以直接使用的数据。
这就是为什么叫它"基础设施"——就像城市里的水电煤一样,平时你可能不会特意想到它,但它就在那里默默支撑着上层的一切运行。没有它,上面的应用要么跑不起来,要么跑起来也是磕磕绊绊。
写在最后
如果你也在处理大量文档——不管是为了留学申请做材料核对、还是合同审核、财务报销、简历筛选、或者搭建企业知识库——真心建议试试 TextIn xParse。
搭配 WorkBuddy 这种 AI 工具平台,你不需要会编程,不需要懂什么 OCR 或者 NLP 的技术原理,按照我今天分享的步骤,下载安装、搜连接器、装好授权、输提示词、给路径,就这么几步,一个能干的智能体就搭好了。
每天免费 1000 页,个人使用或者小团队使用基本够用了。如果量大再考虑升级付费套餐。
工具链接再放一次:https://www.textin.com/market/detail/xparse
有问题欢迎交流,评论区见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号