【实战】1222 张老照片、4 个文件夹、20 年同学会:我用 WorkBuddy 把"一锅粥"素材理成了一条时间线
原创
【实战】1222 张老照片、4 个文件夹、20 年同学会:我用 WorkBuddy 把"一锅粥"素材理成了一条时间线
原创
用户12757959
发布于 2026-09-11 18:04:07
发布于 2026-09-11 18:04:07
【实战】1222 张老照片、4 个文件夹、20 年同学会:我用 WorkBuddy 把"一锅粥"素材理成了一条时间线
关键词:#WorkBuddy #AI办公 #自动化 #生活场景 #效率工具 字数:约 2200 字|建议配图 4 张(文中已标出截图位置)
目录
- 前言:一次真实的"素材灾难"
- 先说结果
- 我是怎么下第一条指令的
- 照片整理:它到底做了什么
- 从"一堆照片"到"一份视频脚本"
- 三个真实踩坑,帮你避雷
- 成本与性价比
- 写在最后
一、前言:一次真实的"素材灾难"
今年是我们大学毕业 20 周年。聚会要做一个开场视频,这个活落到了我头上。真正打开电脑那一刻,我才发现事情有多崩溃:
- 从 QQ 相册、旧硬盘、同学微信群里扒下来的照片,散落在 4 个大文件夹里,一共 1222 张;
- 命名完全混乱:手机导出的
IMG_xxxx、相机导出的DSCxxxx/LPICxxxx,还有中文名的"照片 115.jpg""未命名-129.jpg"; - 时间线是乱的——2002 年入学、2006 年毕业、2016 年十周年,三个阶段的照片混在一起;
- 大量连拍废片、模糊图,同一张照片还在不同文件夹里各存了一份。
手工理?我估算了一下,光是"看一遍"就要两三个小时,更别说分类、去重、挑片、写文案。
最后,我把这件事整个丢给了 WorkBuddy。
二、先说结果
一次对话下来,我拿到了:
- 4 个按时间排序的文件夹:
01-大学日常/02-学位授予/03-毕业聚餐/04-十周年聚会——文件夹编号就是叙事顺序; - 每个文件夹一份精选:从 1222 张里挑出 180 张,并附一份《精选报告》,逐张标注清晰度分值和入选理由;
- 一份约 7 分钟的开场视频脚本:6 段式情绪时间轴 + 逐段分镜 + 配乐建议 + 剪映合成步骤;
- 一份旁白文案全文,以及一份可直接喂给剪映"图文成片"的文案。
从下指令到拿到脚本,总共一个多小时,中间我只补充了几次信息。
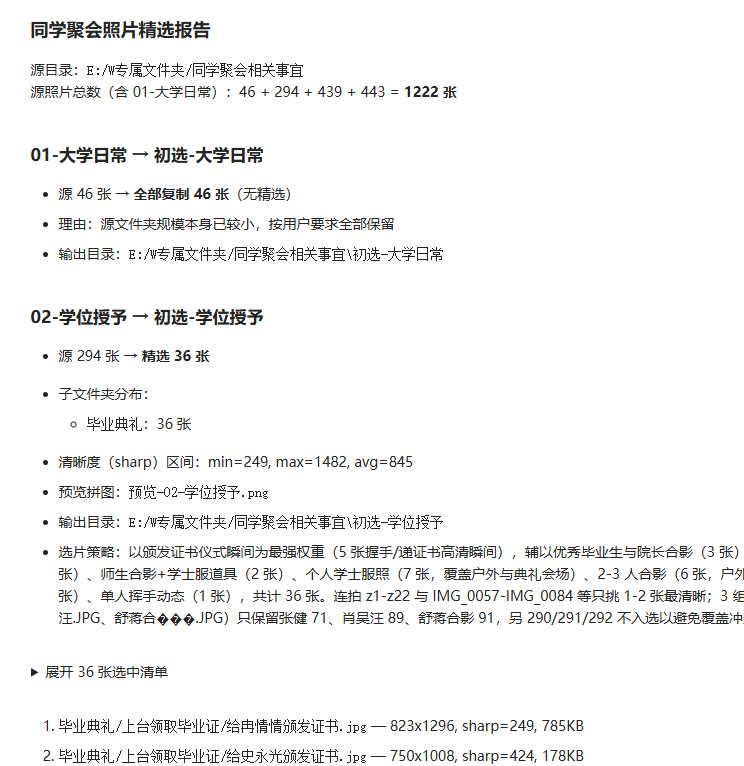
精选报告截图1
三、我是怎么下第一条指令的
这里是最关键的一步。我一开始也没指望它能干这么细,第一条指令其实很朴素:
"这个文件夹里是我同学聚会的照片,很乱。帮我按时间顺序整理一下,分成几个阶段,每个阶段一个文件夹。"
但真正让它把活干漂亮的,是后面追加的几条约束:
- 告诉它叙事顺序:"按我视频要讲的顺序排:大学日常 → 毕业授学位 → 毕业聚餐 → 十周年聚会,文件夹用 01/02/03/04 编号。"
- 告诉它挑选标准:"不要全部保留,帮我做精选。清晰度低的、模糊的、连拍重复的去掉,每个阶段留最能代表当时场景的。"
- 告诉它最终目的:"我最终要做一个 7 分钟的开场视频,请按叙事的需要来选片。"
最后一条特别有用。它让模型知道了"终点",选片逻辑立刻从"随手删"变成"为剪辑服务"——比如它会在报告里专门标注"这段是情绪谷底""这张适合做实定格高潮"。
四、照片整理:它到底做了什么
1. 先摸清家底,再动手
它没有一上来就乱复制,而是先统计出源结构:46 + 294 + 439 + 443 = 1222 张,并识别出每个大文件夹里的真实内容和子文件夹分布。
2. 用"清晰度分值"客观挑片
这是我觉得最专业的一点。它给每张照片算了一个 sharp(清晰度)分值,例如:
- 学位授予段:min 249 / avg 845 / max 1482
- 十周年段:min 266 / avg 694 / max 1627
模糊的(分值低的)直接淘汰,同一场景的连拍只留最清晰的一两张。
3. 处理"重名"和"连拍"这两个经典坑
- 重名冲突:多个文件夹里都有
张健.JPG、照片 004.jpg这种同名文件。它逐组比对后只保留最清晰的一张,避免复制时互相覆盖; - 连拍控制:像"围站合影 30+ 连拍""拥抱长连拍 20+ 张"这种,它规定每组只取 1~4 张,避免出现"同一个人连刷 30 张"的尴尬。
4. 输出一份可核对的《精选报告》
它给每个阶段都写了一段"选片策略",说明为什么留这些、为什么砍那些。比如毕业聚餐段,它的策略是"以举杯干杯 / 大笑 / 群组热闹为第一优先级"。这份报告让我一眼就能看出它有没有挑错,而不必自己再翻一遍 1222 张。
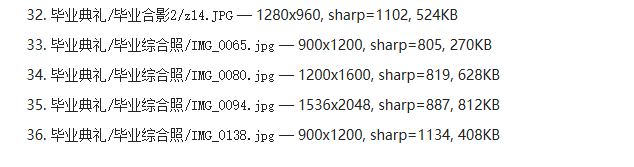
精选报告截图2
五、从"一堆照片"到"一份视频脚本"
照片理完之后,我接着说了一句:"现在帮我写开场视频的文案。"
它给我的不是一段干巴巴的说明文字,而是一份完整的视频脚本:
- 一句话主题:"2002 年我们走进马房山,2006 年我们各奔天涯——今晚,二十年,我们回来了。"
- 6 段式情绪时间轴:庄重 → 青涩温暖 → 荣光绽放 → 不舍离别 → 重逢热烈 → 温情升华;每段都标注了时长、用哪几张照片、配什么音乐;
- 逐段分镜:精确到"段②用照片 01–16,每张 3–4 秒,硬切 + 少量白闪""段③的高潮是毕业大合影,定格 6–8 秒";
- 配乐建议:连 BPM 和音量包络都给了("段⑤副歌最高 +5dB,给主持人留话口");
- 剪映实操步骤:素材怎么导入、怎么卡点、转场怎么选、导出什么分辨率。
说实话,这几段文案我基本是"抄作业"——直接拿去当剪辑的施工图。
五、从"一堆照片"到"一份视频脚本"
照片理完之后,我接着说了一句:"现在帮我写开场视频的文案。"
它给我的不是一段干巴巴的说明文字,而是一份完整的视频脚本:
- 一句话主题:"2002 年我们走进马房山,2006 年我们各奔天涯——今晚,二十年,我们回来了。"
- 6 段式情绪时间轴:庄重 → 青涩温暖 → 荣光绽放 → 不舍离别 → 重逢热烈 → 温情升华;每段都标注了时长、用哪几张照片、配什么音乐;
- 逐段分镜:精确到"段②用照片 01–16,每张 3–4 秒,硬切 + 少量白闪""段③的高潮是毕业大合影,定格 6–8 秒";
- 配乐建议:连 BPM 和音量包络都给了("段⑤副歌最高 +5dB,给主持人留话口");
- 剪映实操步骤:素材怎么导入、怎么卡点、转场怎么选、导出什么分辨率。
说实话,这几段文案我基本是"抄作业"——直接拿去当剪辑的施工图。
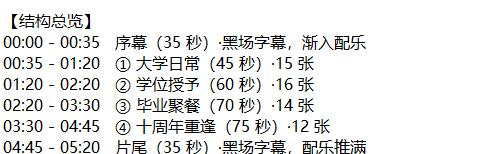
脚本截图
六、三个真实踩坑,帮你避雷
坑 1:不要让 AI 猜你的叙事顺序。 我第一版没说清"时间线",它按文件修改时间排了,结果十周年的照片跑到了毕业照前面。一定把顺序明明白白写出来。
坑 2:给标准,别给感觉。 "帮我挑好看的照片"= 没用。"清晰度低的去掉、连拍只留代表帧、每个场景留 2~3 张"= 好用。AI 需要可执行的判据。
坑 3:先小批量试跑。 1222 张属于"巨量"操作。我的做法是让它先处理最小的那个文件夹(46 张)验证效果,确认没问题再放开全量。大任务先探路,别一把梭。
七、成本与性价比
- 照片整理、报告生成这类本地文件任务,单价很低,整轮整理 + 文案消耗很小;
- 新用户注册后可领免费积分(记得去官网个人中心 / 用量页手动领取,不会自动到账);
- 相对更贵的是图像 / 视频生成(比如把老照片做成动态镜头),按次计费,建议单独评估。
八、写在最后
20 周年聚会那天晚上,视频放到毕业大合影那一帧,台下安静了两秒,然后是一片掌声。
那一刻我觉得,把 1222 张照片"丢给 AI"这件事,值了。
它没有替我怀旧,但它把 20 年散落的记忆,重新排成了一条能被看见的时间线。这大概就是工具最好的样子。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号