DPO(Direct Preference Optimization,直接偏好优化)是 2023 年 NeurIPS 的一篇论文(Rafailov et al.)提出的方法,核心主张是:RLHF 里那个"先训奖励模型、再用 PPO 做强化学习"的两步流程,其实可以压成一步普通的监督学习。它现在是几乎所有开源对齐模型(Zephyr、Llama-3、Qwen 系列)的默认后训练算子。DPO 用分类损失训练模型,使其更偏好 chosen 回复而非 rejected 回复,不需要单独的奖励模型。
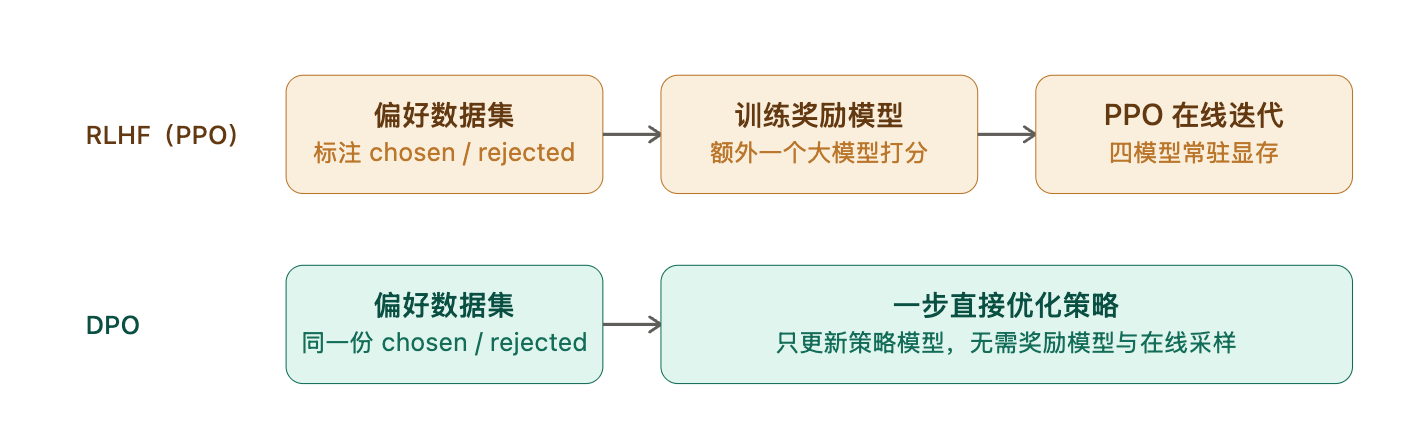
DPO 与 RLHF
DPO 直接优化策略,因此不再需要单独的奖励模型。它比经典 RLHF 更简单、更便宜,但要求基座模型已经与偏好数据同分布。
DPO 损失
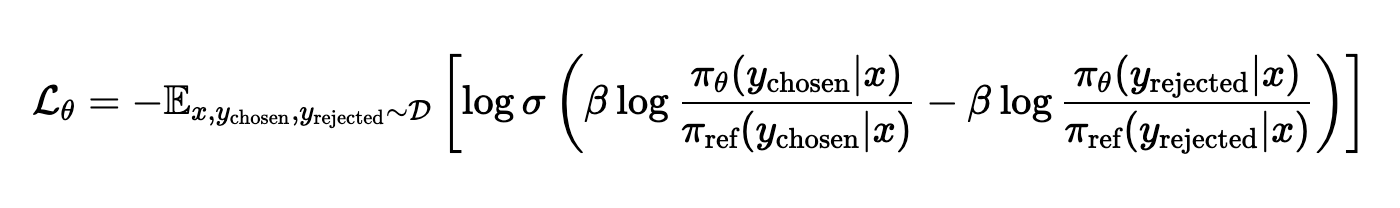
πθ — 正在训练的当前策略
πref — 参考模型(冻结,通常是 DPO 之前的检查点)
β — 控制偏好强度(越大越保守)
DPO: 偏好数据 chosen 与 rejected→参考策略π_ref(冻结)→DPO 损失β 加权→对齐后的模型π_θ
可用数据集
数据集 | 来源 | 说明 |
hhh | Anthropic | Helpful-Harmless-Honest 成对偏好数据 |
helpsteer3 | NVIDIA | HelpSteer3 偏好数据集 |
ultrafeedback | UltraFeedback | 二值化的偏好比较 |
关键超参数
dpo_beta:从 0.1 开始。取值越大越保守。learning_rate:比 SFT 更低,通常取 1e-5 到 1e-6。基座模型:应与偏好数据同分布。可以先做一轮轻量 SFT,或收集 on-policy 的偏好数据。
训练指标
dpo_loss:分类损失(应下降)accuracy:模型偏好 chosen 回复的频率margin:chosen 与 rejected 之间的平均奖励差chosen_reward / rejected_reward:平均隐式奖励延伸阅读
DPO 与偏好教程:动手实践、可交互的演练
RLHF 流程教程:带奖励模型的完整三阶段 RLHF
DPO Recipe:生产环境训练脚本


