RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)的核心思路是:让模型不只学"像人一样说话",而是学"说人喜欢的话"。它把难以写进损失函数的"偏好",例如“有用、无害、礼貌、简洁”学成一个可计算的奖励信号,再用强化学习去优化。
RLHF 通过一个三阶段流水线让语言模型与人类偏好对齐。每个阶段都建立在上一阶段之上:监督微调产出一个初始策略,奖励模型学习为输出打分,然后通过强化学习针对学到的奖励进行策略优化。
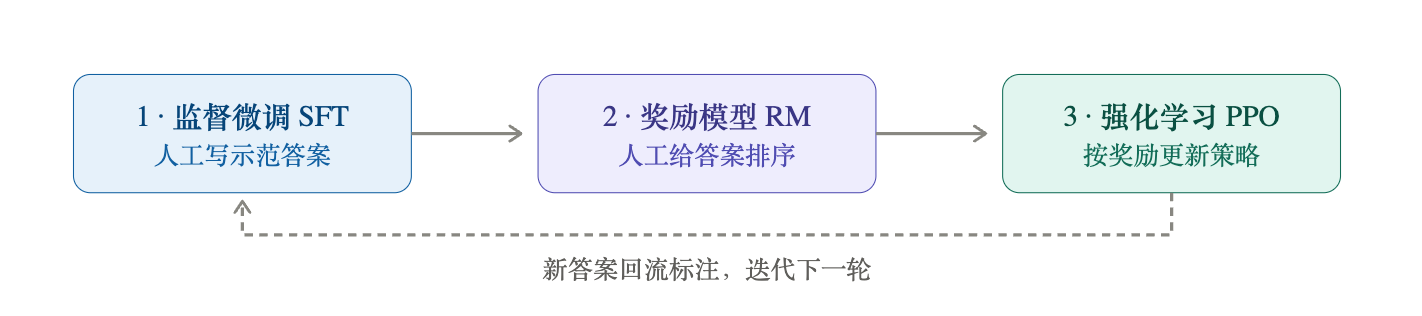
阶段 1:监督微调
阶段 2:奖励模型
另一个单独的模型在 Anthropic HHH 成对比较数据集上训练。给定同一提示词的两个补全,模型学习预测人类更偏好哪一个。
ComparisonRenderer 用分节标记格式化每一对,让模型在一次前向传播中同时看到两个补全。阶段 3:强化学习
SFT 策略通过自博弈针对偏好模型进行优化。对每个提示词采样多个补全,偏好模型以锦标赛方式对所有配对打分。每个补全依据其胜率获得奖励,策略随之更新,从而更多地生成那些获胜的响应。
资源
RLHF 教程:交互式 marimo notebook,带代码逐步走完三个阶段
RLHF 案例:生产级流水线脚本,带 CLI 配置和 wandb 日志记录


