AI 配音功能简介
AI 配音功能可以将视频原配音替换为翻译语言 AI 配音,并将翻译语言字幕压制至视频画面上。
根据您的业务场景,参考以下表格选择接入方式:
译制模式 | 配音级译制 | 字幕级译制 | ||
一站式字幕识别 + 翻译 + 擦除+ AI 配音 | 仅做 AI 配音 | 一站式字幕识别 + 翻译 + 擦除 | 仅做字幕识别 + 翻译 | |
适用场景 | 有原始视频,需要全流程自动完成:字幕识别提取→翻译→擦除→AI 配音。 | 已有无痕视频、原文和译文字幕文件,只需 AI 配音,无需 MPS 进行字幕识别和擦除。 | 原始视频带有硬字幕,需要擦除原字幕,翻译为其他语种,再压制并渲染回视频画面。 | 原始视频没有硬字幕,无需擦除,只需要识别提取字幕并翻译为其他语种。 |
使用模板 | 「智能分析」 25 号预设模板 | 「智能分析」 32 号预设模板 | 「智能擦除」模板 | 「智能字幕」模板 |
字幕来源 | OCR 文本识别 / ASR 语音识别 | 传入原文和译文字幕文件 | OCR 文本识别 / ASR 语音识别 | OCR 文本识别 / ASR 语音识别 |
原文字幕擦除 | ✓ 默认开启(可关闭) | ✗ 不包含(不可开启) | ✓ 包含(不可关闭) | ✗ 不包含(不可开启) |
AI 配音 | ✓ 包含(不可关闭)。 支持三种模式:全自动克隆配音、按角色智能配音、指定单一音色配音。 | ✓ 包含(不可关闭)。 支持三种模式:全自动克隆配音、按角色智能配音、指定单一音色配音。 | ✗ 不包含(不可开启) | ✗ 不包含(不可开启) |
译文字幕压制 | ✓ 默认开启(可关闭) | ✓ 默认开启(可关闭) | ✓ 默认开启(可关闭) | ✓ 默认开启(可关闭) |
计费说明 | 收取“去字幕” + “OCR 提取字幕并翻译”/“ASR 语音翻译” + “AI 配音” + “压制字幕”费用。 | 收取“AI 配音” + “压制字幕”费用。 | 收取“去字幕” + “OCR 提取字幕并翻译”/“ASR 语音翻译” + “压制字幕”费用。 | 收取 “OCR 提取字幕并翻译”/“ASR 语音翻译” + “压制字幕”费用。 |
接入指引 | 参考本文介绍 | |||
本接入指引针对「仅做 AI 配音」模式。发起任务,需要输入以下两种文件:
1. 视频文件。AI 配音任务不进行字幕擦除,因此输入视频上不应有硬字幕。
2. 字幕文件或角色标记文件(Speaker 文件)。
发起 AI 配音任务
接入前置操作
在接入 AI 配音前,为正常使用 MPS 产品,您需要完成以下前置操作:腾讯云账号注册和登录、开通 MPS 产品、授权服务角色。
方式1:控制台发起任务
1. 进入控制台 创建任务 页面,依次选择输入文件路径、配置编排处理流程、输出路径。
2. 在编排配置中,选择媒体 AI - 智能分析节点。
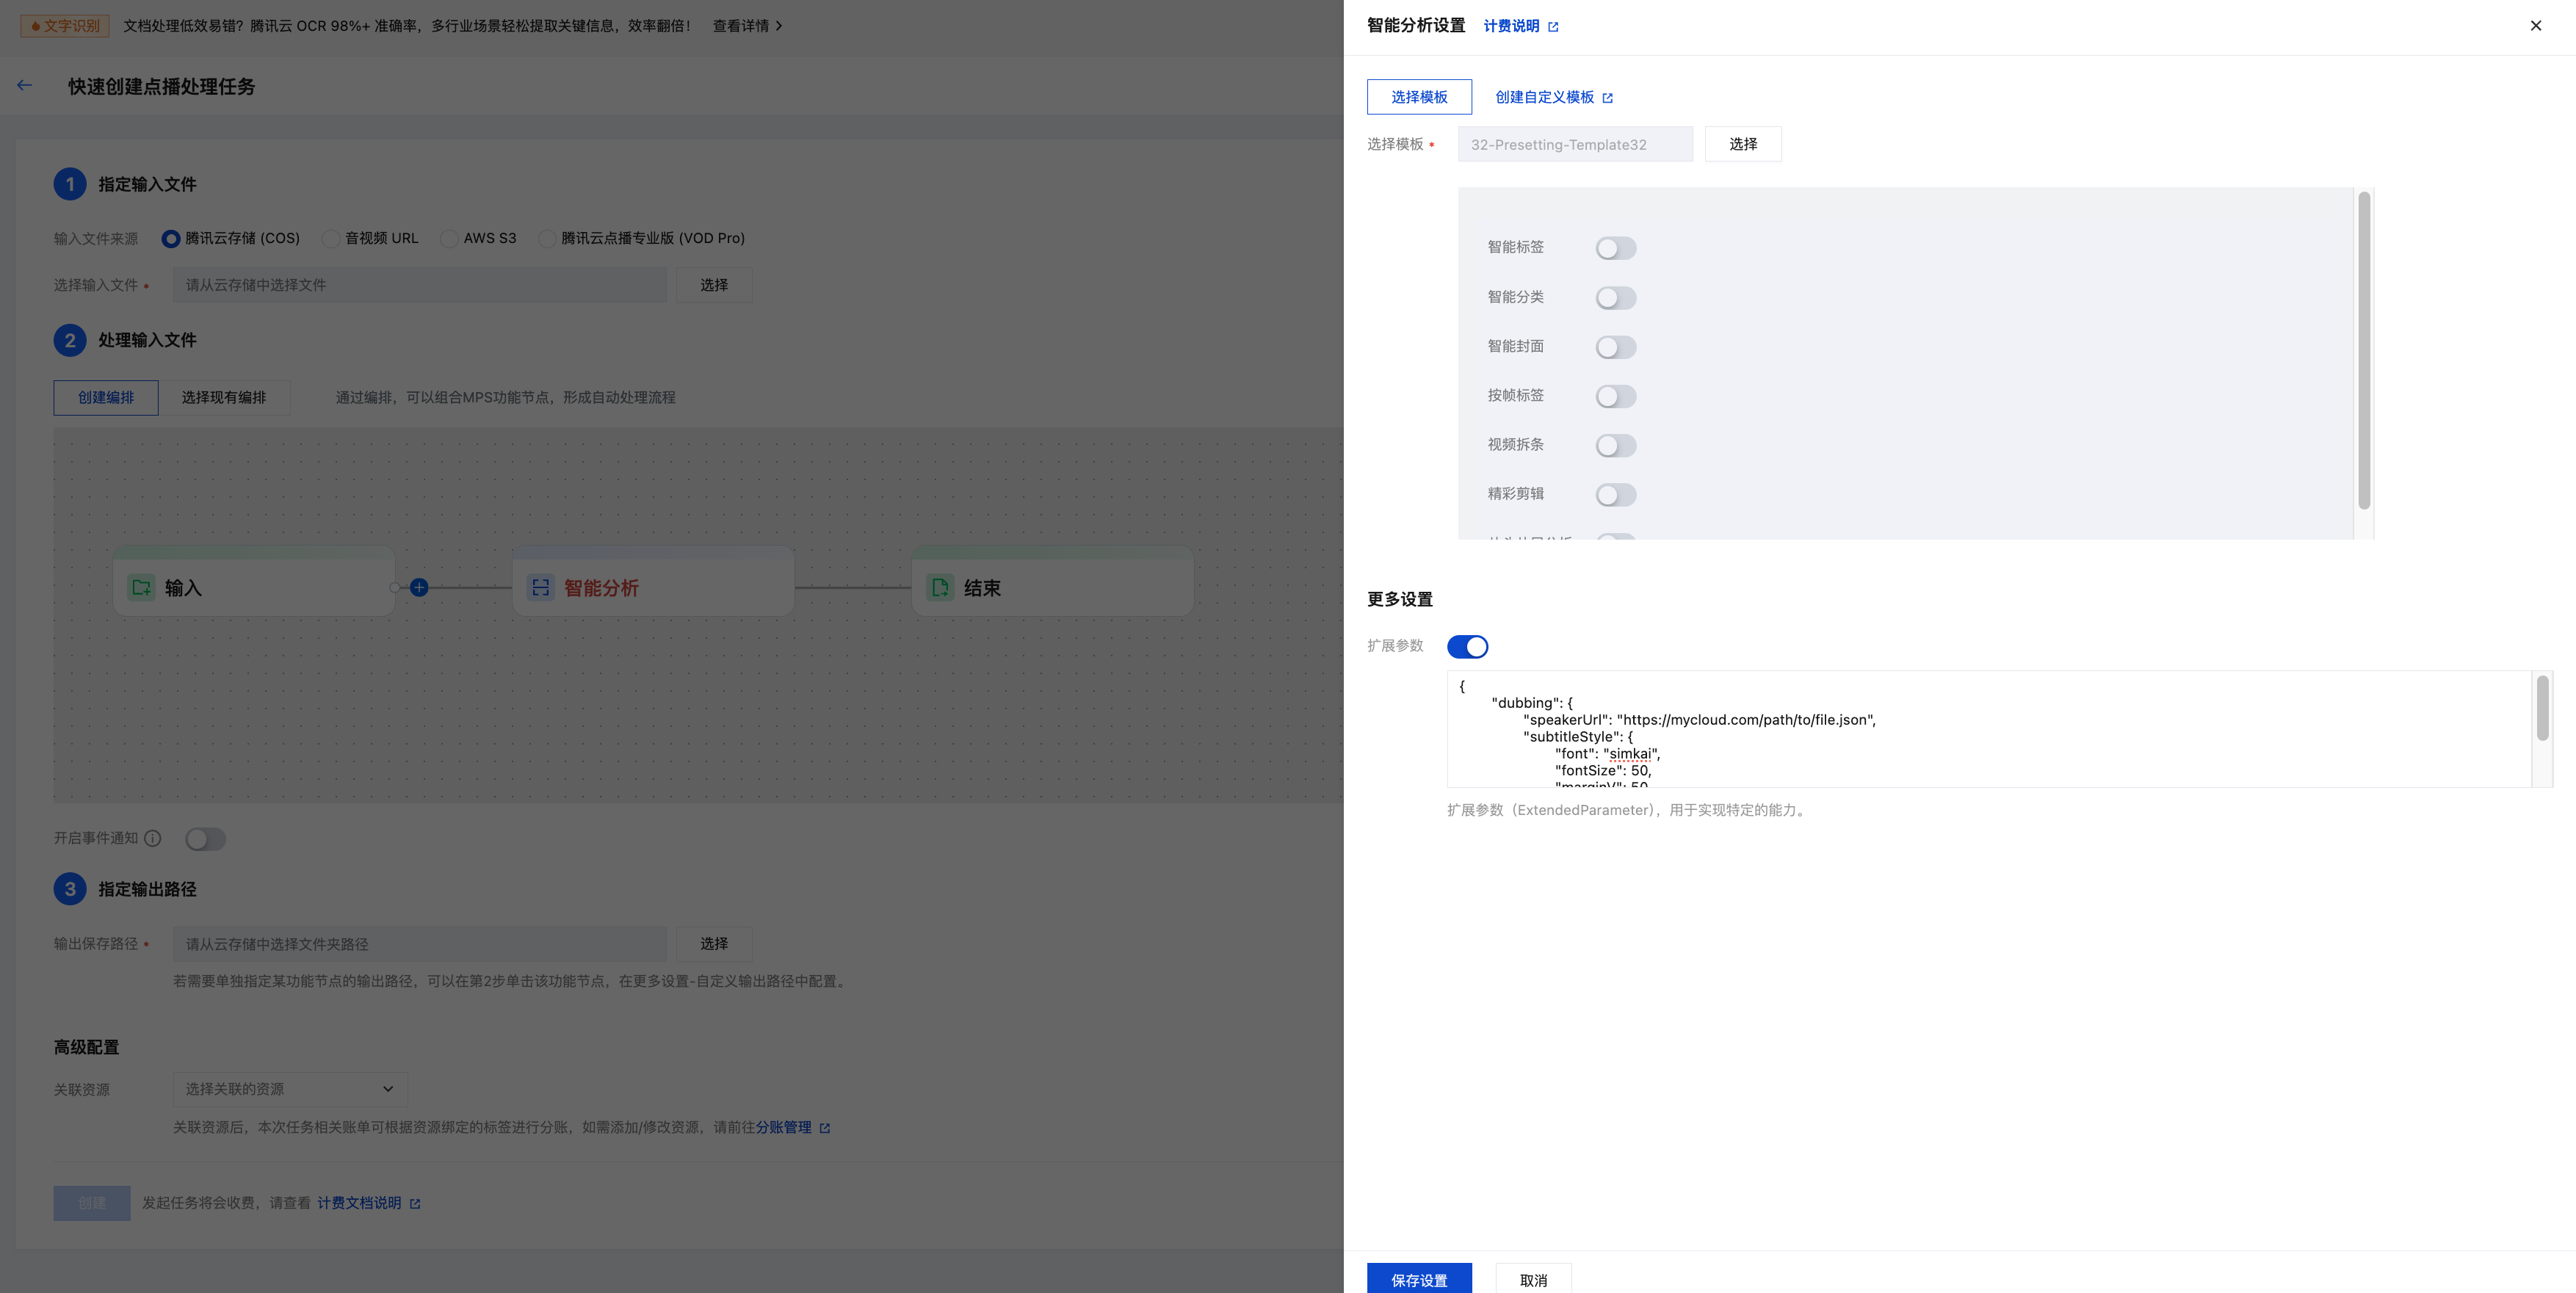
3. 在右侧弹出页面中,选择32号预设模板。开启“更多设置 - 扩展参数”,根据下文 扩展参数说明,传入所需参数。
说明:
发起 AI 配音任务,必须在扩展参数中传入字幕文件路径或 Speaker 文件路径,否则任务会失败。
MPS 控制台会自动转义,请直接传入 JSON 数据,不要传入转义后的字符串,否则任务会失败。
方式2:API 发起任务
调用 ProcessMedia 接口 ,选择 AiAnalysisTask 任务,将 Definition 设置为32(预设模板 ID),ExtendedParameter 填写扩展参数,通过该参数实现 AI 配音能力,取值见下文 扩展参数说明。ProcessMedia 的 JSON 示例如下:
{"InputInfo":{ //输入视频路径,请替换为您的原始视频(建议使用无字幕视频,纯配音服务不会做字幕擦除)"Type":"URL","UrlInputInfo":{"Url":"https://test-1234567.cos.ap-nanjing.myqcloud.com/mps_test/myvideo.mp4"}},"OutputStorage":{ //输出COS存储桶,请替换"Type":"COS","CosOutputStorage":{"Bucket":"test","Region":"ap-nanjing"}},"OutputDir":"/mps_test/output/",//输出文件夹路径,请替换"AiAnalysisTask":{"Definition":32, //预设模板ID,填 32 即可"ExtendedParameter":"{\\"dubbing\\":{\\"speakerUrl\\":\\"https://mycloud.com/path/to/file.json\\"}}" //扩展参数,必传,用于指定speaker文件路径、字幕样式等参数},"TaskNotifyConfig":{ //事件回调通知配置,可选"NotifyType":"URL","NotifyUrl":"http://www.qq.com/callback"}}
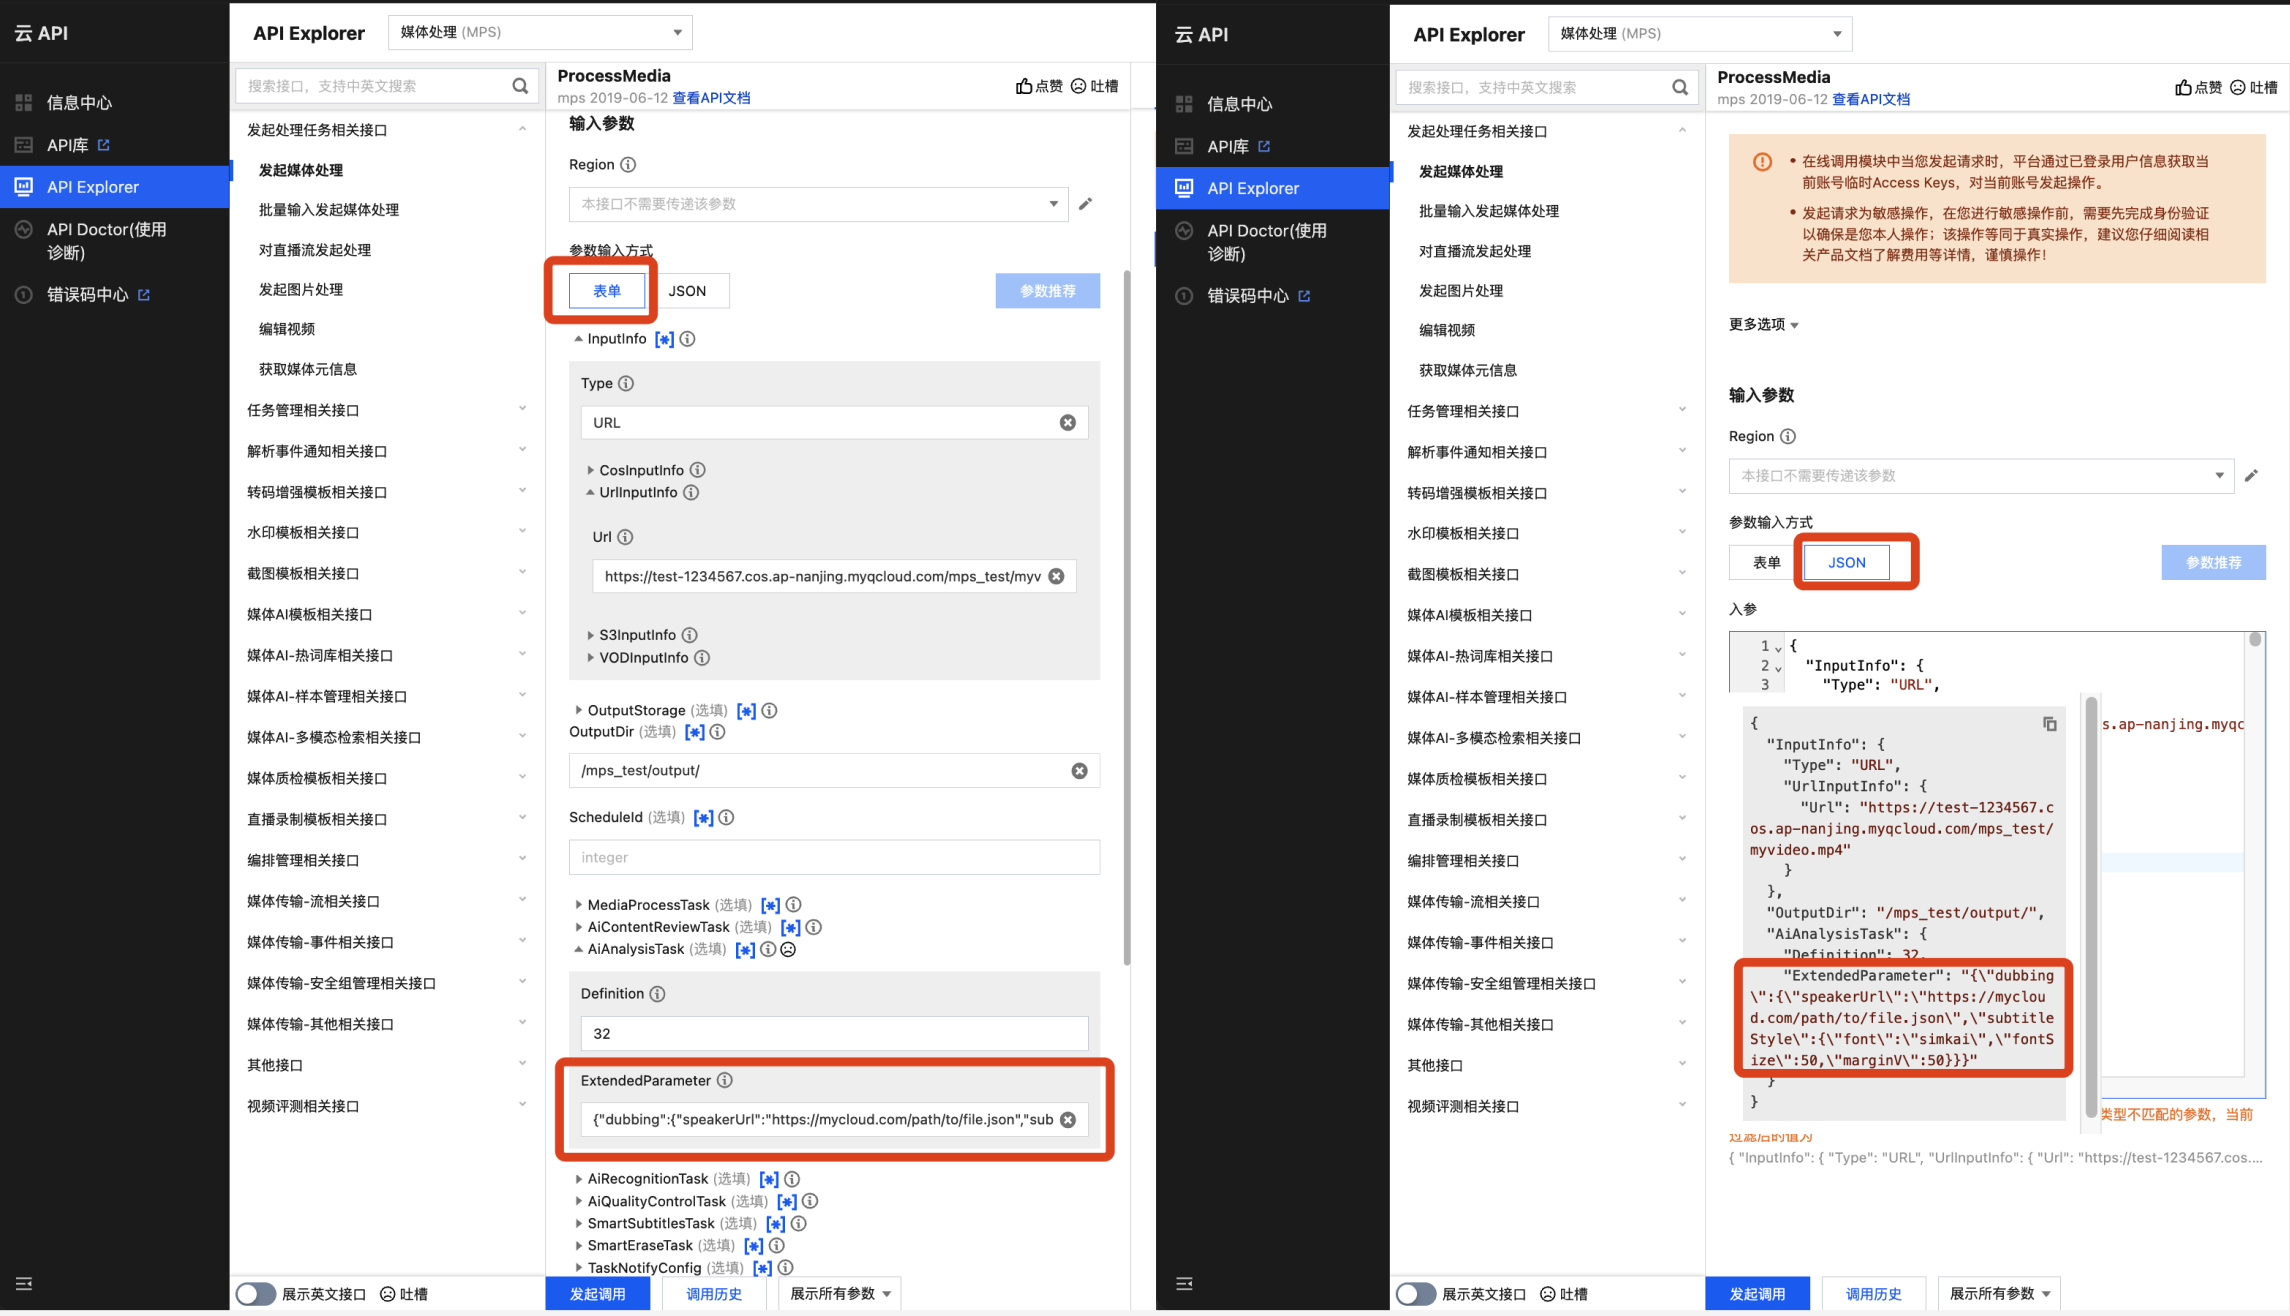
建议您通过 API Explorer 实现快速验证。您可以将上述 JSON 复制到 API Explorer 的 JSON 模式中,切换至“表单”模式可以自动解析,调整输入输出路径等必要参数后,再单击发起调用即可。
在 API Explorer 表单和 JSON 两种输入模式下,ExtendedParameter 的位置示意如下:
注意:
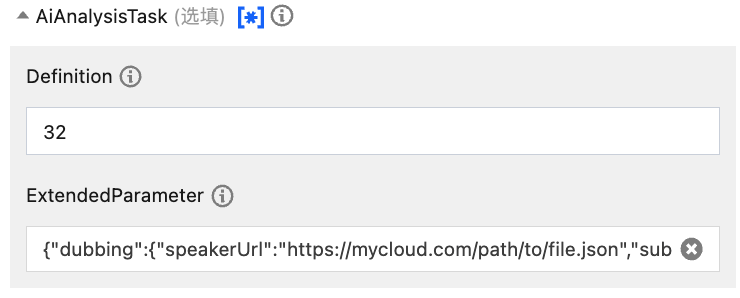
使用 API Explorer 的表单模式填写 ExtendedParameter 时,需要直接传入 JSON,不用转换成字符串。但使用 API Explorer 的 JSON 模式或直接使用 API 接口,则必须传入转义后的字符串。
API Explorer 表单模式,ExtendedParameter 传入 JSON 即可:
API Explorer JSON 模式,ExtendedParameter 则需要传入转义后的字符串,示例:
{\\"dubbing\\":{\\"speakerUrl\\":\\"https://mycloud.com/path/to/file.json\\"}}
配音模式传参说明(ExtendedParameter)
AI 配音支持以下几种模式:
AI 配音模式 | 说明 | 计费说明 |
高情感克隆配音 (默认) | 克隆原片角色音色,保留情感语气。情绪表现最好。 | 收取“AI 配音-克隆音色”费用。 |
按角色智能分配音色 | 自动角色识别,从音色库中为每个角色自动分配符合角色描述的音色(不进行音色克隆)。情绪表现中等,音色一致性好,性价比高。 | 收取“AI 配音-按角色分配”费用。 |
手动标记音色 | 传入 Speaker 文件,手动标记说话人对应的音色 ID。适合手动精调场景,或旁白、解说等单人说话的视频场景。 | 收取“AI 配音-指定音色”费用。 |
指定配音模式,需要通过请求中的
ExtendedParameter 字段传入(JSON 字符串格式)。不传时默认使用克隆模式。以下提供几种常见场景传参示例:场景1:高情感克隆配音
V2 版本 (推荐)
ExtendedParameter 传参示例如下:
{"dubbing": {"srcLang": "zh","dstLangs": ["ja"],"subtitleUrls": {"srcSubtitleUrl": "https://test/zh.vtt", // 原语言字幕文件链接"dstSubtitleUrls": {"ja": "https://test/ja.vtt" // 翻译语言字幕文件链接}},"extraPara": {"provider": "opus"},"subtitle": {"embed": true, // 是否压制字幕,默认开启"style": { // 字幕样式,启用字幕压制时生效"font": "auto", // 字体, auto时根据语言自动匹配"fontSize": 0.04, // 字体大小"marginV": 0.15 // 字幕距离底部位置}}}}
V2版本支持不传字幕文件(不传 subtitleUrls):
1. 如果不传任何字幕文件,会通过 ASR 自动识别字幕并翻译。
2. 如果仅传原文字幕文件,会使用原文字幕文件作为字幕并自动翻译。
3. 如果仅传译文字幕文件,不会参考译文字幕文件,会通过 ASR 自动识别字幕并翻译,译文字幕文件需要配合原文字幕文件一起传入。
V1 版本
ExtendedParameter 传参示例如下:
{"dubbing": {"srcLang": "zh","dstLangs": ["ja"],"subtitleUrls": {"srcSubtitleUrl": "https://test/zh.vtt", // 原语言字幕文件链接"dstSubtitleUrls": {"ja": "https://test/ja.vtt" // 翻译语言字幕文件链接}},"subtitle": {"embed": true, // 是否压制字幕,默认开启"style": { // 字幕样式,启用字幕压制时生效"font": "auto", // 字体, auto时根据语言自动匹配"fontSize": 0.04, // 字体大小"marginV": 0.15 // 字幕距离底部位置}}}}
场景2:按角色智能分配音色
ExtendedParameter 传参示例如下:
{"dubbing": {"srcLang": "zh","dstLangs": ["ja"],"subtitleUrls": {"srcSubtitleUrl": "https://test/zh.vtt", // 原语言字幕文件链接"dstSubtitleUrls": {"ja": "https://test/ja.vtt" // 翻译语言字幕文件链接}},"extraPara": {"voice_from": "match" //表示使用“按角色智能分配音色”模式},"subtitle": {"embed": true, // 是否压制字幕,默认开启"style": { // 字幕样式,启用字幕压制时生效"font": "auto", // 字体, auto时根据语言自动匹配"fontSize": 0.04, // 字体大小"marginV": 0.15 // 字幕距离底部位置}}}}
场景3:手动标记音色
{"dubbing": {"speakerUrl": "https://mycloud.com/path/to/file.json", // speaker 文件 URL"subtitle": {"embed": true, // 是否压制字幕,默认开启"style": { // 字幕样式,启用字幕压制时生效"font": "auto", // 字体, auto时根据语言自动匹配"fontSize": 0.04, // 字体大小"marginV": 0.15 // 字幕距离底部位置}}}}
附注
ExtendedParameter 字段说明
参数 | 类型 | 必填 | 描述 |
speakerUrl | string | 否 | |
srcLang | string | 否 | 源语言,speakerUrl 模式下可不填。 |
dstLangs | list<string> | 否 | 配音目标语言,speakerUrl 模式下可不填。 |
subtitleUrls | json | 否 | 输入字幕 Urls,和 speakerUrl 二选一。 |
subtitleUrls.srcSubtitleUrl | string | 否 | 原字幕 Url. |
subtitleUrls.dstSubtitleUrls | json | 否 | 目标字幕 Urls,key 为语言,value 为字幕 Url。 |
subtitle | json | 否 | 输出字幕相关参数。 |
subtitle.embed | bool | 否 | 是否压制字幕,默认开启。 |
subtitle.style | json | 否 | 字幕样式,启用字幕压制时生效。 |
subtitle.style.font | string | 否 | 字体,不填或填"auto"时使用默认字体。 |
subtitle.style.fontSize | float | 否 | 字体大小,默认值 50 px。 |
subtitle.style.marginV | float | 否 | 底部距离,默认值 50 px。 |
outputPattern | string | 否 | 输出文件名前缀,不传则前缀默认为 dub,文件全名为 dub_{unixtime}.{format}。 |
extraPara | json | 否 | 额外参数字段 |
口型驱动配置
支持在配音任务同时开启口型驱动,通过传入 extraPara.enable_lipsync 为 true 开启,使用 V2 配音同时进行口型驱动示例如下:
{"dubbing": {"srcLang": "zh","dstLangs": ["ja"],"subtitleUrls": {"srcSubtitleUrl": "https://test/zh.vtt", // 原语言字幕文件链接"dstSubtitleUrls": {"ja": "https://test/ja.vtt" // 翻译语言字幕文件链接}},"extraPara": {"provider": "opus","enable_lipsync": true}}}
注意:
当前口型驱动能力仅建议在单人、简单场景开启。
查询任务结果
AI 配音任务会输出处理后的视频文件、精调后的 Speaker 文件(在配音的同时,会对原始 Speaker 文件中的译文做精简逻辑,保证配音的语速正常,避免语速过快的情况,因此会生成新的 Speaker 文件),保存在任务配置的输出路径下。
控制台查询结果
1. 您可以在控制台 任务管理 页面查看任务状态,当子任务状态为“成功”时,单击回调 JSON。
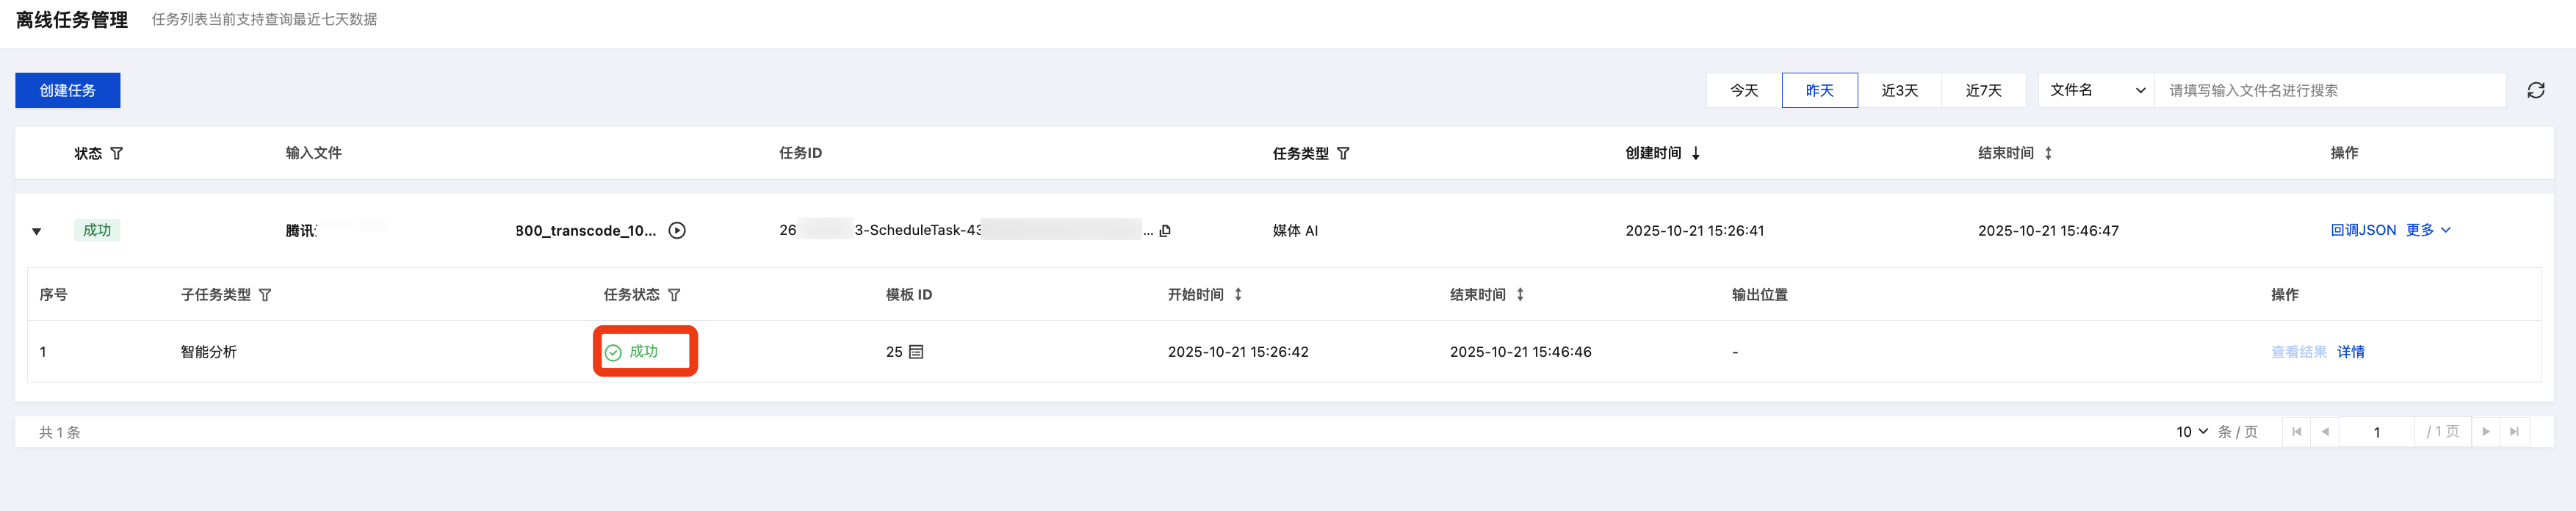
2. 可以在输出信息中找到输出文件路径。
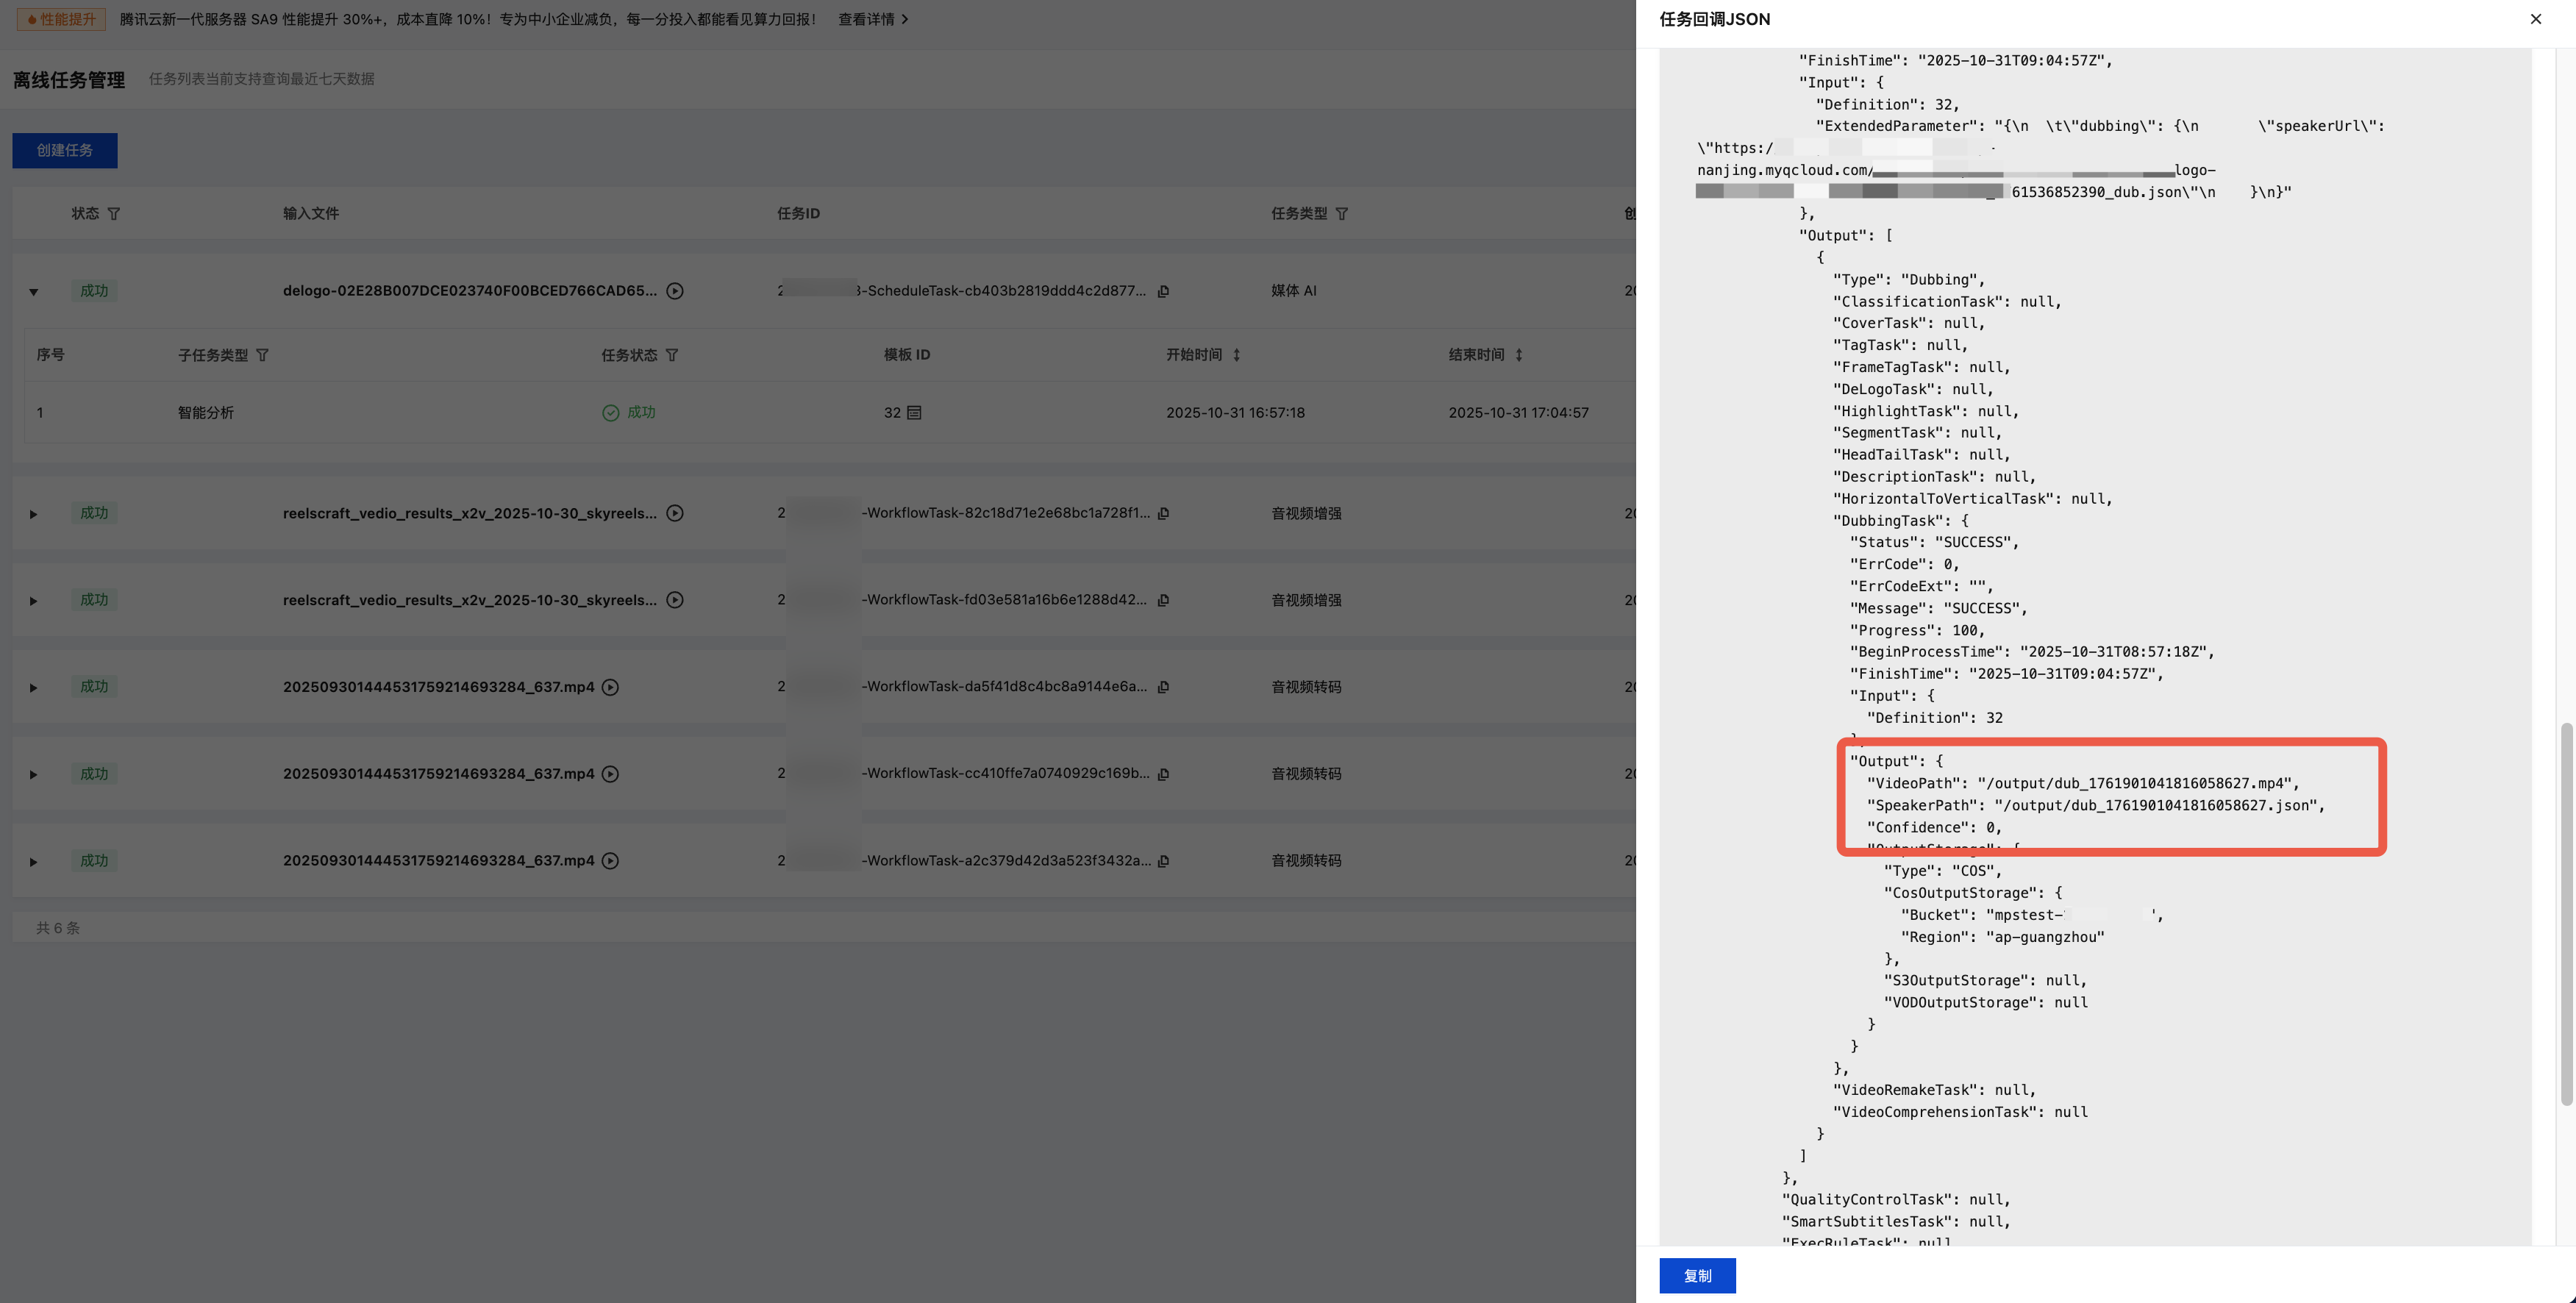
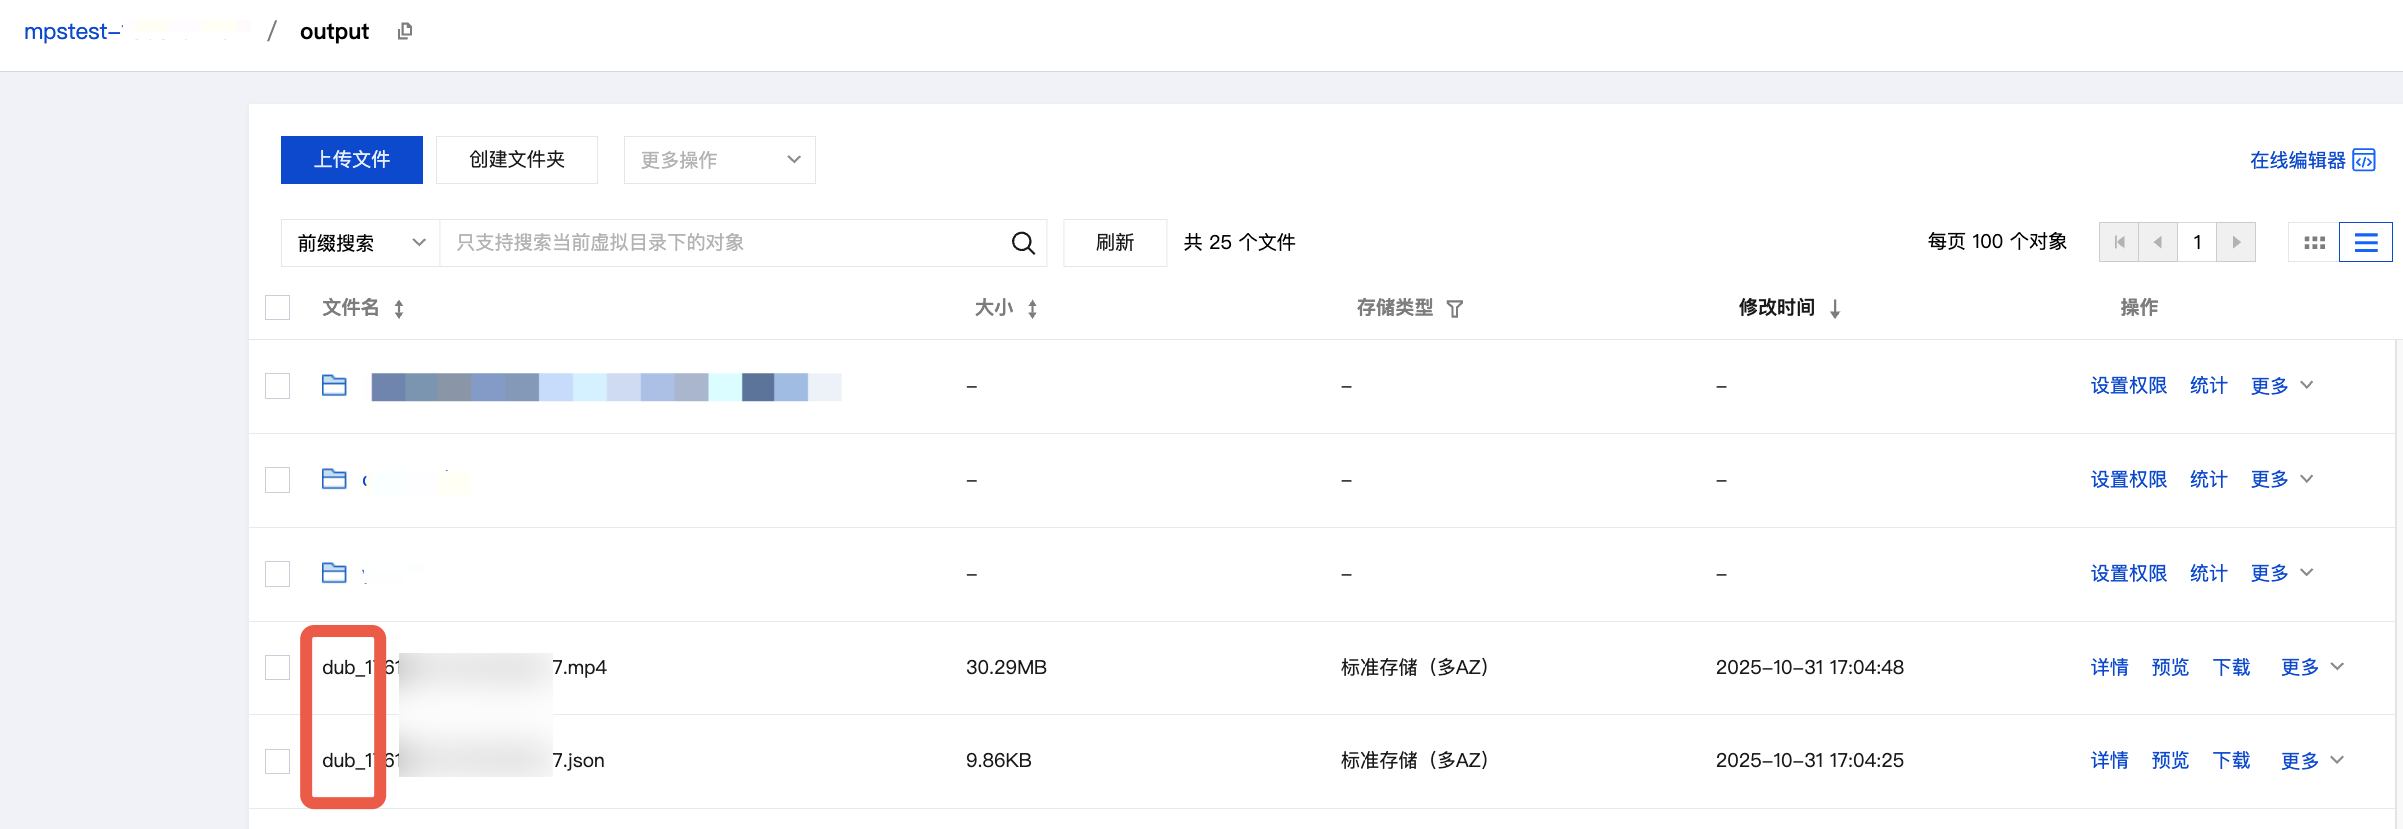
如果使用 COS 作为输出路径,您可以在 MPS 控制台的编排管理 > COS Bucket > 输出 Bucket 页面中找到输出文件。文件名类似"dub-xxx.mp4"、"dub-xxx.json"的文件即为 AI 配音处理后的视频文件、Speaker 文件。
事件通知回调
在使用 ProcessMedia 发起媒体处理任务时,您可以通过 TaskNotifyConfig 参数配置事件回调。当任务处理完成后,会通过配置的回调信息回调任务结果,您可以通过 ParseNotification 解析事件通知结果。下方列出了相关数据结构以供参考。
调用接口查询任务结果
在使用 ProcessMedia 发起媒体处理任务后,会返回任务 ID(TaskId),例如:24000022-WorkflowTask-b20a8exxxxxxx1tt110253、24000022-ScheduleTask-774f101xxxxxxx1tt110253。调用 DescribeTaskDetail 接口,输入任务 ID 即可获取任务结果,您需要解析 WorkflowTask ->AiAnalysisResultSet > DubbingTask > Output 字段获取任务结果。下方列出了相关数据结构以供参考。
相关数据结构
其他说明及常见问题
Speaker 文件说明
数据格式
Speaker 文件指带有字幕及对应角色信息的 JSON 格式文件,数据格式如下:
{"SrcLang": "zh","DstLangs": ["en"],"Speakers": [{"Id": "speaker_0","Gender": "male","VoiceId": "s1_iWay8xZE9nWeUwd66czvRDO/cvcyLQsU0gdJpUs0t0xPiyQbgFwjrJMYV18uGUZYiwFRrA6/prU="},{"Id": "speaker_1","Gender": "female","VoiceId": "s1_FdaOYPrTugqzcDM0oTF5w9nWN+lgMy9OY64fFR82/vGS6w+42WXMwnrLOfZm3fY4C7SSZA=="}],"Clips": [{"TextStartTime": "00:00:00.100","TextEndTime": "00:00:00.600","SpeakerId": "speaker_0","SrcText": "没谁","DstTexts": {"en": "No one"}},{"TextStartTime": "00:00:01.0","TextEndTime": "00:00:01.200","SpeakerId": "speaker_1","SrcText": "早上好","DstTexts": {"en": "Morning"}}]}
参数 | 是否必填 | 类型 | 说明 |
SrcLang | 是 | string | |
DstLangs | 是 | list<string> | |
Speakers[i].Id | 是 | string | 说话人 ID。 |
Speakers[i].Gender | 是 | string | 说话人性别,取 male 或 female。 |
Speakers[i].VoiceId | 否 | string | 说话人音色 ID,用于从音色库中指定说话人音色。 |
Clips[i].TextStartTime | 是 | string | 字幕切片开始时间戳,时:分:秒.毫秒。 |
Clips[i].TextEndTime | 是 | string | 字幕切片结束时间戳,时:分:秒.毫秒。 |
Clips[i].SpeakerId | 是 | string | 字幕切片对应的说话人 ID。 |
Clips[i].SrcText | 是 | string | 字幕切片源语言。 |
Clips[i].DstTexts | 是 | map<string,string> | 字幕切片翻译语言,当前仅支持单种语言。 |
如何通过 SRT/VTT 格式字幕文件生成 Speaker 文件?
支持 SRT 或 VTT 格式字幕文件,使用示例如下:
提供双语字幕文件(原字幕和翻译字幕在同一个字幕文件里)。
python3 subtitle2speaker.py input.srt output.json --src_lang "zh" --dst_langs "en"
提供两个单语字幕文件(原字幕和翻译字幕不在一个文件中)。
python3 subtitle2speaker.py input_src.vtt input_dst.vtt output.json --src_lang "zh" --dst_langs "en"
说明:
通过 SRT/VTT 格式字幕文件生成的 Speaker 文件,说话人 ID 都为默认值,您需要手动修改说话人信息,否则配音效果可能不符合预期。
Speaker 文件中的音色 VoiceId 如何获取?
修改 Speaker 文件示例
修改标记不正确的说话人(SpeakerId),可以避免串音现象

修改过短的时间戳,避免配音语速过快问题

修改译文,满足更地道、更口语化的需求

AI 配音支持语种
语种 | Code | 是否可用于源语言(SrcLang) | 是否可用于译制目标语言(DstLangs) |
中文 (Chinese) | zh | ✓ | ✓ |
英语 (English) | en | ✓ | ✓ |
日语 (Japanese) | ja | ✓ | ✓ |
德语 (German) | de | ✓ | ✓ |
法语 (French) | fr | ✓ | ✓ |
韩语 (Korean) | ko | ✓ | ✓ |
俄语 (Russian) | ru | ✓ | ✓ |
乌克兰语 (Ukrainian) | uk | ✓ | ✓ |
葡萄牙语 (Portuguese) | pt | ✓ | ✓ |
意大利语 (Italian) | it | ✓ | ✓ |
西班牙语 (Spanish) | es | ✓ | ✓ |
印度尼西亚语 (Indonesian) | id | ✓ | ✓ |
荷兰语 (Dutch) | nl | ✓ | ✓ |
土耳其语 (Turkish) | tr | ✓ | ✓ |
菲律宾语 (Filipino) | fil | ✓ | ✓ |
马来语 (Malay) | ms | ✓ | ✓ |
希腊语 (Greek) | el | ✓ | ✓ |
芬兰语 (Finnish) | fi | ✓ | ✓ |
克罗地亚语 (Croatian) | hr | ✓ | ✓ |
斯洛伐克语 (Slovak) | sk | ✓ | ✓ |
波兰语 (Polish) | pl | ✓ | ✓ |
瑞典语 (Swedish) | sv | ✓ | ✓ |
印地语 (Hindi) | hi | ✓ | ✓ |
保加利亚语 (Bulgarian) | bg | ✓ | ✓ |
罗马尼亚语 (Romanian) | ro | ✓ | ✓ |
阿拉伯语 (Arabic) | ar | ✓ | ✓ |
捷克语 (Czech) | cs | ✓ | ✓ |
丹麦语 (Danish) | da | ✓ | ✓ |
泰米尔语 (Tamil) | ta | ✓ | ✓ |
匈牙利语(Hungarian) | hun | ✓ | ✓ |
越南语(Vietnamese) | vi | ✓ | ✓ |
泰语(Thai) | th | ✓ | ✓ |
粤语(Cantonese) | yue | ✓ | ✓ |
如何去除视频硬字幕,获得无痕视频?
是否支持输入视频,一站式进行去字幕+翻译字幕+压制字幕+AI 配音处理?
如何获取音色库,如何克隆或设计新音色?


