基于腾讯云 ES 引擎和生态优势,帮助客户通过更轻量的研发和运维投入,轻松构建 RAG、AI 搜索等应用。本文档将详细说明各原子服务以及发布独享服务的计费方式和单价策略,遵循按需付费原则,提供预付费资源包与按量计费两种方式,帮助客户根据实际业务场景精细化成本管理。
计费方式 | 说明 |
按量计费 | 按照实际调用接口消耗的资源量进行计费,每小时对腾讯云账户进行结算和扣费,正式使用前请保证账户处于非欠费状态。 |
包年包月 LLM 套餐包 | 采用按月订阅 + 积分制,购买时设定月预算,预算按 100 积分 = 1 元 折算为积分额度,调用套餐内模型时按实际用量从积分池中实时扣减。 |
免费额度
购买方式
在账单结算时,系统将按照“免费体验次数 > 后付费/包年包月”的顺序进行结算。
计费内容包含直接调用 API 和在控制台使用相关原子服务在线体验,调用失败不计费。
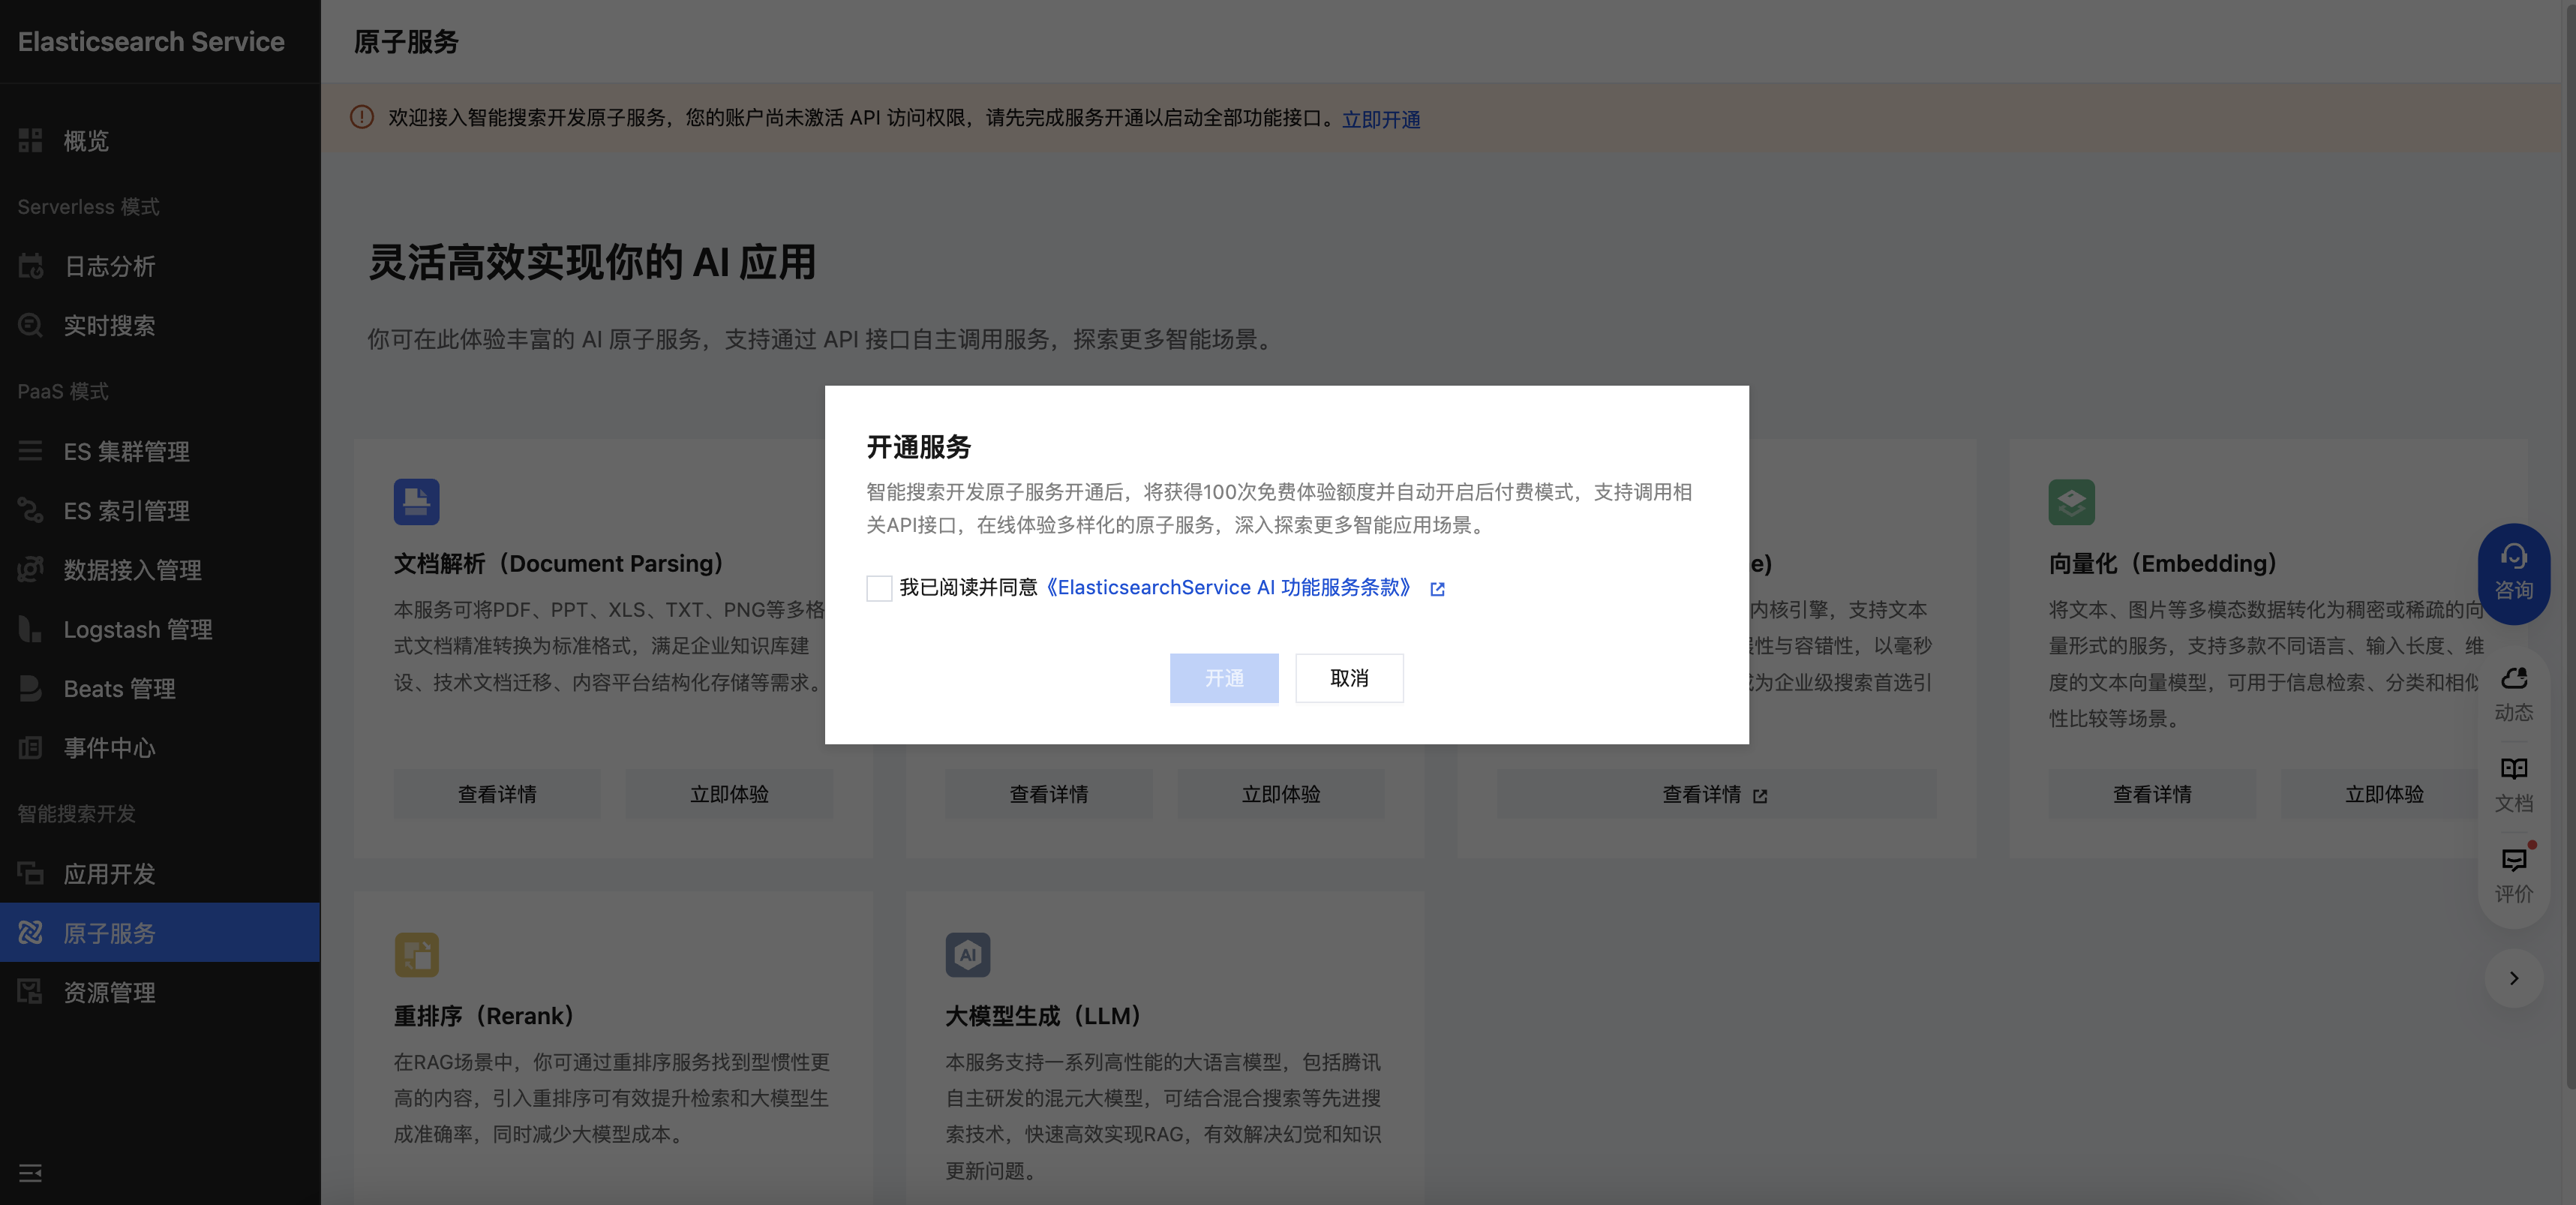
开通后付费
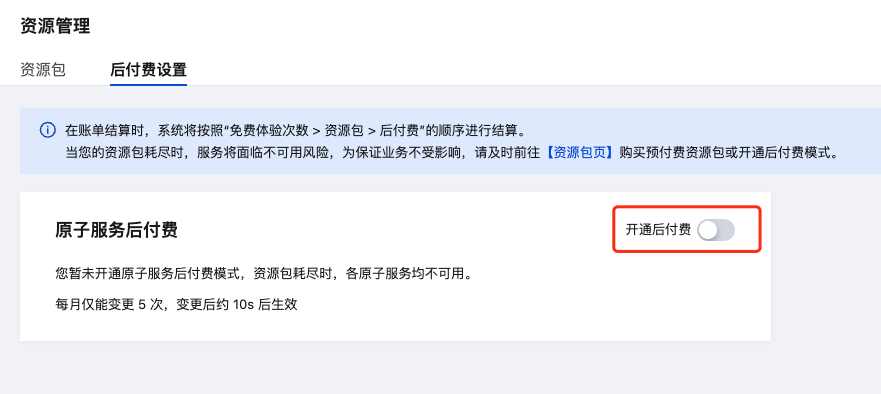
当开通智能搜索开发原子服务后,默认情况下会自动打开后付费,免费体验次数使用完后,若未购买预付费资源包,将会自动转入后付费。如需开启或关闭后付费模式结算,请前往控制台 > 资源管理 > 后付费设置 开通或关闭后付费。
说明:
后付费设置每月仅能变更 5 次,变更后约 10s 后生效,请不要频繁变更。
按量计费定价
文档解析(Document Parsing)
文档解析服务按原始文档成功解析的页数计费,单价如下:
服务 | 刊例(元/页) |
doc-llm | 0.2 |
说明:
doc-llm 文档解析服务是按页收费,对不同文档计费规则如下:
doc、docx、ppt、pptx、pdf 按页计量。
jpeg、png 等图片格式以一张图为一页。
xlsx、txt、md、csv 以 1 份为一页。
文本切片(Text Chunking)
文本切片服务按千 token 计费,单价如下:
服务 | 刊例(元/千 tokens) |
doc-tree-chunk | 0.03 |
doc-chunk | 0.00002 |
说明:
doc-tree-chunk 服务是基于 doc-llm 文档解析服务实现的文档切片,默认会分为解析和分片的两种费用,具体如下:
输入文件为 pdf/docx/doc/ppt/pptx 文档格式和 jpg/png 等图片格式时,需要计算文档解析费用(按页计费)。
输入文件为 txt/md/xlsx/xls 格式时,仅需工程解析,不需要付费。
两种方式输入的文件都需要计算拆分消耗的费用,按 token 消耗数量计费。
doc-chunk 服务是基于分隔符、文本长度进行切片,适用于规则性较强的文本,这里统计的 token 为原始文本的字符长度。
向量化(Embedding)
纯文本 Embedding 服务按千 token 计费,单价如下:
模型 | 维度 | token 限制 | 语言 | 刊例(元/千 tokens) |
bge-base-zh-v1.5 | 768 | 512 | 中文 | 0.0005 |
bge-large-zh-v1.5 | 1024 | 512 | 中文 | 0.0005 |
KaLM-embedding-multilingual-mini-v1 | 896 | 131072 | 多语言 | 0.0005 |
bge-m3 | 1024 | 8194 | 多语言 | 0.0005 |
Conan-embedding-v1 | 1792 | 512 | 中文 | 0.0005 |
图文 Embedding 服务支持文本和图片两种模态输入,分别以 token 和图片数量计费,单价如下:
模型 | 维度 | token 限制 | 语言 | 刊例 |
WeProduct | 768 | - | - | 图片:0.0005 元/张 |
WeCLIPv2-Base | 768 | 72 | 多语言,中文最优 | 文本:0.0005 元/千 tokens 图片:0.0003 元/张 |
WeCLIPv2-Large | 768 | 72 | 多语言,中文最优 | 文本:0.0005 元/千 tokens 图片:0.0005 元/张 |
重排序(Rerank)
重排序服务按千 token 计费,单价如下:
模型 | token 限制 | 语言 | 刊例(元/千 tokens) |
bge-reranker-large | 514 | 中文、英文 | 0.0001 |
bge-reranker-v2-m3 | 8194 | 多语言 | 0.0005 |
联网搜索(Online Search)
联网搜索服务按调用次数计费,可结合大模型进行使用,单价如下:
服务 | 刊例(元/千次) |
Sogou | 65 |
Bing(关停) | 65 |
Baidu(关停) | 65 |
说明:
推荐您使用 Sogou 服务,提供稳定的联网搜索服务,Bing 和 Baidu 服务由三方服务厂商提供,受限于三方服务,有关停风险,请酌情使用。
应用发布资源
应用发布为独享服务时,系统将根据您实际的负载合理分配资源,按照 CPU 和内存使用情况按量付费。单价如下:
资源 | 地域 | 刊例 |
CPU | 北京 | 0.121875元/核/小时 |
内存 | 北京 | 0.06102778元/GB/小时 |
LLM 套餐定价
设定 月预算(元/月),系统自动折算为积分额度。例如月预算 1,000 元对应 100,000 积分。套餐内可调用的模型如下,不同模型的积分消耗不同,下表以 月预算 1,000 元(100,000 积分) 为例展示综合单价与预估可得 Token 量。
模型 | 综合单价(元/百万 tokens) | 预估可得 Token 量(百万) |
Hy3 | 0.74 | 1,351 |
DeepSeek-V4-Flash | 0.70 | 1,429 |
DeepSeek-V4-Pro | 9.26 | 108 |
GLM-5 | 4.40 | 227 |
GLM-5-Turbo | 3.40 | 294 |
GLM-5.1 | 3.80 | 263 |
GLM-5.2 | 4.40 | 227 |
Kimi-K2.6 | 2.80 | 357 |
MiniMax-M2.7 | 1.00 | 1,000 |
MiniMax-M3 | 2.50 | 400 |
说明:
预估 Token 量仅为单一模型视角的参考值,基于运营经验值测算,仅作为预算规划参考,不代表实际可使用的 Token 数量,实际可调用数量受缓存命中率、输入/输出 Token 比例、多模型混合使用等因素影响,以实际调用扣减为准。
积分抵扣规则
抵扣公式
单次请求的积分消耗按三段分别折算后加总:
积分消耗 = (缓存命中输入 token 数 × 命中缓存输入价+ 未命中缓存输入 token 数 × 未命中缓存输入价+ 输出 token 数 × 输出价) / 1,000,000
三段 Token 的含义:
Token 分类 | 说明 |
缓存命中输入 | 请求输入中命中模型侧上下文缓存的部分,按更低的命中价格折算 |
未命中缓存输入 | 请求输入中未命中缓存的部分 |
输出 | 模型生成的回答内容 |
计费示例
以某模型为例(假设抵扣价:缓存命中输入 100 积分/百万 tokens、未命中缓存输入 400 积分/百万 tokens、输出 1,800 积分/百万 tokens),单次请求消耗输入 10,000 tokens(其中缓存命中 6,000)、输出 2,000 tokens,则本次请求的积分消耗为:
(6,000 × 100 + 4,000 × 400 + 2,000 × 1,800) / 1,000,000= (600,000 + 1,600,000 + 3,600,000) / 1,000,000= 5.8 积分
老原子服务资源包定价(已不支持新购)
资源类型维度的定价
资源类型 | 资源包规格 | 刊例价 |
文档解析 | 1千页 | 200 |
| 1万页 | 1700 |
| 10万页 | 9800 |
| 100万页 | 75000 |
文本切片 | 1千万 tokens | 300 |
| 1亿 tokens | 2850 |
| 10亿 tokens | 27000 |
文本向量化 | 10亿 tokens | 500 |
| 100亿 tokens | 4750 |
| 1000亿 tokens | 45000 |
图片向量化 | 100万张 | 500 |
| 1000万张 | 4750 |
| 1亿张 | 45000 |
重排序 | 10亿 tokens | 500 |
| 100亿 tokens | 4750 |
| 1000亿 tokens | 45000 |
大模型生成 | 1万点 | 100 |
| 10万点 | 950 |
| 100万点 | 9000 |
| 1000万点 | 85000 |
联网搜索 | 1万次 | 650 |
| 10万次 | 6200 |
| 100万次 | 58500 |
抵扣系数
各个模型的抵扣系数不同,实际资源包的消耗根据抵扣系数进行换算,换算公式:资源包用量 = 实际用量 * 抵扣系数。
计费计算示例:
1. 客户甲用了 bge-reranker-large 1百万 token,用了 bge-reranker-v2-m3 2百万 token,那么换算下来抵扣的资源包:1百万 * 0.2 + 2百万 * 1 = 2.2百万 token。
2. 客户乙在用了 deepseek-r1 输入1百万 token、输出2百万 token,同时用了 hunyuan-turbo 输入3百万、输出4百万,那么换算下来抵扣的资源包:1百万 * 0.4 + 2百万 * 1.6 + 3百万 * 0.24 + 4百万 * 0.96 = 8160 点(注意:点横向对标 token 的单位为千 token)
以下是各个资源类型的抵扣系数:
资源类型 | 模型服务 | 抵扣系数 |
文档解析 | doc-llm | 1 |
文本切片 | doc-tree-chunk | 1 |
| doc-chunk | 0.00066667 |
文本向量化 | bge-base-zh-v1.5 | 1 |
| bge-large-zh-v1.5 | 1 |
| KaLM-embedding-multilingual-mini-v1 | 1 |
| bge-m3 | 1 |
| conan-embedding-v1 | 1 |
图片向量化 | WeCLIPv2-Base | 0.6 |
| WeCLIPv2-Large | 1 |
重排序 | bge-reranker-large | 0.2 |
| bge-reranker-v2-m3 | 1 |
大模型生成 | deepseek-r1(自动路由 deepseek-v4) | 输入:0.4,输出:1.6 |
| deepseek-v3(自动路由 deepseek-v4) | 输入:0.2,输出:0.8 |
| deepseek-r1-distill-qwen-32b(已下线) | 输入:0.2,输出:0.6 |
| hunyuan-turbo(已下线) | 输入:0.24,输出:0.96 |
| hunyuan-large(已下线) | 输入:0.4,输出:1.2 |
| hunyuan-large-longcontext(已下线) | 输入:0.6,输出:1.8 |
| hunyuan-standard(已下线) | 输入:0.08,输出:0.2 |
| hunyuan-standard-256K(已下线) | 输入:0.05,输出:0.2 |
联网搜索 | sogou | 1 |
| bing(关停) | 1 |
| baidu(关停) | 1 |
抵扣系数说明:
抵扣系数是一种用于统一不同模型服务计费标准的换算比率。以向量化服务为例:当您不确定哪个 embedding 模型最适合业务需求时,可以直接购买通用的"向量化资源包"。该资源包支持所有 Embedding 模型,系统会根据实际调用模型的抵扣系数(例如:模型 A 的1次调用 = 1.2 个资源单位,模型 B 的 1 次调用 = 0.8 个资源单位)自动折算消耗的资源量。这种设计既避免了前期选型困难,又能确保资源的高效利用。


