安装
uv pip install tinker==0.12.0
注意:
export TINKER_API_KEY="your-api-key-here"export TINKER_BASE_URL="http://api.tencenttcrl.com/"
安装后即可使用 Python SDK(
import tinker)和 CLI(tinker run list、tinker checkpoint download)。
本页介绍两种主要的 LLM 微调工作流:监督微调(SFT)和强化学习(RL),并展示每一步如何对应 TCRL SDK 调用。
监督微调(SFT)
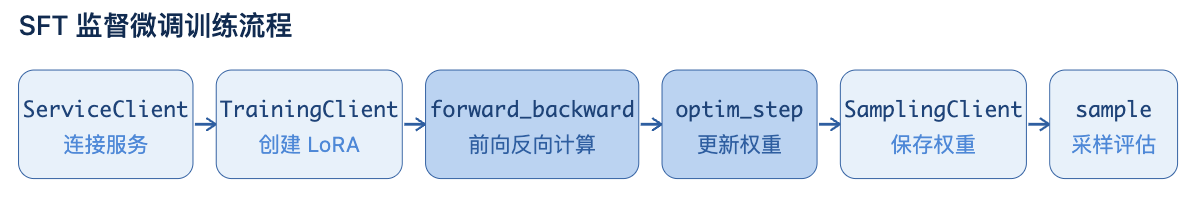
SFT 训练模型模仿示例:
1. 创建客户端:连接 Tinker,创建 TrainingClient
2. 准备数据:将样本 tokenize 为带 loss mask 的
Datum 对象3. 训练:
forward_backward(梯度)+ optim_step(更新权重)4. 评测 — 保存权重,创建 SamplingClient,采样
强化学习(RL)
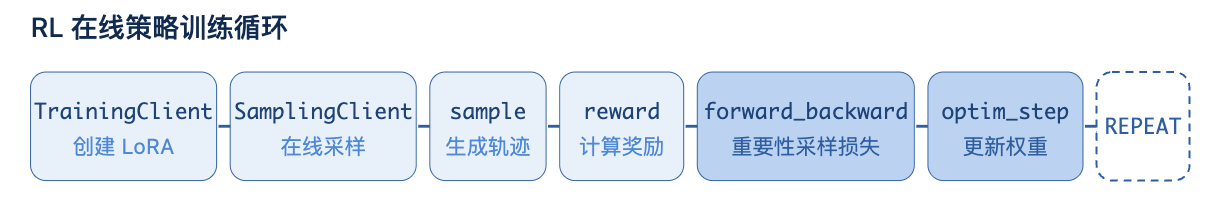
RL 训练模型最大化奖励信号:
1. 创建客户端:连接 Tinker,创建 TrainingClient
2. 获取同策略采样器:
save_weights_and_get_sampling_client3. 采样 rollout:从同策略模型生成补全
4. 评分:计算奖励和对数概率
5. 训练:使用 RL 损失进行
forward_backward + optim_step6. 重复:新权重 → 新 SamplingClient → 再次采样
API 速查
创建客户端
import tinkerfrom tinker import types# 入口 — 从环境变量读取 TINKER_API_KEYservice_client = tinker.ServiceClient()# 训练客户端(LoRA 微调)training_client = service_client.create_lora_training_client(base_model="Qwen/Qwen3-8B", rank=32)# 采样客户端(文本生成)sampling_client = service_client.create_sampling_client(base_model="Qwen/Qwen3-8B")# 分词器tokenizer = training_client.get_tokenizer()
注意
子进程采样(SamplingClient) 可被 pickle——你可以将它传递给其他进程进行并行采样。如果训练循环中有 CPU 密集型工作(评分、环境逻辑),设置
TINKER_SUBPROCESS_SAMPLING=1 可以在专用子进程中运行 sample() 和 compute_logprobs(),避免 GIL 争用。准备训练数据
Datum 是单个训练样本,包含输入 token、目标 token 和逐 token 的损失权重(0 = 忽略,1 = 计算损失)。datum = types.Datum(model_input=types.ModelInput.from_ints(tokens=input_tokens),loss_fn_inputs=dict(weights=weights, # 0 for prompt, 1 for completiontarget_tokens=target_tokens # shifted by 1 from input))
对于 RL 损失(importance_sampling、PPO、CISPO),
loss_fn_inputs 还需包含 logprobs 和 advantages:rl_datum = types.Datum(model_input=types.ModelInput.from_ints(tokens=tokens),loss_fn_inputs=dict(target_tokens=target_tokens,weights=weights,logprobs=sampling_logprobs, # from the rollout policyadvantages=advantages, # reward - baseline))
文本采样
prompt = types.ModelInput.from_ints(tokenizer.encode("The capital of France is"))params = types.SamplingParams(max_tokens=50, temperature=0.7, stop=["\\n"])# 单次采样result = await sampling_client.sample_async(prompt=prompt, num_samples=1, sampling_params=params)print(tokenizer.decode(result.sequences[0].tokens))# 一次调用多次采样result = await sampling_client.sample_async(prompt=prompt, num_samples=8, sampling_params=params)for seq in result.sequences:print(tokenizer.decode(seq.tokens))
计算对数概率
用于 RL 中的评分(比较训练策略与采样策略)。
# Prompt logprobsresult = await sampling_client.sample_async(prompt=prompt, num_samples=1,sampling_params=types.SamplingParams(max_tokens=1),include_prompt_logprobs=True,)print(result.prompt_logprobs)# 简写logprobs = await sampling_client.compute_logprobs_async(prompt)# Top-k logprobs(用于蒸馏)result = await sampling_client.sample_async(prompt=prompt, num_samples=1,sampling_params=types.SamplingParams(max_tokens=1),include_prompt_logprobs=True,topk_prompt_logprobs=5,)
前向-反向传播
计算给定数据和损失函数的梯度,立即返回一个 future。
# SFT: cross-entropy lossfwdbwd_future = await training_client.forward_backward_async(data=[datum], loss_fn="cross_entropy")fwdbwd_result = await fwdbwd_future.result_async()print(f"Loss: {fwdbwd_result.loss}")# RL lossesfwdbwd_future = await training_client.forward_backward_async(data, "importance_sampling")fwdbwd_future = await training_client.forward_backward_async(data, "ppo")fwdbwd_future = await training_client.forward_backward_async(data, "cispo")fwdbwd_future = await training_client.forward_backward_async(data, "dro")# 自定义损失fwdbwd_future = await training_client.forward_backward_custom_async(data, my_loss_fn)
优化器步进
使用上次
forward_backward 的梯度更新模型权重。optim_future = await training_client.optim_step_async(types.AdamParams(learning_rate=1e-4))await optim_future.result_async()
保存与加载权重
# 保存权重 → 获取采样客户端sampling_client = training_client.save_weights_and_get_sampling_client(name="checkpoint-1")# 保存完整状态(权重 + 优化器)training_client.save_state(name="step-100")# 仅从权重恢复training_client = await service_client.create_training_client_from_state_async(path="tinker://run-id/sampler_weights/checkpoint-1")# 带优化器状态恢复training_client = await service_client.create_training_client_from_state_with_optimizer_async(path="tinker://run-id/weights/step-100")
视觉输入
import requestsimage_data = requests.get("https://example.com/image.png").contentmodel_input = tinker.ModelInput(chunks=[types.EncodedTextChunk(tokens=tokenizer.encode("<|im_start|>user\\n<|vision_start|>")),types.ImageChunk(data=image_data, format="png"),types.EncodedTextChunk(tokens=tokenizer.encode("<|vision_end|>Describe this image<|im_end|>\\n<|im_start|>assistant\\n")),])
并发请求
import asyncio# 同一 prompt 多次采样result = await sampling_client.sample_async(prompt=prompt, num_samples=16, sampling_params=params)for seq in result.sequences:print(tokenizer.decode(seq.tokens))# 不同 prompt 并行采样results = await asyncio.gather(sampling_client.sample_async(prompt=prompt1, num_samples=1, sampling_params=params),sampling_client.sample_async(prompt=prompt2, num_samples=1, sampling_params=params),sampling_client.sample_async(prompt=prompt3, num_samples=1, sampling_params=params),)# 流水线训练:overlap forward-backward 与 optimizer stepfwdbwd = await training_client.forward_backward_async(batch1, "cross_entropy")optim_future = training_client.optim_step(types.AdamParams(learning_rate=1e-4))next_fwdbwd = await training_client.forward_backward_async(batch2, "cross_entropy")await optim_future


