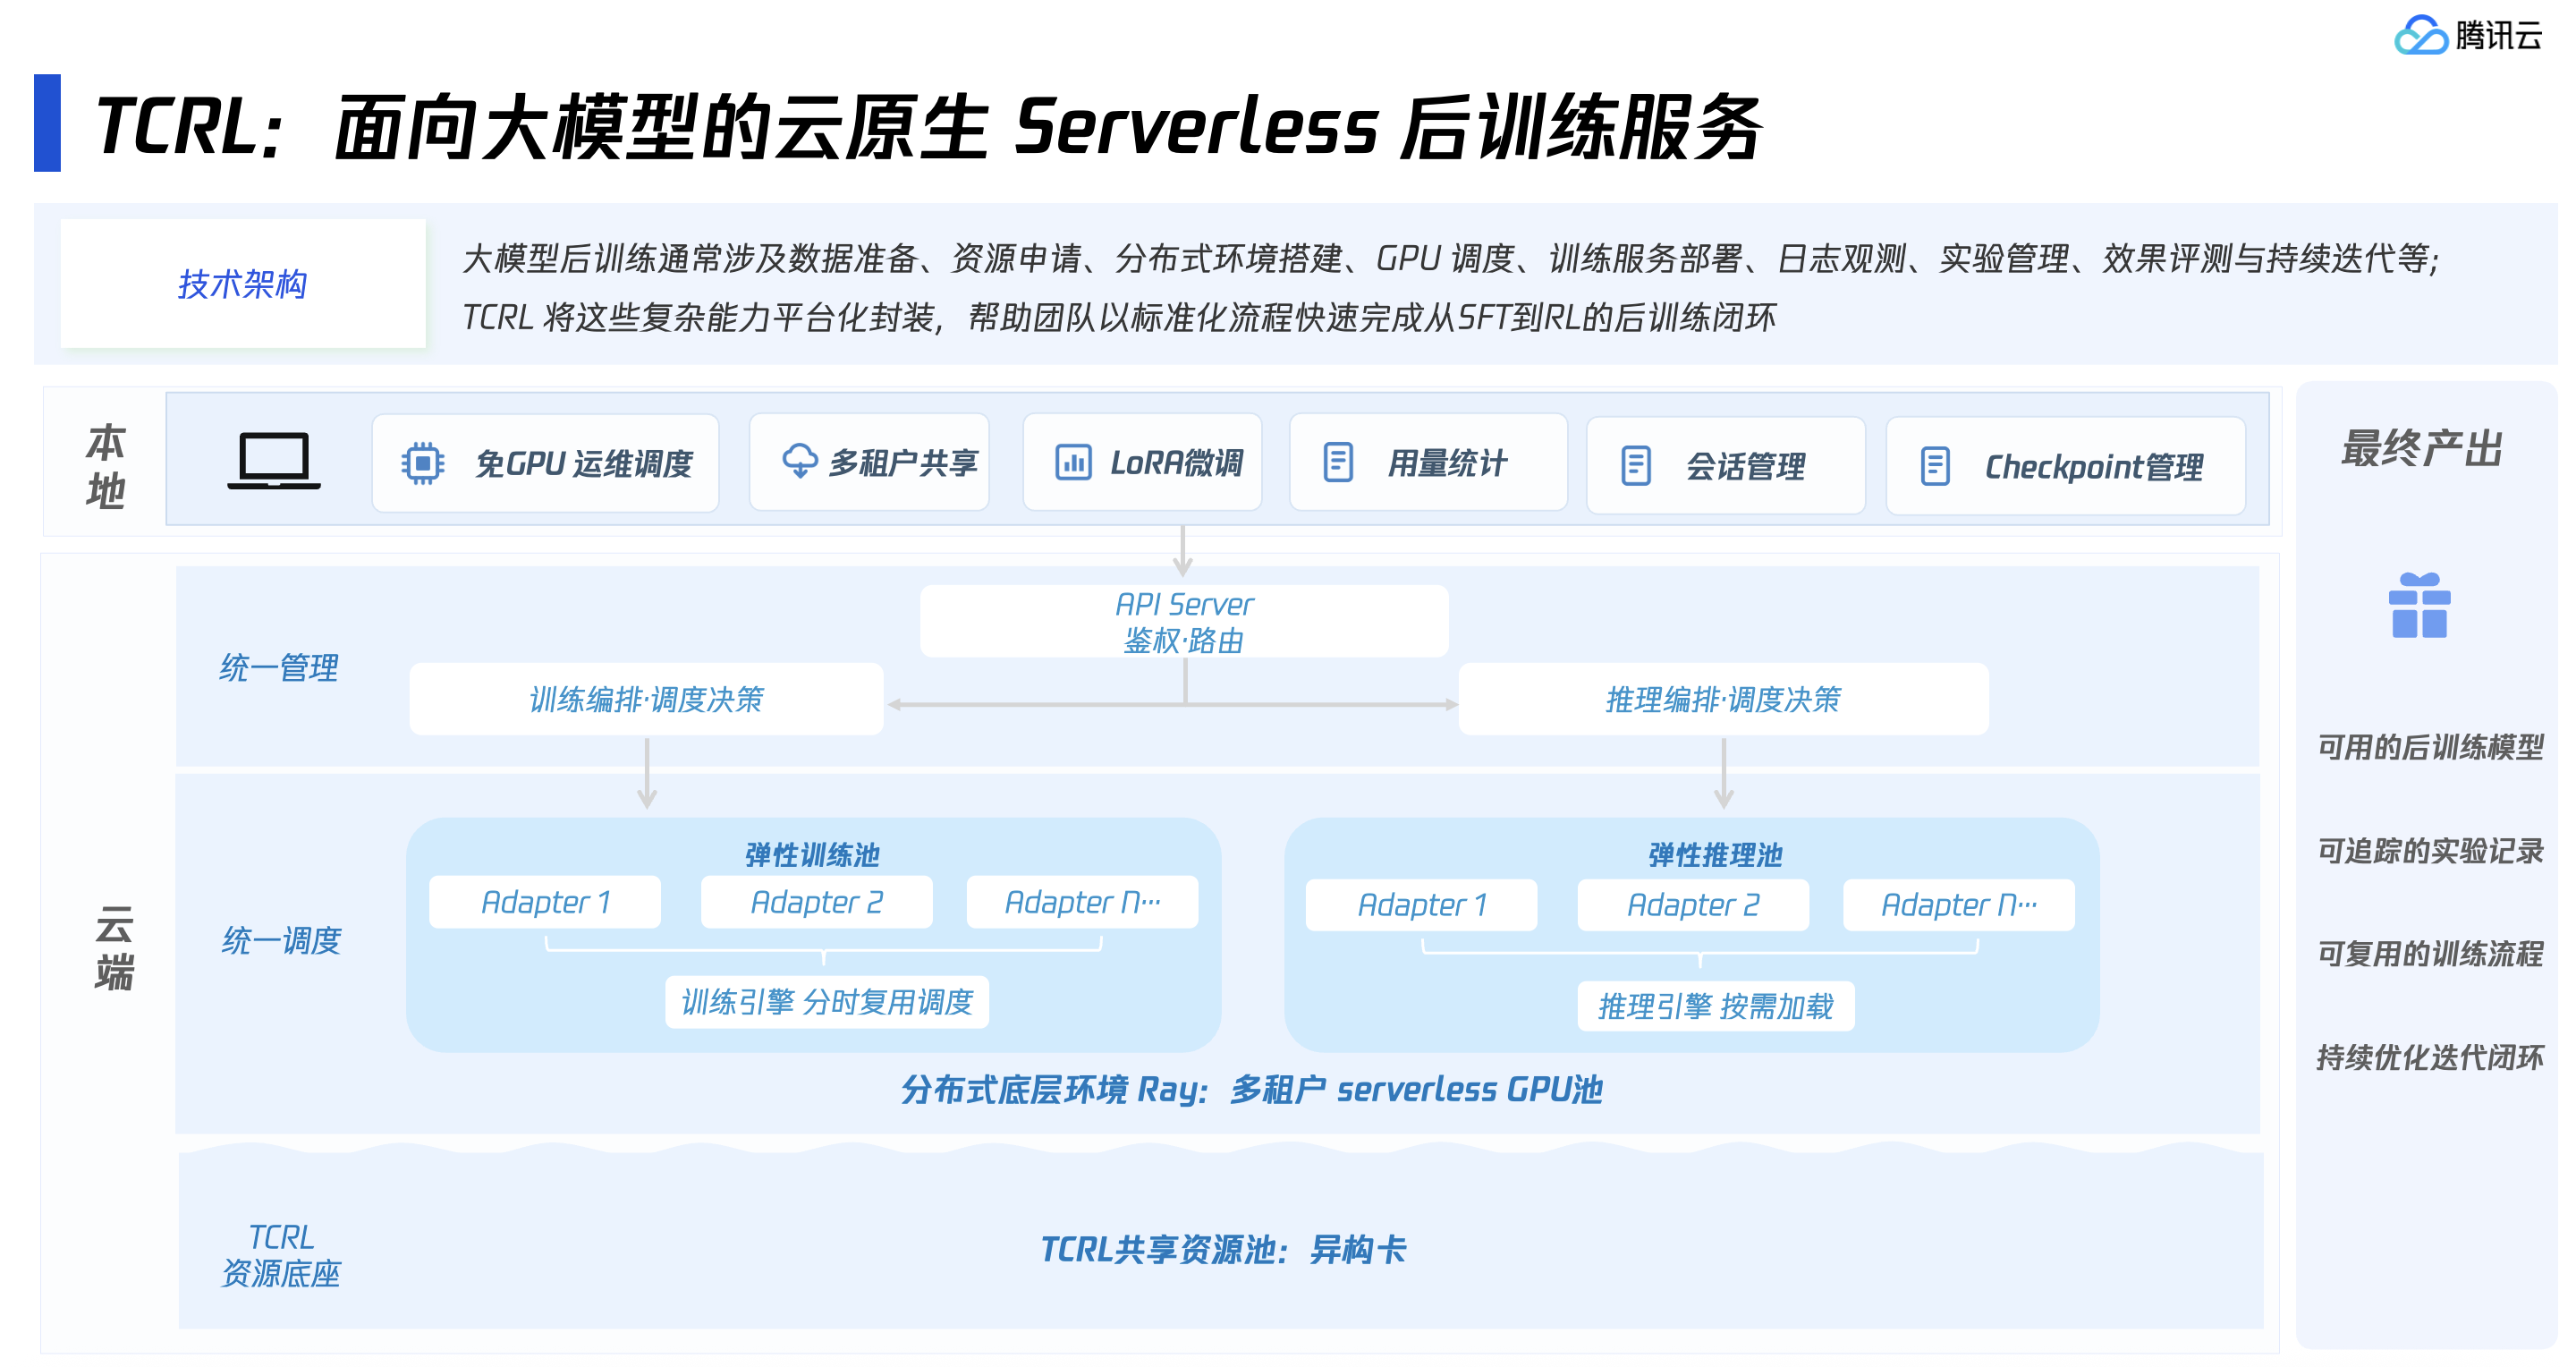
腾讯云模型微调服务(Tencent Cloud Reinforcement Learning,以下简称 TCRL)是面向大模型的云原生 Serverless 模型微调服务,提供监督微调、强化学习、任务追踪和用量监控的一站式能力,让用户更聚焦于数据、算法与训练逻辑本身。用户可以从本地或云端等任意开发环境通过 SDK 提交训练任务,由 TCRL 在云端执行,并在控制台查看任务进度、详情与资源用量。
产品定位
TCRL 保留用户对训练循环和所有算法细节的完全控制——它不是让微调变"简单"的黑盒,而是一个在屏蔽分布式训练复杂性的同时保留控制力的清晰抽象。用户只需在 CPU 机器上编写一个简单的训练循环,包括数据/环境定义和损失函数。TCRL 负责将训练高效地分布到多 GPU 上执行,更换模型只需修改代码中的一个字符串。以下是职责划分:
用户负责 | 用户编写 | TCRL 负责 |
数据与 RL 环境 — 自定义训练数据,在 CPU 上运行 | 简单 Python 脚本 | 大模型高效分布式训练(Qwen3.5-122B-A10B、Qwen3.8-27B-128K 等) |
训练逻辑 — 损失函数、训练循环、评测 | API 调用:forward_backward()、optim_step()、sample()、save_state() | 可靠性 — 硬件故障透明处理 |
产品架构
功能特性
TCRL 服务当前支持的功能:
TCRL 支持微调 1B 到 1T+ 参数的开源模型,包括稠密模型和 MoE 架构。完整列表见 模型与定价。
TCRL 采用 LoRA 微调而非全量微调。在许多重要场景(尤其是 RL)中,LoRA 与全量微调性能相当(参见 LoRA Without Regret)。
您可以下载训练好的模型权重,在 TCRL 之外使用。
功能速览
TCRL 的核心功能集中在以下几个关键函数:
forward_backward:输入数据和损失函数,计算并累积梯度。
optim_step:使用累积的梯度更新模型参数。
sample:从训练好的模型生成输出。
其他用于保存/加载权重和优化器状态的函数。


