本手册面向需要在 WeData 中运行 dbt 项目的数据开发者。阅读前提:你已了解 dbt 的基本概念(model、ref、命令行用法),并在本地跑通过 dbt 项目。
1. 快速上手
本章以「Git 仓库里的一个 dbt 项目,在 WeData 上定时执行」为目标,只需 5 步:
步骤 | 操作 | 预期结果 |
1 | 确认你的 dbt 项目已托管在 Git 仓库(项目根目录含 dbt_project.yml) | 仓库可访问 |
2 | 在 WeData「项目管理」中注册 Git 仓库地址,并完成个人 Token 配置 | Git 下拉列表中能选到该仓库 |
3 | 在编排空间新建任务,任务类型选 dbt,选择 Git 仓库、分支和项目所在文件夹 | 任务创建成功 |
4 | 保持默认命令( dbt deps → dbt seed → dbt run),选择 DLC 数据源和计算资源,保存并提交 | 任务可运行 |
5 | 点击「测试运行」,到运维中心查看日志 | 看到 dbt 各模型的 PASS 汇总 |
出错怎么办:跑不通时按顺序检查——Git 仓库选不到 → 检查个人 Token 是否已配置(见 1.2);运行失败 → 看日志区分是命令层还是 SQL 层报错。
2. 准备工作
2.1 环境安装要求
新增资源组可在界面上安装 python3.9版本,系统自动安装 dbt 所需依赖包。
已有资源组若已安装 python3.9版本,则需手动安装 dbt 所需依赖包:dbt-core、dbt-dlc、dbt-sql-python
仅支持跑 DLC SQL,若客户需要跑其他来源任务,则需自行安装对应包。
安装包下载地址。
已有资源组若未安装 python3.9版本,则可在界面上安装 python3.9版本,系统自动安装 dbt 所需依赖包。
2.2 网络要求
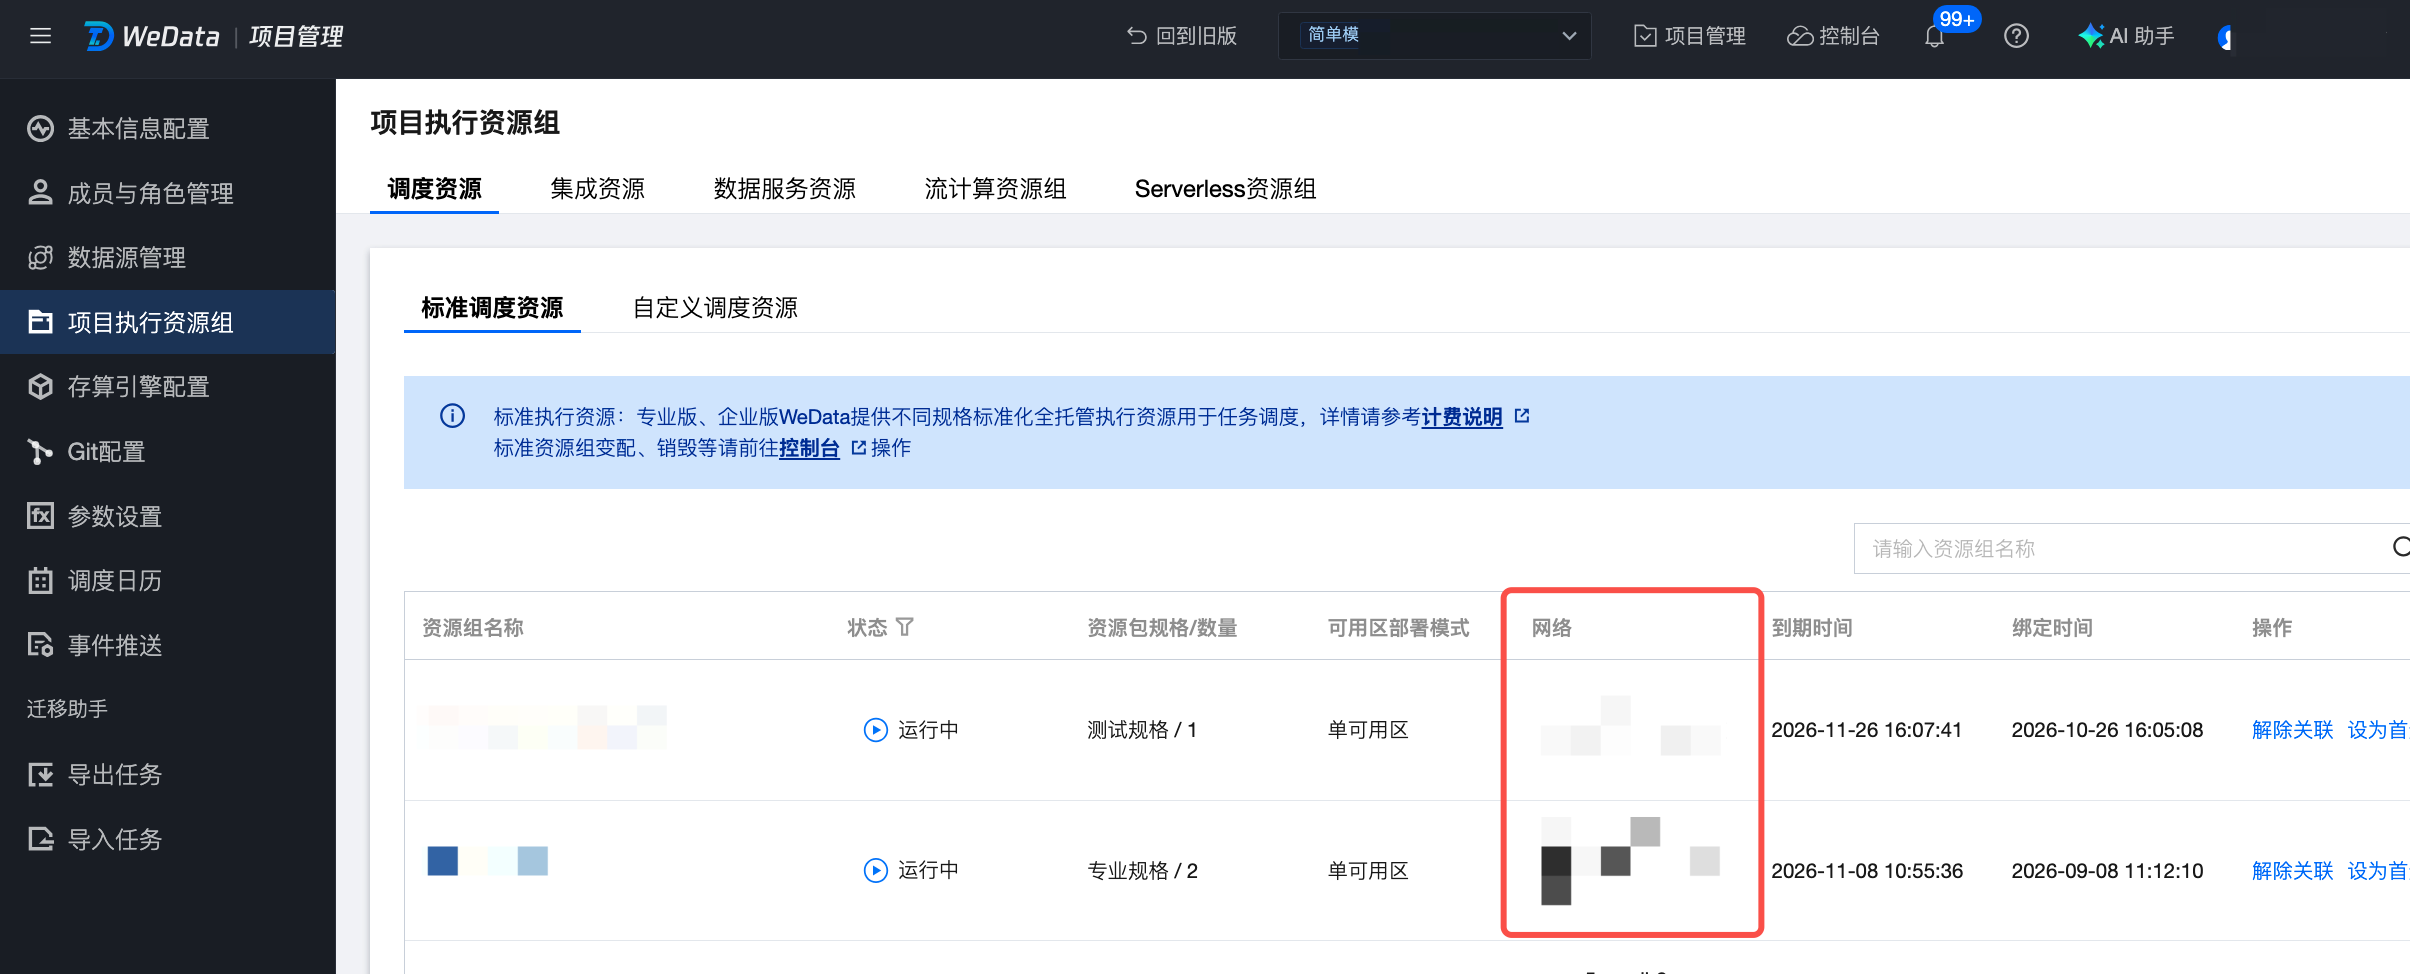
使用调度资源组对应网络配置需在 DLC 资源组上配置,若有则忽略当前步骤。
查看使用调度资源组的网络信息
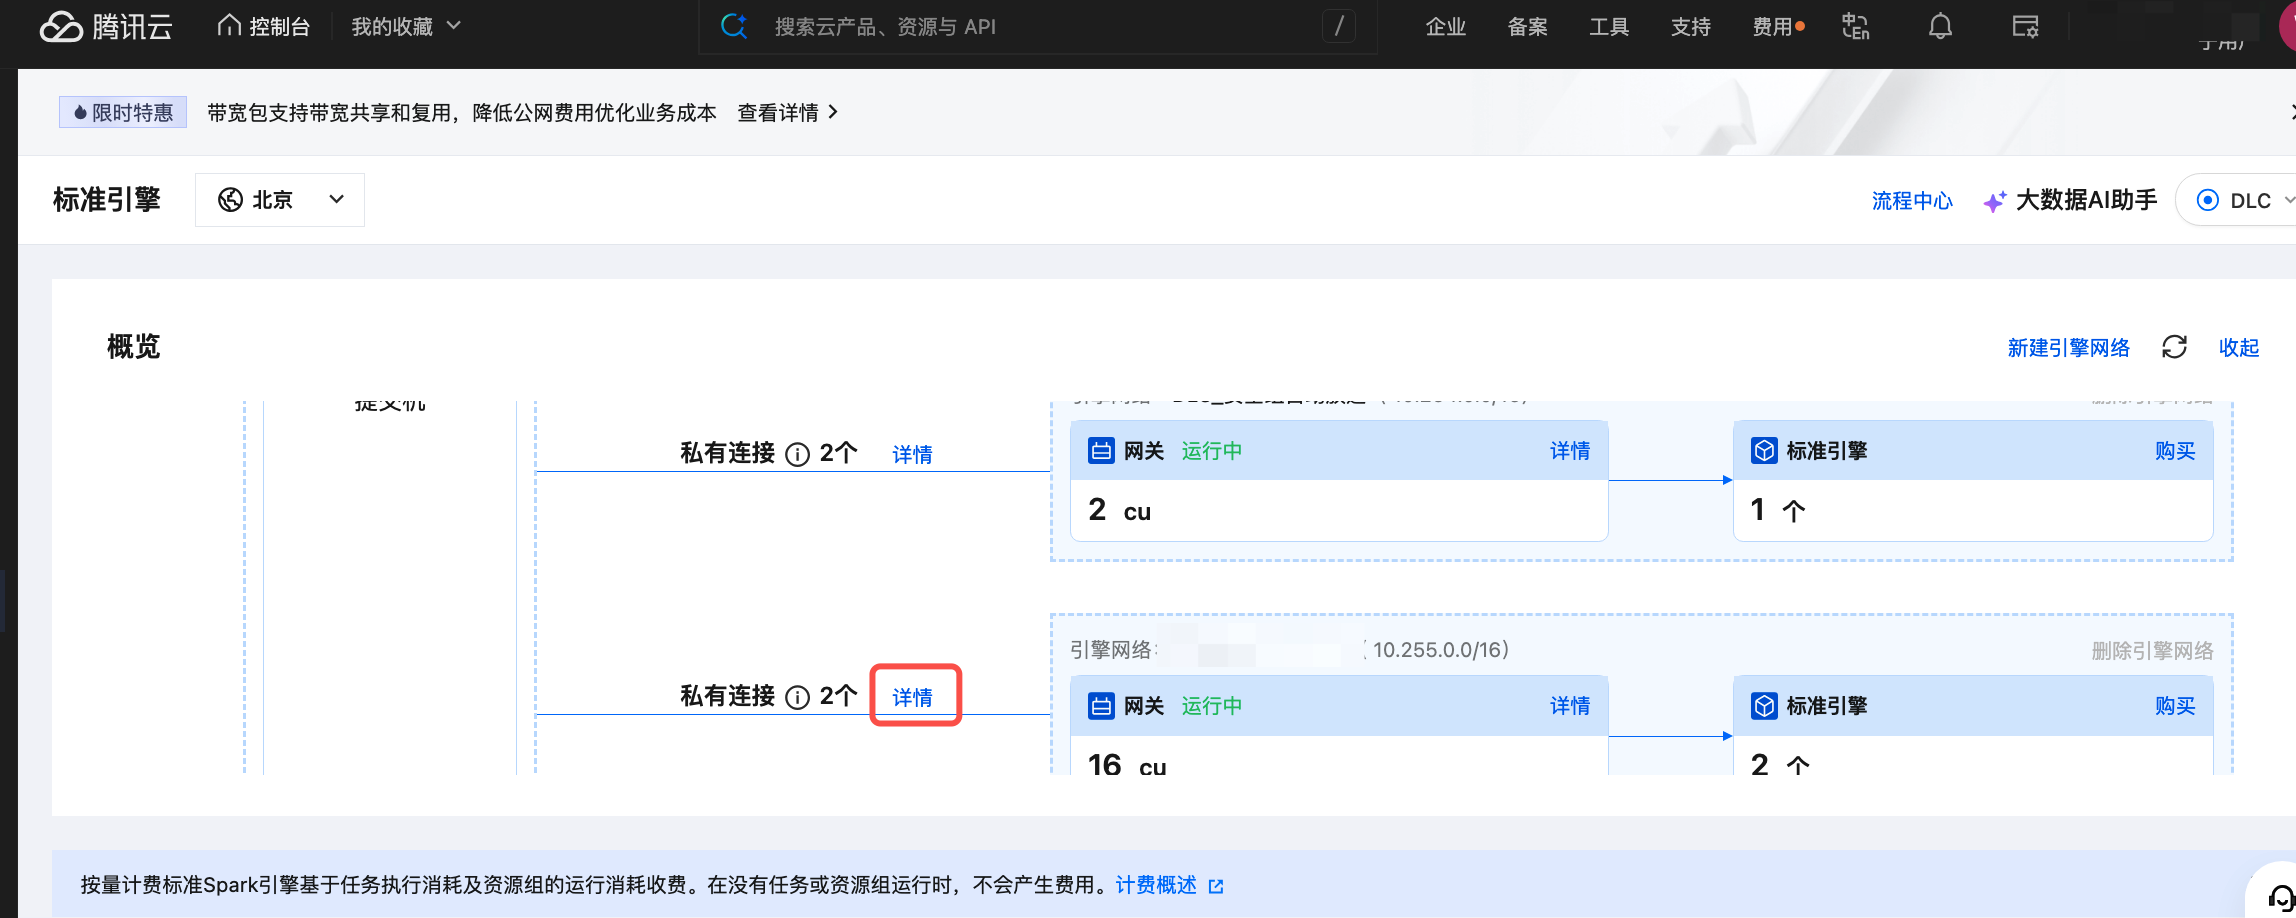
在 DLC 控制台找到引擎对应网络,点击详情
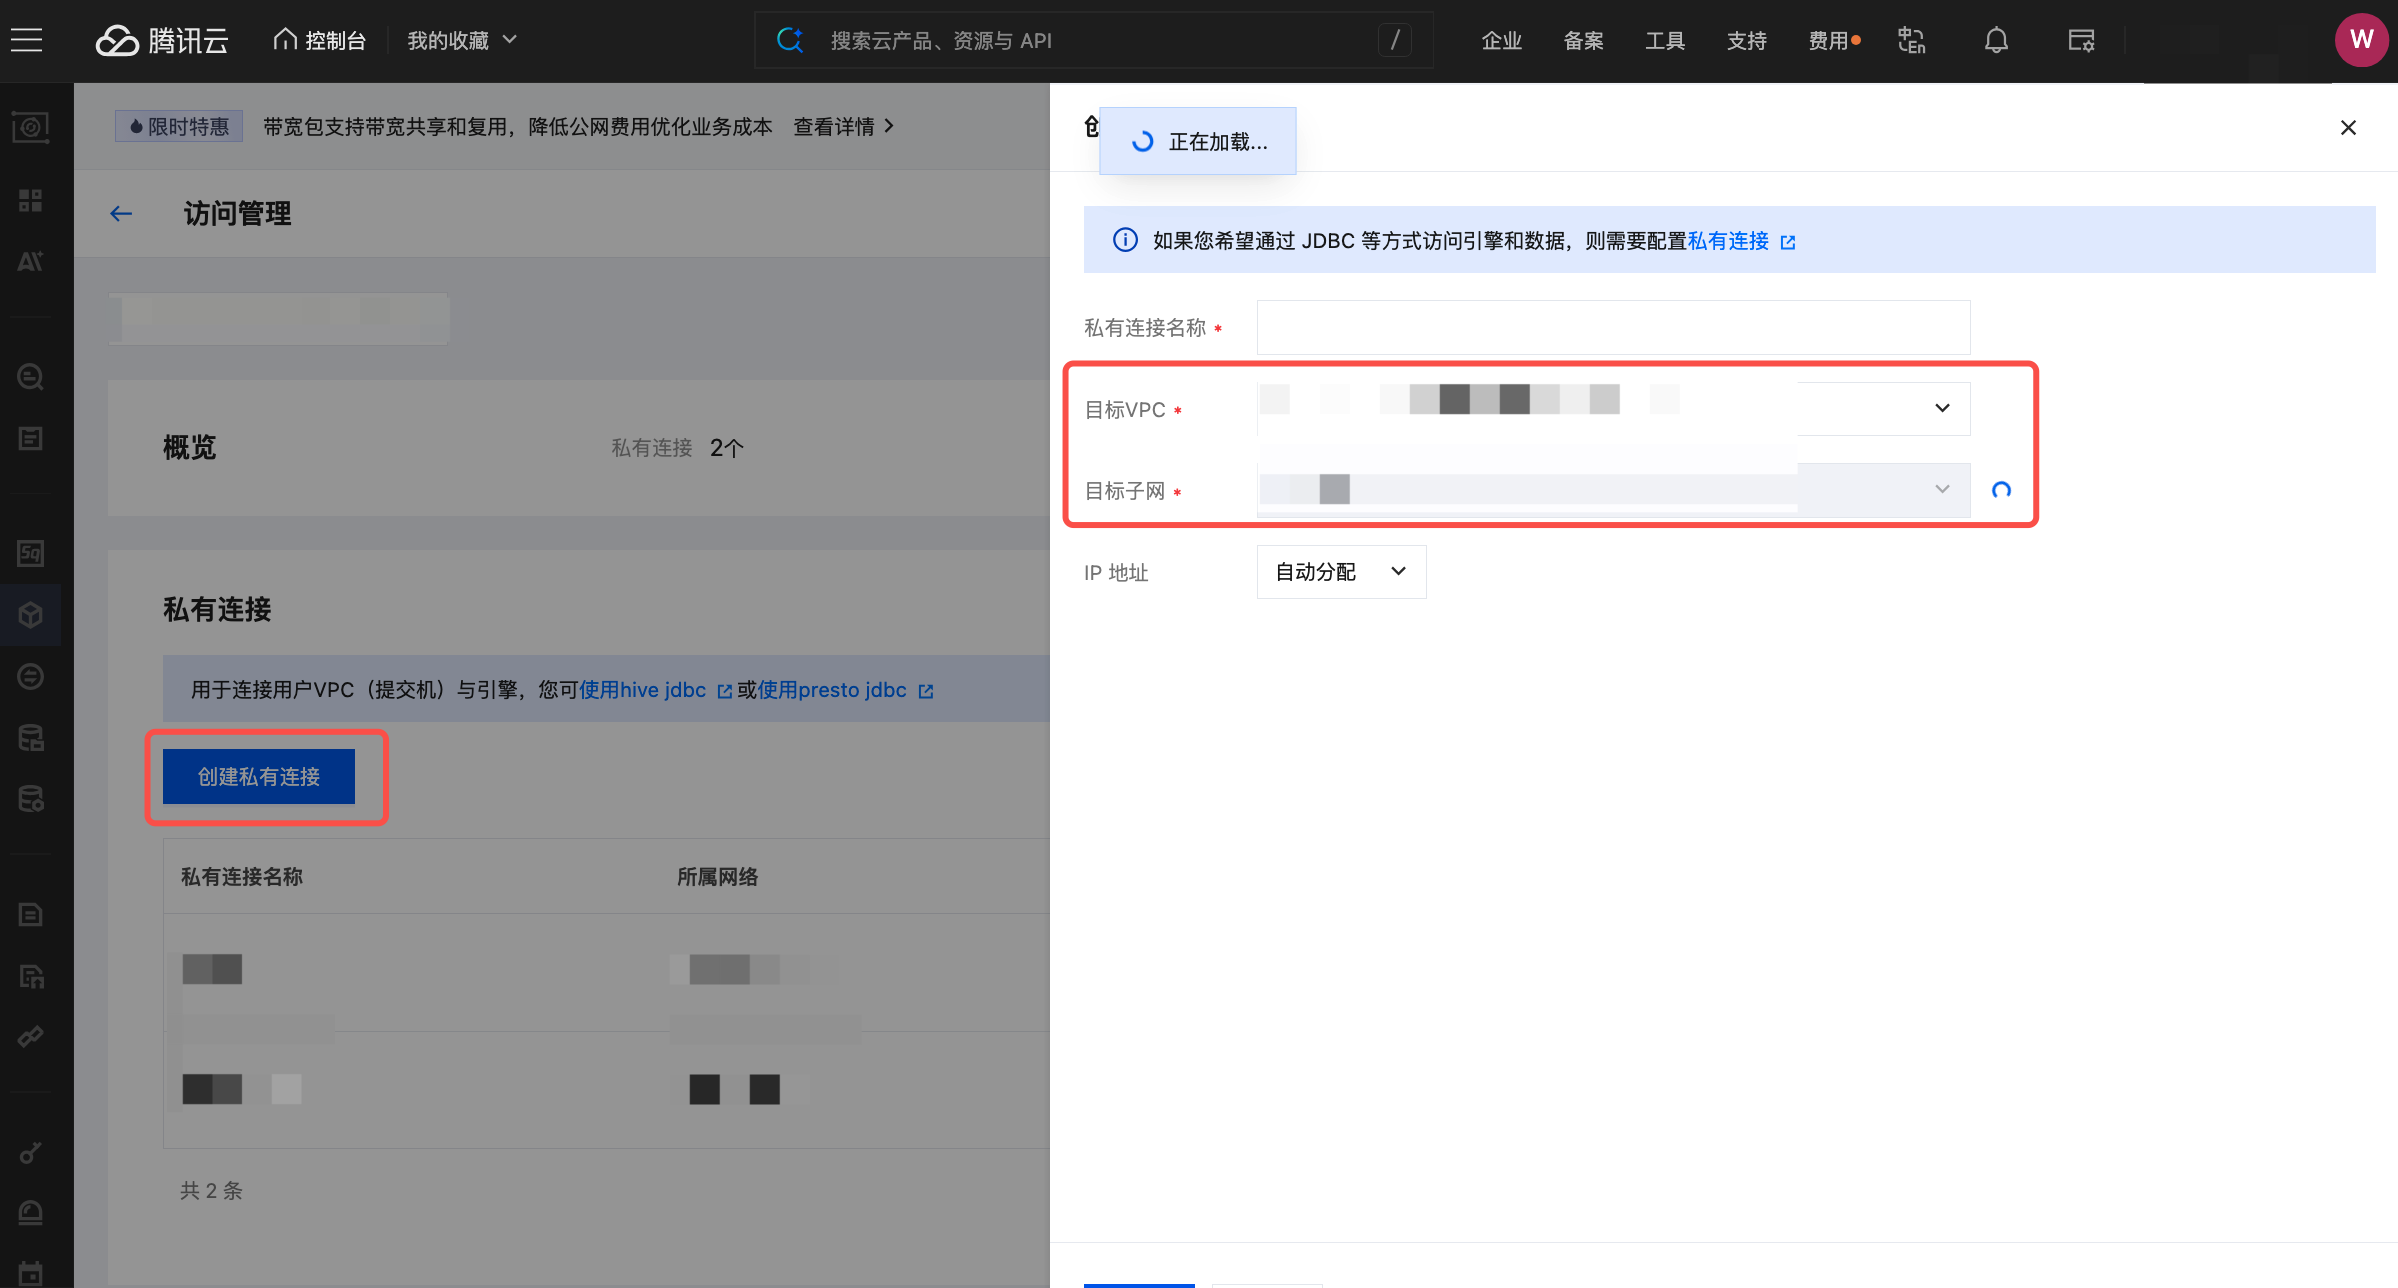
创建私有连接,并选择使用调度资源组的 VPC 信息。
2.3 dbt 项目要求
项目为标准 dbt 项目结构:根目录有
dbt_project.yml,模型放在 models/ 目录下无需编写 profiles.yml:连接信息(计算资源、输出 Catalog/数据库)在任务配置中填写,平台在运行时自动生成连接配置并注入凭证,Token 不需要写在代码里
少数高级场景需要自定义连接时,参见 5.3「自定义 profiles.yml」
2.4 Git 仓库与个人 Token
dbt 任务的代码来自 Git 仓库(本期仅支持 Git 来源,Studio 文件目录来源暂未开放):
1. dbt 项目代码托管在 Git 仓库(支持 HTTPS/SSH)
2. 在 WeData「项目管理」中注册该 Git 仓库地址
3. 完成个人 Token 配置——未配置 Token 时,新建任务时 Git 仓库下拉不可选,鼠标悬停会提示「请先完成个人 Token 配置」,点击可跳转配置页
2.5 权限清单
dbt 任务使用工作流的「运行账号」执行,该账号需要具备:
权限 | 说明 |
DLC 计算资源使用权限 | 任务选中的数据源、计算引擎、资源组 |
目标 Catalog / 数据库使用权限 | 模型建表输出的位置 |
模型涉及对象的读写权限 | 模型读取的源表(SELECT)和产出的表(写入) |
权限通过 WeData 现有权限体系统一申请管理,任务执行前请确认运行账号已具备以上权限。
3. 创建 dbt 任务
3.1 新建任务
入口与通用任务类型一致:目录树右键新建,或在工作流 DAG 图中添加节点。任务类型选择 dbt(位于 JDBC SQL 之后),其余(所属工作流、任务名称、目录)同常规任务。
dbt 任务可以放在 for-each 节点内部、分支节点下游、归并节点上游,用法与其他任务节点相同。
3.2 代码来源(Git)
配置项 | 填写说明 |
Git 仓库地址 | 下拉选择已在「项目管理」中注册的 Git 仓库;未配置个人 Token 时该选项禁用 |
分支 | 选择 Git 仓库后可选,默认为该仓库在项目管理中配置的默认分支,可修改 |
文件路径 | 选择仓库和分支后,选择 dbt 项目所在的文件夹(下拉只展示到文件夹层级,支持按名称搜索) |
3.3 dbt 命令
命令列表,必填。默认三条,按顺序执行:
dbt deps # 拉取 dbt_project.yml 中声明的包依赖dbt seed # 载入 seeds/ 目录下的 CSV 种子数据dbt run # 按依赖顺序执行 models/ 下的模型
最多 10 条命令,按列表顺序执行;常用命令还有
dbt test(数据质量校验)、dbt snapshot、dbt docs generate命令支持 dbt 原生参数,如
--select、--exclude、--vars命令中可以引用 WeData 参数(工作流参数、任务参数、上游传递参数、调度时间参数),写法见 5.1
3.4 连接配置(系统内置 profile)
profile 定义方式保持默认的「系统内置」即可,按下面逐项填写。每一项的含义:
配置项 | 必填 | 填写说明 |
引擎类型 | 是 | 固定选择 DLC(本期仅支持 DLC 引擎) |
DLC 数据源 | 是 | 选择数据源管理中已注册的 DLC 数据源;可选范围与创建 DLC SQL 任务时一致 |
DLC 数据引擎 | 是 | 选择该数据源下的 DLC 计算引擎,标准引擎为 Spark;可选范围与创建 DLC SQL 任务时一致 |
DLC 资源组 | 是 | 执行 SQL 分析使用的资源组 |
输出 Catalog | 否 | dbt 模型建表输出的 Catalog;不填默认 DataLakeCatalog |
输出数据库 | 否 | dbt 模型建表输出的数据库;不填默认 default |
3.5 其他任务配置
调度资源组、任务属性、调度设置、依赖配置:与现有任务类型的配置方式一致
产出登记:引擎选择 DLC 时支持登记 DLC 表;选择自定义 profile 时不展示
参数传递:dbt 任务当前不支持向下游任务传递参数(该选项置灰);支持引用父任务/上游参数
版本管理:支持版本管理与回滚,配置变更记录在版本中
4. 运行任务
4.1 测试运行
单击测试运行,平台会完成整个执行流程:拉取 Git 代码 → 准备运行环境(平台预装 dbt 及 DLC 适配器,无需安装)→ 自动注入运行账号凭证 → 按顺序执行命令列表。
测试运行的结果页直接展示 dbt 日志,支持搜索、下载日志;选择 DLC 引擎时提供「DLC 跳转」入口(下接下拉选择,因为一次 dbt 运行对应多段 SQL 执行),可跳转查看每段 SQL 在引擎上的执行详情。
4.2 提交调度运行
单击提交任务后,任务可随调度配置进行周期调度执行。可在运维中心查看运行状态和详情。
5. 运维:日志、产物、重跑
5.1 运行日志(两层视角)
日志 | 在哪看 | 内容 |
dbt 日志 | 运维中心运行详情页直接展示 | 命令执行进度、模型编译结果、每个模型的执行状态与耗时、PASS/ERROR 汇总 |
DLC 引擎日志 | 通过「DLC 跳转」入口进入 | SQL 在计算引擎上的执行计划、引擎侧报错堆栈、资源占用 |
定位方法:dbt 日志能看出哪个模型失败、命令层有没有报错;如果 dbt 日志只有适配器回传的摘要、看不到根因,通过 DLC 跳转看引擎层的完整报错。
5.2 产物下载
运行详情页提供一键下载入口,产物包括:
manifest.json:dbt 项目完整元数据,含模型之间的依赖关系,可给下游任务或文档工具使用
run_results.json:本次执行结果,含每个模型的执行状态、耗时、执行的 SQL
5.3 重跑与失败处理
支持任务级重跑:重新执行整个命令列表(重新拉代码、装依赖、注入凭证);不支持模型级重跑
失败诊断:错误日志区分命令执行层(dbt 报错,如编译失败、依赖拉取失败)和 SQL 执行层(引擎报错,如语法错误、权限不足、资源不足),按层定位
6. 进阶用法
6.1 参数传递(两跳写法)
WeData 参数和 dbt 变量是两套体系,必须通过
--vars 桥接,固定两步:第一跳:命令里用 ${...} 引用 WeData 参数。
dbt run --vars '{"dt": "${yyyyMMdd}"}' --select my_model
可引用:工作流参数、任务参数、上游传递参数、调度时间参数(
${yyyyMMdd} 及变形,如 ${yyyy-MM-dd}、${yyyyMMdd-1})。平台在命令执行前把 ${...} 替换为实际值。第二跳:模型 SQL 里用 var() 读取。
selectorder_id,'{{ var("dt") }}' as biz_datefrom {{ source('dw', 'dws_sales') }}where dt = '{{ var("dt") }}'
注意:
var("dt") 里的名字必须和 --vars 里的 key 完全一致,否则取不到值。模型 SQL 里不能直接写 WeData 的 ${...} 参数。6.2 常用命令场景示例
场景 | 命令写法 |
只跑指定模型及其下游 | dbt run --select my_model+ |
按调度日期传参 | dbt run --vars '{"dt": "${yyyyMMdd-1}"}' |
跑完模型后执行质量校验 | 命令列表末尾追加 dbt test |
排除某些模型 | dbt run --exclude stale_models |
6.3 自定义 profiles.yml(高级用法)
在 dbt 项目中编写
profiles.yml,任务配置中「profile 定义方式」选择自定义,并填写 profile 文件路径(项目内的相对路径,不填默认项目根目录)Token 位置写
{{ env_var('DBT_ACCESS_TOKEN') }},凭证仍由平台在运行时自动注入,不要把 Token 写死在文件里选择自定义后,2.4 的连接配置区域不再展示;产出登记、DLC 跳转等依赖 DLC 引擎的功能也不可用
6.4 通过 Bundle 进行 CI/CD 部署
dbt 任务支持作为 Bundle 资源进行导出、部署(generate、bind、validate、deploy 流程),部署时配置项可按目标环境替换,适合多环境发布场景。
7. 与其他任务协同
上下游依赖:dbt 任务作为普通节点纳入工作流 DAG,上游可接 SQL/Shell/Spark 等任务,下游同理——典型链路:数仓加工任务 → dbt 任务(指标计算)→ 下游任务。
引用上游参数:支持引用父任务/上游传递的参数(经 5.1 的 --vars 方式进入模型)。
向下游传参:不支持。
批量操作:支持修改资源组、修改负责人、提交、修改调度设置、删除等批量操作。
8. 功能边界
不支持项 | 说明 |
Studio 目录作为代码来源 | 本期仅支持 Git 来源 |
模型级重跑 | 重跑粒度为整个命令列表,不支持单模型重跑 |
向下游任务传递参数 | 输出参数选项置灰 |
克隆任务 | 不支持 |
标准模式 | 不支持 |
全局搜索 | dbt 任务不出现在全局搜索中 |
非 DLC 引擎 | 本期仅支持 DLC |


