方案概览
企业在批量迁移上云(数十甚至上百个 PostgreSQL 数据库实例)时,传统 DTS 控制台流程存在明显的重复劳动:每个任务都需要在控制台逐一完成购买、源端/目标端配置、迁移对象选择、迁移类型与校验选项等多次表单配置;预检失败后需要在控制台与数据库之间反复切换排查;批量任务运行期间需要逐个查看状态;迁移报错的定位高度依赖 DBA 经验;割接环节涉及结束时机、会话检查、反向逃生链路等多个易错步骤。
TencentDB Agent(腾讯云数据库 AI 服务)与 DTS 深度结合,将上述全流程收敛为对话式操作:用户在 Agent 对话中一次性描述迁移需求(支持批量),Agent 自动完成前置校验、任务创建、状态跟踪、数据校验、异常诊断与割接执行,并内置防呆门禁与安全护栏。本文以 PostgreSQL 到 PostgreSQL(PG2PG)迁移为例,介绍基于 TencentDB Agent 完成 PostgreSQL 批量迁移的完整流程。
运维场景
批量任务反复配置:迁移上云通常涉及大量规格相近的实例。传统方式下每个任务要在控制台完成4 ~ 5步表单配置,100个实例意味着上百次重复操作,且配置项容易遗漏(如忘记开启全量校验)。
预检失败反复排查:DTS 前置校验项多(版本兼容、逻辑复制参数、权限、对象冲突等),失败后需要用户在控制台、数据库和文档之间来回切换定位原因,修复后重试的周期长。
批量状态跟踪低效:批量任务运行中,用户需要逐个进入任务详情查看阶段与进度,无法一眼掌握全局。
异常诊断依赖经验:迁移链路报错分散在结构迁移(SCT)、全量(Dumper/Loader)、增量(River/Sinker)等阶段,判断"是源端还是目标端的问题"需要较强的内核与链路知识。
割接操作门槛高:结束增量任务的时机(readyComplete 状态与延迟为0的判断)、源库停写的会话检查、反向逃生链路的初始化类型与冲突策略配置等,手工操作容易遗漏或误操作。
解决方案
TencentDB Agent 内置 DTS 迁移场景化 Skill,覆盖迁移全生命周期的会话能力。用户在对话中提交需求,Agent 调用 DTS API 完成实际操作,并按内置 SOP 保证操作次序与安全边界。
核心能力映射
迁移阶段 | Agent 会话能力 | 关键行为 |
双端信息提交 | 单任务/批量描述,自动补全可自查项 | 只追问账号密码、迁移范围等必要信息,附临时账号安全提示 |
前置校验 | 自动发起 preflight,对话内渲染报告 | BLOCK 项给出修复动作与文档链接;批量场景输出 HTML 评估报告 |
任务创建 | 单个/批量创建,二次确认 | BLOCK 未清除的任务拒绝创建;创建前确认校验选项与计费影响 |
状态跟踪 | 汇总任务状态、阶段、进度、延迟 | 按 API 实际返回转述,不编造数据 |
数据校验 | 内置校验结果查询、独立校验发起 | 只处理点名任务;不一致时给出订正 SQL 与重验指引 |
异常诊断 | 结构/全量/增量三阶段根因定位 | 五段式输出(分类→证据链→影响→分步方案→预防)+ 结论标签 |
割接与回切 | 六步割接流程、反向逃生链路、回切 | readyComplete 硬前置校验;反向链路自动配置仅增量 + 忽略同名表 |
方案优势
批量化:一条消息描述多个迁移任务,Agent 逐个预检、汇总报告、批量创建,BLOCK 任务自动跳过并标注原因,消除重复表单操作。
门禁防呆:前置校验存在 BLOCK 项时拒绝创建任务(硬门禁);结束增量任务前强制确认任务处于 readyComplete 且延迟为0,避免状态冲突报错。
经验内置:预检修复动作、报错根因判断(如 COPY 协议下 reading/writing 均判源端)、割接会话检查 SQL 等 DBA 经验沉淀为 Agent 内置 SOP,降低操作门槛。
安全可控:临时账号"用完即删"提示、密码仅在会话内使用、写操作前二次确认,敏感操作均有护栏。
应用场景
场景 | 核心痛点 | Agent 关键能力 |
批量迁移上云 | 逐任务反复配置、预检来回排查 | 批量预检 HTML 报告 + BLOCK 门禁 + 批量创建 |
迁移期状态跟踪 | 逐个任务点开查看 | 一句话输出全部任务状态/阶段/进度表 |
数据一致性验收 | 校验配置与结果查看分散 | 内置校验结果查询 + 点名发起独立校验 + 订正 SQL |
迁移异常处理 | 报错定位依赖经验 | 五段式诊断 + 根因结论标签 + 恢复方案 |
割接与回退 | 步骤多、易遗漏 | 六步割接 Runbook + 反向逃生链路 + 回切执行 |
整体链路
说明:
① 提交双端信息(单/批量)→ ② 前置校验(BLOCK 项须修复)→ ③ 任务创建(单/批量)→ ④ 任务状态查询 → ⑤ 数据一致性校验 → ⑥ 异常诊断(按需)→ ⑦ 割接与反向逃生
其中②为硬门禁:前置校验存在 BLOCK 项时,Agent 会拒绝创建任务;创建任务前 Agent 会主动确认是否开启全量数据校验。
前提条件
条件 | 说明 |
腾讯云账号 | 已完成实名认证,并开通 TencentDB Agent(数据库 AI 服务) |
DTS 权限 | 操作账号具备 DTS 迁移任务相关权限 |
源端实例 | 自建 PostgreSQL 或腾讯云 PostgreSQL 实例,已开启逻辑复制(wal_level=logical),账号具备 REPLICATION 等价权限 |
目标端实例 | 腾讯云 PostgreSQL 实例运行中,无与源端同名的待迁移库 |
注意事项
1. PG2PG 链路仅支持库粒度迁移,不支持表级选择;单个任务最多 6000 个对象。
2. 目标端不能存在与待迁移库同名的库,否则校验不通过。
3. ROLE、PROCEDURE、TRIGGER、FUNCTION 不在迁移范围内,割接前需在目标端手工重建。
4. 全量 + 增量任务在校验通过后不会自动结束,需要在业务低峰期、源库停写后手动完成增量迁移(割接流程见步骤七)。
5. 建议使用临时迁移账号完成任务后即删除;账号密码仅在对话会话内使用,不要写入长期文档。
操作步骤概要
详细操作步骤
步骤一:提交双端信息
在 TencentDB Agent 对话中描述迁移需求。单任务直接描述;批量场景在一条消息中列出多个任务。Agent 不会反问可自查项(主机、端口、版本、网络连通性),仅追问账号密码、任务类型、迁移范围、待迁移 database 数等必要信息,并附临时账号的创建 SQL 与"用完即删"安全提示。
单任务提示词示例:
帮我对一组 PG2PG 实例做 DTS 迁移启动前检查,注意检测全,任务做全量+增量迁移。源端:实例 ID <源端实例ID>(ap-guangzhou),账号 <源端账号>,密码 <源端密码>,迁移范围:仅迁移库 <库名>(1 个 database)目标端:实例 ID <目标端实例ID>(ap-guangzhou),账号 <目标端账号>,密码 <目标端密码>
批量提示词示例(在单任务描述基础上追加):
请批量预检以下任务,最终输出 html 评估报告。迁移任务1:源端 实例ID <源端实例ID1>(ap-guangzhou),账号/密码 <源端账号>/<源端密码>,范围 仅库 <库名1>;目标端 实例ID <目标端实例ID1>,账号/密码 <目标端账号>/<目标端密码>迁移任务2:源端 专线自建,<专线网关ID> / <vpc-id> / <subnet-id> / ip <源端IP>:5432(ap-guangzhou),账号/密码 <源端账号>/<源端密码>,范围 仅库 <库名2>;目标端 实例ID <目标端实例ID2>,账号/密码 <目标端账号>/<目标端密码>
自建源端支持公网 IP 直连或专线接入两种方式描述。
步骤二:前置校验并修复 BLOCK 项
确认信息后,让 Agent 发起预检:
就按刚才的信息跑预检,migration、全量+增量、仅库 <库名>、待迁移 database 数 1。
Agent 会在对话内完整渲染 Markdown 报告(总览 → BLOCK 阻塞项 → WARN 警告项 → 跳过项 → GRANT SQL → 建议):每条 BLOCK 项附带修复动作(fix_action)与官方文档链接;批量场景额外生成 HTML 评估报告文件。整体结论分为 GO(可直接创建)、CONDITIONAL_GO(有警告,建议处理)、BLOCK(存在阻塞项)三态。
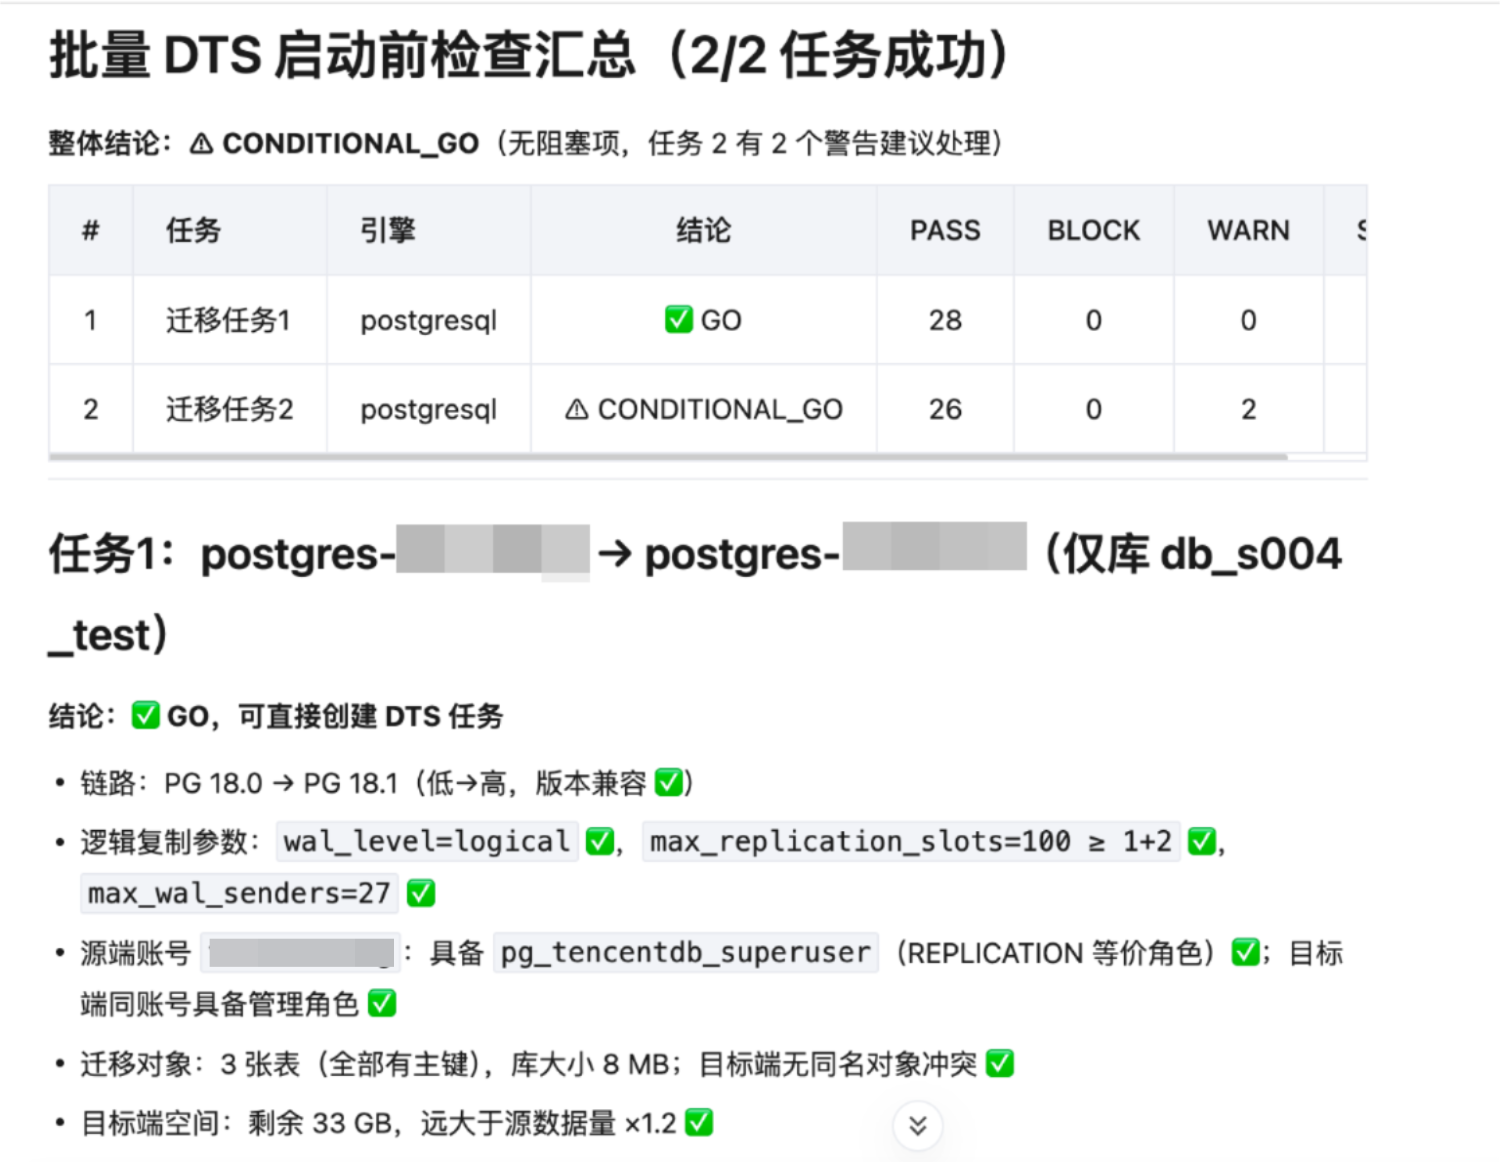
警告:
前置校验存在 BLOCK 项时,Agent 会拒绝创建任务并复述 BLOCK 清单(硬门禁)。请先按修复动作处理(如调整 wal_level、清理目标端同名库、执行 GRANT SQL),修复完成后让 Agent 重跑预检。
修复后重跑示例:
源端 wal_level 已改 logical 并重启,max_replication_slots 调到 10,目标端同名库已删,请重跑预检。源端权限不足,把 GRANT SQL 给我,执行完你再校验一次。
步骤三:批量创建迁移任务
预检通过后,让 Agent 创建任务。单任务与批量均可:
把预检通过的任务都创建成迁移任务,全量+增量、按各自库范围、规格 medium,全量校验都开。
Agent 的行为:
1. 创建前输出任务创建方案(预检门禁结论、执行链路、扣费与数据写入影响、目标端建库说明),并主动确认是否按方案创建及是否开启全量校验。
2. 确认后自动执行"购买创建 → 配置源/目标/对象 → DTS 校验 → 校验通过后启动",并输出任务清单表(任务名、JobId、源端、目标端、迁移方式、全量校验、规格、状态、控制台链接)。
3. 批量场景中,存在 BLOCK 的任务自动跳过并标注原因,不影响其他任务。
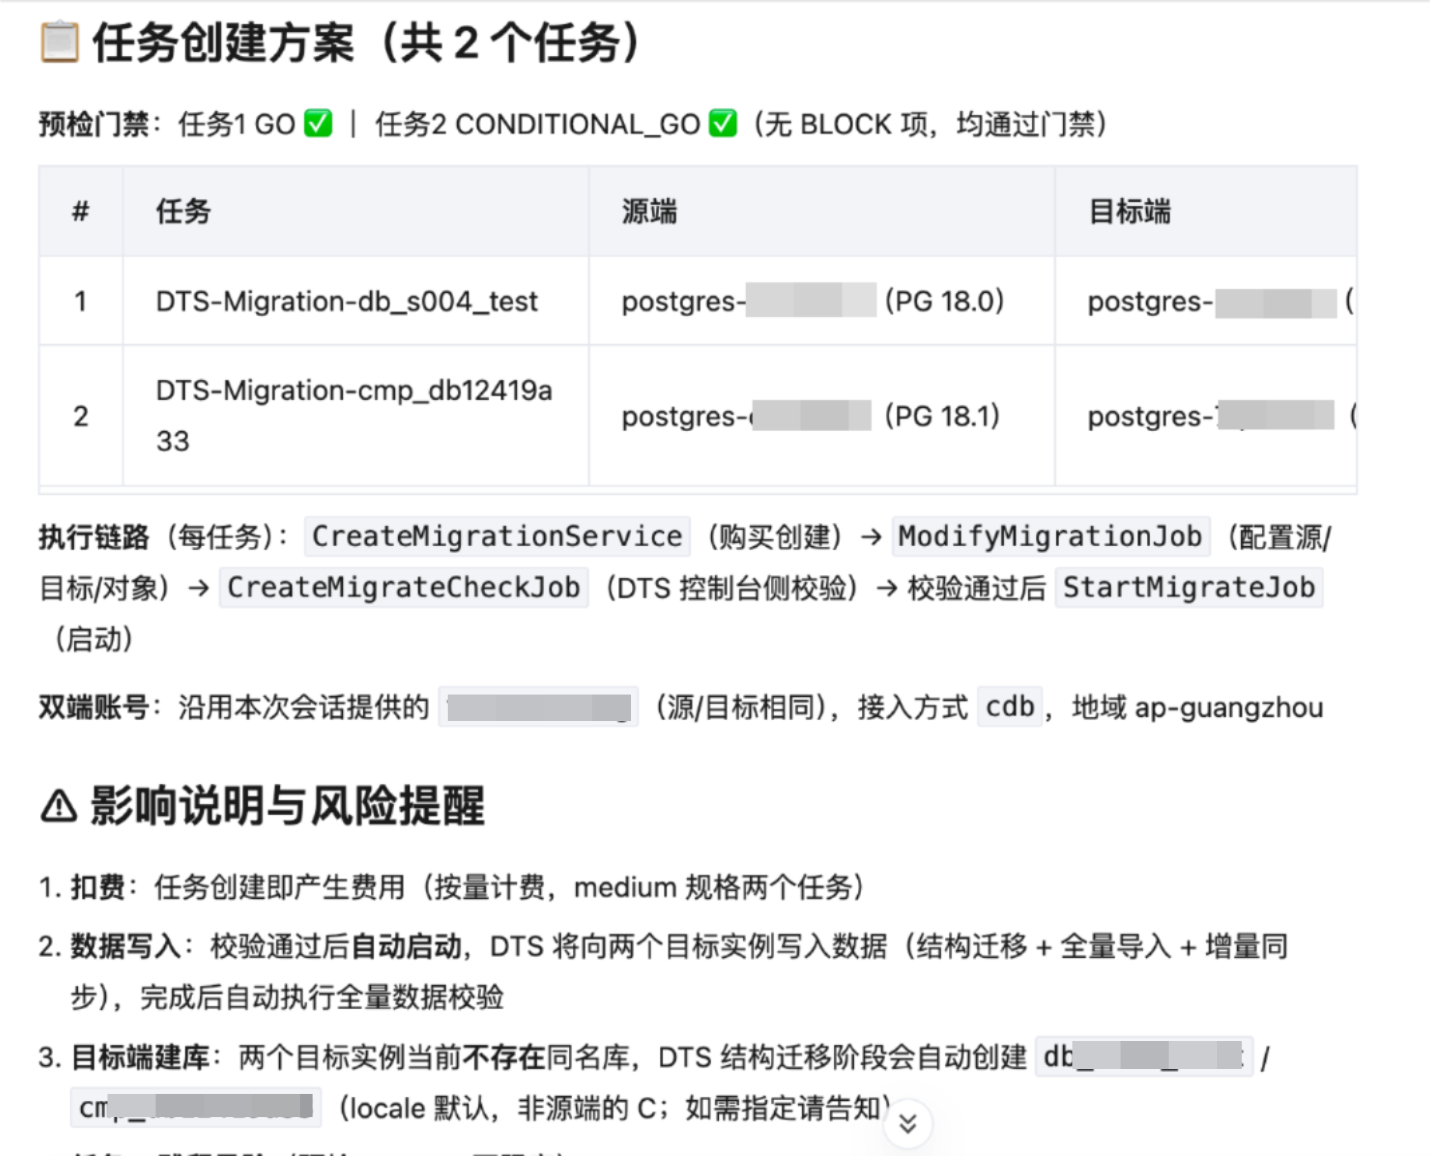
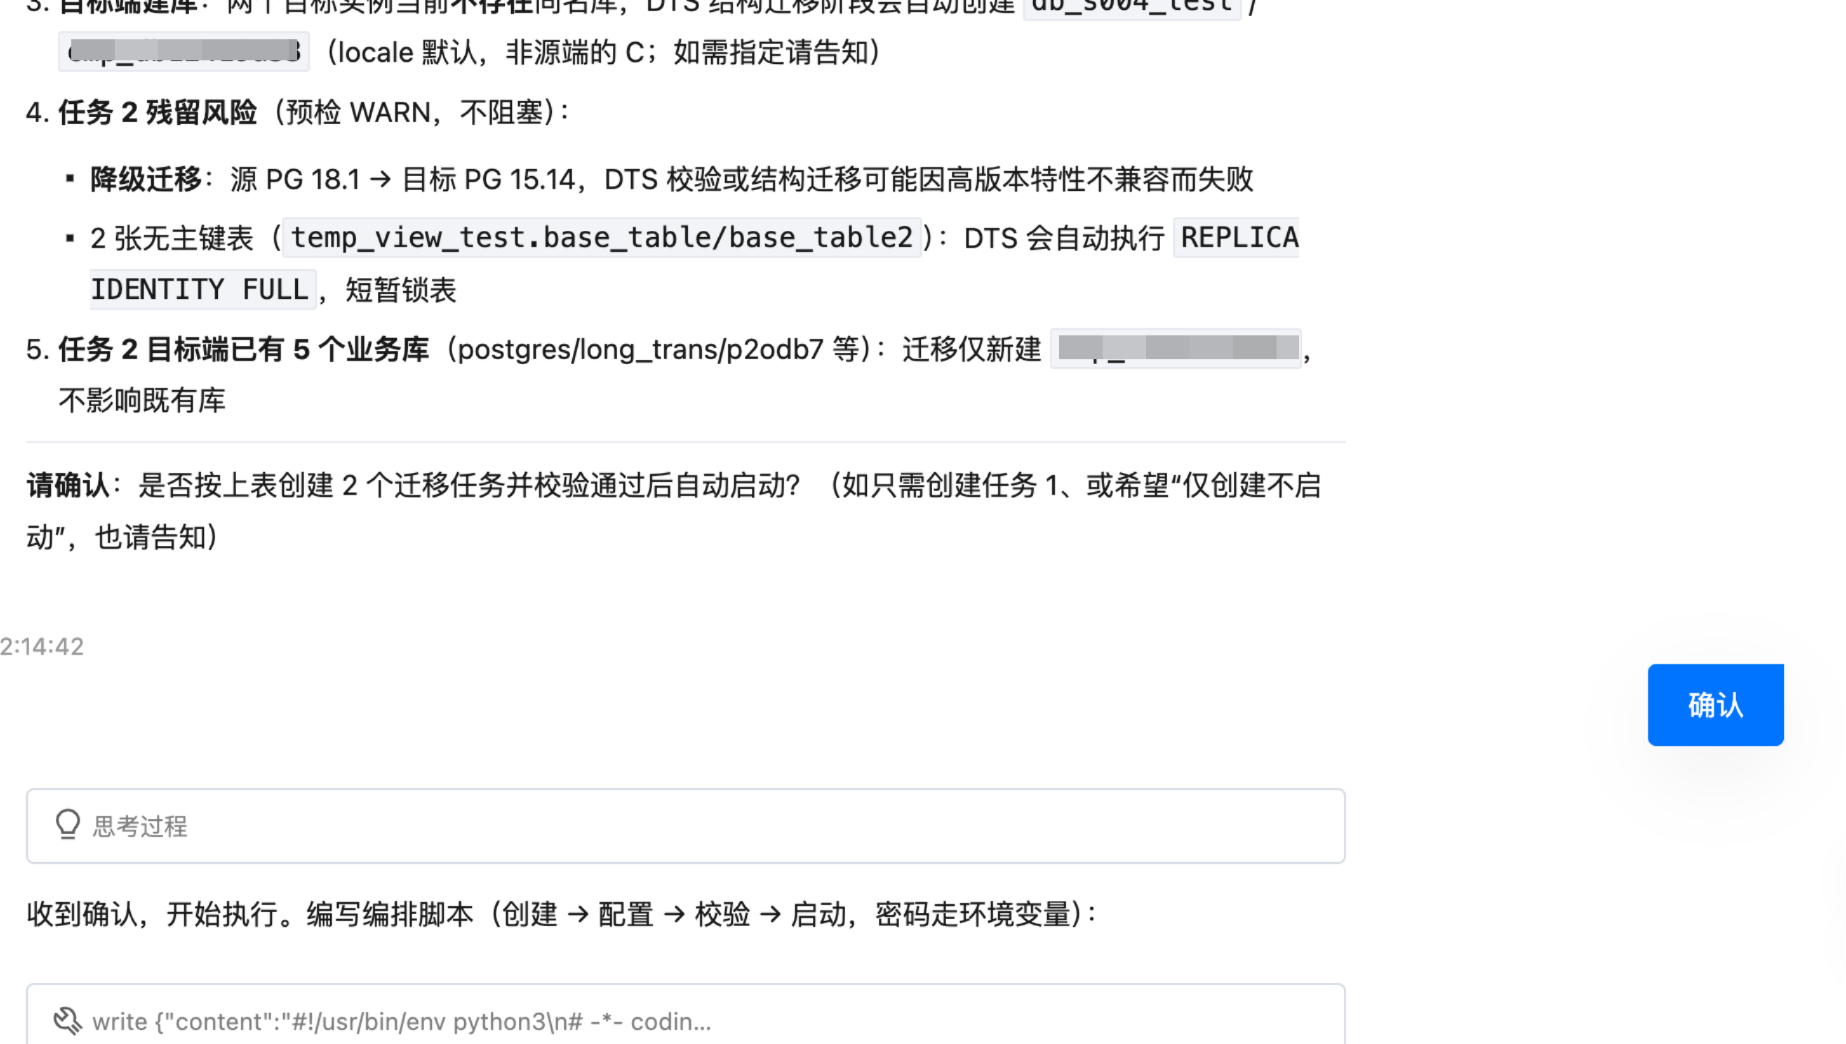
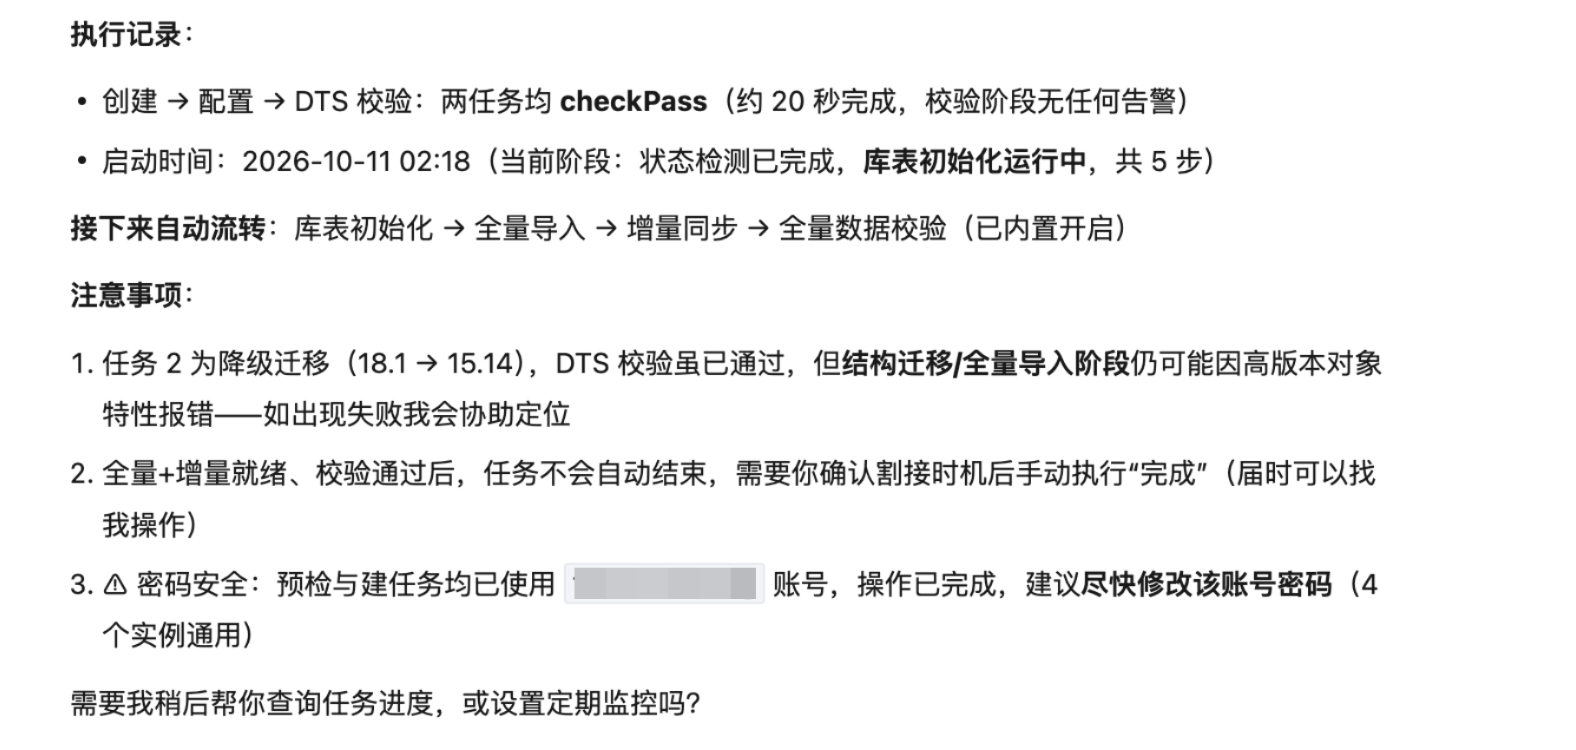
也可以点名创建部分任务(如"帮我把任务1和任务3创建,任务2先不建")。
步骤四:查询任务状态
任务创建后可随时查询进度:
迁移任务跑得怎么样了?
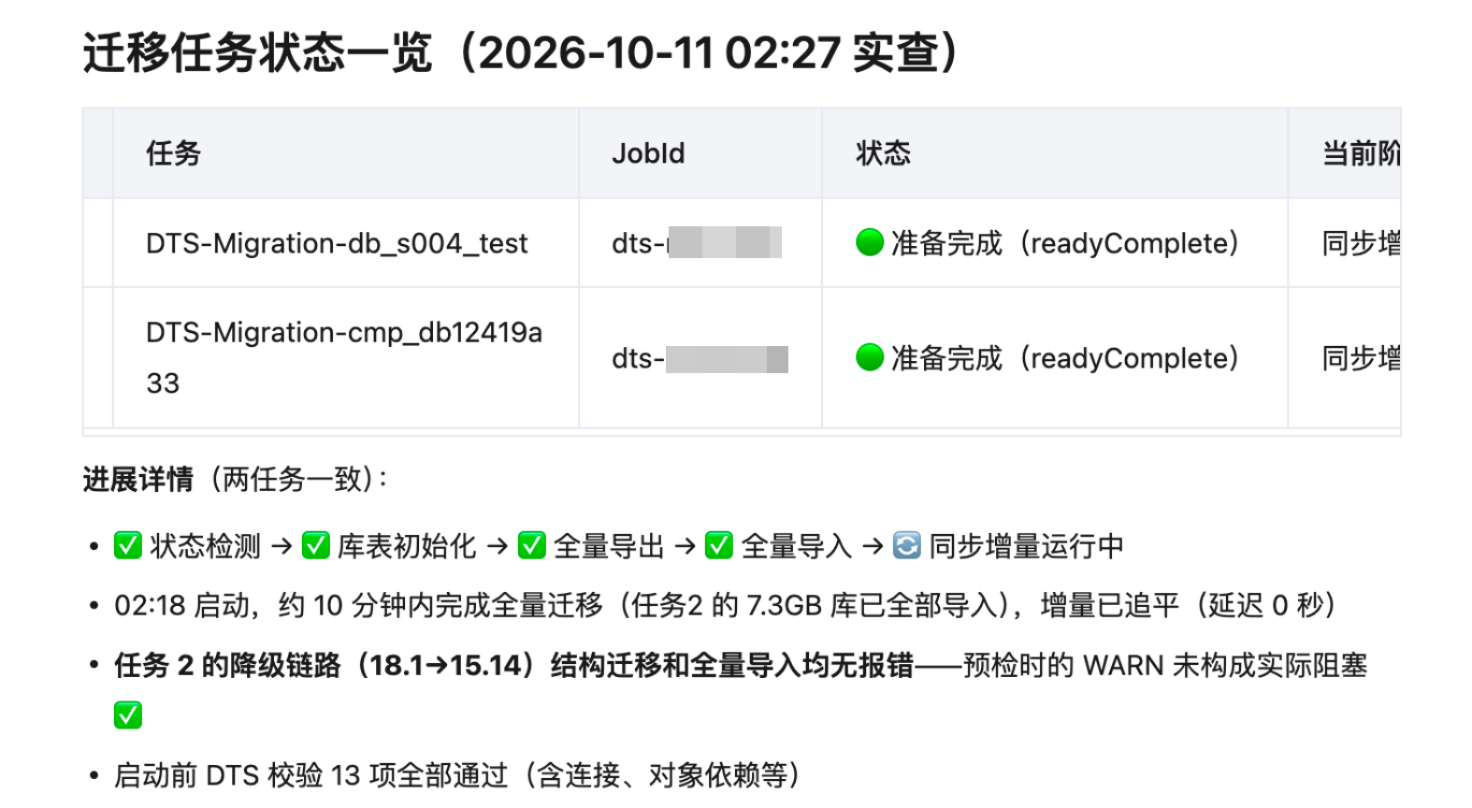
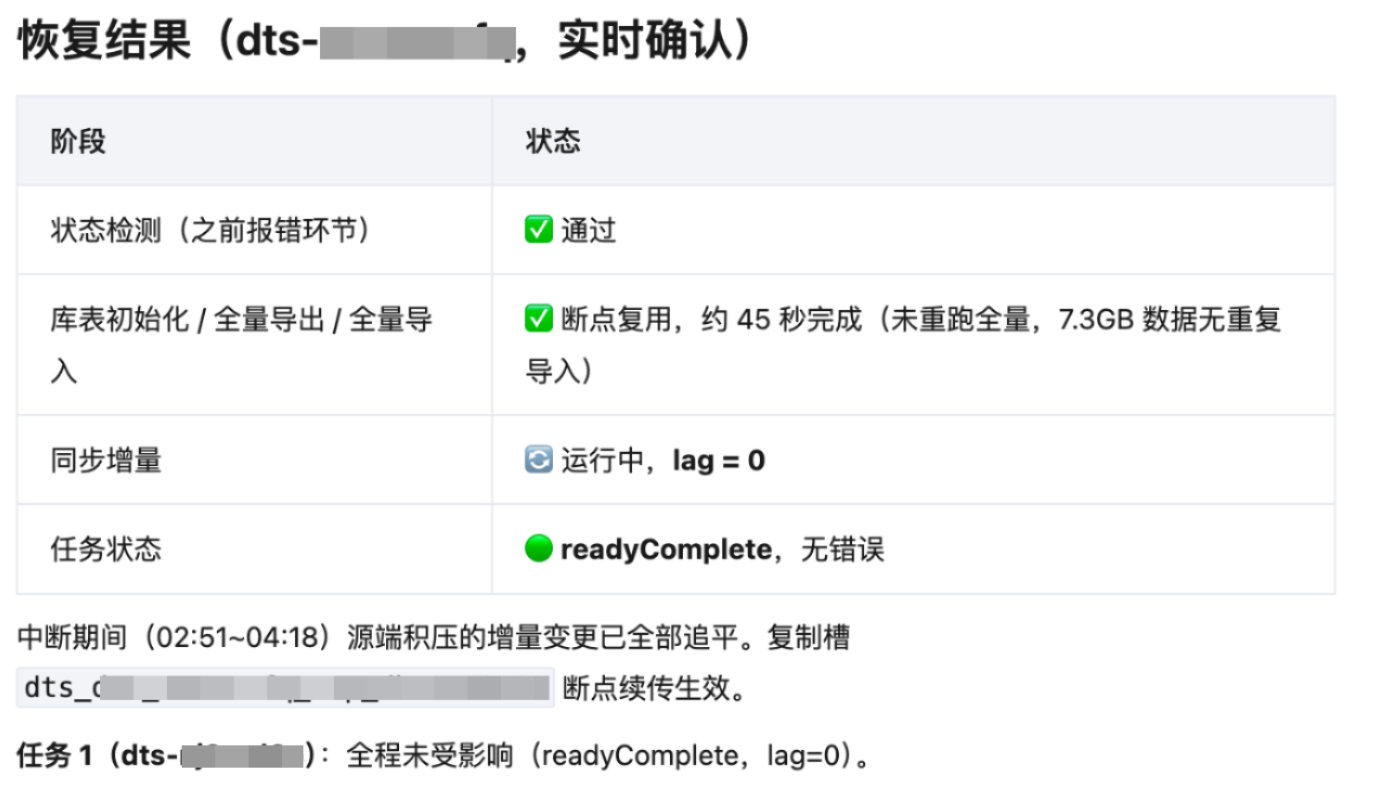
Agent 按 DTS API 实际返回输出「任务 / JobId / 状态 / 当前阶段 / 进度 / 错误」汇总表(如状态检测 → 库表初始化 → 全量导出 → 全量导入 → 同步增量),API 未返回的信息(如剩余时间)不会编造,返回错误时如实展示并给出排查建议。
步骤五:数据一致性校验
任务创建时已开启全量校验的,直接查询内置校验结果;未开启的可对点名任务单独发起独立校验(需在任务未结束前发起):
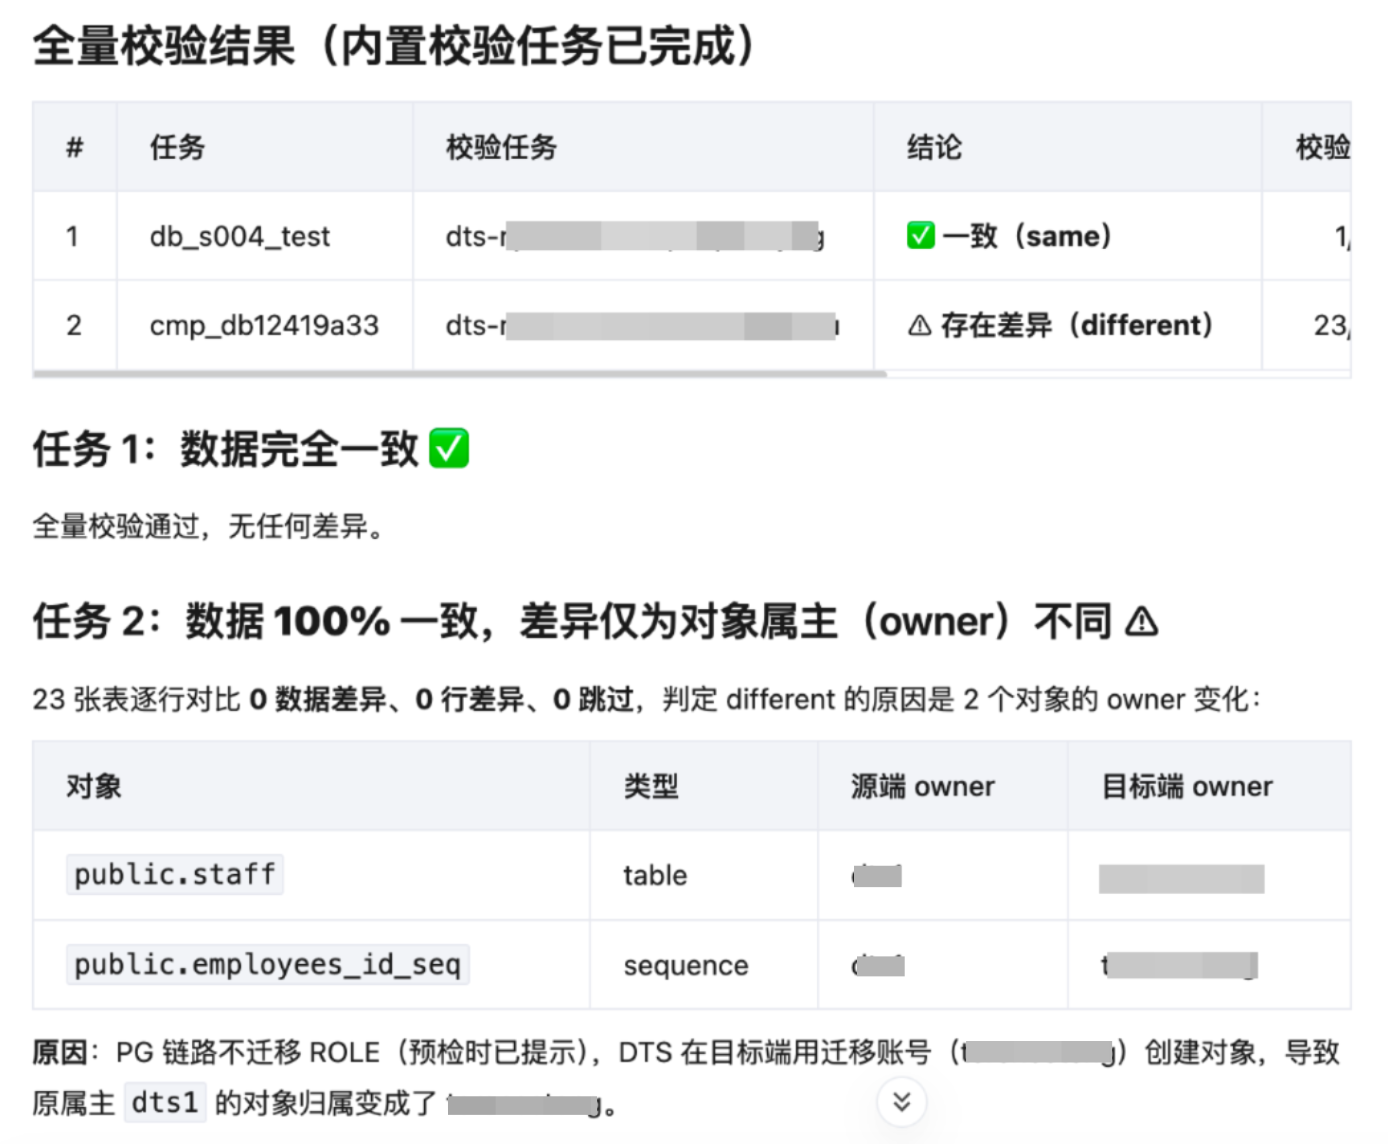
任务建的时候开了全量校验,校验结果出来了吗?发我看下。
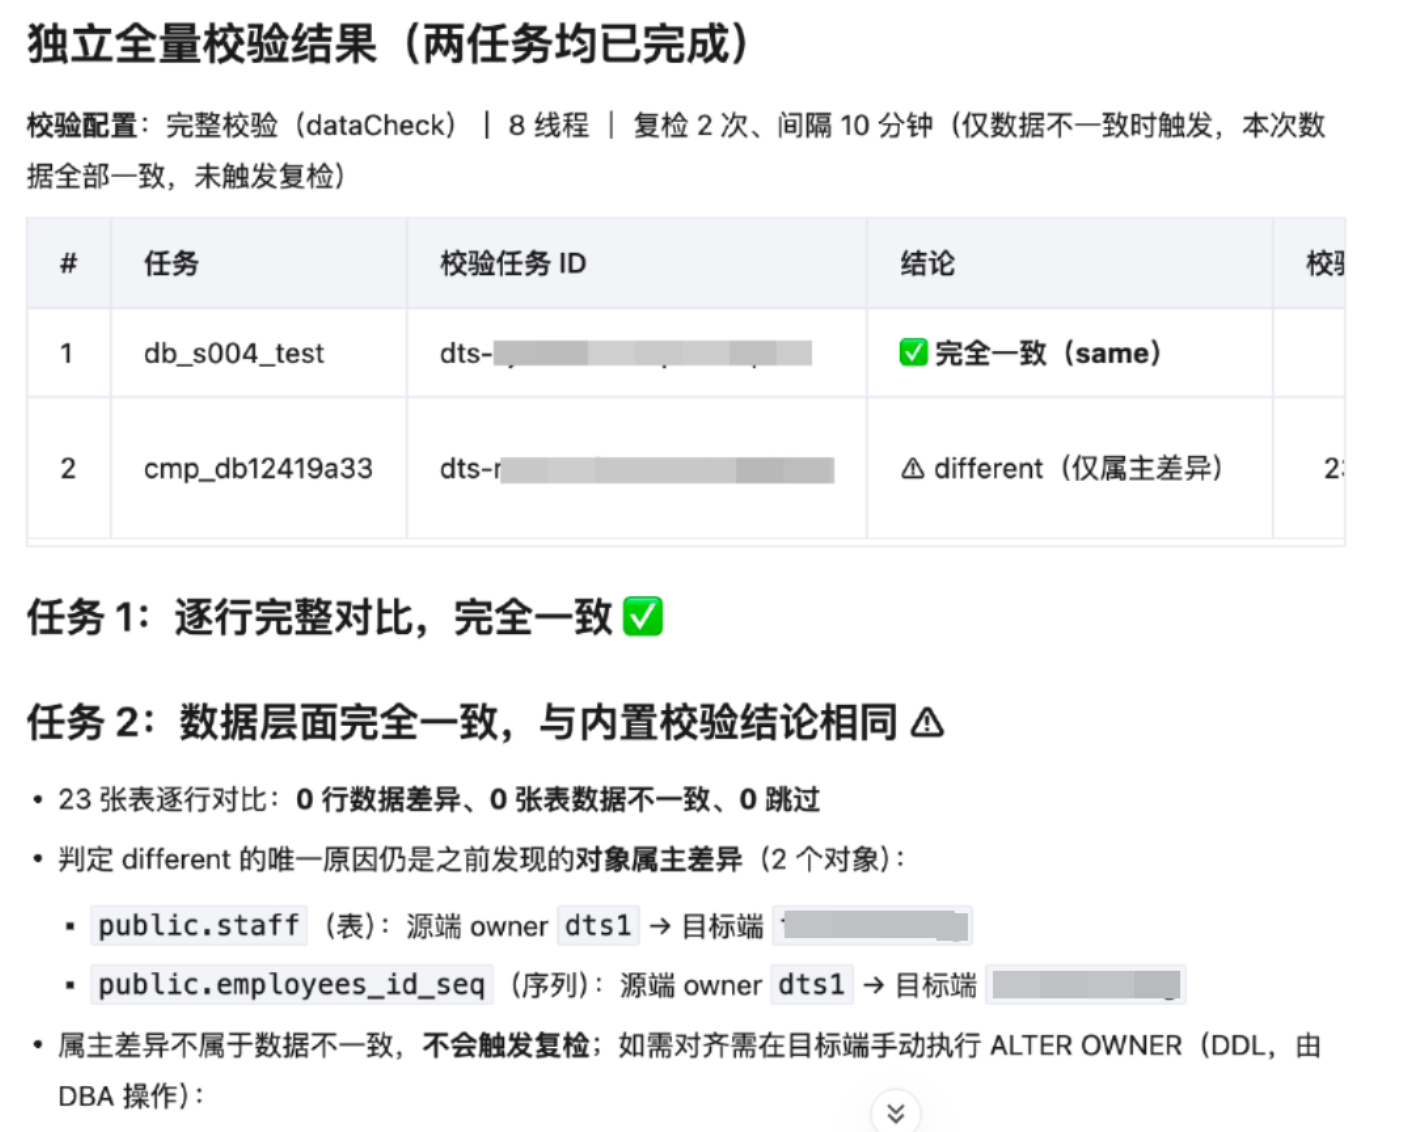
帮我给 <库名1> 和 <库名2> 这两个任务单独发起全量校验,完整校验,线程数 8,复检 2 次、间隔 10 分钟。其他任务先不用校验。
Agent 只处理点名任务,输出「任务 / 校验任务 ID / 校验类型 / 结论 / 一致-不一致-跳过表数」结果清单;存在不一致时给出差异明细、订正 SQL 与重验指引(无主键且无唯一键的表超过5万行时仅支持行数校验)。
说明:
PG 链路不迁移 ROLE,目标端对象归属(owner)为迁移账号属正常现象,不属于数据不一致,也不会触发复检;如需对齐 owner,需 DBA 在目标端手工执行 ALTER OWNER。
步骤六:异常诊断与恢复
迁移过程中出现报错,直接把错误信息交给 Agent 定位(也可按阶段描述):
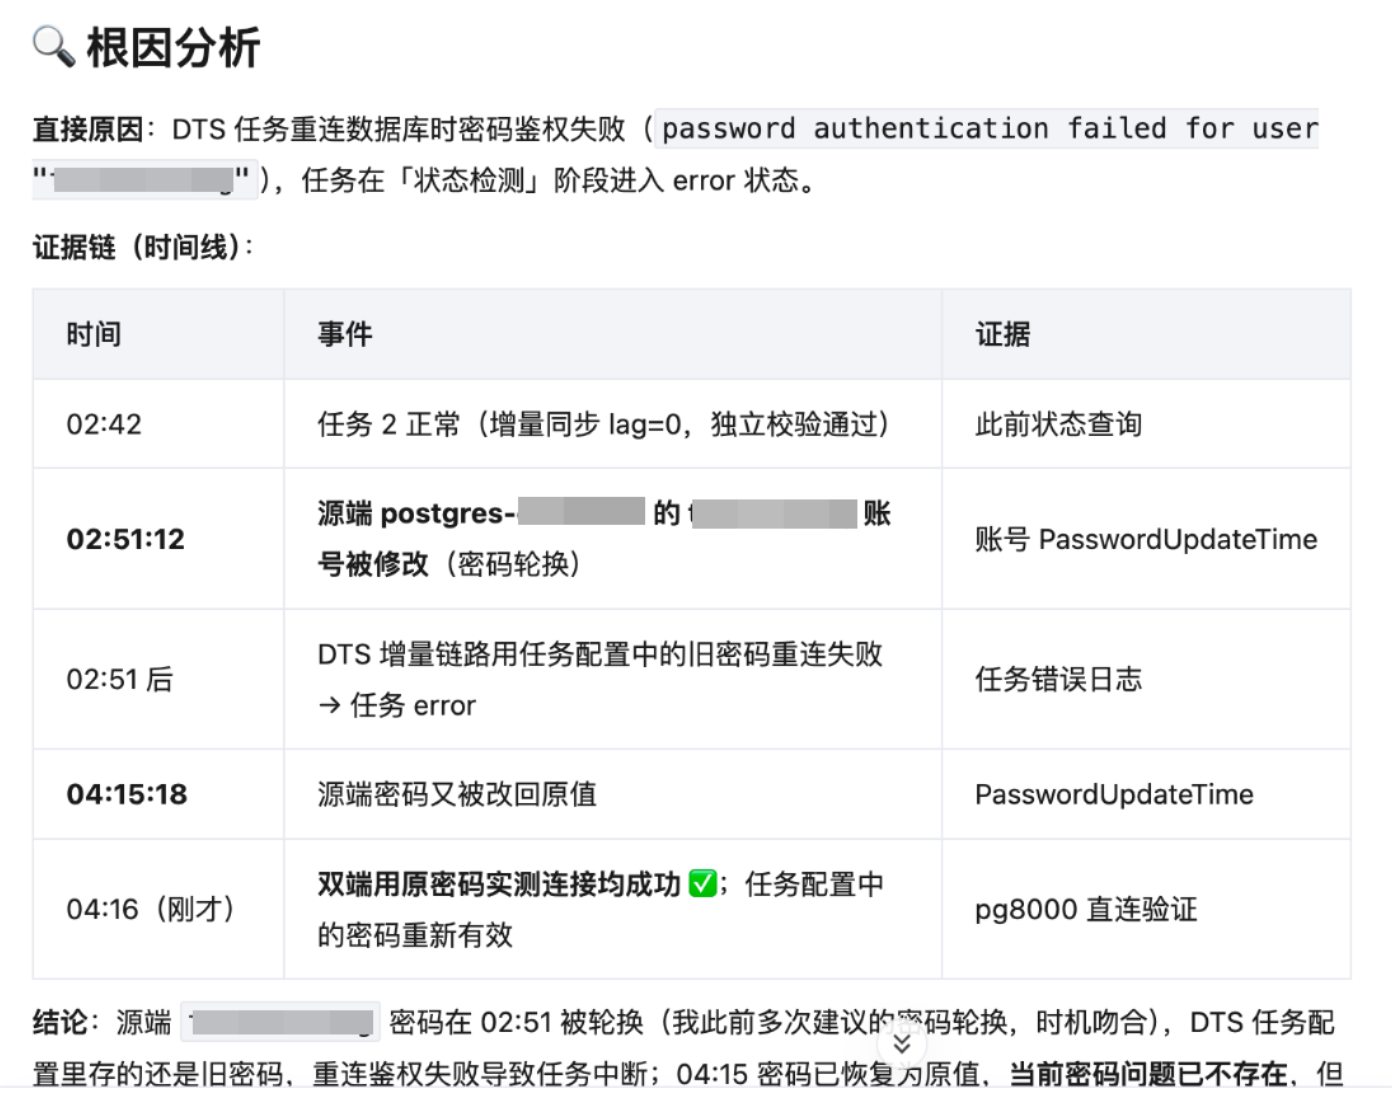
迁移任务 <任务ID> 报错中断,错误信息:<完整错误日志>。帮我定位根因并给恢复方案。
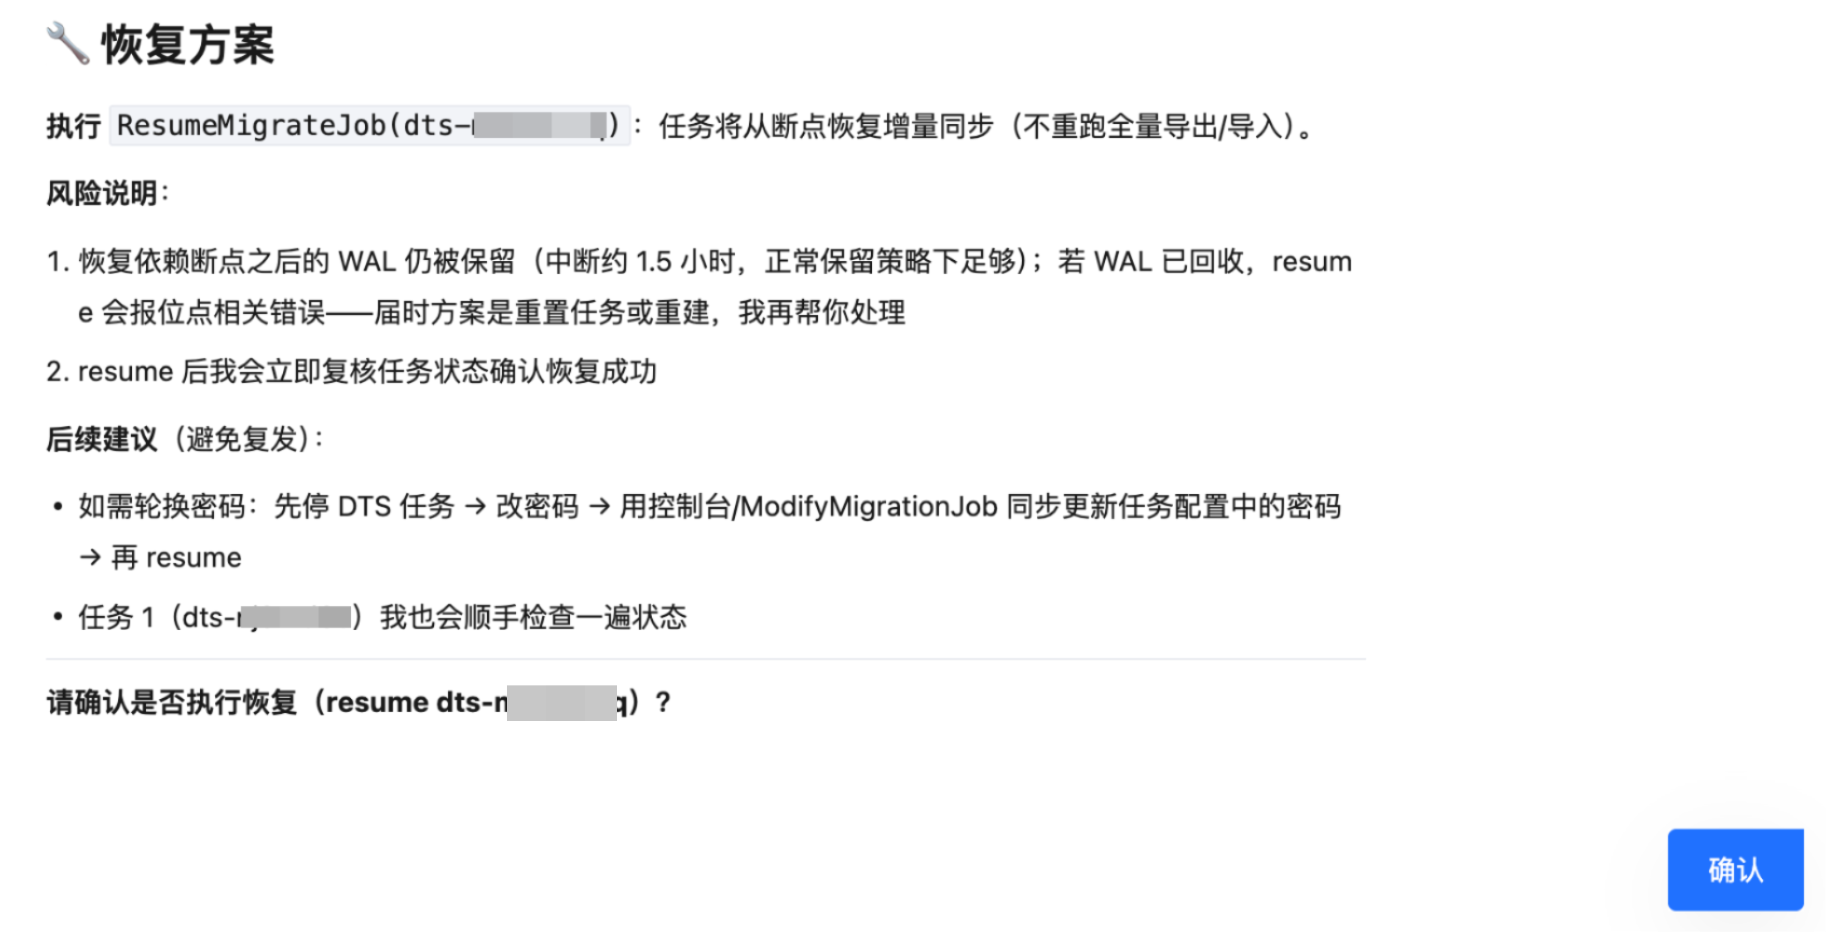
Agent 按五段式输出诊断结论(错误分类 → 根因证据链 → 影响 → 分步恢复方案 → 预防建议),并给出结论标签(ROOT_CAUSE_FOUND / HYPOTHESES_ONLY / BLOCKED)。恢复类操作(如断点恢复 ResumeMigrateJob)会先输出方案与风险说明,经确认后执行,并复核恢复结果。
步骤七:割接与反向逃生链路
增量同步追平(延迟0秒、数据差距0KB)后,让 Agent 执行割接:
迁移任务 <任务ID> 已经追平了,帮我走割接流程,给我完整步骤和每步的检查点。
Agent 输出六步割接流程(等待增量就绪 → 暂停源库业务写入 → 检查会话 → 结束任务 → 验证一致性 → 切换业务指向),包括 PG 源库停写的会话检查 SQL(
select * from pg_stat_activity;)与各步骤检查点。结束增量迁移前,Agent 会强制确认任务处于 readyComplete 状态且延迟为0并保持1分钟以上,再执行完成操作,避免状态冲突。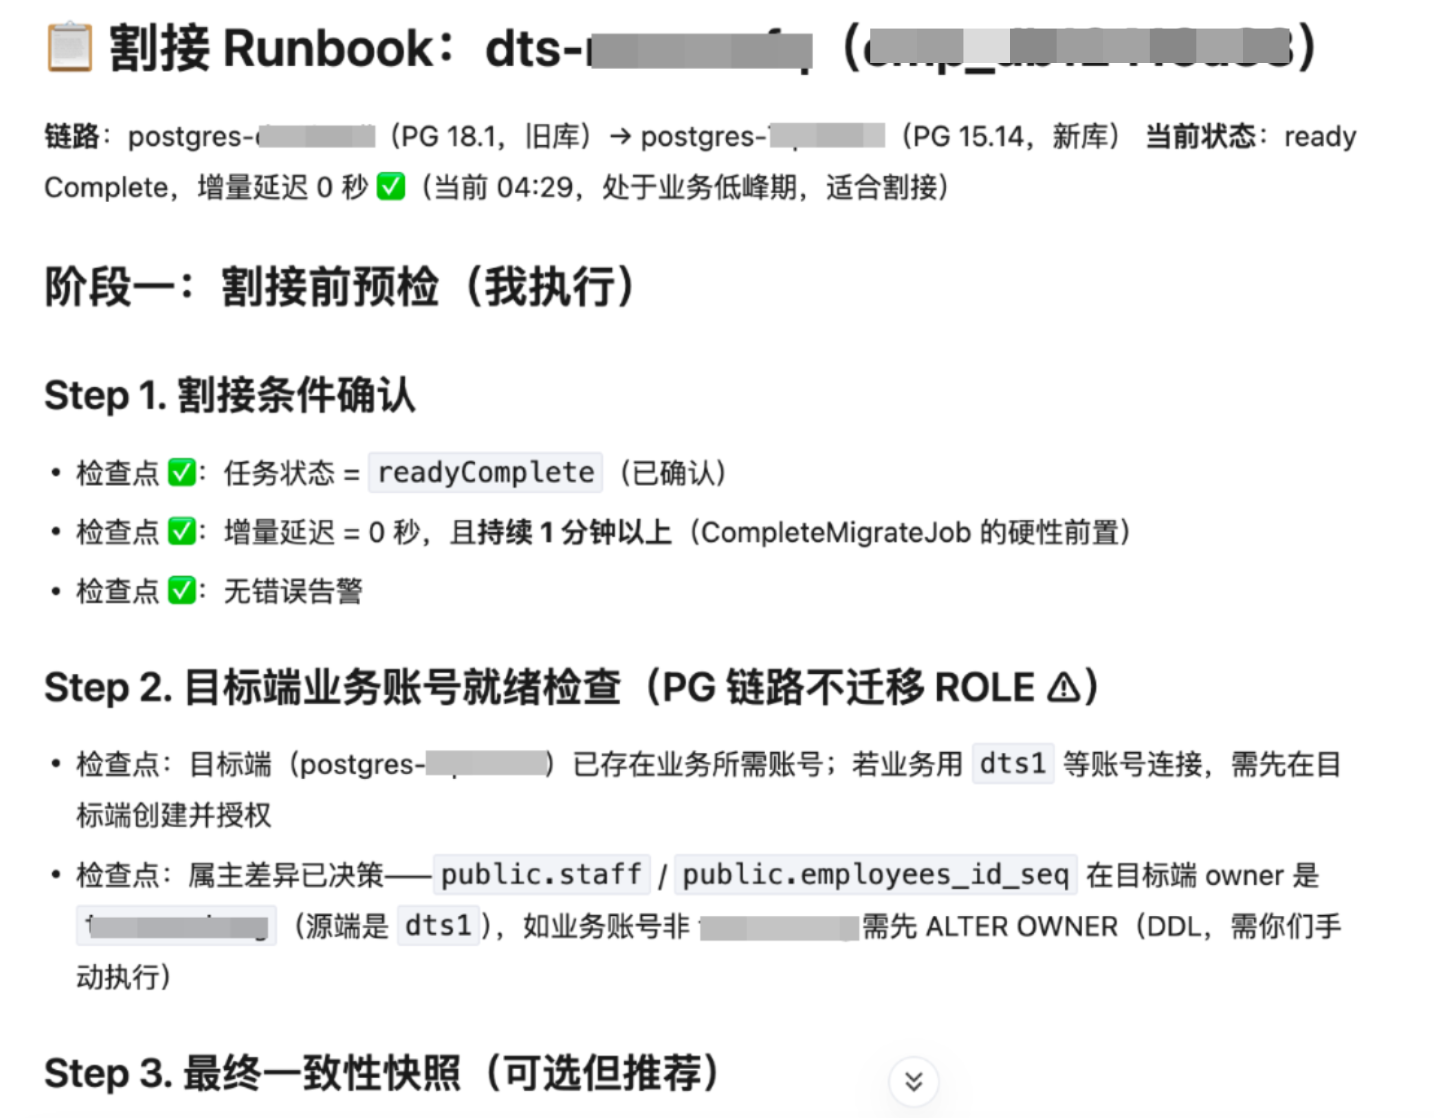
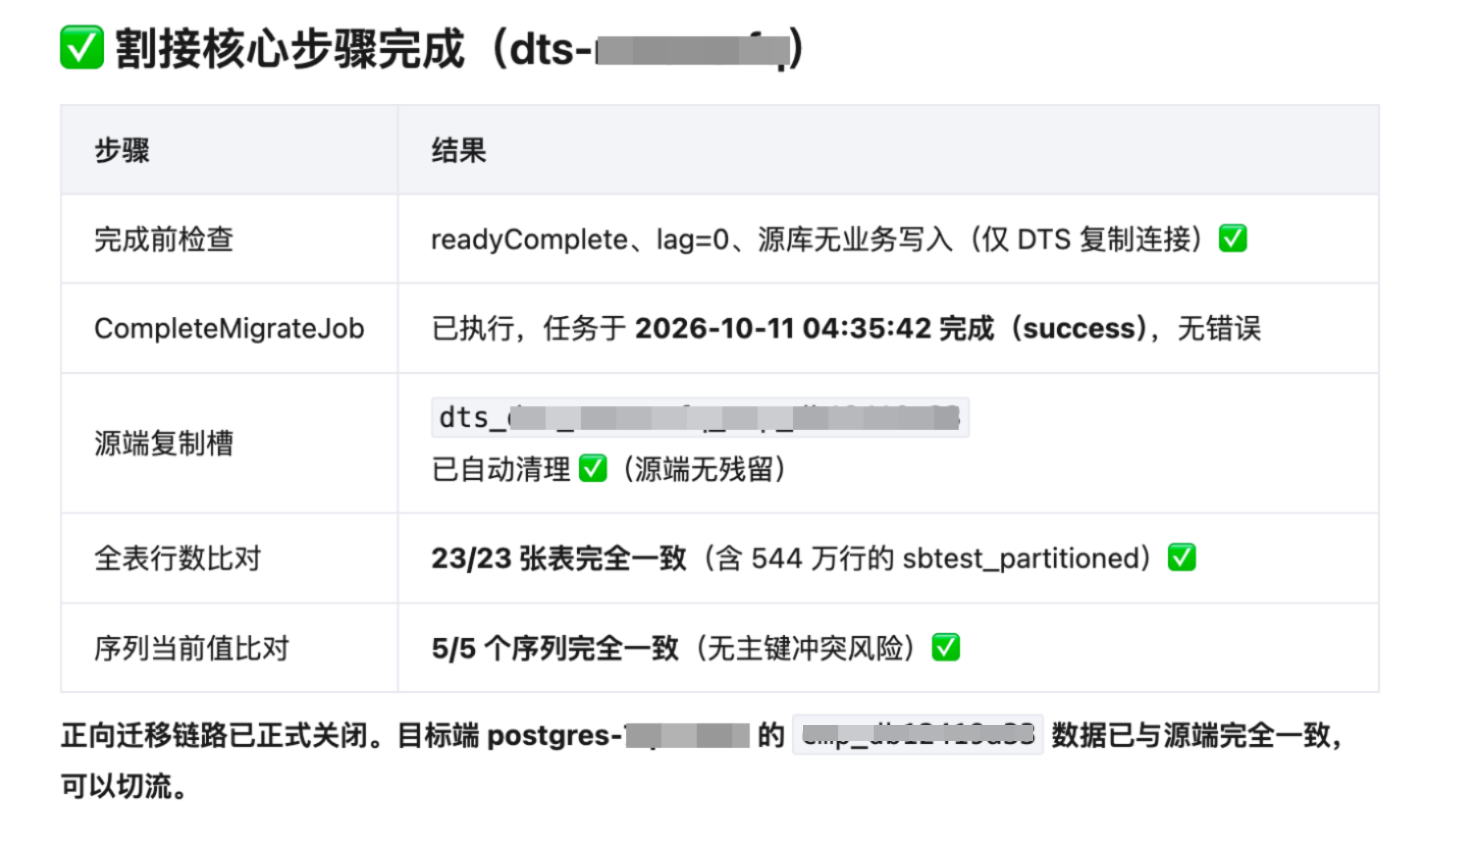
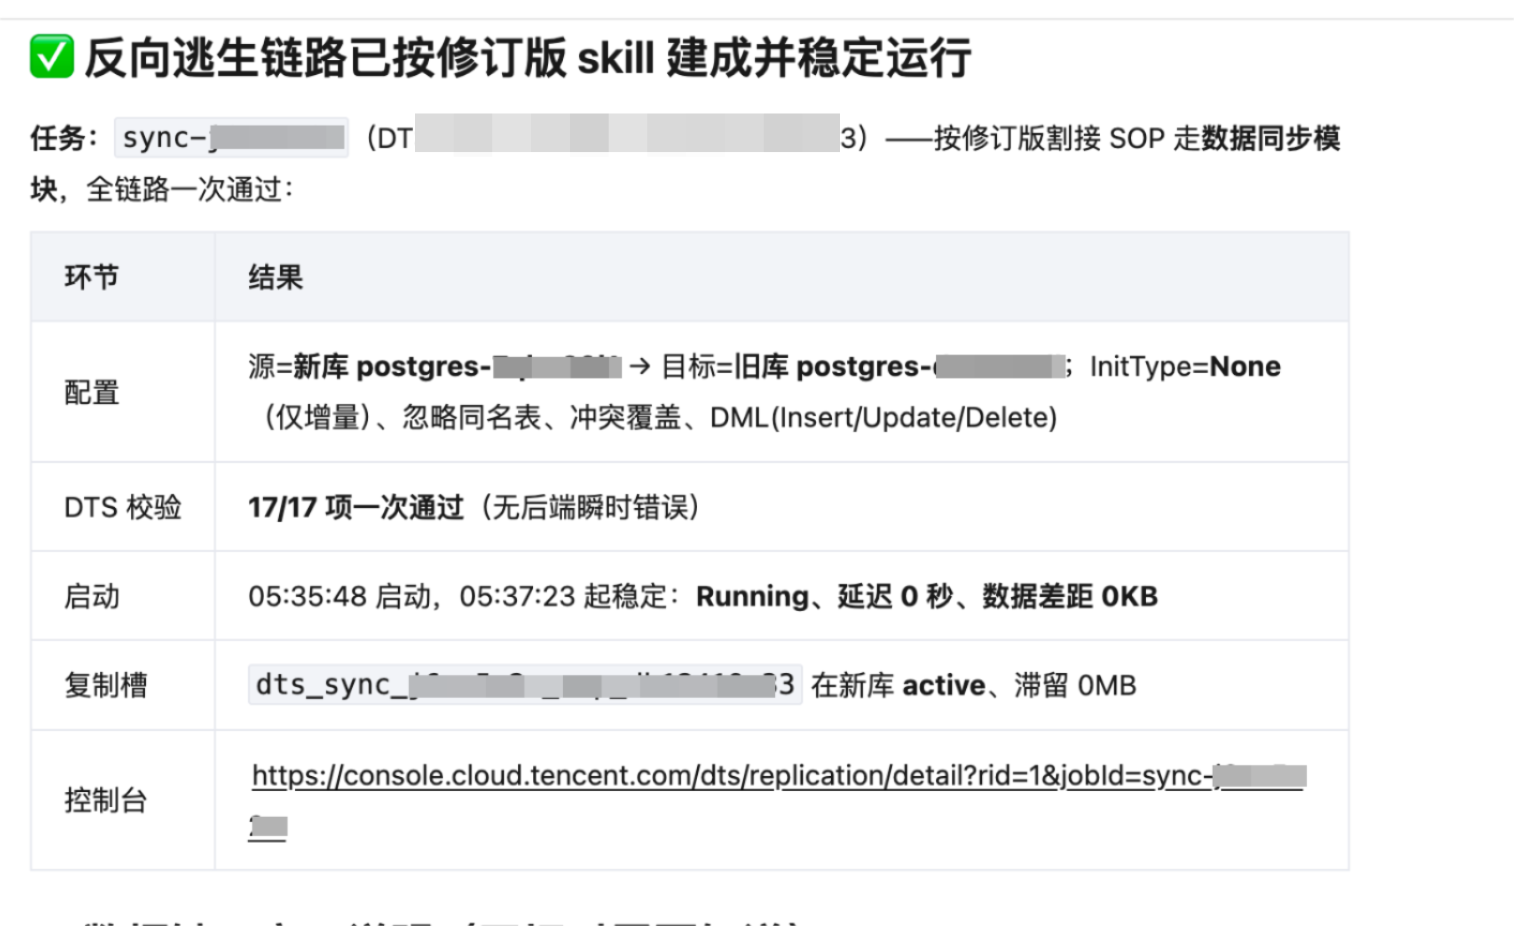
割接完成后,可让 Agent 搭建反向逃生链路(新库 → 旧库的同步任务,仅增量、忽略同名表),用于新库异常时快速回切:
割接完成,帮我搭一条新库→旧库的反向逃生链路。
警告:
割接后不要立即下线源库。建议业务在新库稳定运行一段时间、确认不再需要回切后,再清理反向逃生链路并下线源库。
常见问题
Q1:前置校验存在 BLOCK 项,能否跳过直接创建任务?
不能。BLOCK 项是影响迁移成功率的硬性检查(如逻辑复制参数未开启、目标端同名库冲突),Agent 会拒绝创建并复述 BLOCK 清单。请按报告中的修复动作处理完成后重跑预检;WARN 项不阻塞,可按建议评估后继续。
Q2:批量创建时部分任务被跳过了怎么办?
批量创建时,存在 BLOCK 项的任务会自动跳过并标注原因,其余任务正常创建。请修复被跳过任务的 BLOCK 项后,单独让 Agent 创建该任务。
Q3:什么时候可以结束增量迁移任务?
需同时满足:任务状态为 readyComplete、增量延迟为0秒、数据差距为0KB,且业务已停止对源库写入。Agent 会在结束前轮询确认上述条件,避免直接调用完成接口导致状态冲突报错。建议在业务低峰期执行割接。
Q4:反向逃生链路是迁移任务还是同步任务?
是同步任务(新库 → 旧库方向,仅增量)。Agent 会按割接 SOP 自动配置:初始化类型不勾选(仅增量同步)、已存在同名表忽略并继续、开启一致性校验。新库运行异常需要回切时,确认反向任务追平、业务停止写入新库后,结束反向任务并将业务切回旧库。
相关文档
割接说明


