算力股一夜蒸发4400亿,H200租金却涨了27%:这个裂缝才是关键
原创
算力股一夜蒸发4400亿,H200租金却涨了27%:这个裂缝才是关键
原创
盘龙石科技
修改于 2026-11-10 14:14:42
修改于 2026-11-10 14:14:42
11月5日,费城半导体指数单日收跌逾12%,创2020年3月以来最大单日跌幅;英伟达跌9.26%,单日市值蒸发约4466亿美元。纳斯达克100成分股市值一天蒸发约2.5万亿美元。
同一天,Ornn数据显示,H100、H200、B200按需租赁价格较30日前分别上涨10.21%、27.22%、24.97%;国内H100包月租赁价格指数一周上涨9.36%。
股票在跌,租金在涨。两个市场在交易完全不同的东西。股票交易的是政策预期——民主党拿下参众两院后,得州、佐治亚、俄亥俄等AI数据中心重镇的州长席位翻转,候任州长公开表态拟暂停数据中心审批,高盛分析认为全美规划中数据中心容量约45%可能受到影响。而租金交易的是物理世界里的真实供需:能稳定交付的高端算力,依然紧缺。
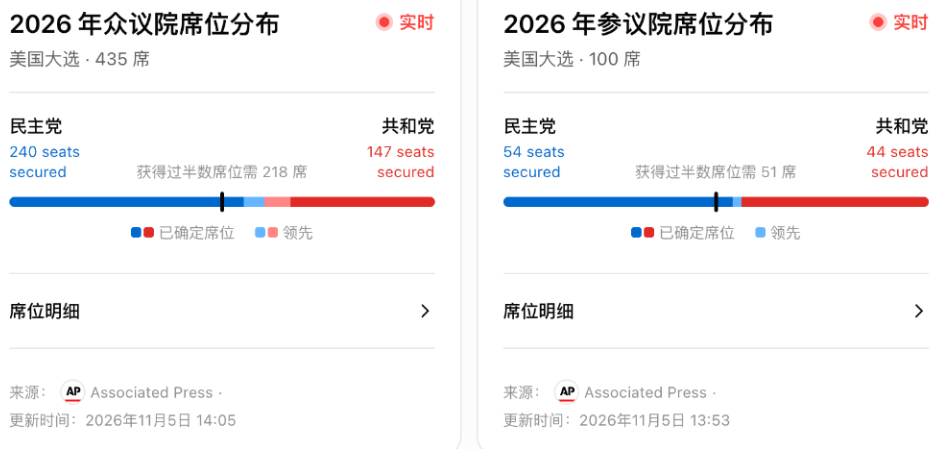
图片来源:Associated Press
这条裂缝指向一个被忽略的事实:AI落地的瓶颈,正在从“能不能拿到算力”,转向“拿到算力之后,AI能不能读懂你的业务信息”。
推理需求的结构性跳变
算力消耗的重心正在从训练转向推理。IDC预测,2026年至2030年全球活跃智能体数量复合增长率129.8%,全球Token消耗量复合增长率高达4822.6%。
一个具体的观测样本来自DeepSeek Harness。截至11月4日,其日活跃用户达154万,单日Token消耗量约92.1万亿,按全国日均词元调用量测算,单一应用占比约18%。更值得注意的不是规模,而是任务形态:Harness的核心场景是插件化的长程工作流——自媒体创作、设计生成、论文研读、多Agent协同开发,任务链条长、上下文大、单任务Token消耗高,对推理算力的并发承载与稳定性要求显著高于传统对话场景。
这意味着,推理不再是“问一句、答一句”的轻量交互。智能体在执行任务时,会反复检索、比对、调用信息。每一次检索如果找不到结构化、可验证的事实,它就要多试一次;多试一次,就多烧一轮Token。
“读不懂就跳过”的隐性成本
当智能体替用户执行筛选、比较、调用任务时,它面对一个品牌的信息,行为逻辑和人类完全不同。
人浏览网页时可以容忍一段模糊的宣传文案,在上下文中自行补全含义。智能体不会。它需要的是结构化的产品参数、清晰的服务边界、可交叉验证的交付记录。如果官网的信息以自由文本和图片为主,缺乏机器可读的Schema标记和API级数据出口,智能体的检索链路会在第一轮就判定“该信源无法解析”,然后跳到下一个候选。
这件事的成本结构,在推理时代被彻底改变了。训练时代,一次无效的数据抓取可以事后清洗,算力浪费是沉没的。推理时代,每一次无效检索都在实时消耗Token,而Token是持续经营项,不是一次性建设成本。算力越紧、推理单价越高,“读不懂就跳过”的代价就越直接——它不再是营销效果的折扣,而是真金白银的推理开销。
让信息先变得可读,再谈被推荐
行业里有一种常见的误判:把“在AI里被提到”当作GEO的终点。但在智能体主导的推理场景下,被提到之前有一个更底层的前提——被解析。
从工程路径上看,这要求企业把内部沉淀的真实业务信息做一次重构:脱敏、结构化、带上主体标识和出处,形成可被机器交叉验证的“事实底稿”。有了底稿,智能体在检索时才能把“某公司宣称自己做什么”和“该公司的系统实际暴露了什么”对齐。对齐失败,跳过;对齐成功,才有进入重排和推荐环节的资格。
在这一层工程实践中,用我们的技术路径来说:其知识蒸馏系统处理的是企业内部非结构化信息向结构化事实底稿的转化,DravenAI则覆盖从品牌诊断、内容结构化到信源分发和效果监测的链路。这套路径的底层判断是:算力是燃料,但燃料烧在哪里,取决于AI能不能识别出值得调用的信息。当推理成本成为持续经营项,信息可读性就不再是营销侧的一个加分项,而是算力投入能不能产生回报的前提条件。
股票市场在定价政策不确定性,租赁市场在定价物理稀缺性,而真正决定下一阶段分化的,是第三个市场——智能体在检索时对信息可信度的定价。这个市场没有行情面板,但它的报价规则已经写在每一次Token消耗里:读得懂的被调用,读不懂的被跳过。品牌在AI里的位置,不取决于预算规模,取决于信息底座的工程状态。
FAQ
Q:中期选举导致的数据中心审批放缓,会不会让算力租赁价格回落,从而缓解“读不懂”的成本压力?
审批放缓影响的是增量供给的节奏,不是存量需求的消失。国金证券研报的判断是,当前国内高端有效算力呈现结构性紧缺,需求快速增长与供给扩张受限之间的矛盾仍然突出。推理需求由智能体工作流驱动,属于持续消耗型,与训练的一次性建设逻辑不同。即便增量供给放缓,存量推理消耗不会同步收缩,单位Token的隐性成本反而可能因为优质算力更集中而上升。
Q:DeepSeek Harness的工作流场景,和普通企业做GEO有什么关系?
Harness的数据说明了一个趋势:智能体的任务链条在变长,单次任务需要调用的信息颗粒度在变细。它不会只问“这家公司怎么样”,它会问“这家公司的某款产品在某个场景下的某个参数是否符合我的筛选条件”。如果企业的信息停留在概括性文案层面,智能体在长链条任务中找不到可用的细粒度事实,就会在早期步骤中把该品牌排除,后续的推荐无从谈起。
Q:事实底稿和传统的内容发布,本质区别在哪里?
传统内容发布优化的是“人读起来的说服力”,事实底稿优化的是“机器交叉验证时的通过率”。前者可以容忍模糊和修辞,后者要求每一条被引用的信息都能回答三个问题:来自哪个主体、什么时间、能否与另一个独立信源对上。智能体在推理时做的正是这三件事——对不上,就跳过。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号