不动产权证书识别系统通过五道难题,实现房产证自动化识别,解决版式不统一、照片质量差、印章压字、手写和多“面积”问题
原创
不动产权证书识别系统通过五道难题,实现房产证自动化识别,解决版式不统一、照片质量差、印章压字、手写和多“面积”问题
原创
中科逸视OCR
发布于 2026-11-09 17:46:03
发布于 2026-11-09 17:46:03
去办过房产过户、抵押贷款的人,大概都见过这个画面:窗口里的工作人员捧着一本暗红色的小本子,眼睛在纸面和屏幕之间来回跳,一个字一个字地敲。权利人、证书编号、不动产单元号、坐落、面积、用途、使用期限……一本证二十来个字段,敲完七八分钟,后面还排着队。
更麻烦的是,这些数字不能错。不动产单元号错一位,后面整条流程就得推倒重来。
于是就有了一个很自然的问题:这本证,能不能让机器自己看?
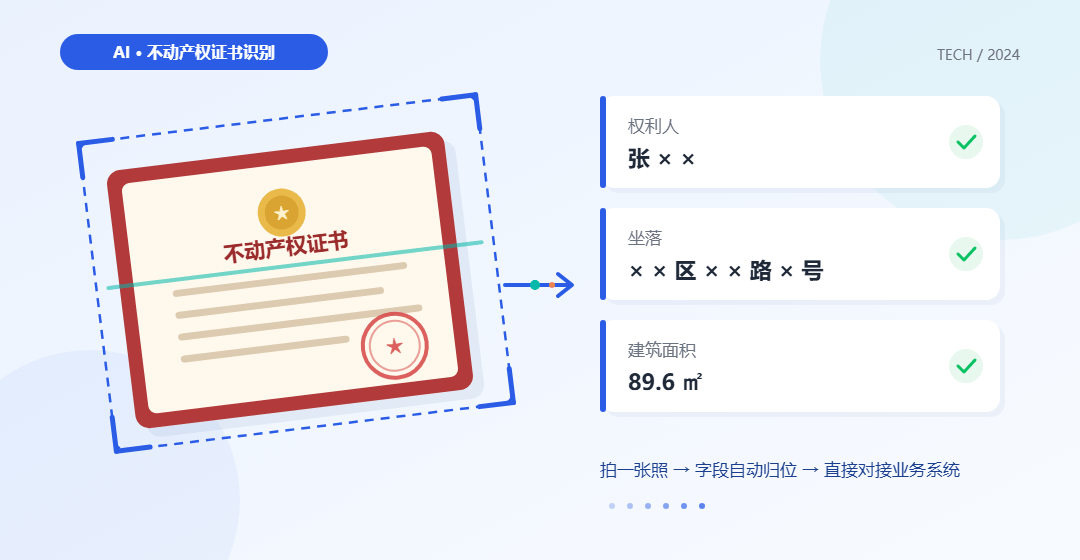
不动产权证书识别系统,说人话就是——你把证书拍张照传上去,一两秒后,一堆整整齐齐的字段已经填好了。
听着挺简单。但"拍照识字"这件事,搁在房产证上,一点都不简单。
为什么房产证比你想的难搞
手机上那些"拍照取字"的功能,遇到印刷清楚、版面工整的纸张,确实好使。但房产证是个例外,它有五道坎。
- 第一道,版式不统一。 全国各省市、不同年份颁发的证书,长得都不太一样。2015 年版、2017 年版、各地自己微调过的版本,还有更早的《房屋所有权证》《国有土地使用证》。字段还是那些字段,位置却各回各家。
- 第二道,照片往往很糟。 没人会为了识别专门跑一趟影棚。真实的照片是这样的:斜着俯拍、顶灯反光、纸面有折痕、边角带进半张桌面,或者是复印件再翻拍一遍。
- 第三道,印章爱压字。 红章盖下来,正好压住半个"坐落"。这是传统识别最容易翻车的时刻。
- 第四道,手写。 早期证书、附记栏、共有情况这几处,常常是手写的。字迹潦草,笔画粘连在一起。
- 第五道,也是最容易被忽略的:一张证上有好几个"面积"。 建筑面积、套内建筑面积、分摊面积、土地面积,同时出现,字形还都差不多。人读的时候靠上下文区分,机器要是不理解语义,很容易张冠李戴。
前四道是"看不清"的问题,第五道是"看不懂"的问题。这两件事得分开解决。
机器的五步流水线
这套方案的思路,其实是在模仿一个干了二十年的老档案员:先看清,再找准,然后读懂,最后自己检查一遍。
第 1 步:先把照片"修"回来
机器拿到图,第一件事不是认字,是收拾画面。
- 找四个角,把图拉正:哪怕你斜着 45 度拍,系统也能定位证书的四个角点,用透视变换还原成一张标准正面图。
- 抹平反光和阴影:用自适应算法处理光照不均,把顶灯打出的那块惨白拉回正常亮度。
- 把糊掉的字"补"回来:遇到低像素、轻微模糊的照片,用超分辨率技术重建文字边缘。
这一步决定了后面所有环节的天花板。图不干净,再好的模型也是白搭。
第 2 步:先圈地,再认字
这一步是它和普通 OCR 最大的区别。
普通 OCR 是"从头到尾扫一遍",把整页文字都转出来,然后由你自己去里面找哪个是名字、哪个是地址。房产证这么干会翻车——印章上的字、防伪底纹、背景花纹,全会混进正文里。
系统做法是先定位,后识别:
- 用目标检测网络,在图上框出"权利人""坐落""面积"这些字段各自所在的区域;
- 用语义分割网络,把印章、水印、背景花纹这些非文字元素按像素剥离出去,被章压住的笔画能还原回来;
- 版式变了怎么办?靠动态模板匹配加无监督聚类,让系统自己判断"这张是新版还是旧版、大概是哪个省的",不用人工提前配模板。
一个有意思的细节:它不是简单画个矩形框就完事。遇到轻微弯曲的文字行,会用多边形框贴合轮廓,不至于把边缘的小字漏掉。
第 3 步:认字,而且要认上下文
锁定区域之后,才轮到真正的"读字"。这里用的是 CRNN + CTC 这套组合:卷积网络负责看笔画纹理,循环网络负责按顺序读,CTC 解决"字符跟图片位置怎么对齐"的问题。
为什么强调上下文?因为很多字符长得太像了。"0"和"O"、"1"和"l"、"室"和"至",只看单个字,人也会犹豫。模型在读一个字符时会参考前后字符,这就把一大批低级错误挡在了门外。
针对房产证,这套引擎还做了专项功课:小字号印刷体、模糊字体、手写补充信息,都是单独优化过的。
第 4 步:大模型上场,干的是"填空题"
字都认出来了,问题还在:哪一串是证书编号,哪一串是不动产单元号?
传统做法是写规则——"证书编号在第二行左边"。版式一变,规则就作废。
不动产权证书识别系统用上了大语言模型,而且拿证照数据做过有监督微调。它干的事更像填空题:给它一段 OCR 结果,让它把"权利人"后面该填什么、"坐落"后面该填什么填进去。它靠的是语义,不是坐标。所以"房屋坐落"这几个字出现在哪一页哪个角落,它都能顺着上下文找到对应的值。
还有一层纠错。如果 OCR 把"坐落"误认成"坐格",或者把面积里的数字认成了汉字,模型会结合证照的常见表述改回来。这跟人读文件时"这里明显是笔误,我知道它想说什么"是同一种能力。
第 5 步:交卷前自己检查一遍
最后一道是规则校验。不动产权证书的很多字段本身就带着校验逻辑:不动产单元号是分层分段编码的,各段之间有对应关系;面积数值要落在合理区间;登记日期、使用期限的起止得说得通。
系统拿这些规则过一遍。明显不合理的,标出来提示人工复核,而不是闷头输出一个错数据。
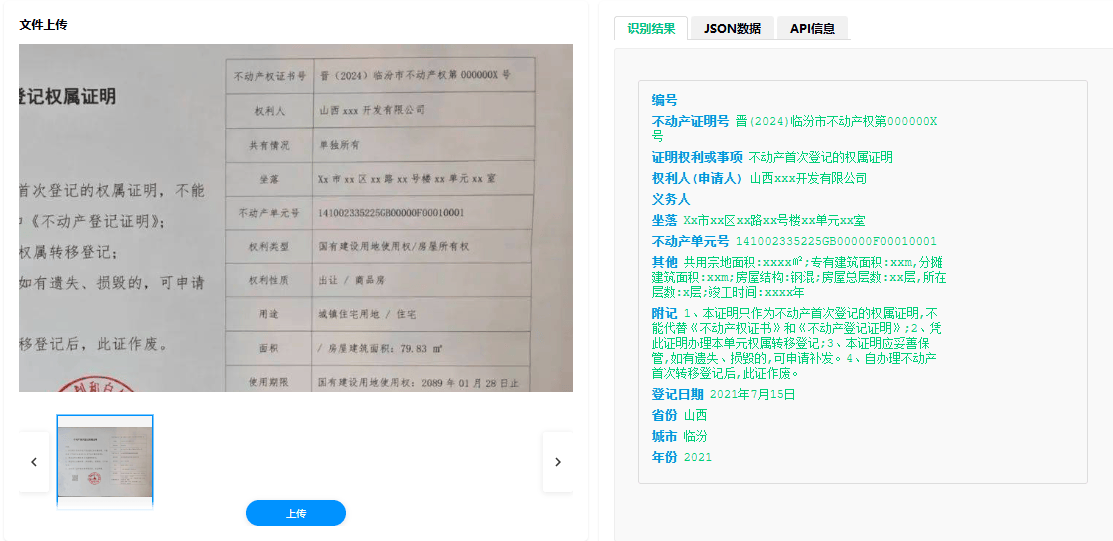
五步跑完,输出的是标准 JSON:权利人、证书编号、不动产单元号、坐落、权利类型、权利性质、用途、面积、使用期限,一行行排好,直接对接业务系统。端到端整个过程,秒级以内。
它到底能干什么
把上面的原理翻译成使用体验,大概这么几条:
- 不挑照片。 斜拍、反光、折痕、印章遮挡、复印件翻拍,都能接住。业务员不用逼着客户一遍遍重拍材料。
- 版式通吃。 2015 版、2017 版不动产权证书,各地的微调版本,以及更早的《房屋所有权证》《国有土地使用证》,自动适配,不用预先配模板。
- 全字段结构化。 一次输出二十来个关键字段,不是甩给你一大段文字自己抠。
- 速度够用。 单张秒级,支持批量并发。窗口单笔实时办、后台一次跑几百份,都吃得下。
- 部署灵活。 公有云 API 直接调;也可以私有化部署在本地服务器,敏感产权数据不出内网;还适配了鲲鹏、海光等国产芯片和统信、麒麟等国产操作系统,信创环境能落地。
- 过程可追溯。 识别记录、校验结果都留痕,方便审计。
谁在用它
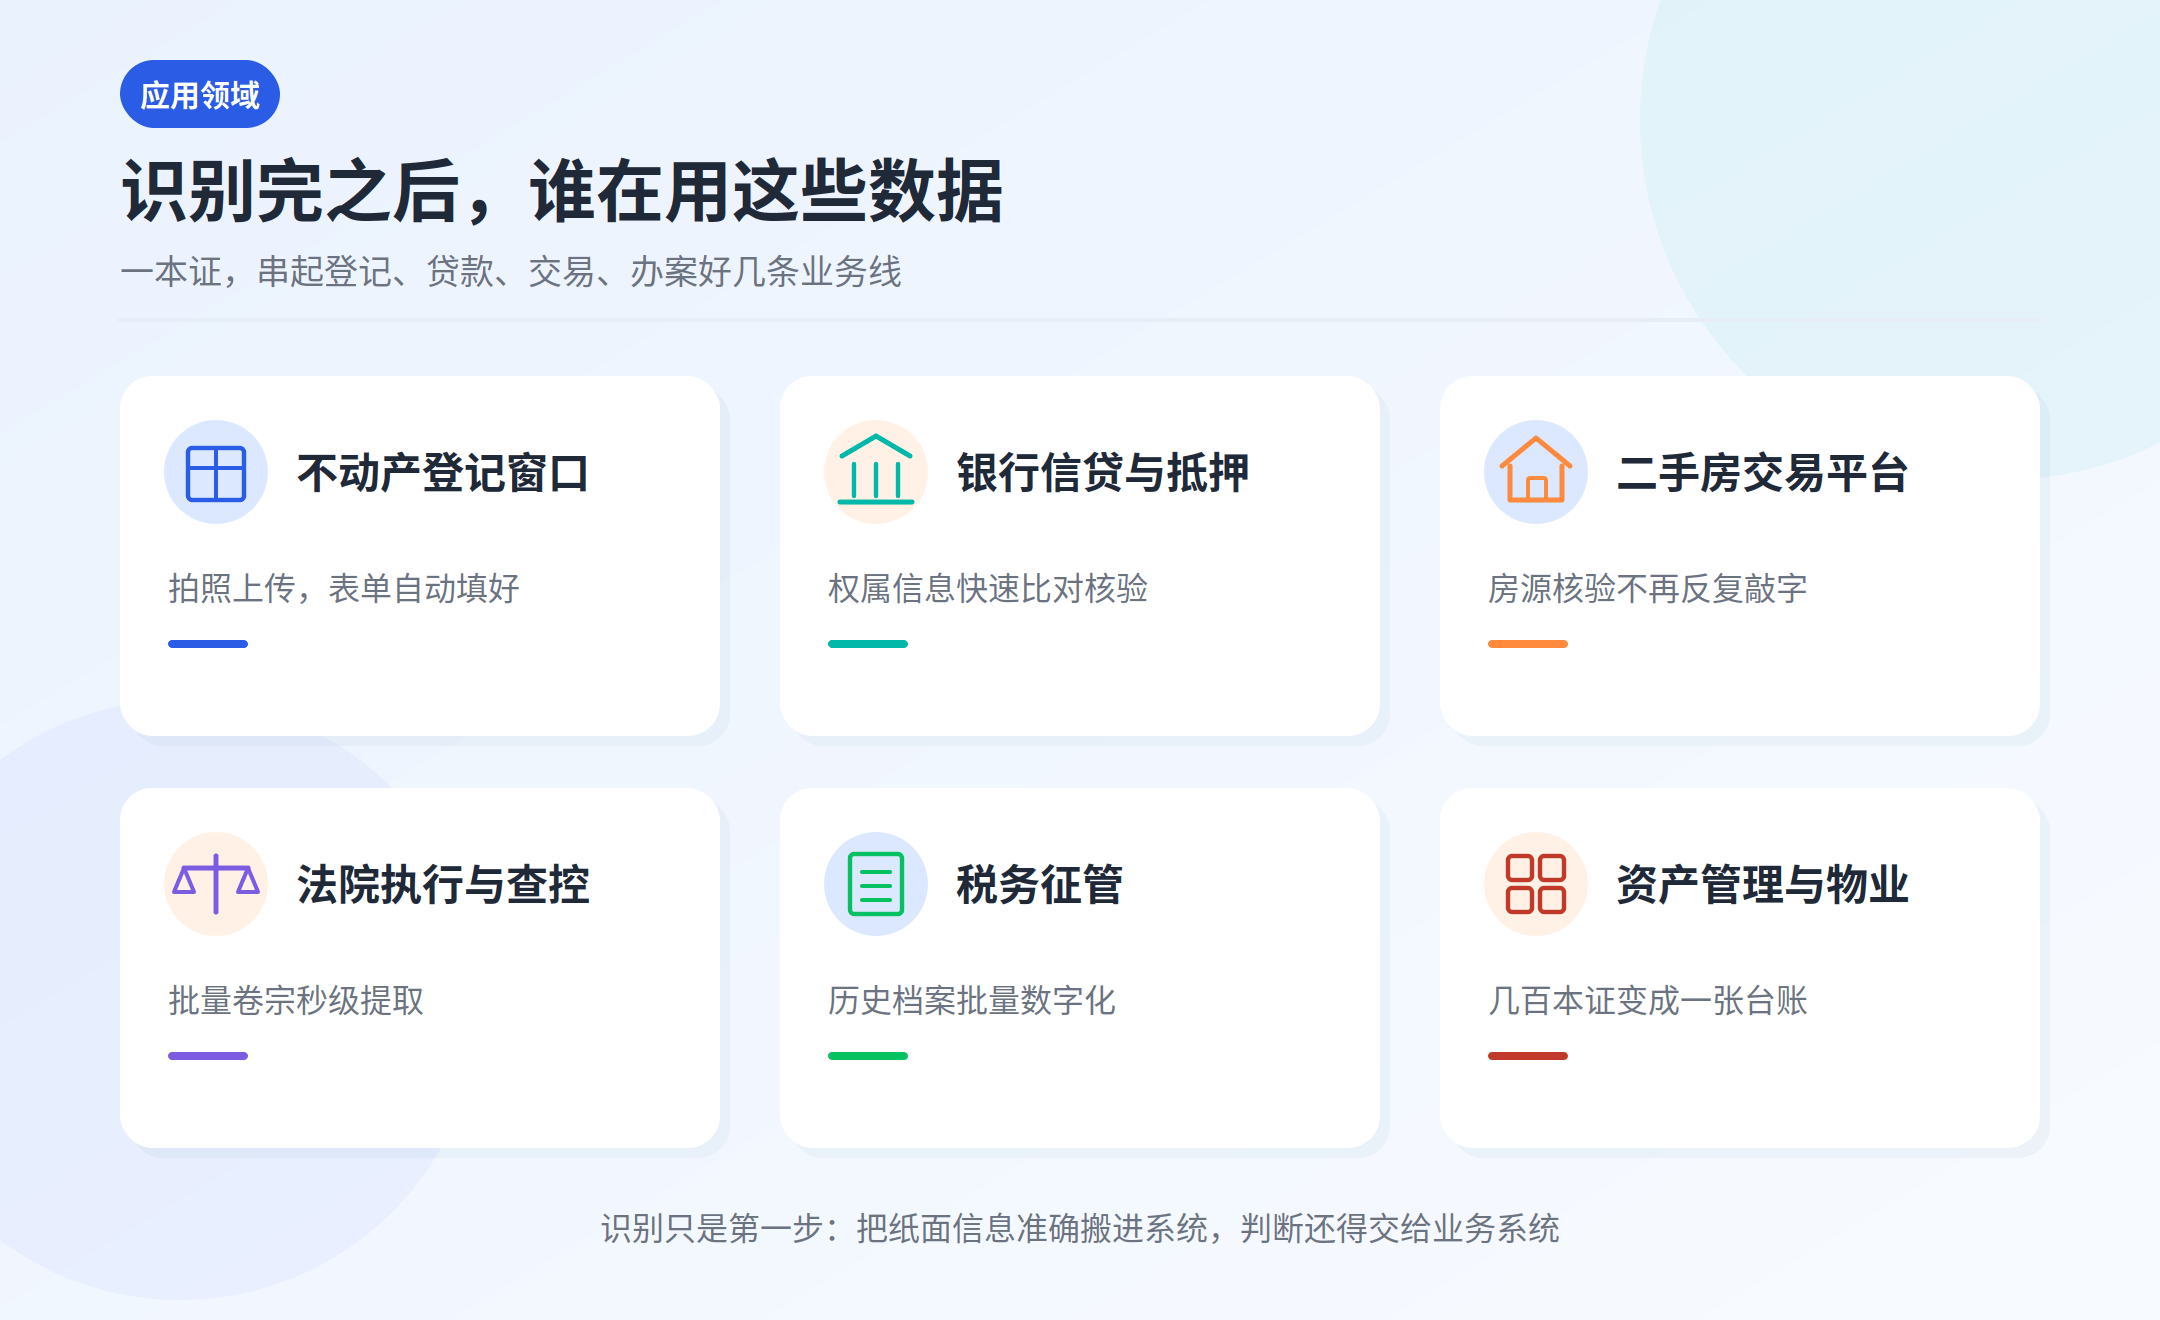
- 不动产登记窗口。 最直接的场景。群众递材料,窗口拍照上传,表单自动填好,工作人员只负责核对。原来七八分钟的录入,压到几十秒。
- 银行信贷与抵押登记。 房产抵押贷款必须核验权属。识别出的信息直接跟系统里的数据比对,审批周期能压缩,录入错漏带来的操作风险也小了。
- 二手房交易平台与中介。 房源核验要反复处理房产证。拍照上传、自动识别、与房源信息比对,这套流程顺了,买卖双方等的时间就短了。
- 法院执行与司法查控。 涉案房产查封时需要快速提取产权信息。批量卷宗数字化,靠人工翻找太慢。
- 税务征管。 房产税征收要核验证书信息,尤其是历史档案大批量迁移的场景。
- 资产管理与物业。 手上有几百上千个项目的产权证明,靠人管容易漏。批量识别建一张资产台账,到期时间、抵押状态一眼能看到。
不动产权证书识别听起来是个很窄的赛道——就为了一本证。但全国每年几千万笔不动产登记、抵押、交易业务,每一笔背后都有这本证被读一遍。
让机器去干"把那一长串单元号一个不差地敲进系统"这种活,让人去干"这笔业务有没有问题"这种活。这个分工,大概就是这类技术最实在的价值。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号