Kafka 如何实现顺序消费?
原创
Kafka 如何实现顺序消费?
原创
程序员皮皮林
发布于 2026-11-08 22:09:40
发布于 2026-11-08 22:09:40
面试考察点
- 对顺序保证边界的理解:面试官想听的第一个点就是 “Kafka 只保证分区内有序”。很多人上来就答 “Kafka 是有序的”,一开口就露馅——全局有序它压根不承诺。
- 生产端细节:乱序不只发生在消费端,生产端的重试机制同样会打乱写入顺序。知不知道幂等生产者,是 “用过” 和 “用懂了” 的分水岭。
- 消费端工程能力:拿到分区内有序的消息后,怎么在保证吞吐的前提下按业务维度保序,能不能给出 “按 key 路由内存队列” 这类方案,直接区分背题的和真踩过坑的。
核心答案
先给结论:Kafka 只保证单个分区内消息有序,不保证 topic 级全局有序。所以解题思路就一句话:让需要保序的消息进同一个分区,并保证这个分区从头到尾串行处理。
目标 | 方案 | 代价 |
|---|---|---|
全局有序 | topic 只设 1 个分区 + 消费组内 1 个消费者 | 吞吐量极低,基本只用于低流量场景 |
局部有序 | 相同 key 的消息发到同一分区(分区器哈希) | 几乎无损,主流方案 |
实际生产中绝大多数场景只需要局部有序:同一个订单的消息有序、同一个用户的消息有序,就够了。
深度解析
一、先搞清楚:Kafka 的 “有序” 到底指什么
Kafka 的存储结构是 append-only log(只追加日志),每个分区就是一串只能往尾部追加的消息日志。
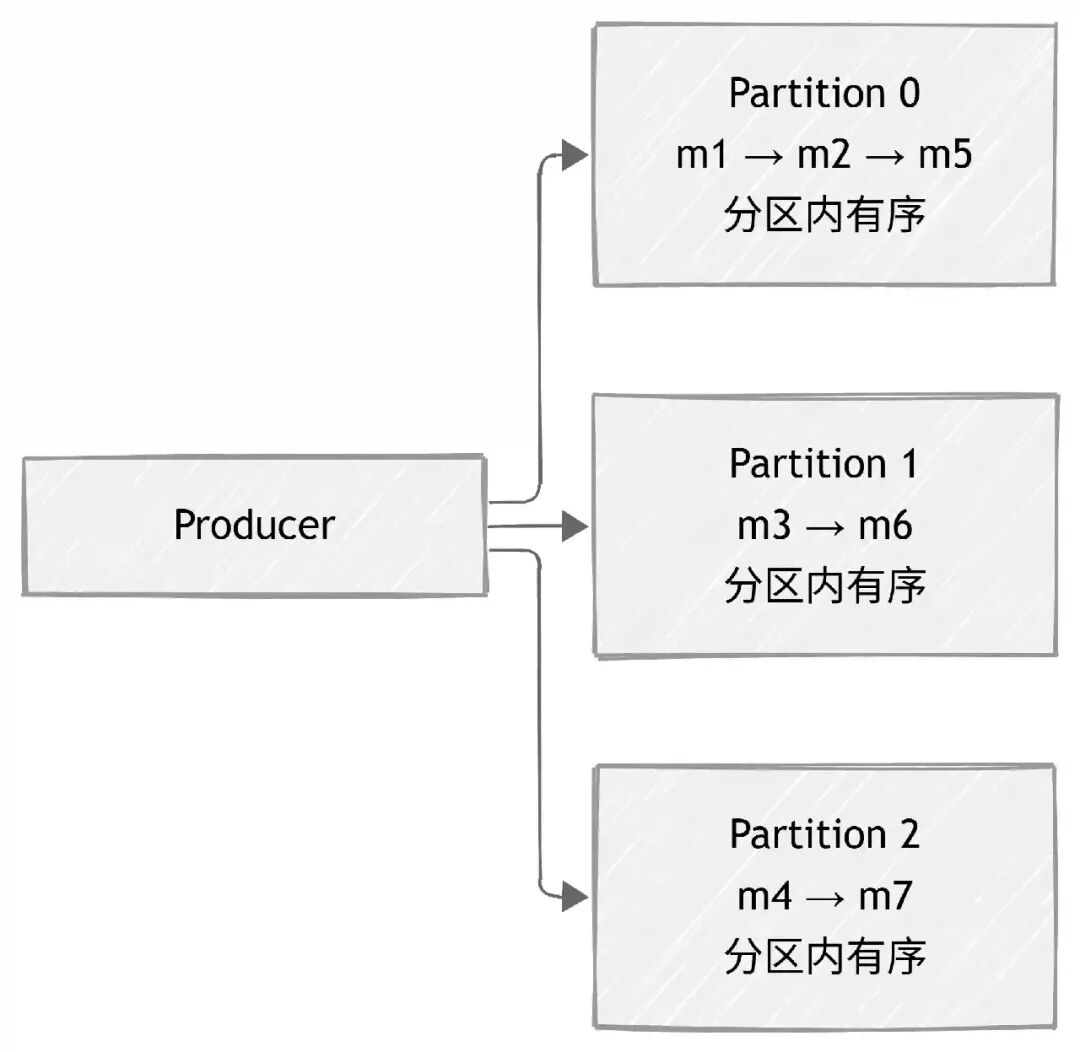
Kafka 消息分发到多个有序分区
Kafka 消息分发到多个有序分区
上图展示了 Kafka 分区级别的顺序保证,拆开看三层:
- 写入侧:消息按到达顺序追加到分区日志尾部,分区内天然有序
- 读取侧:消费者按 offset 递增方向拉取,单分区内读取顺序稳定
- 分区之间:没有任何顺序承诺,Partition 2 的消息完全可能比 Partition 0 的先被消费
所以想全局有序只有一条路:topic 就给一个分区。代价也明显:写入吞吐和消费并行度全被锁死,分区数就是并行度上限。除非业务真的要求全局有序(比如 Binlog 全量回放这种),否则别这么干。
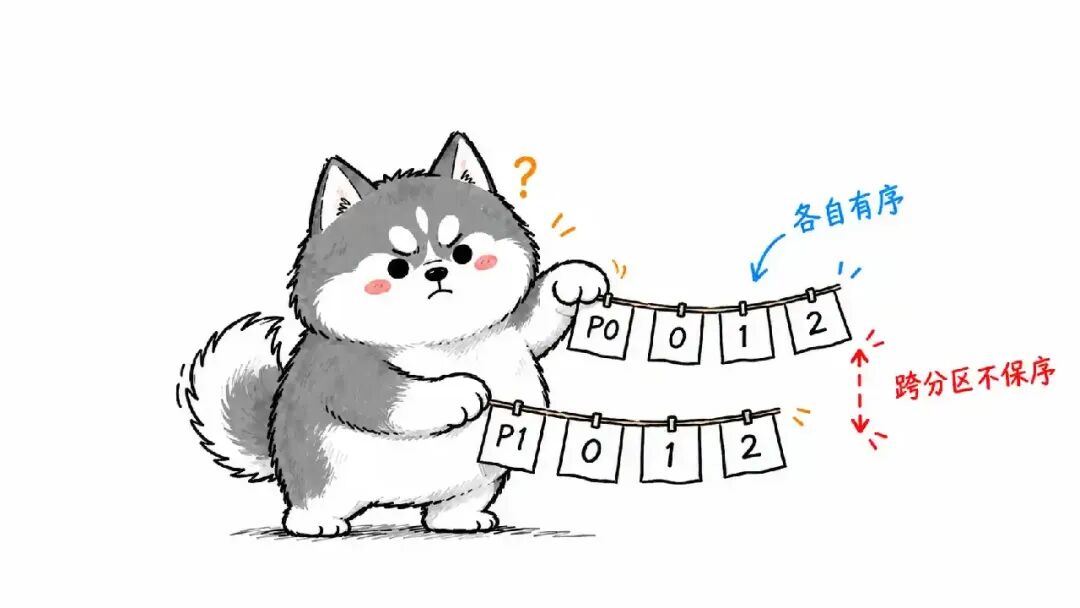
Kafka 分区内有序,跨分区不保序
Kafka 分区内有序,跨分区不保序
二、生产端:把该有序的消息送进同一个分区
Producer 发消息时可以指定 key,默认分区器对 key 做 murmur2 哈希再对分区数取模,公式是 toPositive(murmur2(keyBytes)) % numPartitions。只要分区数不变、序列化方式不变,相同 key 的消息永远落同一个分区。
// 同一个订单的消息用 orderId 作为 key,天然进同一分区
ProducerRecord<String, String> record =
        new ProducerRecord<>("order-topic", orderId, orderEventJson);
producer.send(record);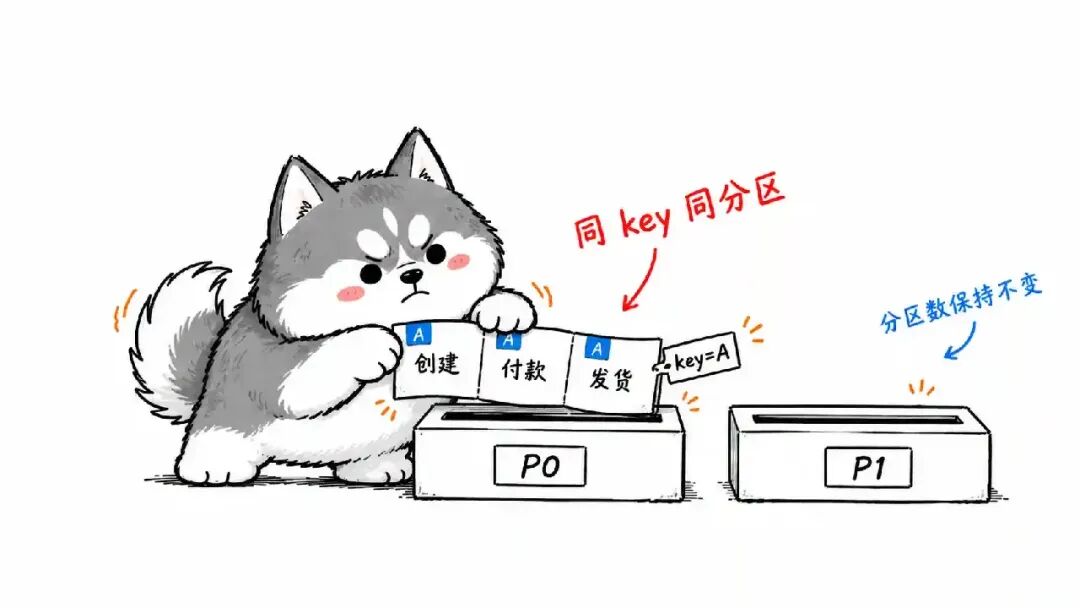
Kafka 同 key 订单消息进入同一分区
Kafka 同 key 订单消息进入同一分区
但这里有个当年坑过很多人的暗雷:重试乱序。
retries > 0 且 max.in.flight.requests.per.connection > 1 时,如果第一个 batch 失败进重试,第二个 batch 先落盘成功,顺序就反了。两种解法:
- 把
max.in.flight.requests.per.connection设成1:能保序,但吞吐掉的比较狠,不推荐 - 开启幂等:
enable.idempotence=true,Broker 端按序列号去重并保序,max.in.flight到 5 都不怕。Kafka 3.0 起这个参数默认就是开的(acks也默认改成了all),老版本要手动开
再补一个冷知识:Kafka 2.4(KIP-480)之后,key 为 null 的消息改用 “粘性分区” 策略——producer 会粘着一个分区攒 batch,攒满才切下一个。所以无 key 消息不仅没顺序可言,连以前的轮询打散都没有了。
三、消费端:一个分区只被一个消费者消费
消费组机制保证了:同一个消费组内,一个分区最多分配给一个消费者。消费者数量多于分区数时,多出来的只能干瞪眼。
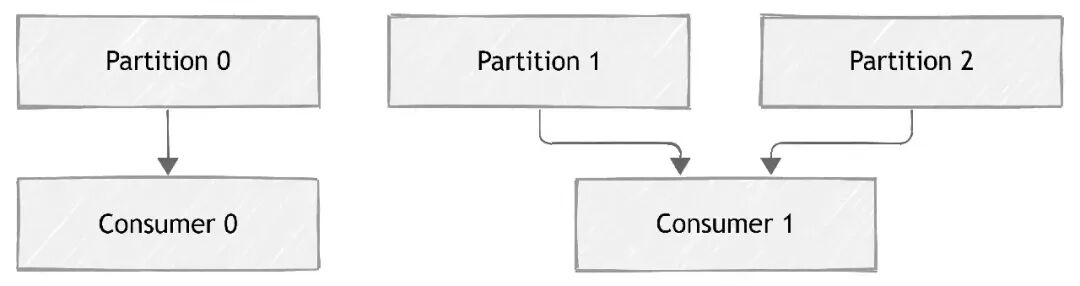
Kafka 同组消费者独占分区的分配关系
Kafka 同组消费者独占分区的分配关系
上图的意思很直白:
- 3 个分区、2 个消费者,
Consumer 1被分配了 2 个分区,各自串行消费 - 这是 Kafka 消费组协议保证的,不用你写一行代码
- 想加消费者提速?可以,但消费者数超过分区数就没意义了
这部分不用操心,真正容易翻车的是消费者内部的处理逻辑。
最常见的坑:poll() 拉回来一批消息,图快直接扔线程池并行处理——完了,分区内拉取有序,处理完成顺序全乱了。
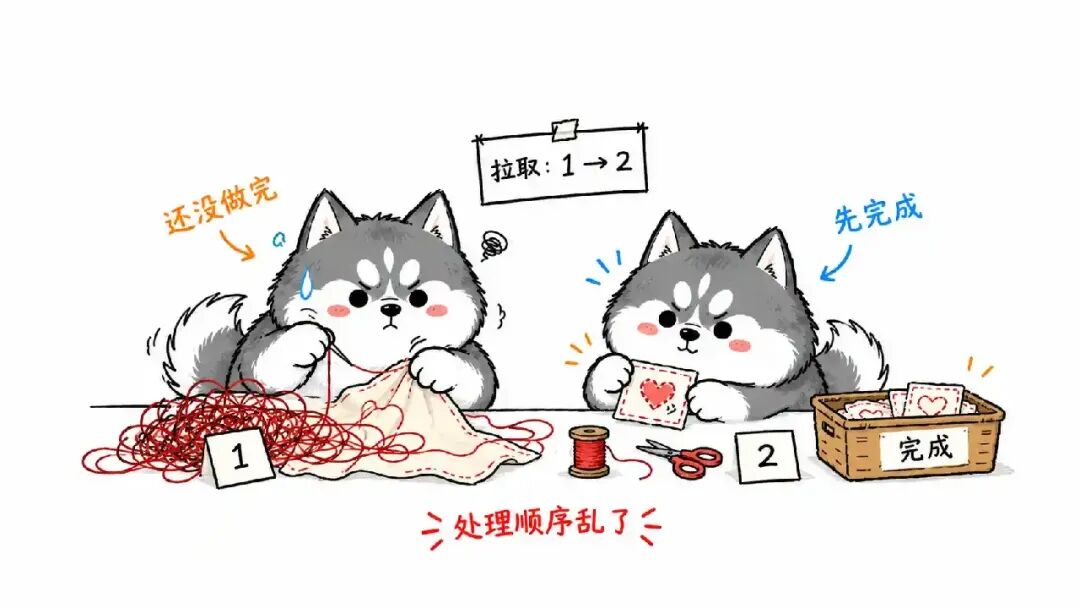
Kafka 有序拉取后并行处理导致乱序
Kafka 有序拉取后并行处理导致乱序
经典解法是 “按 key 路由内存队列”:
// 消费者线程只做两件事:拉取 + 按 key 路由
while (running) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(500));
    for (ConsumerRecord<String, String> record : records) {
        // 同一个 key 永远进同一个内存队列,队列内单线程消费
        int idx = Math.floorMod(record.key().hashCode(), QUEUE_COUNT);
        queues[idx].add(record);
    }
}
每个内存队列配一个专属工作线程,串行 take() 处理:
// 每个队列一个 worker,同一队列内严格串行
ExecutorService executor = Executors.newFixedThreadPool(QUEUE_COUNT);
for (BlockingQueue<ConsumerRecord<String, String>> queue : queues) {
    executor.submit(() -> {
        while (running) {
            ConsumerRecord<String, String> record = queue.take();
            handle(record); // 业务处理
        }
    });
}
这样一来,一个消费者线程能扛多个分区的吞吐,同一 key 的消息依然严格串行。吞吐和顺序就都保住了。
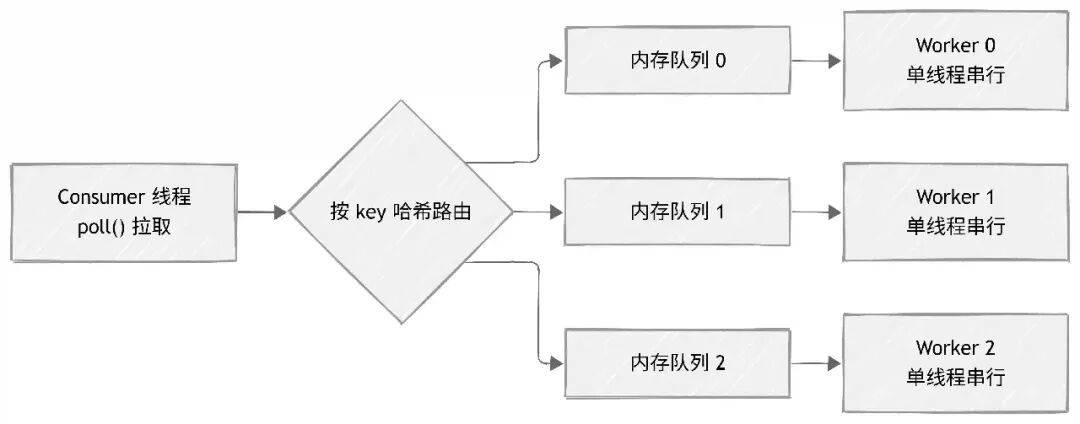
Kafka 按 key 路由队列并由独立线程处理
Kafka 按 key 路由队列并由独立线程处理
上图就是方案的全貌:消费者线程只负责拉取和分发,真正干活的是后面一排 “队列 + 单线程” 组合,每条队列内部就是一个小型的单分区世界,顺序天然有保障。
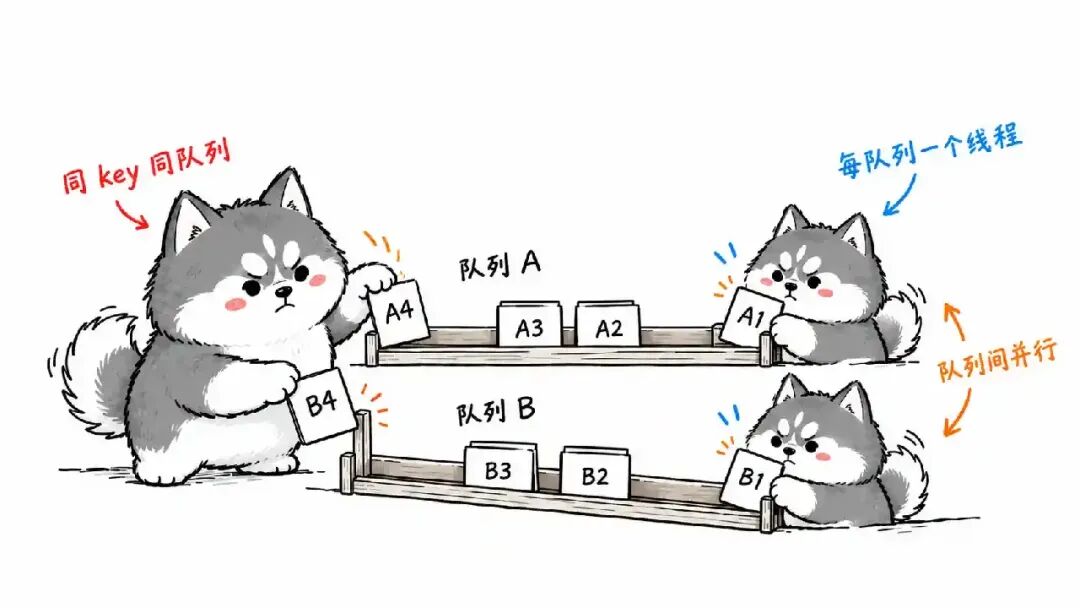
Kafka 同 key 同队列,队列内串行处理
Kafka 同 key 同队列,队列内串行处理
最后说说 rebalance。消费者扩缩容、宕机都会触发 rebalance,分区被重新分配。这里要分清楚:rebalance 带来的主要是重复消费风险(offset 没提交到位),不是乱序——分区内的 offset 顺序不会因为重新分配而改变。应对套路是 “先处理后提交 offset + 消费端幂等” 兜底。
四、把整条链路串起来
生产端同 key 同分区(开幂等防重试乱序)→ Broker 分区日志天然有序 → 消费组内分区独占 → 消费者单线程处理(慢就按 key 拆内存队列并行提速)。
面试高频追问
- 幂等生产者的原理是什么? Producer 启动时拿到 PID,按 <PID, 分区> 维护序列号,Broker 端比对序列号去重,重复的拒掉、乱序的拦截。
- 消费者数量比分区数多会怎样? 多余的消费者空闲。想提并行度只能加分区,但加分区会打破 “同 key 同分区” 的映射关系,这是个经典深坑。
- rebalance 会造成乱序吗? 不会打乱分区内顺序,主要风险是重复消费,用幂等消费兜底。
- 消费逻辑很慢,怎么既保序又提吞吐? 按 key 拆内存队列,多个 worker 各自串行,并行度和顺序兼得。
- 和 RocketMQ 的顺序消息比呢? RocketMQ 原生支持顺序消息(发送时选 MessageQueue,消费时顺序模式),Kafka 需要自己攒这套方案。
常见面试变体
- “Kafka 为什么不保证全局有序?”
- “如何保证消息不丢、不重、不乱序?”(三件套连环问)
- “Kafka 和 RocketMQ 在顺序消息上的区别?”
记忆口诀
同 key 同分区,同分区同线程。 生产端靠 key 哈希聚到同一分区,消费端靠分区独占加单线程处理;要提速就按 key 拆内存队列,别动分区数。
总结
一句话:Kafka 的顺序是分区级别的,生产端用同一个 key 把有序消息打进同一分区(顺手开幂等防重试乱序),消费端保证一个分区一个消费者、处理时别乱并行,慢就按 key 拆内存队列。这条链路答下来,再补一句 “全局有序只能单分区但吞吐会炸”,这道题基本就稳了。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号