把出图量归因到商品:一套产能核算表的设计
原创

做电商的都会盯一个数:这个月出了多少张图、几张能用。
但这个总数本身说明不了什么。它回答不了真正的问题——哪款商品在反复重做、哪类图最费时间、换了模型之后可用率变没变、这个店和那个店哪个更稳。
要把这些问题答上来,得把产出归因到具体的商品和图位上。这件事不是记账问题,是数据模型问题:归因维度必须在提交任务时就带上,事后补不回来。
一、为什么按总量记没用
大多数人的记法是月底看一眼总数。这个做法有三个硬伤。
第一,无法定位。 这个月出了八百张,是因为上新多了,还是因为某款商品反复重跑?总数看不出来。
第二,无法比较。 两个店的产出没法直接比,因为上新量、类目、客单价都不同。要比就得比"每个可用图位出几次",而这就要求归因。
第三,无法判断换版本值不值。 模型换了一代,如果不知道每个图位出了多少张、废了多少张,就算不出真实的可用率。
二、六个归因维度
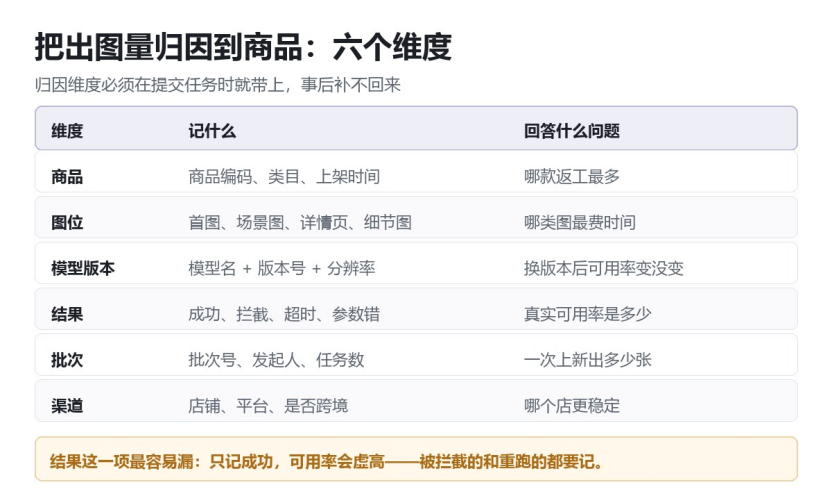
示意图:把出图量归因到商品,六个维度各自回答什么(本文绘制)
维度 | 记什么 | 回答什么问题 |
|---|---|---|
商品 | 商品编码、类目、上架时间 | 哪款返工最多 |
图位 | 首图、场景图、详情页、细节图 | 哪类图最费时间 |
模型版本 | 模型名 + 版本号 + 分辨率 | 换版本后可用率变没变 |
结果 | 成功、拦截、超时、参数错 | 真实可用率是多少 |
批次 | 批次号、发起人、任务数 | 一次上新出多少张 |
渠道 | 店铺、平台、是否跨境 | 哪个店更稳定 |
六个维度里,结果这一项最容易被漏。只记成功任务的张数,算出来的是"每张成功图要出几次",这个数会偏低——被拦截的、超时重跑的,同样占了一次任务。
三、表怎么设计
最小可用的表长这样:
CREATE TABLE image_output_record (
    id            BIGSERIAL PRIMARY KEY,
    task_id       VARCHAR(64)  NOT NULL,
    sku_id        VARCHAR(64)  NOT NULL,   -- 商品编码
    category      VARCHAR(64),             -- 类目,冗余存一份
    image_slot    VARCHAR(32)  NOT NULL,   -- 图位枚举
    model_name    VARCHAR(64)  NOT NULL,
    model_version VARCHAR(32)  NOT NULL,
    resolution    VARCHAR(16),             -- 1K / 2K / 4K
    batch_id      VARCHAR(64),             -- 一次上新一个批次号
    channel       VARCHAR(32),             -- 店铺/平台
    status        VARCHAR(16)  NOT NULL,   -- success / blocked / ...
    out_cnt       INT          DEFAULT 1,  -- 这一任务出了几张
    usable_cnt    INT          DEFAULT 0,  -- 验收通过几张
    duration_ms   INT,
    operator      VARCHAR(64),
    created_at    TIMESTAMPTZ DEFAULT now()
);

CREATE INDEX idx_out_sku   ON image_output_record (sku_id, created_at);
CREATE INDEX idx_out_batch ON image_output_record (batch_id);
几点设计考虑:
图位用枚举,不要自由文本。 一旦允许手填,"主图""首图""商品主图"会变成三个值,分组统计就散了。
类目冗余存一份。 商品表里的类目会变,产出记录要保留当时的类目,否则回溯时会被新类目覆盖。
状态单独一列。 不要把它折进 usable_cnt=0,那样就分不清"没出图"和"出了不可用"。
产出与可用分开记。 out_cnt 是这一任务实际出了几张,usable_cnt 是验收通过的几张。两个数一起看,才有可用率。
四、写入时机
三个时机,缺一不可:
提交时写一条。 带上 sku、图位、模型、批次、渠道。这条记录的存在本身就说明任务发起过。
回调或轮询确认结果时更新状态。 成功、拦截、超时分开记。
每日对账后补漏。 有些任务在提交时就失败(参数错),没有回调,只能靠对账补。
写入要幂等。同一个 task_id 重复更新,只保留最后一条,不要产生多条记录。
五、四个能直接用的查询
哪款返工最多:
SELECT sku_id,
       SUM(out_cnt)                              AS total_out,
       SUM(usable_cnt)                           AS total_ok,
       ROUND(SUM(out_cnt)::numeric
             / NULLIF(SUM(usable_cnt), 0), 2)    AS out_per_ok
  FROM image_output_record
 WHERE created_at >= now() - interval '30 days'
 GROUP BY sku_id
 ORDER BY out_per_ok DESC
 LIMIT 20;
注意 out_per_ok(每个可用图位要出几次)比 total_out(总张数)更有决策价值。前者能比,后者不能。
哪类图最慢:
SELECT image_slot,
       COUNT(*)                             AS tasks,
       ROUND(AVG(duration_ms) / 1000.0, 1)  AS avg_sec,
       ROUND(AVG(CASE WHEN status = 'success'
                 THEN 1 ELSE 0 END), 3)     AS ok_rate
  FROM image_output_record
 WHERE created_at >= now() - interval '30 days'
 GROUP BY image_slot
 ORDER BY avg_sec DESC;
换版本前后对比:
SELECT model_version,
       DATE_TRUNC('week', created_at) AS wk,
       COUNT(*) AS tasks,
       ROUND(AVG(CASE WHEN status = 'success'
                 THEN 1 ELSE 0 END), 3) AS ok_rate
  FROM image_output_record
 WHERE model_name = 'nano-banana'
 GROUP BY 1, 2
 ORDER BY 2, 1;
一次上新出多少张:
SELECT batch_id, operator,
       COUNT(*)  AS tasks,
       COUNT(DISTINCT sku_id) AS skus,
       SUM(out_cnt)    AS total_out,
       SUM(usable_cnt) AS total_ok
  FROM image_output_record
 WHERE batch_id = 'B20261102-01'
 GROUP BY 1, 2;
六、三个常见的坑
坑一:只在成功时记记录。 失败的任务同样占了一次排队与一次等待,尤其是内容拦截和超时重跑。只记成功,可用率会算高三成。
坑二:用文件名当商品编码。 文件名会改,商品编码不会。归因键必须在提交时绑定,不能靠事后匹配。
坑三:没有批次概念。 没有批次号,就回答不了"这次上新出了多少张",也没法把产出和销售结果对照。
七、这套表能带来什么
最直接的变化是:月底不再只看一个总数,而是能说出"这款商品每个可用图位要出两次,因为它改了六次稿"。
有了这个判断,动作就清楚了——要么改提示词模板,要么把图位拆细重排,要么这款商品直接实拍。
顺带说一句工具选择。归因表能跑起来的前提是任务能带上业务字段。Flux Art 是多模型 AI 视觉创作与生产平台,电商方向按上架内容、商品图处理、服饰与穿戴分组,图位概念本身就在产品结构里,提交时按组选、回来按组统计,比自己维护一套图位枚举要省事;开放接口也支持把这些字段随任务一起带过去。
产能核算的价值不在算得准,在于能定位。定位清楚了,省下来的往往不是一点点。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号