我把 LangGraph 从入门到上线全撸了一遍,这篇是完整知识点总结
原创
我把 LangGraph 从入门到上线全撸了一遍,这篇是完整知识点总结
原创
大盘鸡拌面
发布于 2026-10-12 16:12:51
发布于 2026-10-12 16:12:51
先说点废话。
我最早用 LangChain 写 Agent 的时候,代码长这样:一个 while True 循环,里面塞一堆 if else,判断模型返回的下一步该干嘛,然后手动往 messages 列表里 append,再手动记一下"这一步走到哪了"。写着写着自己都看不下去了——逻辑一复杂,那个循环就变成一坨谁都不敢动的意大利面。
更难受的是两件事。一是状态管理,每个节点都在改同一个列表,改着改着就不知道是谁改的、覆盖了没有。二是中断恢复,程序跑到一半崩了,或者需要人点个确认再继续,你根本没法优雅地"存个档,等会儿接着跑"。
LangGraph 就是冲着这两个痛点来的。它不是 LangChain 的替代品,更像是给 LangChain 套了个"状态机"的外壳。你不再写循环,而是画一张图——节点是干活的函数,边是走哪条路,状态是一个自动流转的数据结构。剩下的调度、持久化、断点续跑,框架全给你包了。
这篇我按自己的理解把它捋一遍,最后给一个完整的实战例子。看完你应该能直接动手写。
一、先搞清楚 LangGraph 到底解决了什么问题
很多文章一上来就讲 API,我觉得没用。你得先知道它为什么存在。
传统的 Agent 写法,本质是命令式的:我告诉程序第一步干嘛、第二步干嘛、遇到 A 走分支 1、遇到 B 走分支 2。代码里全是控制流。问题是当 Agent 变复杂之后——比如十几个工具、要循环重试、要中途让人审批、要多个 Agent 协作——命令式代码的复杂度是爆炸式增长的。
LangGraph 换了个思路,做成声明式的:你只描述"有哪些节点"和"节点之间怎么连",具体的执行顺序交给框架。
这两种写法的差别,有点像手动管理内存和用 GC。前者你能控制一切,但迟早把自己绕进去。
具体一点,LangGraph 给你四样东西:
能力 | 没有它会怎样 | 有了它 |
|---|---|---|
循环 | 手写 while,重试逻辑散落各处 | 边可以指回前面的节点,天然支持 |
持久化 | 崩了就从头再来 | 每个节点后自动存档,断点续跑 |
人在回路 | 只能跑完再让人看结果 | 任意节点挂起等人,确认后接着跑 |
多智能体 | 手写消息转发,调度混乱 | Supervisor / Swarm 模式开箱即用 |
说实话,如果你只是做个"问一句答一句"的机器人,用不上 LangGraph,Chain 就够了。但只要你的 Agent 需要循环、分支、暂停、多人协作里的任何一项,就该上 LangGraph。
二、四块积木:State、Node、Edge、Checkpointer
LangGraph 的全部概念,拆开就这四个。我一个一个说。
2.1 State:整个图的"共享内存"
State 是贯穿整张图的数据容器。每个节点读它、改它,改完传给下一个节点。
from typing import TypedDict, Annotated
from langgraph.graph.message import add_messages

class AgentState(TypedDict):
    # add_messages 是 reducer:新消息追加而不是覆盖
    messages: Annotated[list, add_messages]
    # 普通字段:后写覆盖先写
    current_step: str
retry_count: int这里有个特别容易踩的坑,我单独拎出来讲:Annotated 里的第二个参数叫 reducer(归约器)。
不加 reducer 的话,节点返回 {"messages": [新消息]},默认行为是整个列表被替换掉,历史全没了。加上 add_messages 之后,新消息会追加到原列表后面。这一个参数的区别,能让你的 Agent 从"每次都失忆"变成"记得住上下文"。
除了内置的 add_messages,你也能自己写 reducer,比如做累加计数、做字典合并:
def merge_dict(left: dict, right: dict) -> dict:
    return {**left, **right}

class State(TypedDict):
    # 字典合并而不是替换
    user_profile: Annotated[dict, merge_dict]
2.2 Node:干活的普通函数
节点就是一个普通的 Python 函数,签名是 (state) -> dict。返回值是要更新到 State 里的增量,不是全量。
def classify_intent(state: AgentState) -> dict:
    last_msg = state["messages"][-1].content
    # 这里真实场景会调 LLM,先简化
    if "退款" in last_msg:
        intent = "refund"
    elif "物流" in last_msg:
        intent = "logistics"
    else:
        intent = "consult"
    return {"current_step": intent}
注意它只返回 {"current_step": intent},没动 messages。这是 LangGraph 的设计哲学:每个节点只说自己改了什么,框架负责合并。这样做的好处是节点之间解耦,你改一个节点不会影响别人。
2.3 Edge:决定下一步往哪走
边分两种。普通边就是无条件跳转:graph.add_edge("a", "b")。条件边才是灵魂,它接一个路由函数,根据 State 动态决定去哪个节点。
def route_by_intent(state: AgentState) -> str:
    return state["current_step"]   # 返回值对应下面 mapping 的 key

graph.add_conditional_edges(
    "classify_intent",
    route_by_intent,
    {"refund": "handle_refund", "logistics": "handle_logistics", "consult": "handle_consult"},
)循环就是靠条件边实现的——让路由函数在某些条件下返回前一个节点的名字,图就绕回去了。比如"回答质量不合格就重新生成"这种重试逻辑,用 LangGraph 写就是一条指回自己的边,干净得不像话。
2.4 Checkpointer:自动存档点
这是我最喜欢的功能。编译图的时候传一个 checkpointer,框架会在每个节点执行完自动把当前 State 存下来。
from langgraph.checkpoint.memory import MemorySaver

memory = MemorySaver()
app = graph.compile(checkpointer=memory)

# 每个对话一个 thread_id,互不影响
config = {"configurable": {"thread_id": "user-001"}}
app.invoke({"messages": [HumanMessage("我要退款")]}, config)
有了 thread_id,同一个用户的多轮对话状态自动串起来。生产环境换成 SqliteSaver 或者 PostgresSaver 就能持久化:
from langgraph.checkpoint.sqlite import SqliteSaver
import sqlite3

conn = sqlite3.connect("agent.db", check_same_thread=False)
memory = SqliteSaver(conn)
app = graph.compile(checkpointer=memory)
整个执行流程长这样:
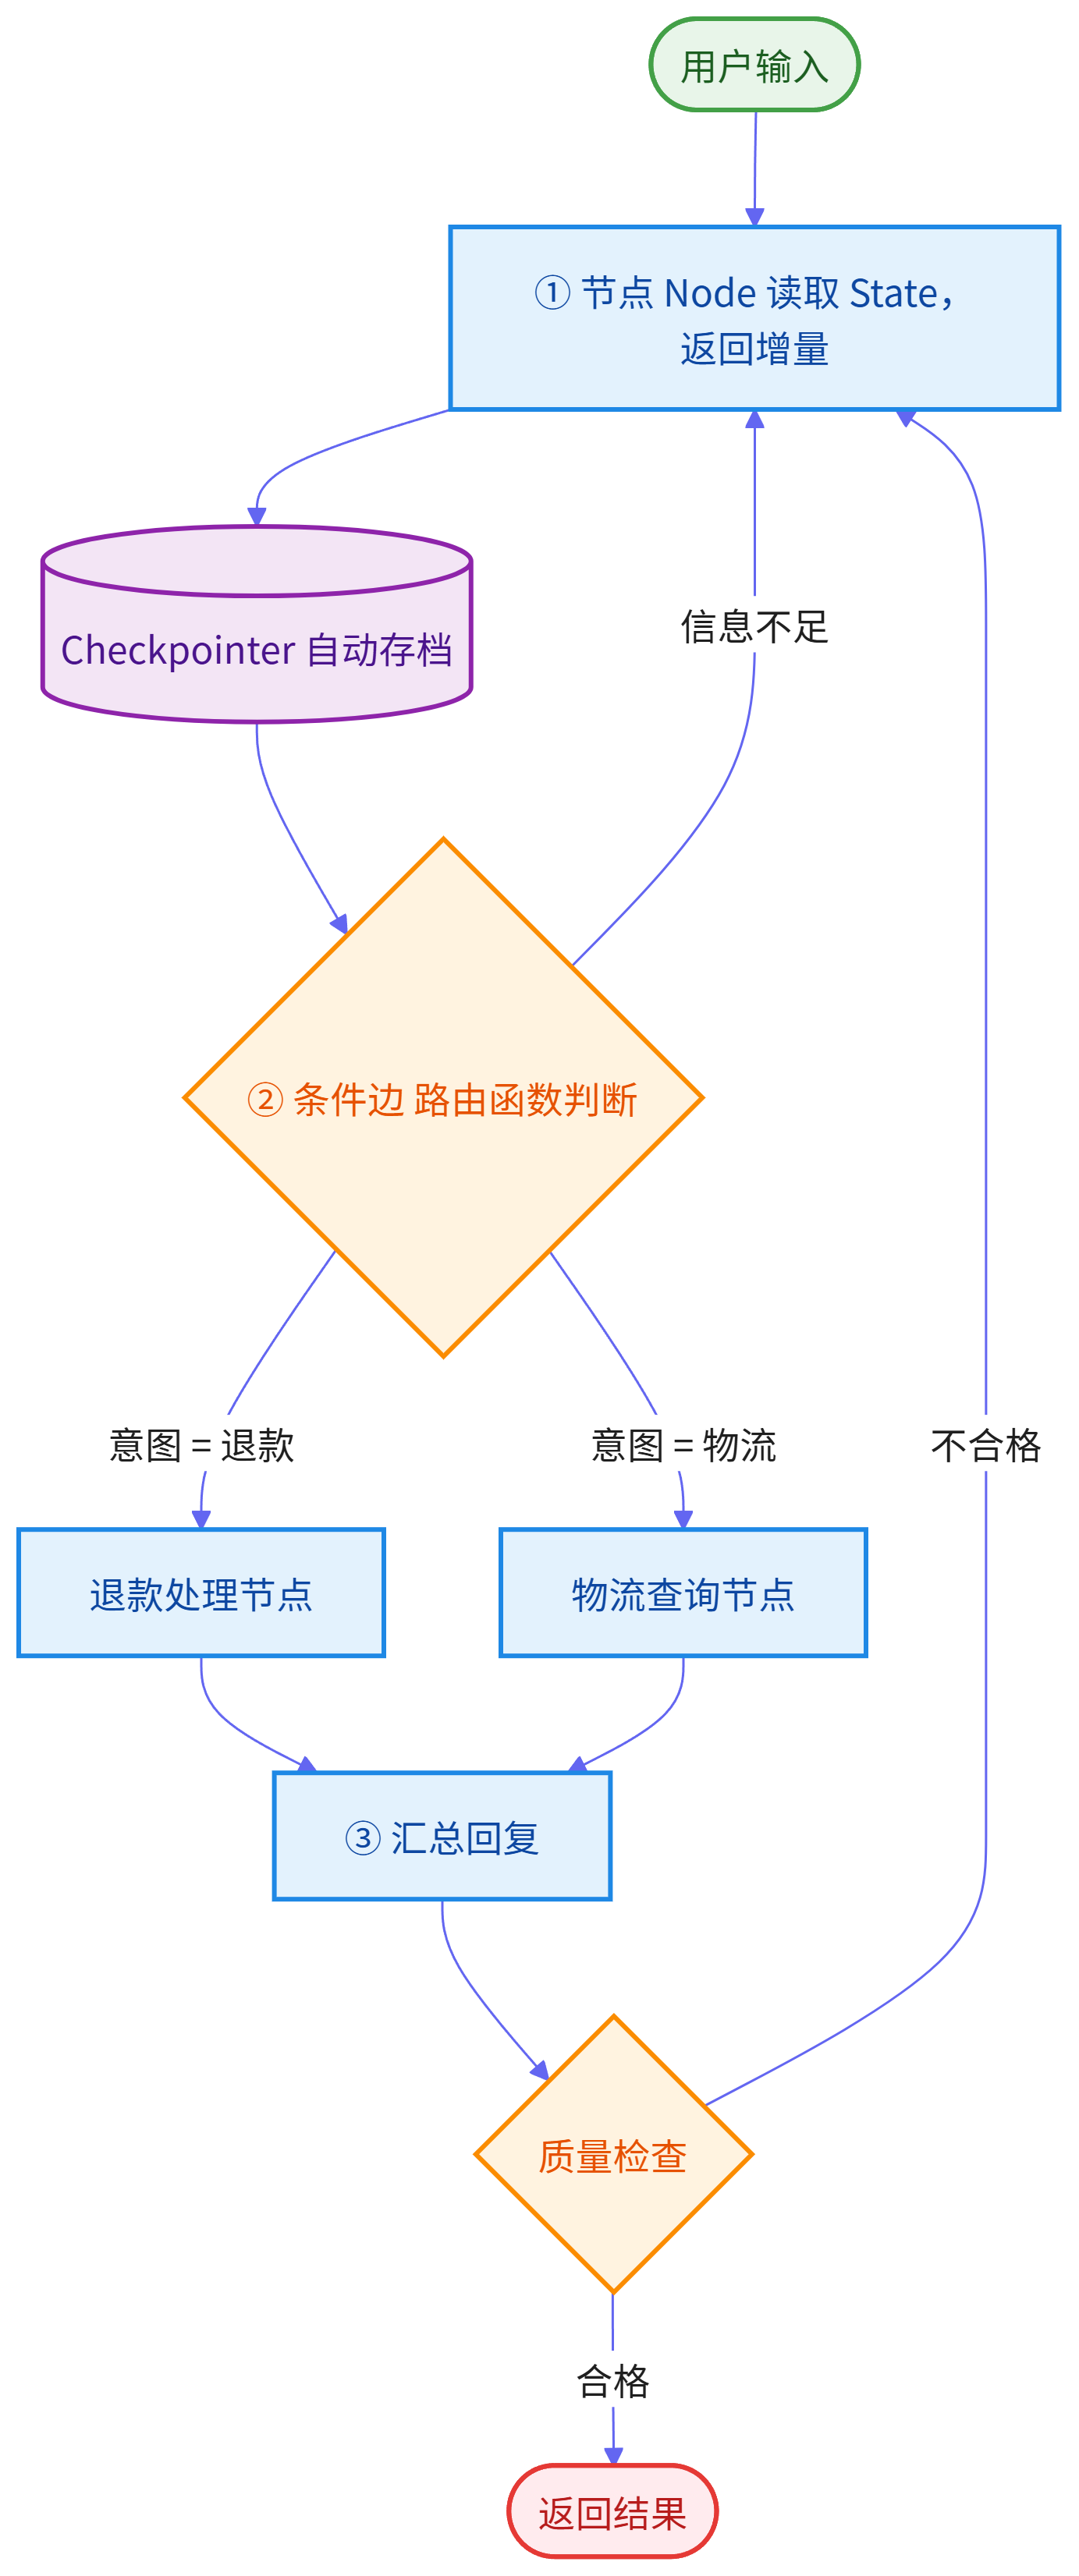
图里那条从"质量检查"绕回节点的橙色虚线,就是循环。用普通代码写这段逻辑你得嵌套好几层,用 LangGraph 就一行 add_conditional_edges。
三、让 Agent 真的像人干活:分支、循环、人在回路
基础的四块积木会了之后,接下来这几个是真正拉开差距的东西。
3.1 循环重试:给 Agent 加个"自我检查"
大模型输出不稳定这事大家都知道。传统做法是外面套个 for 循环手动重试,状态得自己维护。LangGraph 里你只要加一个"质检节点",不合格就把边指回生成节点,同时在 State 里放个计数器防死循环。
def quality_gate(state: AgentState) -> str:
    if state["retry_count"] >= 3:
        return "force_end"      # 兜底,别无限循环
    if len(state["messages"][-1].content) < 20:
        return "regenerate"
    return "finish"
我一般会在 State 里固定放一个 retry_count,每次重试就 +1。到上限强制走兜底分支,返回一句"这个问题我转人工"。生产环境这个兜底必须写,不然遇到死循环你的 API 账单会很难看。
3.2 人在回路:跑一半停下来等人
这是 LangGraph 最杀手级的功能。涉及退款、删数据、发短信这种不可逆操作,你肯定不敢让 Agent 全自动。interrupt 可以让图在某个节点挂起,等人处理完再接着跑。
from langgraph.types import interrupt, Command

def refund_node(state: AgentState) -> dict:
    amount = extract_amount(state["messages"][-1].content)
    if amount > 500:
        # 挂起!把信息抛给前端,等人审批
        decision = interrupt({
            "question": f"检测到 {amount} 元大额退款,是否批准?",
            "amount": amount,
        })
        if not decision["approved"]:
            return {"current_step": "rejected"}
    return {"current_step": "refund_done"}
人处理完之后,用 Command(resume=...) 把结果喂回去,图从上次中断的地方继续往下跑,而不是从头再来:
app.invoke(Command(resume={"approved": True}), config)整个交互时序是这样的:
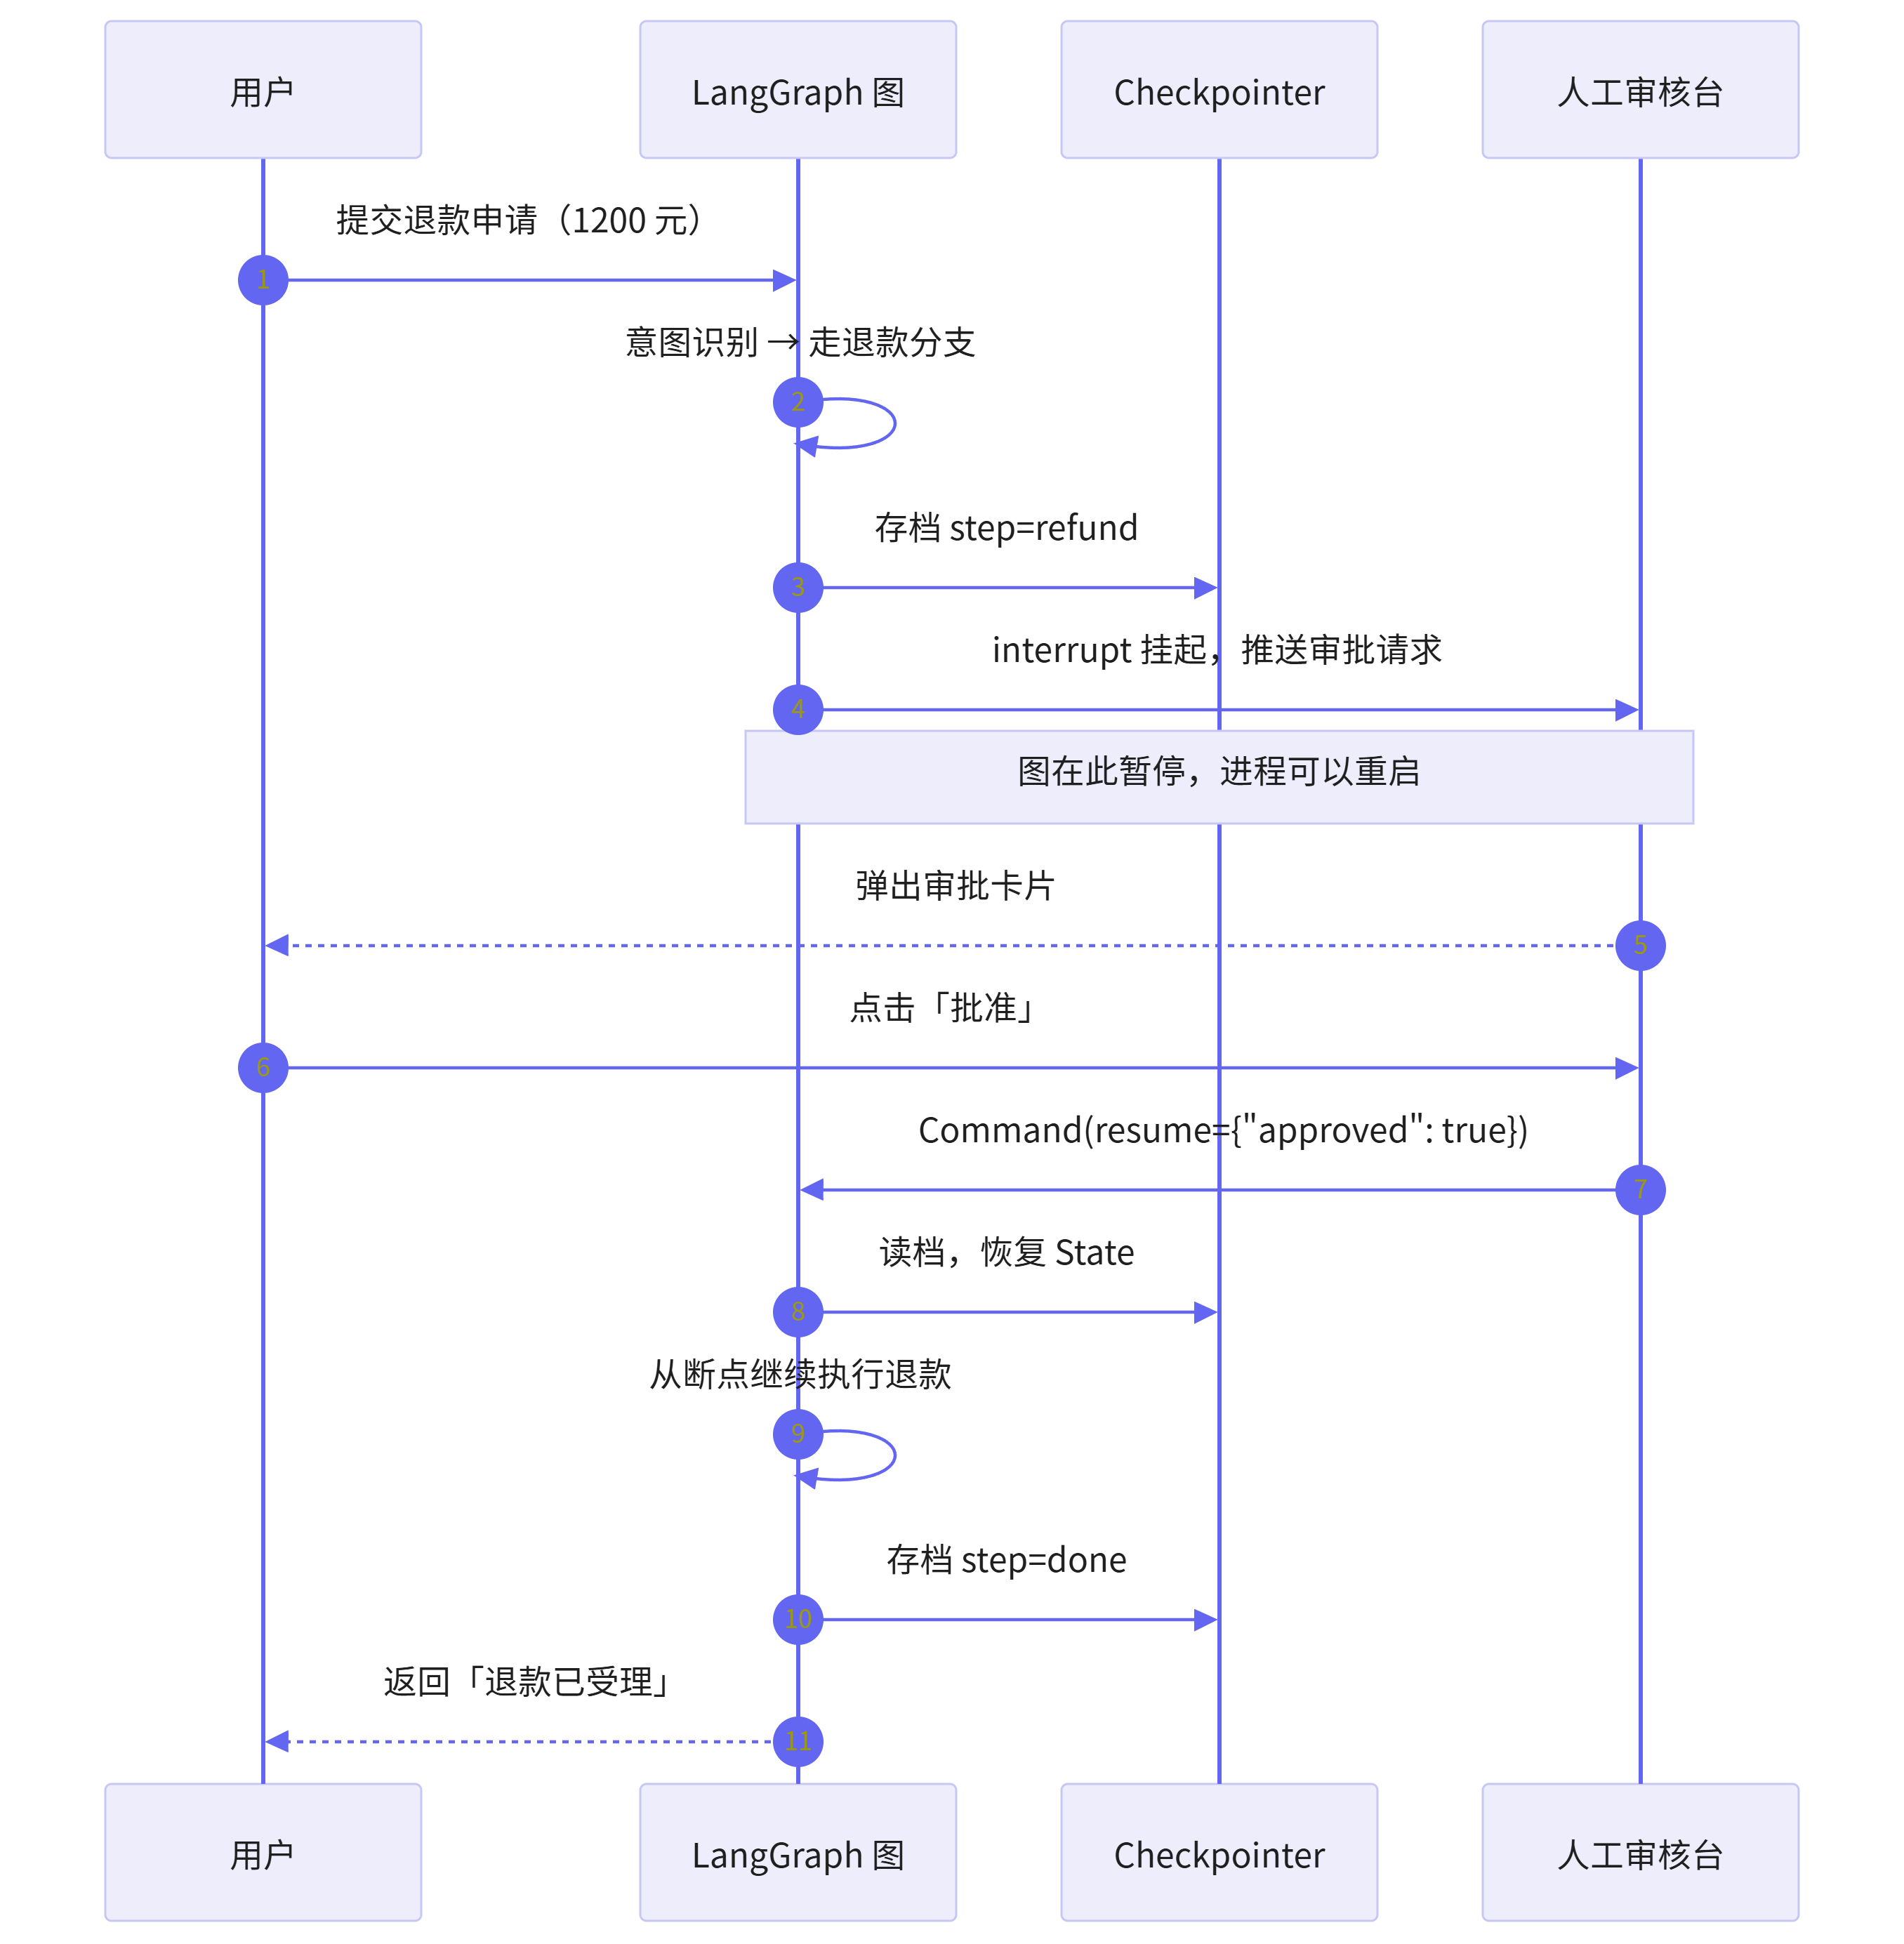
关键在"图在此暂停"那一行。进程挂了、服务重启了都没关系,State 在 checkpointer 里躺着,resume 的时候原样恢复。我自己做支付相关的 Agent 时,这个功能救过好几次。
3.3 时间旅行:回退到任意一步重跑
既然每一步都存档了,那就能"读档"。你可以拿到某个 thread_id 的完整历史,挑一个检查点,从那一步重新分叉执行。
# 看这个会话的所有检查点
for snapshot in app.get_state_history(config):
    print(snapshot.config, snapshot.values)

# 回退到某一个检查点,改点东西再跑
old_config = snapshot.config
app.update_state(old_config, {"retry_count": 0})
app.invoke(None, old_config)   # 从这个点继续
这个功能在调试的时候巨好用。以前查 bug 只能加 print 重跑一遍,现在直接回退到出错那一步,改个参数再跑,几秒钟的事。
四、多智能体怎么排兵布阵
单个 Agent 搞不定的活,就拆成多个。LangGraph 里常见的两种编排模式。
Supervisor(主管模式):一个主管 Agent 负责分发任务,干活的 Agent 干完都把结果交回主管,主管决定下一步。好处是控制集中,不会出现两个 Agent 互相踢皮球。适合流程相对固定的场景,比如"先查资料、再写稿、再配图"这种。
Swarm(群聊模式):Agent 之间可以互相转交任务,谁能干谁接手。灵活,但不好预测,容易失控。适合探索性的任务,比如开放式研究。
我个人的经验是 80% 的场景用 Supervisor 就够了,别为了炫技上 Swarm。多智能体最大的坑不是调度,是上下文膨胀——每个 Agent 都往 State 里塞消息,跑十轮之后 token 数直接起飞。解决办法是给子 Agent 单独的 State,只把结论回传给主管。
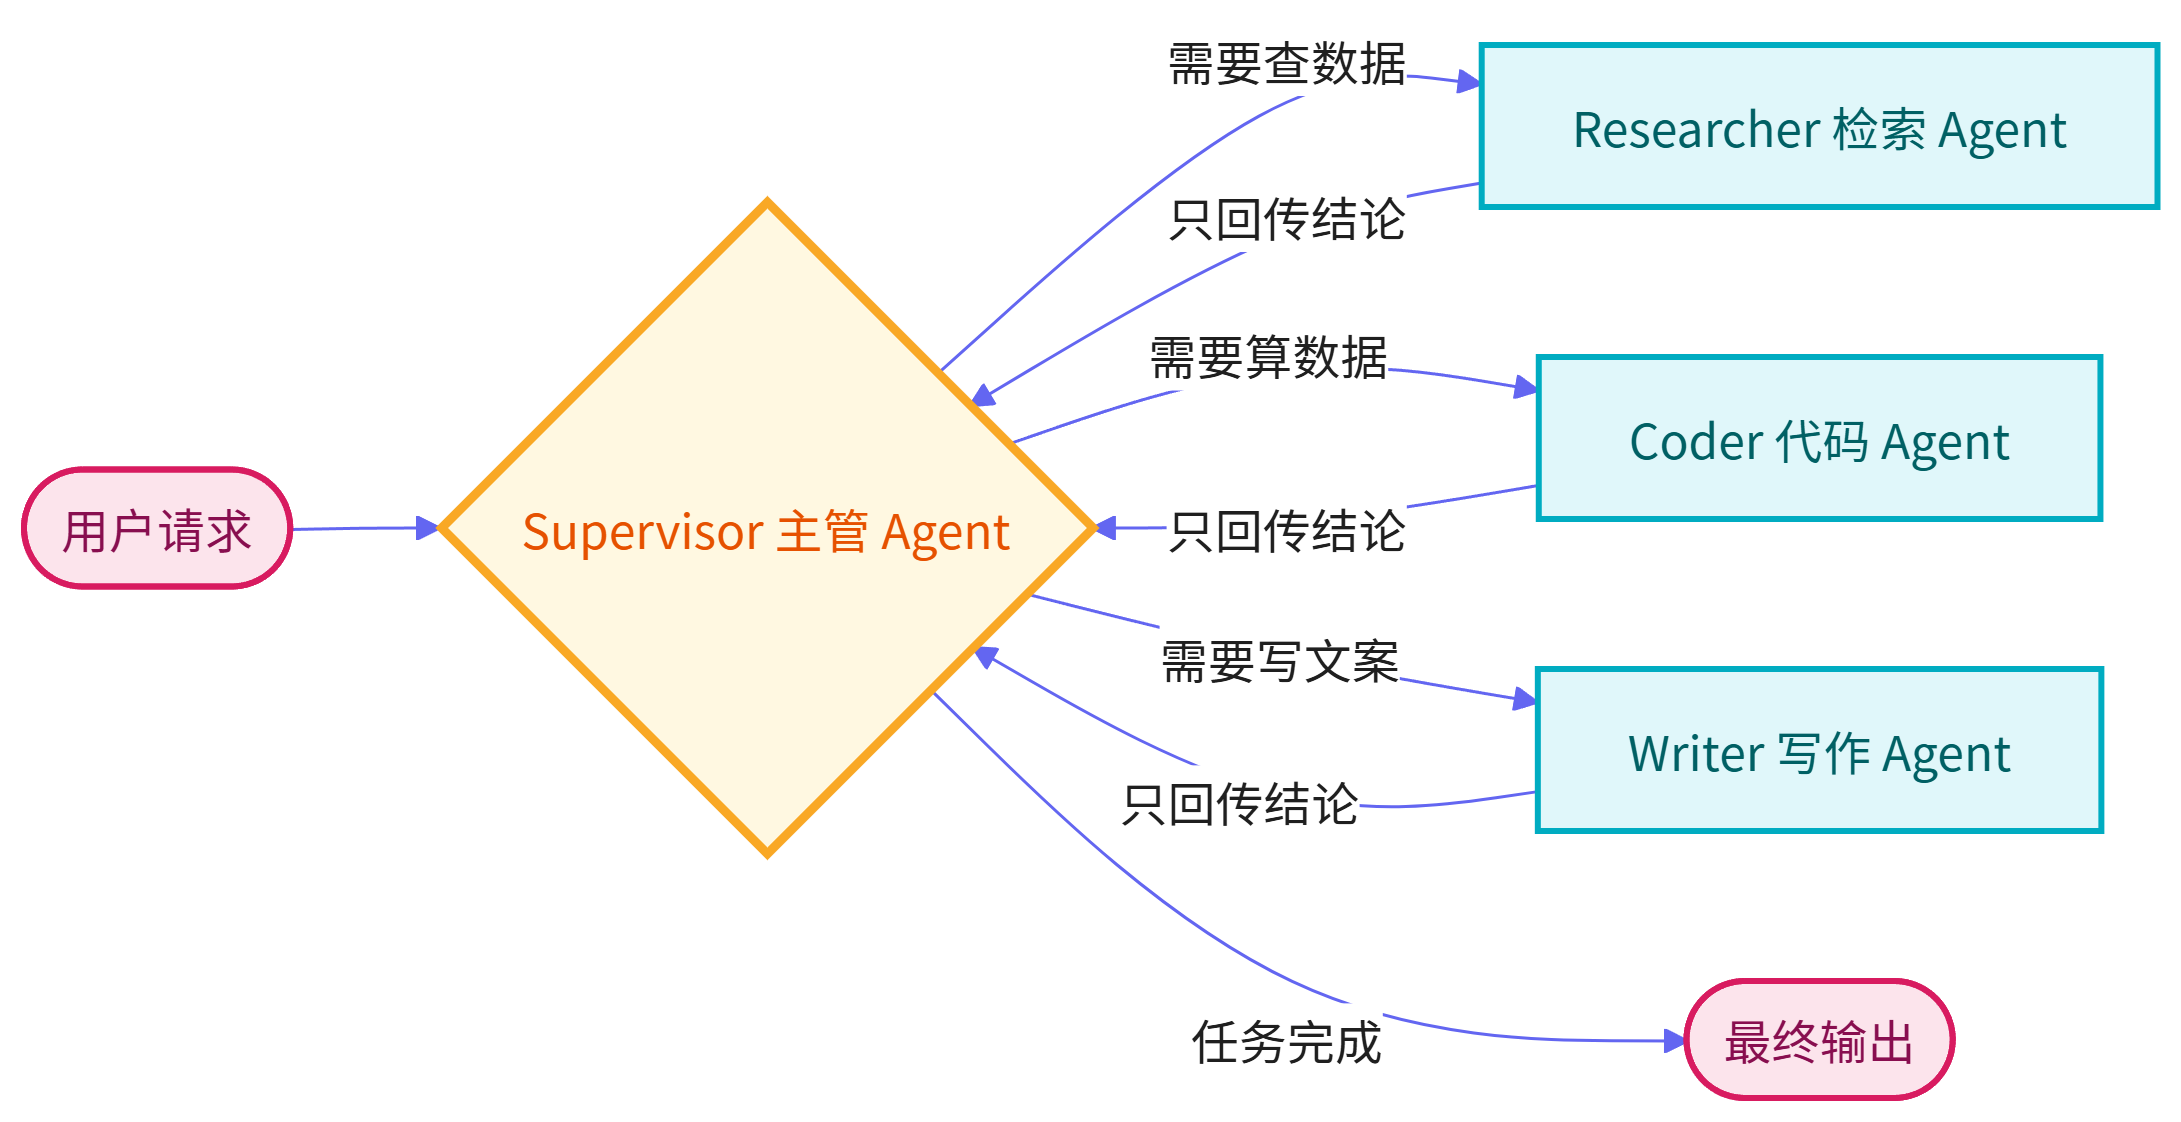
图里"只回传结论"这四个字是重点。子 Agent 内部可以聊十轮,但回给主管的应该是压缩后的结果,不是原始对话记录。这一条设计做好了,多智能体的成本能砍掉一大半。
五、实战:一个能上线的智能客服工单系统
光讲概念没意思,我把自己做过的一个客服工单系统简化一下,完整贴出来。
业务背景:电商平台每天几千条工单,涉及退款、查物流、技术咨询。诉求是常规问题自动处理,大额退款必须人工审批,回答不达标要自动重写,处理不了转人工。
为什么必须用 LangGraph:四个需求里,"自动重写"要循环,"人工审批"要中断,"多轮对话"要持久化。这三个凑一块,用普通写法基本没法维护。
5.1 定义 State
from typing import TypedDict, Annotated
from langgraph.graph.message import add_messages

class TicketState(TypedDict):
    messages: Annotated[list, add_messages]   # 追加,保留历史
    intent: str                                # refund / logistics / consult
    amount: float                              # 退款金额
    retry_count: int                           # 重写次数
    approved: bool                             # 人工审批结果
    final_answer: str
5.2 写各个节点
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, AIMessage
from langgraph.types import interrupt

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

# ① 意图识别
def classify(state: TicketState) -> dict:
    text = state["messages"][-1].content
    prompt = f"把下面这条工单归到 refund/logistics/consult 之一,只输出一个词。\n工单:{text}"
    intent = llm.invoke(prompt).content.strip().lower()
    # 顺手把金额抠出来
    amount = 0.0
    for tok in text.replace("元", " ").split():
        try:
            amount = float(tok)
            break
        except ValueError:
            continue
    return {"intent": intent, "amount": amount}

# ② 退款处理(带人工审批)
def handle_refund(state: TicketState) -> dict:
    if state["amount"] > 500 and not state.get("approved"):
        decision = interrupt({
            "question": f"工单涉及 {state['amount']} 元退款,超过 500 元阈值,需人工审批",
            "amount": state["amount"],
        })
        return {"approved": bool(decision.get("approved"))}
    prompt = f"用户申请退款 {state['amount']} 元,给出专业、简短的客服回复。"
    return {"final_answer": llm.invoke(prompt).content}

# ③ 物流查询
def handle_logistics(state: TicketState) -> dict:
    # 真实场景这里会调物流 API
    order_id = extract_order_id(state["messages"][-1].content)
    tracking = query_tracking_api(order_id)
    prompt = f"物流状态:{tracking}。用客服口吻向用户说明。"
    return {"final_answer": llm.invoke(prompt).content}

# ④ 技术咨询
def handle_consult(state: TicketState) -> dict:
    docs = retrieve_kb(state["messages"][-1].content)   # 知识库检索
    prompt = f"参考资料:{docs}\n回答用户问题:{state['messages'][-1].content}"
    return {"final_answer": llm.invoke(prompt).content}

# ⑤ 质检:不合格就重写
def quality_check(state: TicketState) -> str:
    ans = state.get("final_answer", "")
    if state["retry_count"] >= 3:
        return "to_human"          # 重试三次还不行,转人工
    if len(ans) < 15 or "我不知道" in ans:
        return "regenerate"
    return "pass"

def regenerate(state: TicketState) -> dict:
    prompt = f"上一版回答太简略,请补充细节后重写。原始问题:{state['messages'][0].content}"
    return {
        "final_answer": llm.invoke(prompt).content,
        "retry_count": state["retry_count"] + 1,
    }

def to_human(state: TicketState) -> dict:
    return {"final_answer": "这个问题已转交人工客服,预计 30 分钟内联系您。"}
说明:上面用到的
extract_order_id、query_tracking_api、retrieve_kb 是业务侧的伪函数(订单号抽取、物流接口、知识库检索),按你们自己的实现替换即可,跟 LangGraph 本身没关系。
5.3 把图拼起来
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.sqlite import SqliteSaver
import sqlite3

builder = StateGraph(TicketState)

builder.add_node("classify", classify)
builder.add_node("refund", handle_refund)
builder.add_node("logistics", handle_logistics)
builder.add_node("consult", handle_consult)
builder.add_node("regenerate", regenerate)
builder.add_node("human", to_human)

builder.add_edge(START, "classify")

# 按意图分流
builder.add_conditional_edges(
    "classify",
    lambda s: s["intent"],
    {"refund": "refund", "logistics": "logistics", "consult": "consult"},
)

# 三条业务线都汇到质检
for node in ("refund", "logistics", "consult"):
    builder.add_conditional_edges(
        node,
        quality_check,
        {"regenerate": "regenerate", "pass": END, "to_human": "human"},
    )

# 重写完再回质检,形成循环
builder.add_edge("regenerate", "refund")
builder.add_edge("human", END)

conn = sqlite3.connect("tickets.db", check_same_thread=False)
app = builder.compile(checkpointer=SqliteSaver(conn))
5.4 实际调用
config = {"configurable": {"thread_id": "ticket-20261012-001"}}

# 第一轮
result = app.invoke({"messages": [HumanMessage("我买的鞋子不合适,要退款 899 元")]}, config)
# 到这里会因为 interrupt 挂起,result 里带着 __interrupt__ 字段

# 人工在后台点了「批准」之后
result = app.invoke(Command(resume={"approved": True}), config)
print(result["final_answer"])
上线之后的实际效果:常规咨询类工单全自动闭环,占比大概七成;大额退款全部走人工审批,没有出过误操作;回答质量不合格自动重写,平均重跑 1.2 次就能达标。最直观的变化是运维同学不用半夜起来重启服务了——工单跑到一半卡住,第二天 resume 一下接着走就行。
有一点要提醒:上线前一定要给 add_conditional_edges 的 mapping 加个兜底 key,比如意图识别返回了个预料之外的值,没有兜底的话图会直接抛错中断。我吃过这个亏。
LangGraph 的学习曲线不算陡,但它的思维方式跟写普通代码不太一样——你得从"我要一步步控制流程"转成"我只要描述清楚有哪些状态和转移"。这个转变刚开始会有点别扭,过了那个坎之后,写复杂 Agent 的效率是真的高。
如果你准备上手,我的建议是:先拿一个最简单的三节点图(识别 → 处理 → 输出)跑通,然后依次加上条件边、加上循环、加上 interrupt、最后接持久化。每加一个功能你就理解一层,比一上来啃多智能体强得多。
至于要不要用,判断标准就一句话:你的 Agent 需不需要"停下来"或者"绕回去"。需要,就用;不需要,Chain 足矣。别为了用而用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号