DolphinDB 时序数据建模实战:宽窄表取舍与多型号设备的统一 schema
原创
DolphinDB 时序数据建模实战:宽窄表取舍与多型号设备的统一 schema
原创
Xxtaoaooo
发布于 2026-09-20 21:56:29
发布于 2026-09-20 21:56:29
摘要
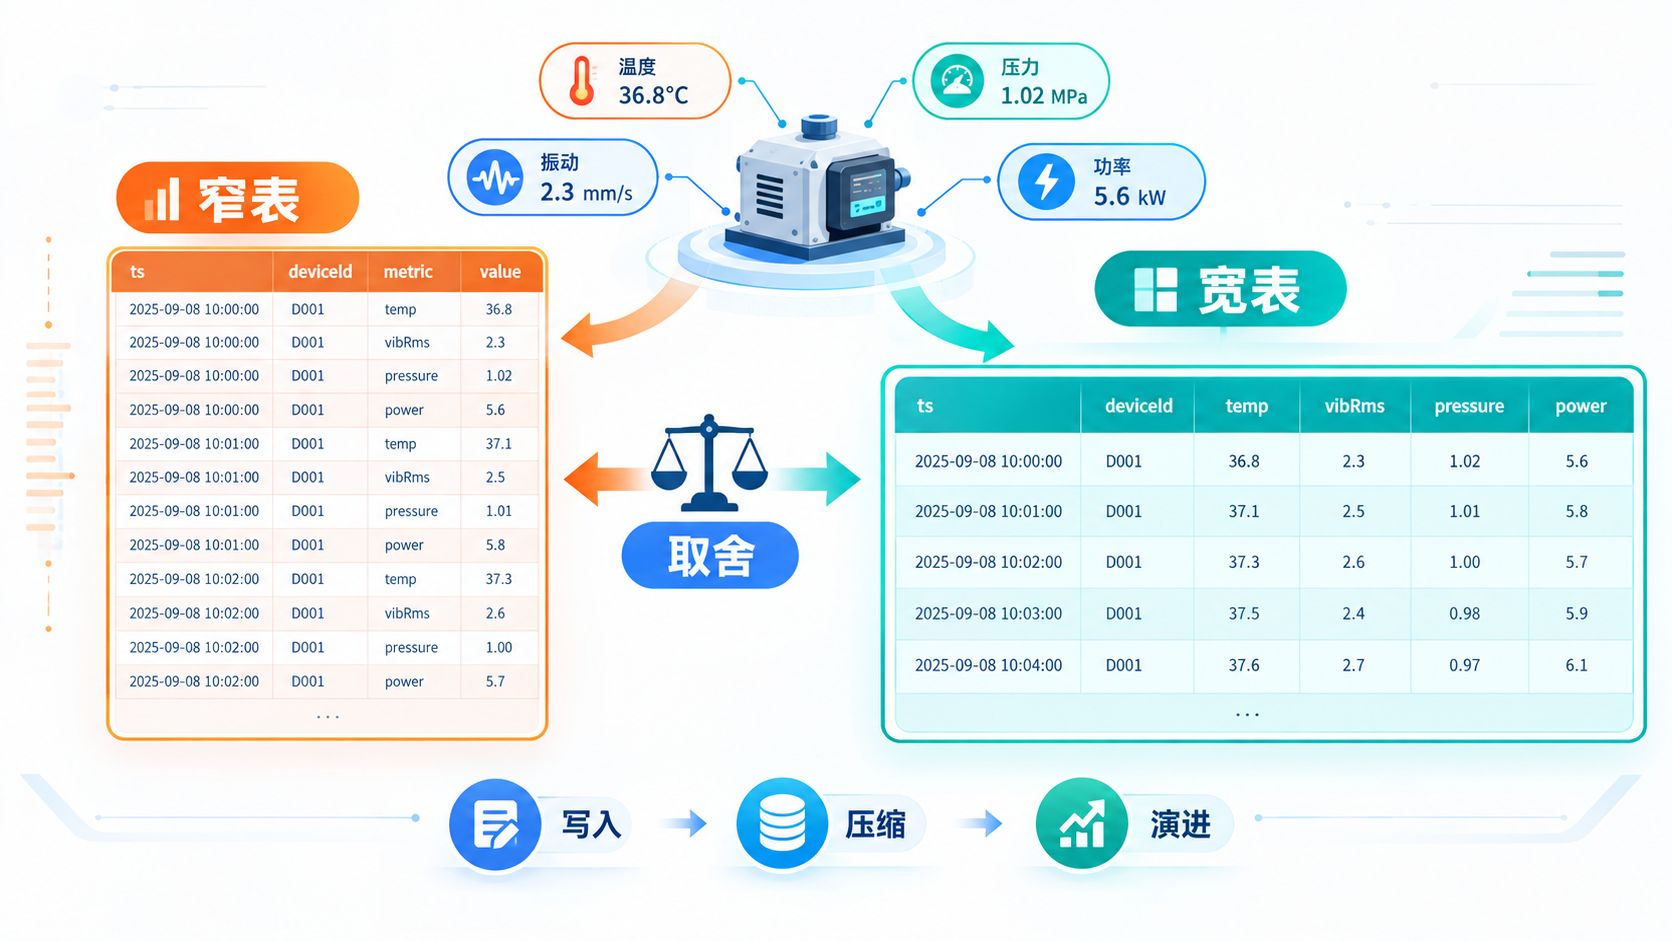
搭 IoT 数据平台,有一道题躲不开,而且必须第一天就答:测点数据用什么表结构存?
大部分教程给的答案是窄表——一测点一行(时间、设备、指标名、数值),通用、灵活、加测点零改动,MySQL 时代就这么教。而列存时序引擎又普遍偏爱宽表——一设备一行、一测点一列,压缩率和查询效率都更好。两种说法都对,但都不全对:窄表的灵活是有代价的,宽表的高效也是有边界的,代价和边界都藏在你的具体场景里。
更麻烦的是第二个问题:厂里设备三个型号、五家厂商,测点一半重叠一半不同,schema 怎么统一?每型号一张表?全型号一张超宽表?还是有什么折中?
本文把这两个问题摊开讲:窄表与宽表在写入、查询、压缩、类型安全、计算直接性五个维度上的取舍;多型号设备统一 schema 的三种方案;tag 放内联还是维表;以及加测点、上新型号时 schema 怎么演进。最后给一份可以直接照用的决策清单。
建模是第一天的事,也是每一天的事——schema 会陪你比代码更久,值得第一周多花两天想清楚。
一、两种形状:窄表与宽表
先把两种建模摆出来,看清楚它们长什么样。
1.1 窄表:一测点一行
// 窄表(也叫长表):每个采样点占一行
narrow = table(1:0,
    `ts`deviceId`metric`value,
    [DATETIME, SYMBOL, SYMBOL, DOUBLE])

// 一台设备 8 个测点的同一秒采样 = 8 行
// (2026.03.15 10:00:00, PUMP-007, temp,    42.1)
// (2026.03.15 10:00:00, PUMP-007, vibRms,   2.3)
// (2026.03.15 10:00:00, PUMP-007, pressure, 0.8)
// ...窄表的本质是把"测点"做成了数据(metric 列的值),而不是结构(列名)。这是它一切优缺点的根源。
1.2 宽表:一设备一行、一测点一列
// 宽表:一次采样占一行,每个测点一列
wide = table(1:0,
    `ts`deviceId`temp`vibRms`vibPeak`pressure`rpm`power`status,
    [DATETIME, SYMBOL, DOUBLE, DOUBLE, DOUBLE, DOUBLE, DOUBLE, DOUBLE, SYMBOL])

// 同一个采样 = 1 行
// (2026.03.15 10:00:00, PUMP-007, 42.1, 2.3, 5.7, 0.8, 1480, 75.2, RUNNING)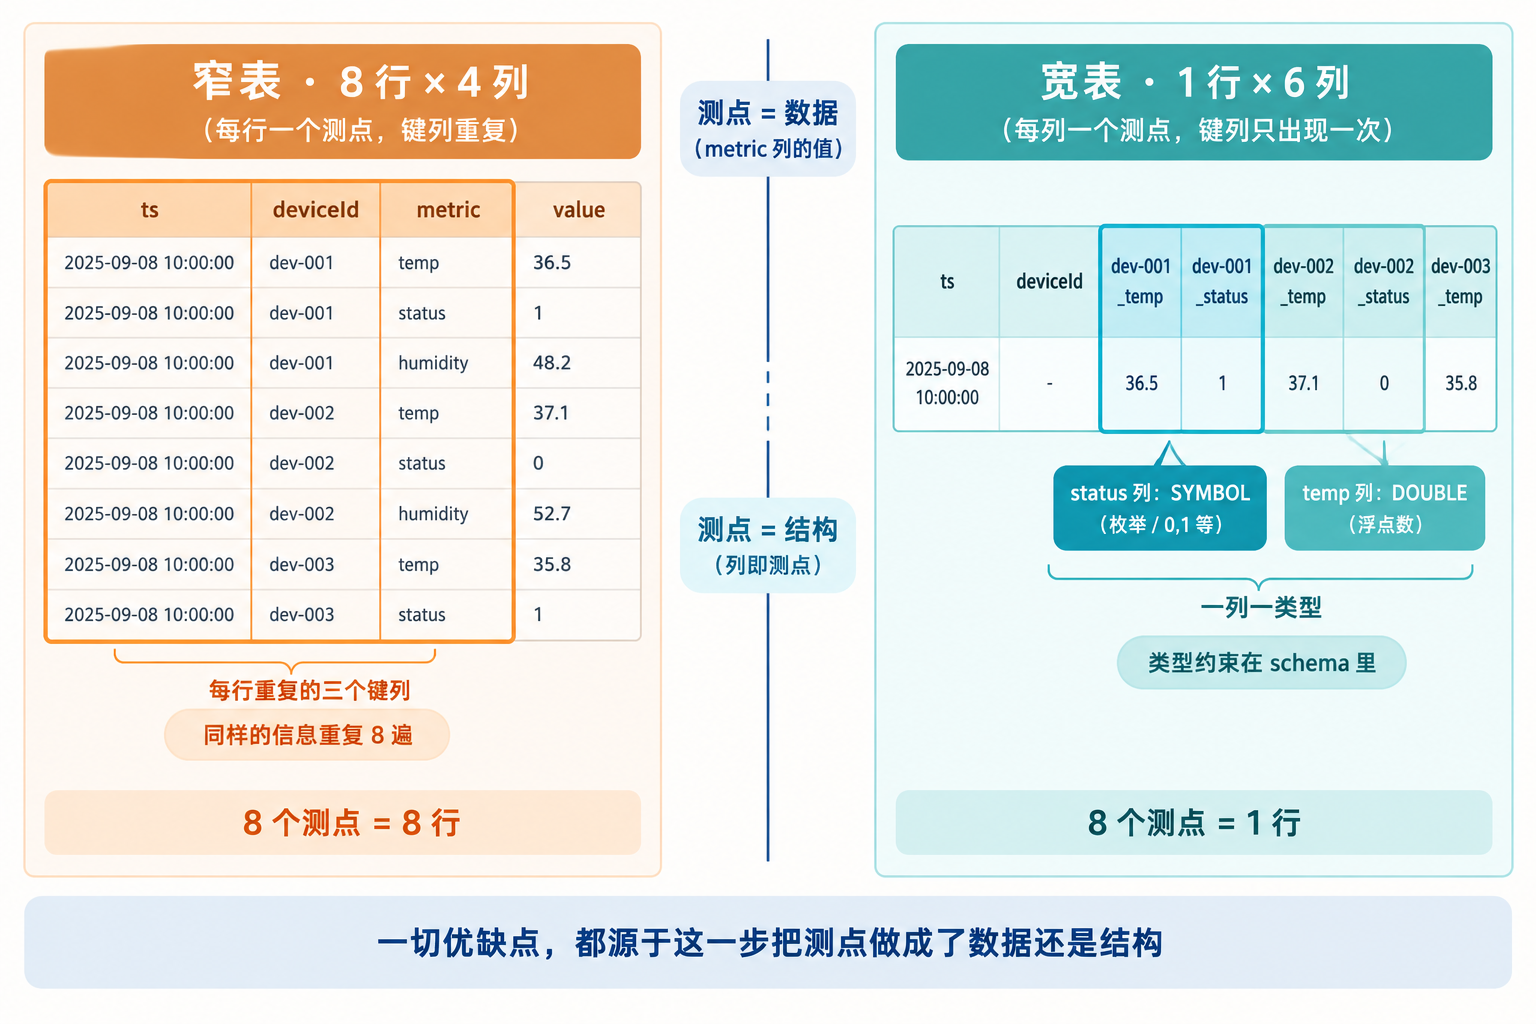
宽表把测点做成了结构:列即测点,类型即约束。
二、五个维度的取舍
两种形状谁好?没有标准答案,只有维度。
2.1 写入路径:行数放大 vs 单行多列
窄表有行数放大效应:8 个测点就是 8 行。1000 台设备 1Hz 采样,每秒 8000 行;宽表只要 1000 行。行数多本身不是问题(时序引擎吃行数没问题),问题是每行都要重复 ts + deviceId + metric 这组键——同样的信息量,窄表多扛了三列的重复存储。
宽表的写入端要求接入数据"一次到齐":一个采样周期内各测点凑齐一行再写。测点到达参差(有的 1Hz 有的 0.1Hz)时,要么按最慢的对齐,要么接受空值。
2.2 查询模式:先问"谁是常客"
选型的关键不是两种表各自能跑什么查询,而是你的查询里谁是常客:
- 单测点长曲线(看 PUMP-007 三天的温度趋势):窄表
where metric = 'temp'直出;宽表select ts, temp from ...同样直出——两者打平 - 多测点同时刻关联(温度、振动、功率对齐看;算振动和功率的相关性):宽表是原生能力,列就在同一行里:
// 宽表:跨测点计算零成本
select corr(vibRms, power) as vib_power_corr
from loadTable("dfs://iot", "wide")
where deviceId = "PUMP-007"
  and ts between datetime(2026.03.15) : datetime(2026.03.16)
窄表要做这件事,得先 pivot by 把行转列,多一步 reshuffle,数据量大时这一步不便宜:
// 窄表:先转宽再算
select corr(vibRms, power) from (
    select avg(value) from narrow
    where deviceId = "PUMP-007"
    pivot by minute(ts), metric
)- 新测点上线:窄表零改动(metric 多一个值而已);宽表要动 schema——这是窄表的核心优势,演进问题第五节单独讲
2.3 压缩与空间:列同质性与空值密度
列存引擎的压缩率取决于列内数据的同质性。这里窄表吃暗亏:
- 宽表的
temp列,从头到尾都是温度值,范围窄、变化平缓,压缩效果好 - 窄表的
value列,混着温度、振动、压力、功率——量纲不同、范围差几个数量级,压缩率明显受损;metric列虽然 SYMBOL 重复压缩不错,但那本来就是宽表里"列名"不需要存的东西
宽表的反向代价是空值密度:某设备没有功率测点,power 列就是一列空值。好在列存对空值友好(空值位图压缩极便宜),只要空值密度不夸张(比如不超过一半),宽表在空间上仍是赢家。
2.4 类型与单位安全
窄表的 value 只能是一种类型(通常 DOUBLE),这带来两个隐患:
- 设备状态这种字符串量(RUNNING/STANDBY/FAULT)没地方放,要么另开一张窄表,要么硬编码成数字——后者丢掉了自解释性
- 没有类型校验:温度测点被人配置成了字符串 "42.1",写入直接报错或者更糟——静默出错
宽表一列一类型:status SYMBOL、temp DOUBLE,约束在 schema 里,错误进不了库。测点类型越杂,宽表这个优势越明显。
2.5 计算的直接性
这条决定日常使用的体感。宽表下,绝大多数分析就是最普通的 SQL:avg(temp)、max(vibRms) \ avg(vibRms)、mavg(power, 60)——任何人都能写。窄表下,每个分析都要先过一次"行转列"的心智转换,写的人累,读的人也要多想一步。
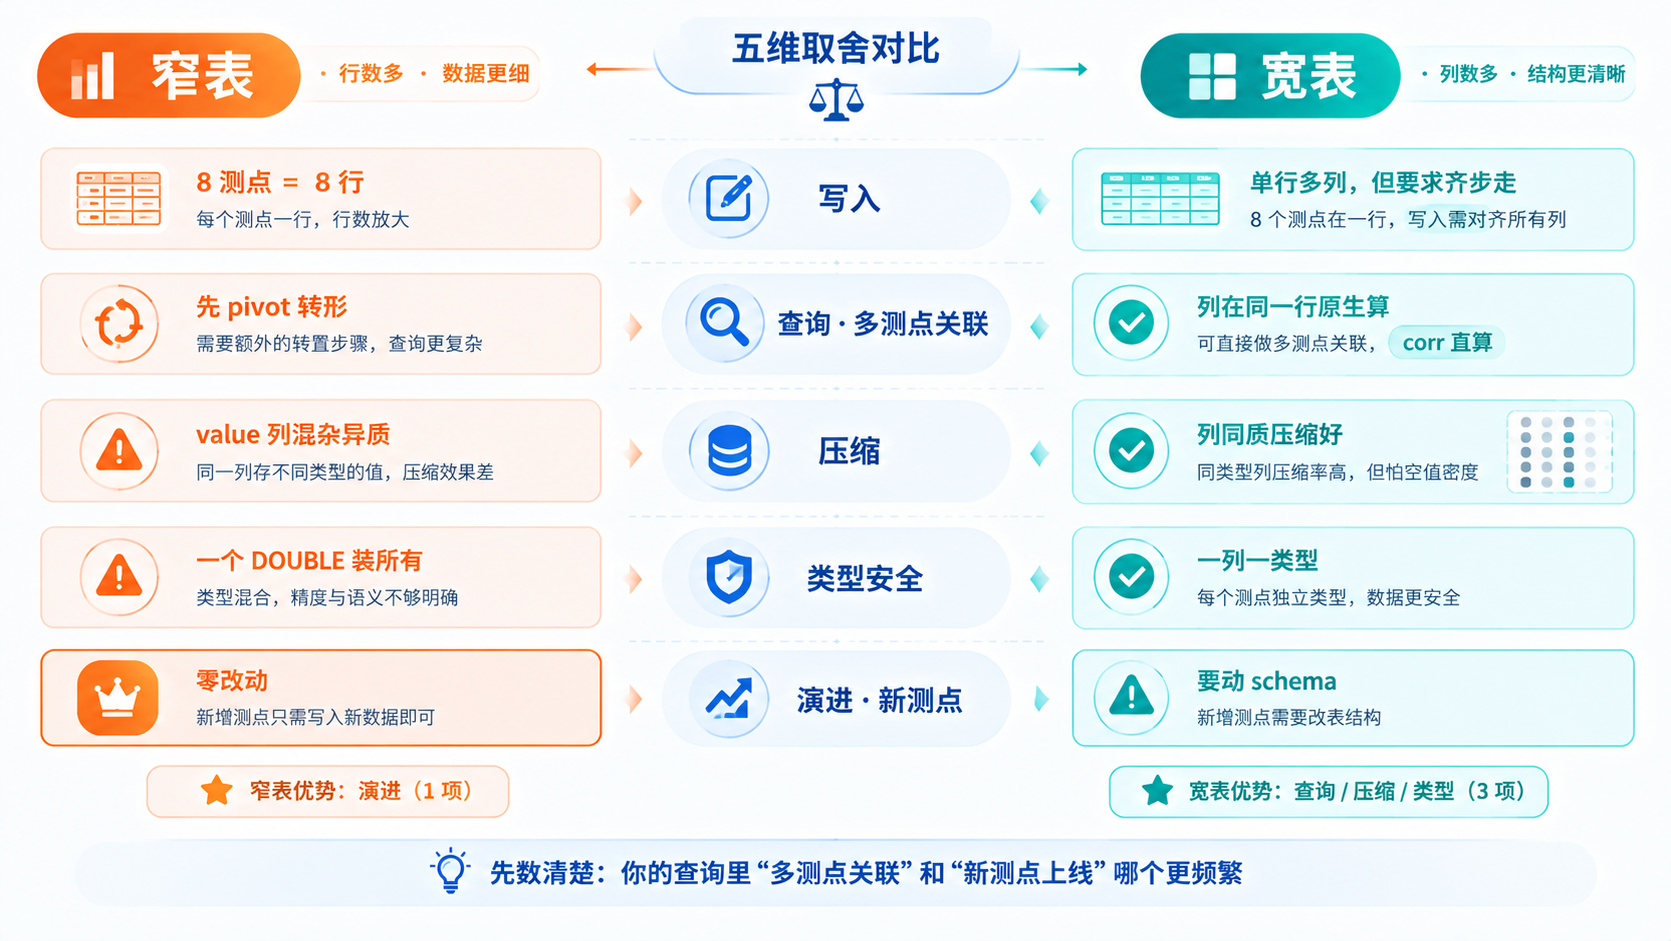
计算的直接性是宽表最容易被低估的优势——它省的不是机器时间,是每个写查询的人的时间。
三、多型号设备的统一 schema
单型号场景宽表基本是默认解。真正的难题从多型号开始:3 个型号、5 家厂商,测点一半重叠一半不同。
3.1 方案 A:每型号一张表
// 泵类一张表
pumpTable = table(1:0, `ts`deviceId`temp`vibRms`sealTemp`bearingTemp, ...)
// 电机类一张表
motorTable = table(1:0, `ts`deviceId`temp`windingTemp`rotorPos, ...)- 优点:每张表干净,类型贴合型号,没有空值浪费
- 缺点:型号一多表爆炸;跨型号的群体查询很难看——"全厂设备的温度分布"要 N 张表 union 起来;新型号上线 = 新表 + 新接入配置 + 新查询适配
适合型号数量少(两三种)、彼此测点差异大、且很少跨型号分析的场景。
3.2 方案 B:全型号超宽表
把所有型号测点的并集做成一张超宽表,型号没有的测点留空。
- 优点:一张表查全厂,跨型号分析最顺
- 缺点:测点并集随型号增长,空值密度爬升;新型号带新测点仍然要加列(DDL 动作);表越宽,"这列是哪个型号的"越难记
适合型号测点重叠度高(比如七成以上公共测点)、型号数量增长可控、以跨型号分析为主的场景。
3.3 方案 C:公共列 + 扩展表分层(工程折中)
实践中用得较多的是分层:公共测点进主表,型号特有测点按组进扩展表。
// 主表:全厂公共测点(所有型号都有)
main = table(1:0,
    `ts`deviceId`temp`vibRms`power`status,
    [DATETIME, SYMBOL, DOUBLE, DOUBLE, DOUBLE, SYMBOL])

// 扩展表:按测点组分表,只存型号特有测点
pumpExt = table(1:0, `ts`deviceId`sealTemp`bearingTemp, ...)    // 泵类特有
motorExt = table(1:0, `ts`deviceId`windingTemp`rotorPos, ...) // 电机类特有- 日常的全厂分析(温度、振动、功率)只碰主表,简单直接
- 型号深度诊断时按需 join 扩展表,或干脆只查扩展表
- 新型号上线:公共测点直入主表,特有测点要么进已有扩展表,要么新增一张——主表 schema 稳定不动
代价是"深度分析要跨表",所以分层的关键判断是:公共测点要覆盖日常 80% 的查询,否则扩展表会天天被 join,分层失去意义。
3.4 怎么选:三个判断依据
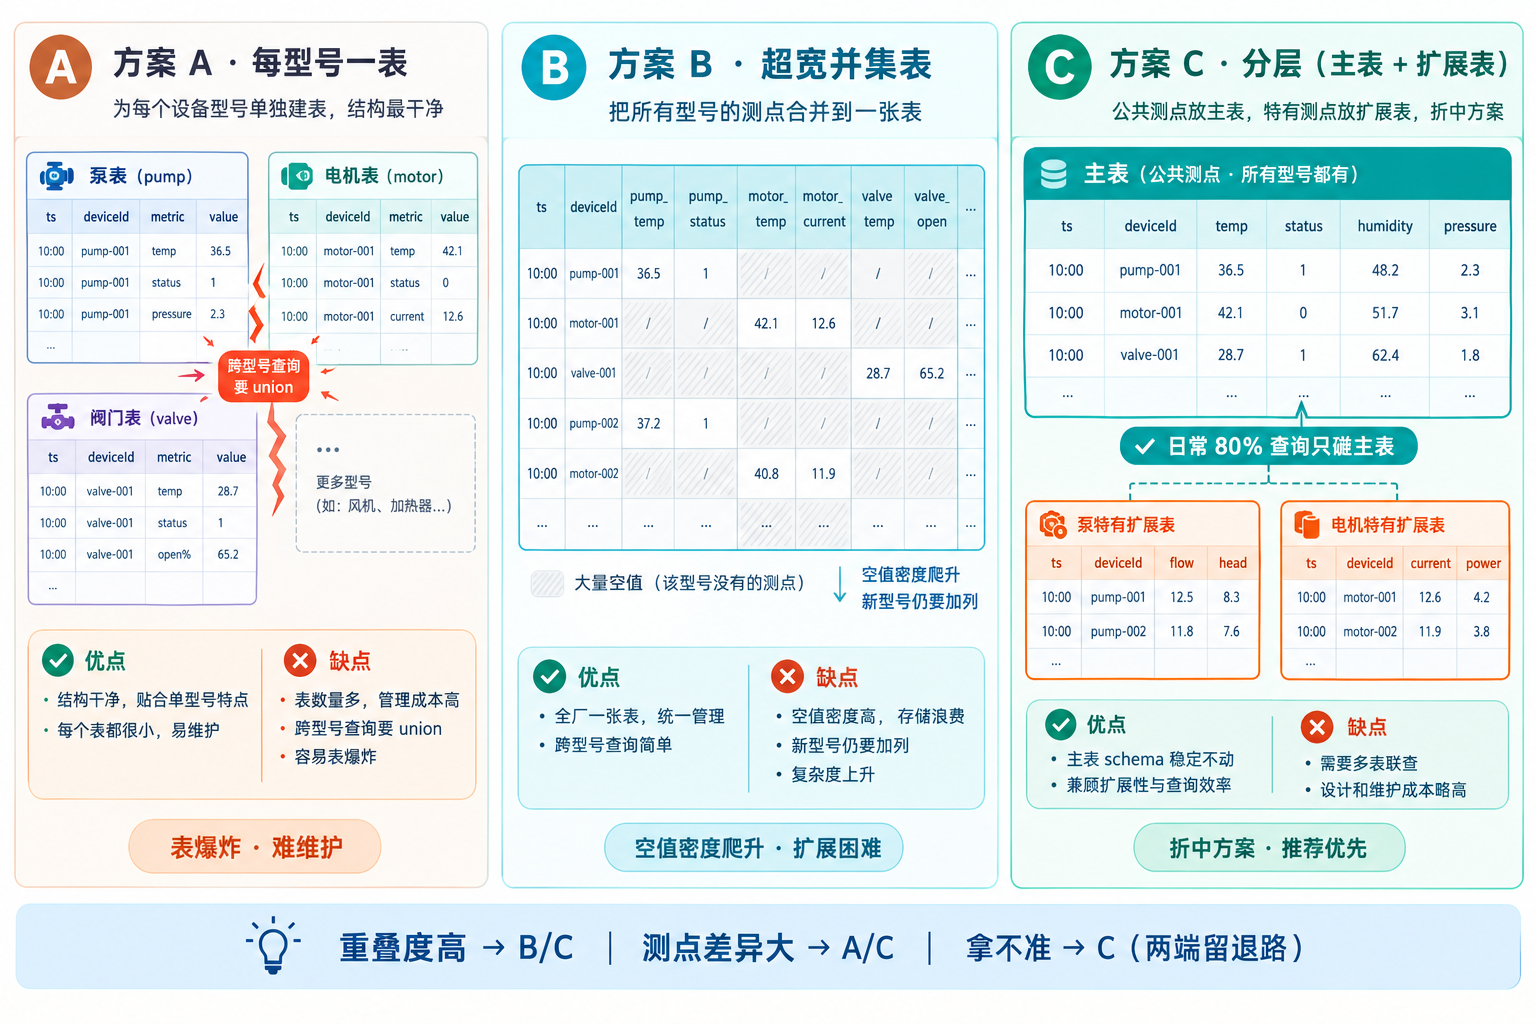
- 测点重叠度:重叠高(>70%)→ B 或 C;重叠低 → A 或 C
- 型号数量与增长:型号持续增长 → C(主表稳如磐石);型号收敛 → A/B 都行
- 查询习惯:以全厂群体分析为主 → 优先 B/C;以单型号深度诊断为主 → A/C
拿不准时选 C——它在两端都留了退路。
四、tag 放哪:内联冗余 vs 维表关联
设备上的业务属性(型号、产线、车间、厂商)——tag——放哪是个高频错题。
错误做法:tag 冗余进时序表。
// 反例:model/line/site 每行重复存储
bad = table(1:0, `ts`deviceId`model`line`site`temp, ...)
三个问题:存储放大(三个字符串列跟一辈子);tag 写死在历史数据里(设备调到另一条产线,历史数据的 line 是改还是不改?);tag 变更要求批量 update 时序表——时序表怕的就是 update。
正确姿势:时序表只存 deviceId,tag 放设备档案维表。
// 时序表:只有 deviceId
// 档案维表:tag 集中管理,设备调线只改这一处
deviceMeta = table(1:0,
    `deviceId`model`line`site`installDate,
    [SYMBOL, SYMBOL, SYMBOL, SYMBOL, DATE])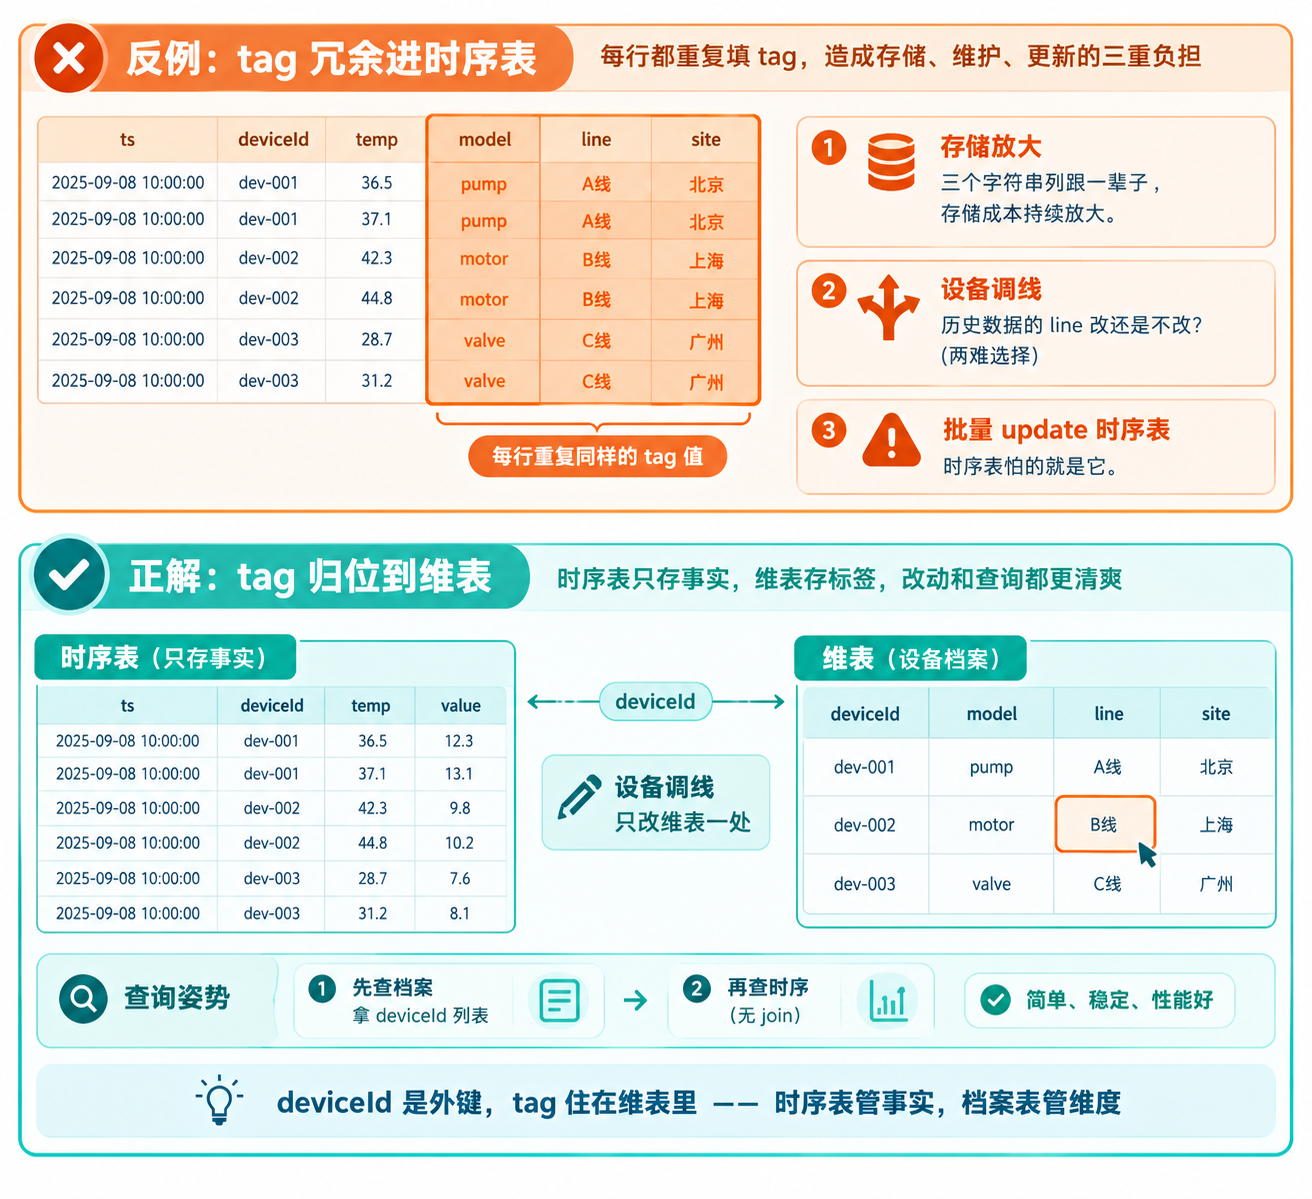
查询时两种用法:
- 先查档案再查时序(常用且高效):先从档案表筛出目标设备的
deviceId列表,再带进时序查询的where in条件——时序表全程无 join - 确实要行级关联时再 join:小结果集上 join,避免大表大 join
一句话:deviceId 是外键,tag 住在维表里。时序表管事实,档案表管维度,各司其职。
顺带一个类型细节:deviceId、metric、status 这类重复度高的字符串列,用 SYMBOL 而不是 STRING——SYMBOL 有内部字典,比较和压缩都更快,这是列存引擎下的免费午餐。
五、schema 演进:加测点与新型号的落地
schema 不是定一次管永久。测点会加,型号会上新,怎么演进才不伤筋动骨?
5.1 宽表加列:可行,但当成运维动作做
分区表加列(addColumn)在技术上是支持的,但要清楚代价:新列对历史分区是空的,历史数据不会自动回填;加列涉及全部分区的元数据变更,大表上要评估执行窗口;下游依赖 select * 的任务会突然多一列,行为可能变。
所以加列的三条纪律:
- 加列前确认这个测点值得进主表(用满第三节的分层判断,能进扩展表就不动主表)
- 选低峰窗口执行,执行后验证下游
- 历史分区的新列就是空——接受"新列从今天开始有数"的语义,别试图回补历史
5.2 结构大改:版本化并存 + 统一视图
测点体系整体升级(比如窄表迁宽表、主表重新分层)时,别在原表上动手术。稳妥路径是新版本表并存,按时间切分流量,查询层统一封装:
// v2 新表上线,新老并存,ts >= 切换点写新表
// 查询封装:内部按切换点路由,外部无感
def queryUnified(startT, endT) {
    cutover = datetime(2026.07.01 00:00:00)
    oldPart = select ts, deviceId, temp, vibRms, double(NULL) as power
               from loadTable("dfs://iot", "wide_v1")
               where ts between startT : min(endT, cutover - 1s)
    newPart = select ts, deviceId, temp, vibRms, power
               from loadTable("dfs://iot", "wide_v2")
               where ts between max(startT, cutover) : endT
    return oldPart.unionAll(newPart)
}要点:老表冻结不删(历史查询和审计还需要),新流量全走 v2,验证一个季度后再考虑老表降级为归档存储。对外只暴露 queryUnified 这样的封装函数,业务查询不感知切换——把"改表"这个运维事故高发动作,变成一次无感的灰度发布。
5.3 接入侧与存储侧解耦:窄进宽出
一个实用的架构招:接入用窄式流表(通用灵活),落盘前转成宽表(高效存储)。
采集网关五花八门,让每个网关都拼宽行很别扭;但让它们往窄式流表吐"测点名 + 值"很容易。落盘环节由流计算引擎做转形:按 deviceId 聚合,把同一周期的测点拼成宽行写入宽表。这样接入的灵活和存储的高效两头都占,代价是中间多一跳转形逻辑——这跳逻辑换来的是:加测点时接入层零改动,只在转形配置里多一个映射。
六、决策清单
把全文的取舍收成一张表,搭新平台时照着走:
场景特征 | 推荐 | 关键动作 |
|---|---|---|
型号单一,测点少而稳定 | 宽表 | 直接建宽表,类型逐列约束 |
测点增减频繁,接入方五花八门 | 窄式接入 + 宽表落盘 | 流表窄式收数,落盘前转形 |
多型号,公共测点为主(>70%) | 全型号宽表 | 控制空值密度,新测点审慎加列 |
多型号,测点差异大 | 公共主表 + 扩展表分层 | 公共列覆盖日常八成查询 |
型号很少且互不相干 | 每型号一表 | 接受跨型号查询要 union |
tag 多且会变 | 维表,时序表只存 deviceId | 先查档案再查时序,避免大 join |
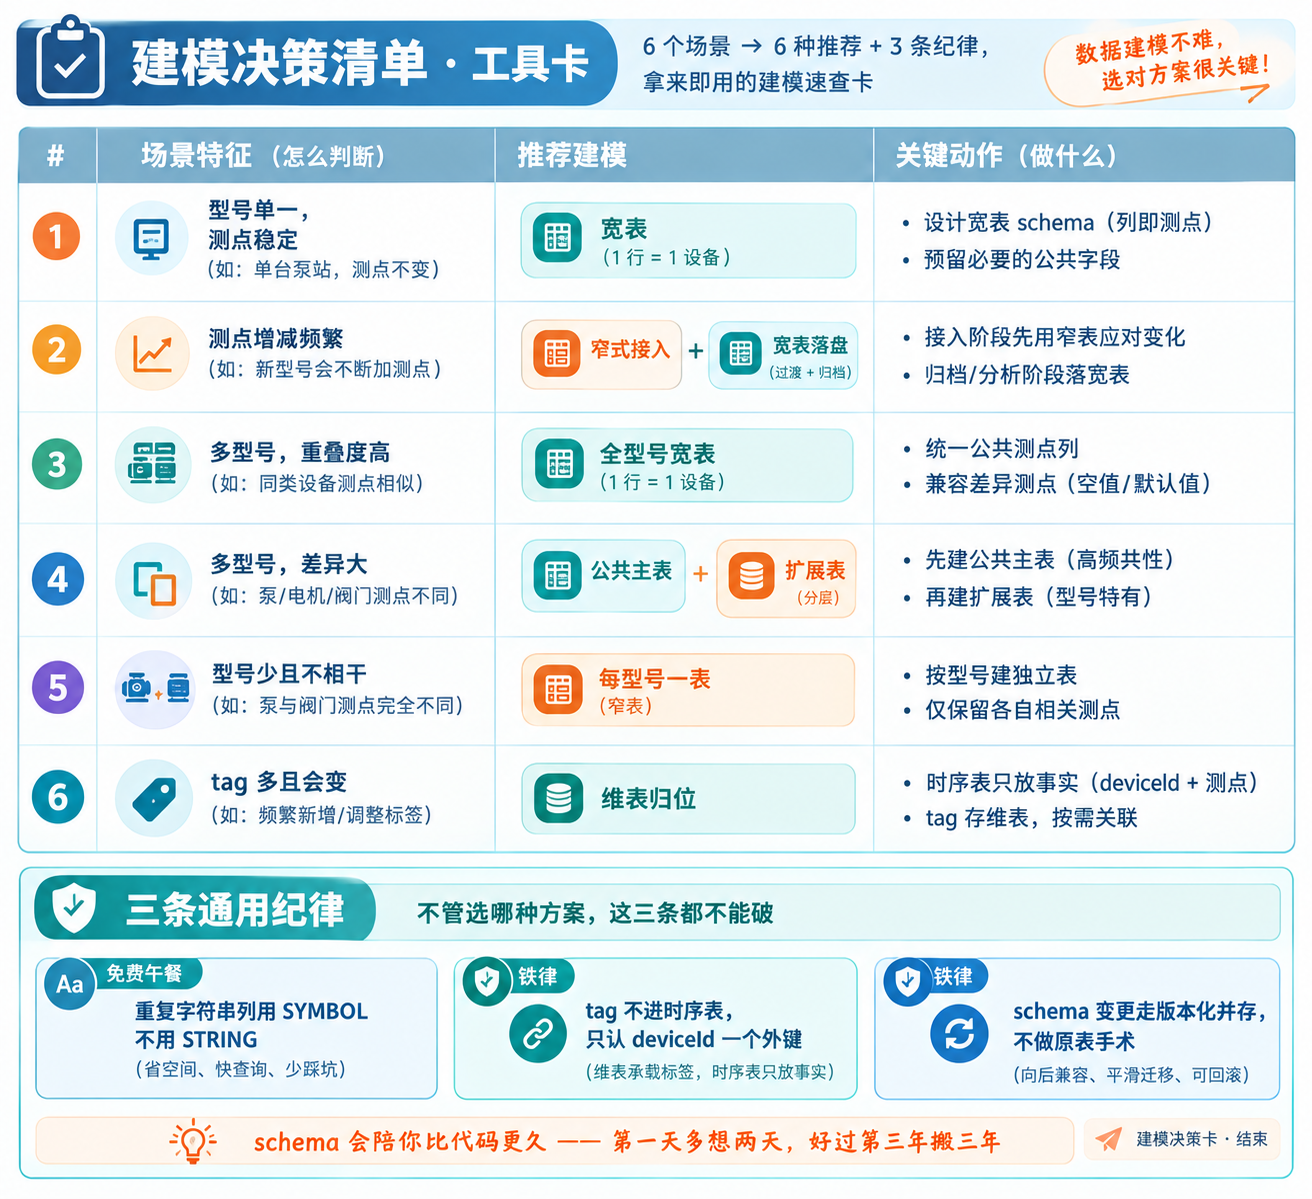
三条通用纪律,不分场景:
- 字符串重复列用
SYMBOL不用STRING - tag 不进时序表,时序表只认 deviceId 一个外键
- schema 变更走版本化并存,不做原表手术
七、写在最后
数据建模没有惊艳的算法,没有调参的乐趣,它是平台的地基工程——没人看见它,直到它出问题。窄表宽表之争、多型号统一、tag 归位、schema 演进,每一件都是第一周的决策,代价却在第三年偿还。
回头看几个核心判断:
- 窄表的灵活付的是存储和查询的税,宽表的高效付的是演进的税——先数清楚你的查询里"多测点关联"和"新测点上线"哪个更频繁
- 多型号统一优先考虑分层(公共主表 + 扩展表),它在"表爆炸"和"超宽空值表"两个极端之间留了退路
- tag 住维表,时序表只认 deviceId——这条几乎没有反例
- 演进靠版本化并存,不靠原表手术——把 DDL 大动作变成灰度发布
最后一句给正在搭平台的人:schema 会陪你比代码更久。代码可以重写,schema 换起来要连历史数据一起搬——第一天多想两天,好过第三年搬三年。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号