省电数字会过期:同一张 5090,九个月,盈亏平衡点挪了 3B
原创
省电数字会过期:同一张 5090,九个月,盈亏平衡点挪了 3B
原创
四王爷
发布于 2026-09-20 17:28:31
发布于 2026-09-20 17:28:31
之前那篇 4090 博客的结论是:决定量化省不省电的不是位宽,是 kernel。这周在 RTX 5090 上的补测把它再推半步——连 kernel 的版本号都算数。
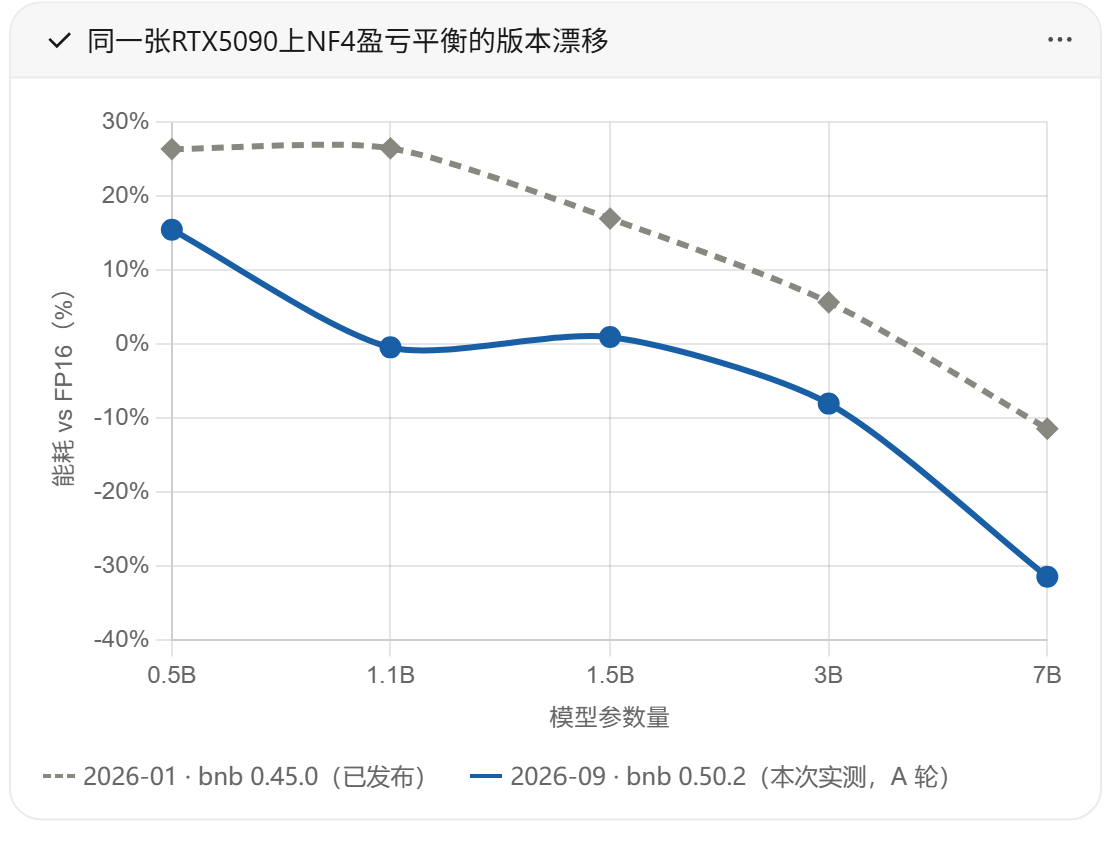
今年 1 月,我们在 RTX 5090 上测 NF4(bitsandbytes 0.45 时代):1.1B 模型的每 token 能耗比 FP16 高 26.5%,盈亏平衡点在 5B 参数开外。九个月后,同一张卡、同一批模型、同一条测量管线,只把 bitsandbytes 升到 0.50.2——1.1B 变成 −0.4%,3B 是 −8.0%,7B 是 −31.4%。盈亏平衡点从 ~5B 挪进了 1.1–1.5B。
也就是说,"4-bit 小模型更费电"这个 1 月还成立的结论,不是 Blackwell 架构的固有属性,而是当时 kernel 的成熟度。一次库更新,把 crossover 推前了 3B 多。
同场另外两块拼图:INT8 依旧全线费电(+55% 到 +256%),困惑度损伤却小到可以忽略——它的问题从来是速度不是精度;FP8 三月的能耗异常在稳定版 torchao 上复现,且两条代码路径朝相反方向劣化:weight-only 惩罚随尺寸升级(7B 高达 +816%,功耗反超 FP16),动态量化路径反而随尺寸缓解(+323% 降到 +83%)。
两次跨重启会话,NF4/INT8 全部 20 条实测,A/B 偏差平均 2.1 个百分点。bitsandbytes 版本与已发布基准不同(0.50.2 ≠ 0.43.3),本文所有跨版本对比均已显式标注。
所以引用节能数字的规矩要再加一条:不写运行时不算数,不写版本号也不算数。省电数字是有保质期的。
数据(25 个配置,全部 direct-NVML 实测):Zenodo 10.5281/zenodo.22855133
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号