算力芯片适配踩坑实录:从驱动到容器透传

算力芯片适配踩坑实录:从驱动到容器透传
小李君与AI
发布于 2026-09-16 21:15:55
发布于 2026-09-16 21:15:55
负责 GPU/NPU/DCU 算力集群部署的运维工程师、基础架构工程师、AI 平台工程师。如果你经常在 NVIDIA、昇腾、海光三家之间切换,这篇能帮你少走弯路。
凌晨两点,机房里一台新到的昇腾 910B 服务器死活装不上驱动。你翻遍了华为文档,发现 x86_64 的包名里居然用的是连字符 x86-64,而 CANN Toolkit 的包名却用的是下划线 x86_64。
等你搞完驱动,又发现 Docker 透传 NPU 还得装一个叫 Ascend Docker Runtime 的东西——跟 NVIDIA 的 Container Toolkit 完全不是一回事。
再换个场景:海光 DCU K100 到货了。你按经验直接套 AMD ROCm 的安装流程,结果 rocminfo 报了个 HSA initialization failed,折腾一晚上才发现海光 DCU 根本不能用 ROCm 公版驱动,得从光合社区下 rock-*.run 包,还得设 HSA_OVERRIDE_GFX_VERSION。
这些问题不是多高深的技术难题,但坑多、分散、且每家厂商文档风格各异。我们做了一个 Skill,把这类适配工作固化成了一套可复用的标准流程。
这个 Skill 是什么
chip-adapter,一个聚焦 GPU(NVIDIA)、NPU(华为昇腾)、DCU(海光)三类算力芯片裸金属适配的智能体 Skill。
Skill 地址:https://skillhub.openanolis.cn/skill/chip-adapter
定位一句话:你告诉它系统版本和芯片型号,它给你一套能直接复制粘贴跑的命令序列。
覆盖范围:
- 驱动全生命周期:选型、安装、调优、卸载、回滚
- 硬件兼容矩阵:十维对照表(CPU 架构到框架版本全覆盖)
- 异构混用风险预判:哪些卡能同机、哪些不能
- Docker/K8s 透传:NVIDIA Container Toolkit + Ascend Docker Runtime 双路支持
- 排障日志一键采集:一条命令打包所有诊断信息
解决什么问题
问题一:三家厂商的驱动安装方式各不相同
NVIDIA 的 runfile 用 --silent --dkms,昇腾用 --full --install-for-all,海光 DCU 用 -A 全自动安装。
参数体系完全不互通,照搬一个厂商的经验去装另一个,必然踩坑。
比如海光 DCU,最常见的错误就是习惯性加 --install 参数——这个参数对 rock-*.run 包根本不存在。
问题二:包名命名规则不统一
华为自己的包名都不统一:
NPU 驱动包:Ascend-hdk-910b-npu-driver_23.0.3_linux-x86-64.run ← 连字符CANN Toolkit:Ascend-cann-toolkit_7.1.RC1_linux-x86_64.run ← 下划线下载时少注意一个字符就 404。
问题三:DCU 不能用 ROCm 公版
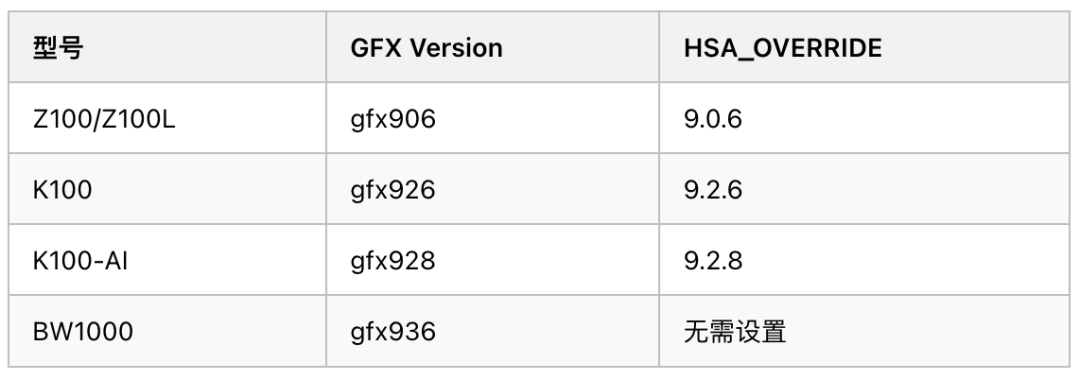
海光 DCU 基于 ROCm 编程模型(HIP),但软件栈是自研的 DTK,路径在 /opt/hygon/dcu/ 而非 /opt/rocm/。
直接装 AMD ROCm 公版驱动,轻则 HSA 初始化失败,重则 invalid device function (98),连最简单的 kernel 都跑不起来。
而且不同型号的 DCU GFX Version 不同,HSA_OVERRIDE_GFX_VERSION 取值也不一样:
问题四:容器透传各家方案独立
NVIDIA 用 Container Toolkit,NPU 用 Ascend Docker Runtime,两者配置完全不同,daemon.json 的 runtime 注册也各写各的。
而且 NVIDIA 在 2023 年底把仓库从 nvidia-docker 迁到了 libnvidia-container,很多老教程还在用废弃的旧地址,装完发现 --gpus all 不生效——因为少了 nvidia-ctk runtime configure 这一步。
问题五:排障信息散落各处
出问题后要查 dmesg、查 journalctl、查 Xid 错误码、查 NPU 固件日志、查 BMC 带外日志。
每次都是手动一条条敲,漏了哪条就得重新来。
如何使用
获取方式
访问 SkillHub 平台获取本 Skill:
https://skillhub.openanolis.cn/skill/chip-adapter
使用方式
在支持 Skill 调用的 AI 助手或开发工具中,直接用自然语言提问即可触发。例如:
- “CentOS 7.9 装 A100 驱动”
- “麒麟 V10 上海光 DCU K100 怎么装”
- “Docker 怎么透传 GPU 给容器”
- “A100 和 910B 能插同一台机器吗”
- “怎么关掉 A100 的 ECC”
- “怎么卸载昇腾 NPU 驱动”
Skill 会先确认四个关键信息:内核版本、操作系统、芯片型号、部署场景。信息齐全后,直接给你一套能跑的分步命令,附带前置检查和故障排查表。
如果你在做 CI/CD 自动化部署,也可以将 Skill 集成到流水线中,作为新节点的驱动适配检查门禁。
输出示例
以 Ubuntu 22.04 + 昇腾 910B 为例,Skill 会给你这样的命令序列:
# 0. 创建 NPU 专用运行用户(不做这步会报 ERR_NO:0x0091)groupadd HwHiAiUseruseradd -g HwHiAiUser -d /home/HwHiAiUser -m HwHiAiUser -s /bin/bash# 1. 安装驱动(注意 x86-64 是连字符)./Ascend-hdk-910b-npu-driver_23.0.3_linux-x86-64.run --full --install-for-all# 2. 安装固件./Ascend-hdk-910b-npu-firmware_7.1.0.5.220.run --full# 3. 安装 CANN(注意 x86_64 是下划线,跟驱动包不一样)./Ascend-cann-toolkit_7.1.RC1_linux-x86_64.run --install --quiet# 4. 环境变量echo 'source /usr/local/Ascend/ascend-toolkit/set_env.sh' >> ~/.bashrc# 5. 验证 + 拓扑检查npu-smi infonpu-smi info -t topo # 看 HCCS 互联拓扑每一步都有注释说明为什么这么干。卸载时也会提醒你顺序反过来:先卸固件再卸驱动。
使用场景案例
案例一:Docker--gpus all报错
现象:容器内执行 nvidia-smi 报 could not select device driver with capabilities gpu
根因:装了 nvidia-container-toolkit 但没执行 runtime 配置。很多老教程缺了这一步。
修复:
sudo nvidia-ctk runtime configure --runtime=dockersudo systemctl restart docker案例二:DCU 装完 rocminfo 无输出
现象:海光 K100 装完驱动后 rocminfo 空 output,但 lspci 能看到设备。
根因:没设 HSA_OVERRIDE_GFX_VERSION,运行时不知道按哪个 GFX 架构编译。
修复:
echo 'export HSA_OVERRIDE_GFX_VERSION=9.2.6' >> ~/.bashrcsource ~/.bashrc案例三:多卡场景的两个高频坑
坑 1:A100 和 910B 混插
驱动层不冲突(nvidia.ko 和 drv.ko 可共存),但 BAR 空间竞争大,Above 4G Decoding 必须开。更关键的是 PyTorch CUDA 版和 CANN 版不能同时加载到同一进程,必须在容器层面隔离。建议还是分节点部署。
坑 2:多卡训练 NCCL 突然报 ibv_open_device
排查逻辑链:先看 GPU 与 IB 网卡拓扑(nvidia-smi topo -m),再看 IB 端口状态(ibstat),最后查 memlock 限制(ulimit -l)——最常见的根因是 memlock 没设 unlimited。
一键采集排障日志
出问题后不用一条条手动敲,Skill 内置了日志采集脚本,关键 5 行:
mkdir -p /tmp/chip_debug && cd /tmp/chip_debuglspci -vvv > lspci_vvv.log; dmesg > dmesg.lognvidia-smi -q > nvidia_smi.log; npu-smi info > npu_smi.log; hy-smi > hy_smi.lognvidia-bug-report.shtar czvf chip_debug_$(date +%Y%m%d).tar.gz *打包发给后端,一条龙。硬件级故障还需通过 iDRAC/iLO 带外管理通道采集 BMC 日志。
最后说两句
做算力适配的工程师大概都有个体会:这活儿技术上不难,但信息太碎。
NVIDIA 的文档是一套体系,华为是另一套,海光又是一套。而且每家都在迭代——NVIDIA 把 Docker 仓库迁了,华为把 device-plugin 合到 mind-cluster 了,海光的驱动模块名从 hydcu 改成了 hycu。
这个 Skill 做的事情就是把碎片化的信息收敛到一处,经过了多轮技术验证(每条命令、每个 URL、每个包名都搜过官方文档确认),减少在文档大海里捞针的时间。
如果你正在踩坑,现在就去试试。下次装机翻出来直接抄。
Skill 地址:https://skillhub.openanolis.cn/skill/chip-adapter
如果用的时候发现哪里跟实际有出入,欢迎反馈,我们持续修正。
适配范围:
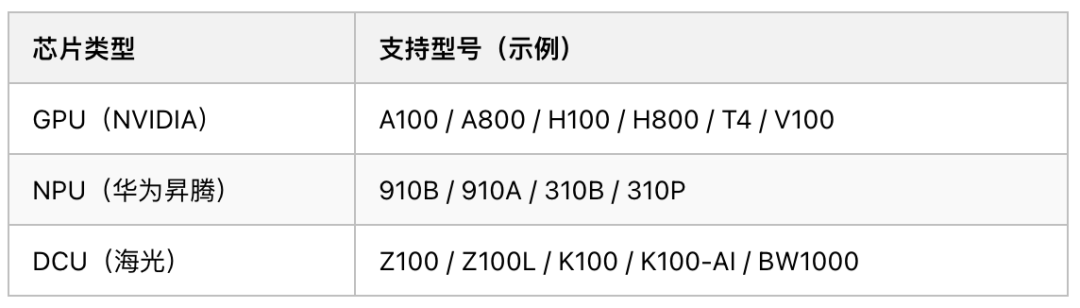
适配操作系统:Ubuntu 20.04/22.04、CentOS 7/8、麒麟 V10、统信 UOS
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-31,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号