CIOE 芯光论坛:万卡超节点时代,海思光电的全栈光互连方案

CIOE 芯光论坛:万卡超节点时代,海思光电的全栈光互连方案
光芯
发布于 2026-09-16 21:13:23
发布于 2026-09-16 21:13:23
两大趋势下的互联瓶颈
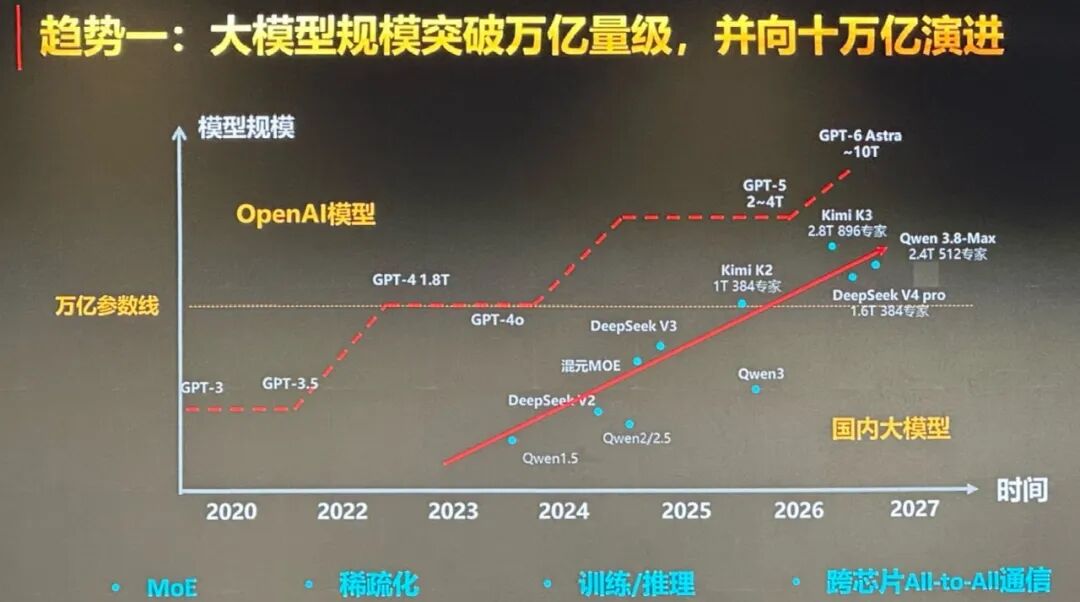
趋势一:模型规模的指数级膨胀
从 2020 年的百亿级参数,到 2024 年 GPT-4o、DeepSeek、通义千问等主流模型集体迈入 1~3.8 万亿参数区间,行业普遍预计 2026-2027 年将冲刺 10 万亿参数大关。MoE 稀疏化、跨芯片 All-to-All 通信成为常态,对互联带宽的需求只增不减。
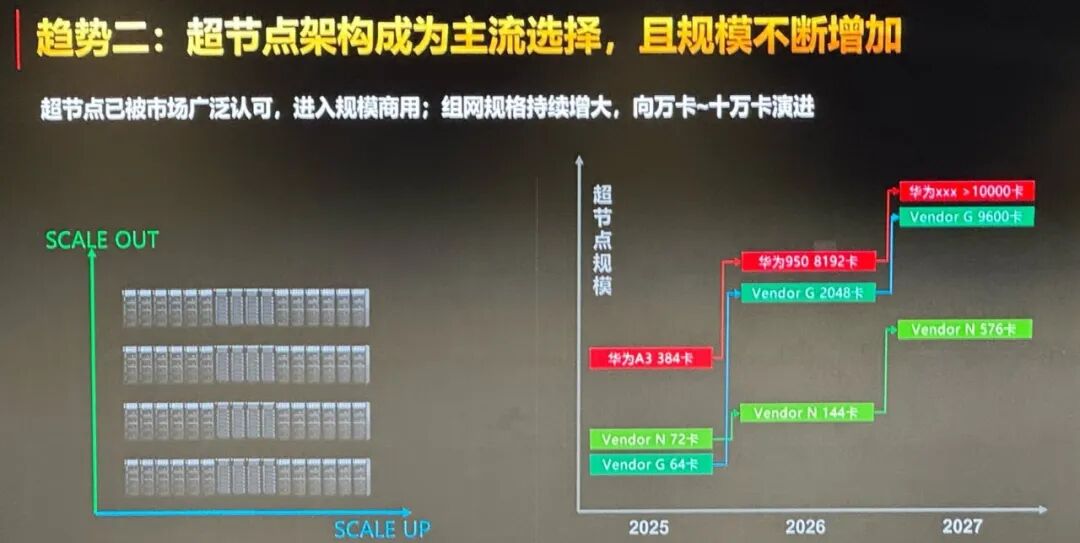
趋势二:超节点架构的规模化落地
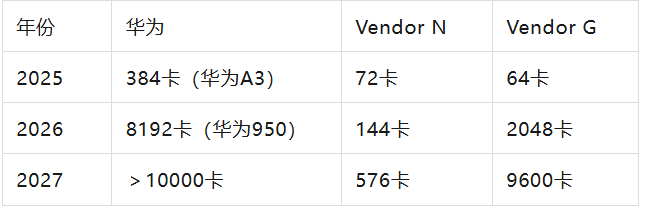
超节点已经成为智算中心的主流架构,同时沿着 “单节点规模升级(Scale Up)” 和 “集群横向扩容(Scale Out)” 双线演进。2025 年主流还是百卡级配置,2026 年将跃升至数千卡,到 2027 年头部厂商将冲击万卡甚至十万卡级集群。
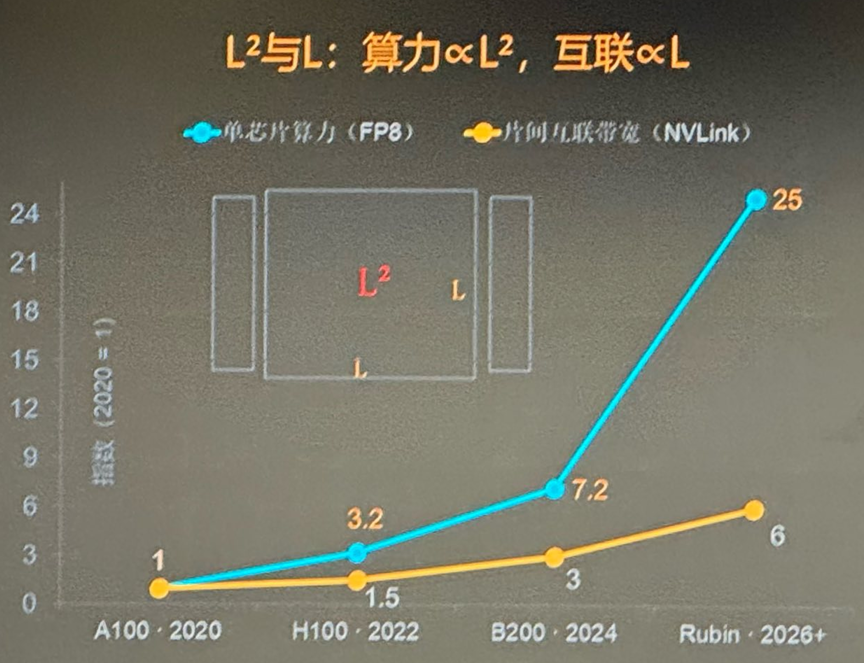
那么问题来了:六年下来,单芯片算力(FP8)从 A100 的 1T 到 H100 的 3.2T,再到 B200 的 7.2T以及到Rubin的25T,单芯片算力翻了25倍,而芯片之间的"公路"并没有同步拓宽(片间互联带宽只增长6倍),算力释放就一定会被连接卡住。这就是业内常说的"算力与互联的增速剪刀差"。
光互联成为“必选项”
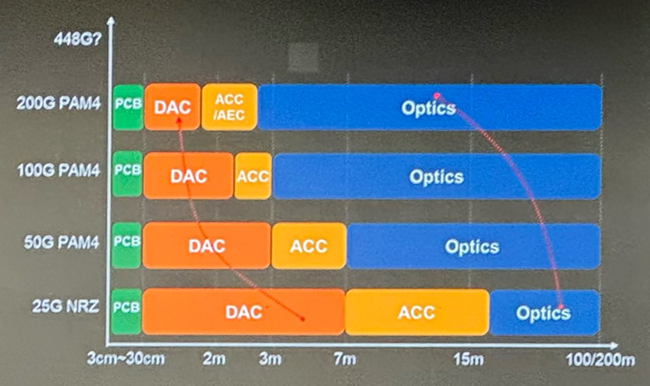
要理解光互联为什么必须上位,先要理解电互联是怎么"撞墙"的。电信号在铜缆和PCB上跑,距离越长、速率越高,损耗和功耗就越失控。25G NRZ信号在PCB上大约能走3厘米到30厘米;到了200G PAM4,电互联的有效传输距离只能支撑数米。也就是说,机柜内部、板卡之间还能靠电扛住,一旦要跨机柜、跨楼层,电互联在功耗、损耗、密度上就全部失灵。
超节点的目标是让成千上万颗芯片协同工作时"像一颗芯片"。要做到这一点,互联必须同时满足三件事:足够远(覆盖机房乃至楼群)、足够密(单位面积带宽够大)、足够省电(不然散热先崩)。这三条电互联都给不出答案。
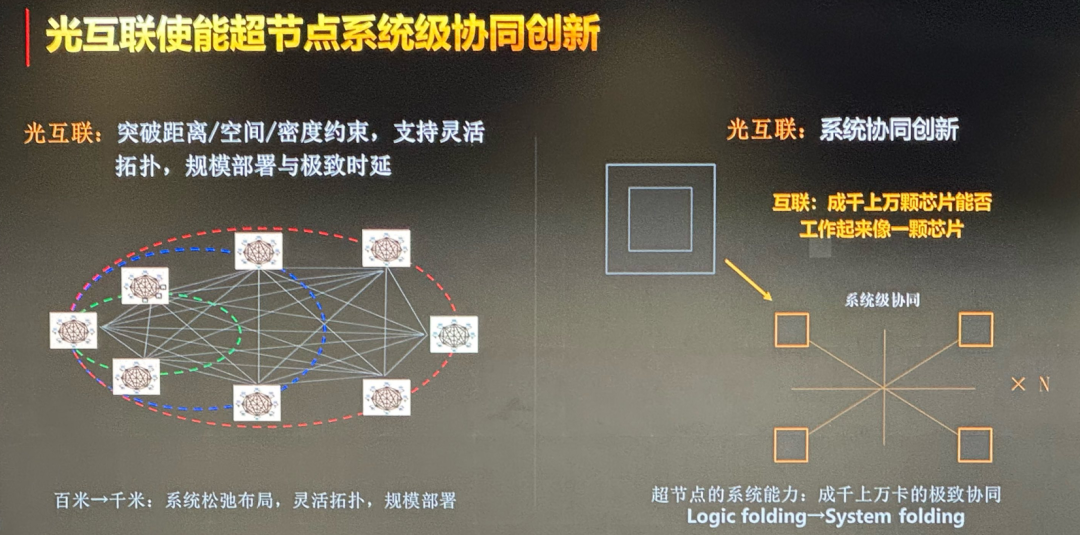
光互联凭借长距离、高带宽、低功耗、低电磁干扰等特性,成为突破互联瓶颈的核心方案,可实现从百米至千米级的传输距离,支撑系统松弛布局与灵活拓扑,实现系统创新协同。它不是"带宽不够用光凑"的补位,而是超节点架构的物理底座。衡量光互联能力,有四大核心指标(FOM):
- 带宽密度(Tbps/mm):指芯片每毫米岸线可输出的带宽。芯片岸线资源有限,带宽密度直接决定互联能力能否随算力持续扩容,是高密度场景的核心指标。
- 比特功耗(pJ/bit):每传输 1 比特数据消耗的能量。决定了狭小封装空间内的热密度上限,是高密集成场景的关键约束。
- 传输距离(m):决定高速互联域的物理边界,支撑跨机柜、跨楼层的灵活组网,直接影响集群部署的灵活性。
- 时延(ns):数据传输的往返时间,决定计算等待与集群同步的效率,是 AI 训练集群的关键性能短板,直接影响 TPOT(每秒万亿次操作)与 TTFT(首 token 时延)。
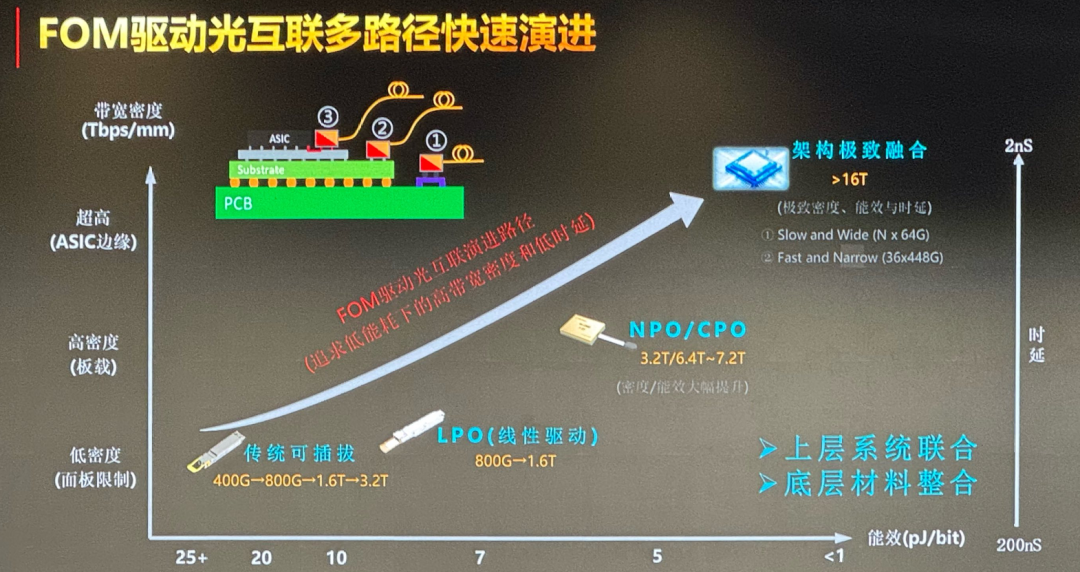
围绕这四个指标,光互联正在沿"高密度、低能效、低时延"的方向演进,并分化两条路线:Fast and Narrow(高速窄通道,代表36×448G方案),冲单通道极致速率;Slow and Wide(低速宽通道,代表N×64G方案),拼低功耗下的高带宽密度和低时延。
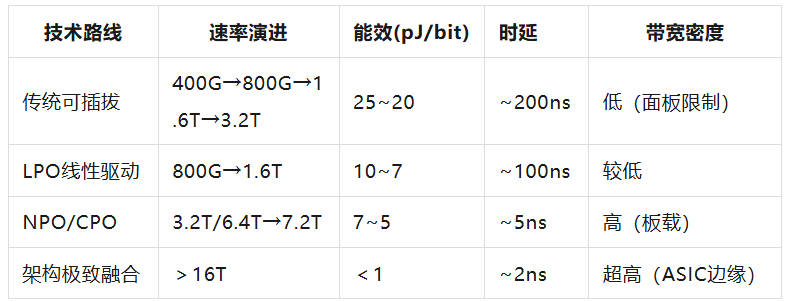
海思光电的全栈技术布局
在CIOE 2026芯光论坛上,华为海思光电高级专家邵海峰分享了海思光电的技术路线。海思的布局是"芯片—器件—模块—系统"一条龙,全面覆盖不同速率、不同场景的光互联需求。
三大材料体系,覆盖全速率场景
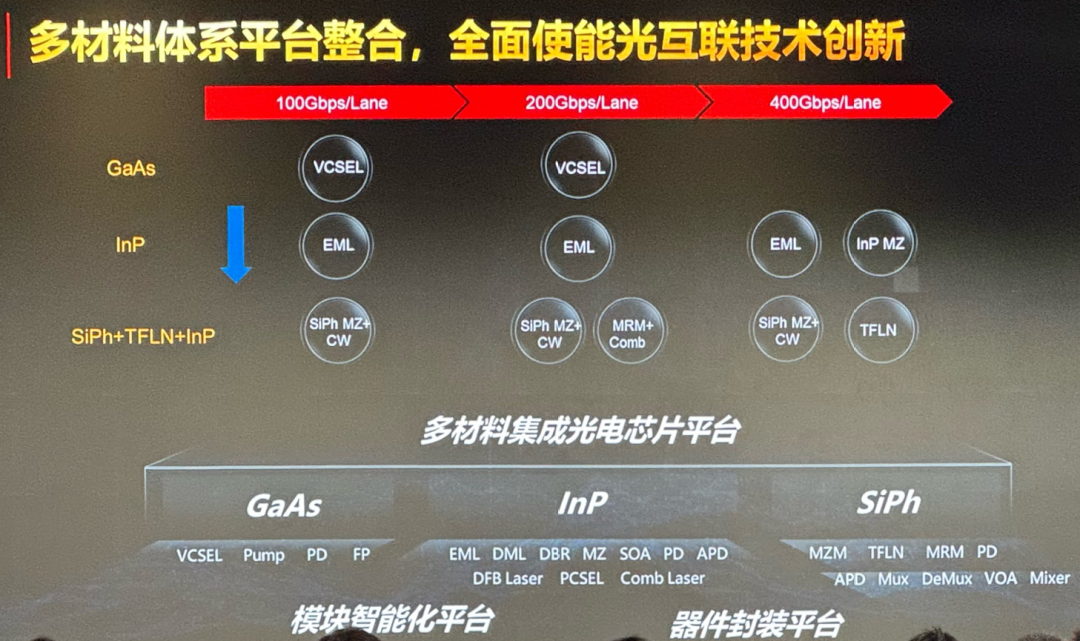
针对不同距离和速率需求,海思布局了三条材料体系:
- GaAs基:主打 VCSEL,单通道速率覆盖100G/200G,用于短距高密度场景;
- InP基:主打EML和MZ,单通道速率覆盖100G/200G/400G,兼顾速率与传输距离;
- SiPh+TFLN+InP混合集成:覆盖 SiPh MZ、MRM、TFLN CW 等技术,支撑高带宽、高集成度光引擎。
系统级方案:华为A3/A5超节点
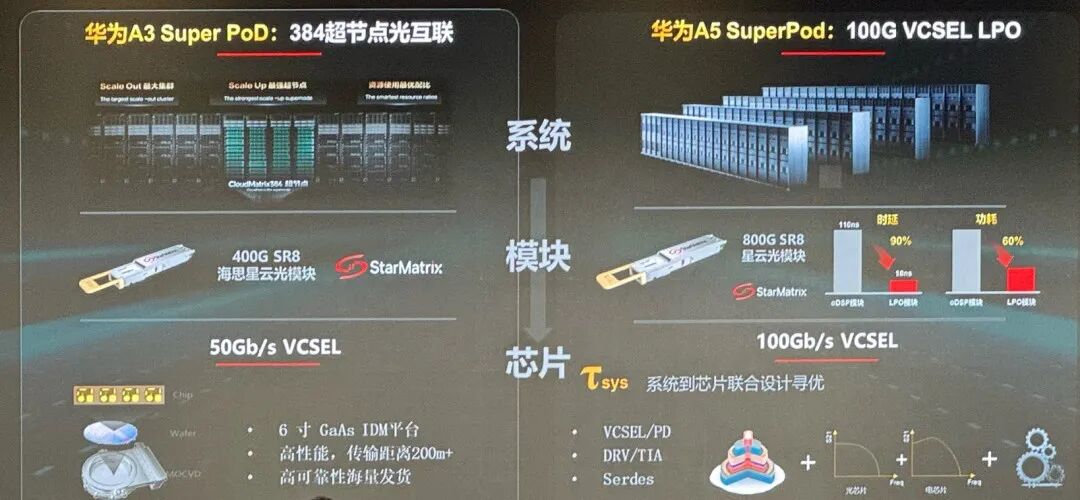
华为A3超节点(384卡):采用海思自研的8*50G VCSEL SR8星云光模块方案;
华为A5超节点:采用8*100G VCSEL LPO SR8星云光模块方案,是业界第一个把多模VCSEL 用于LPO方案。与oDSP方案相比,LPO方案时延降低了90%,功耗节省了60%。
3.2T/7.2T NPO光引擎产品
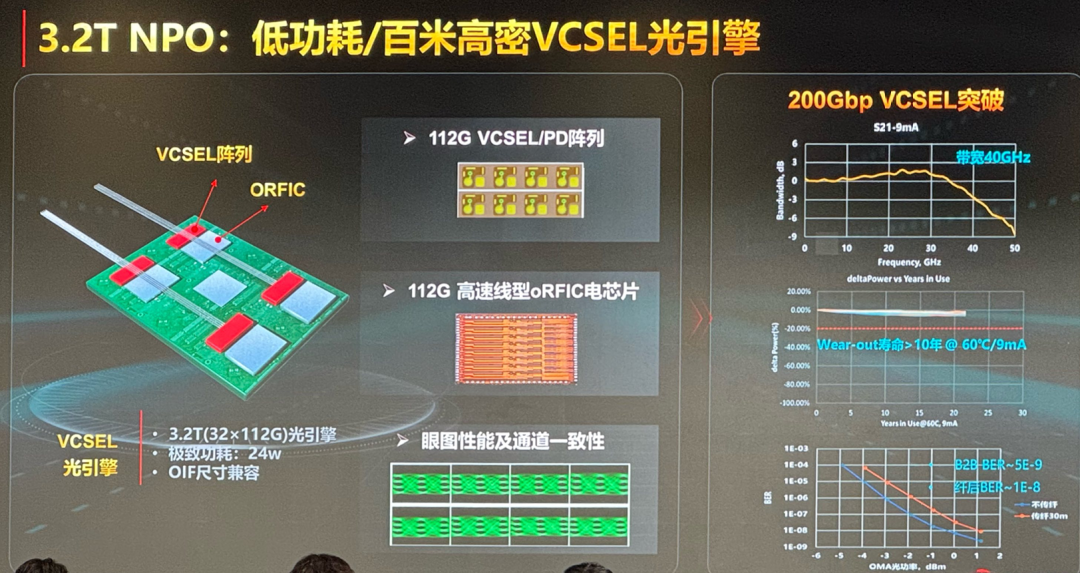
3.2T NPO光引擎:32×112G配置,总带宽 3.2T,整引擎功耗低至 24W,兼容 OIF 标准尺寸,采用自研112G VCSEL/PD 阵列和高速线型 RFIC 电芯片。目前海思200Gbps VCSEL带宽突破40GHz;60℃/9mA 工况下寿命超 10 年;30m传输后误码率约1E-8。
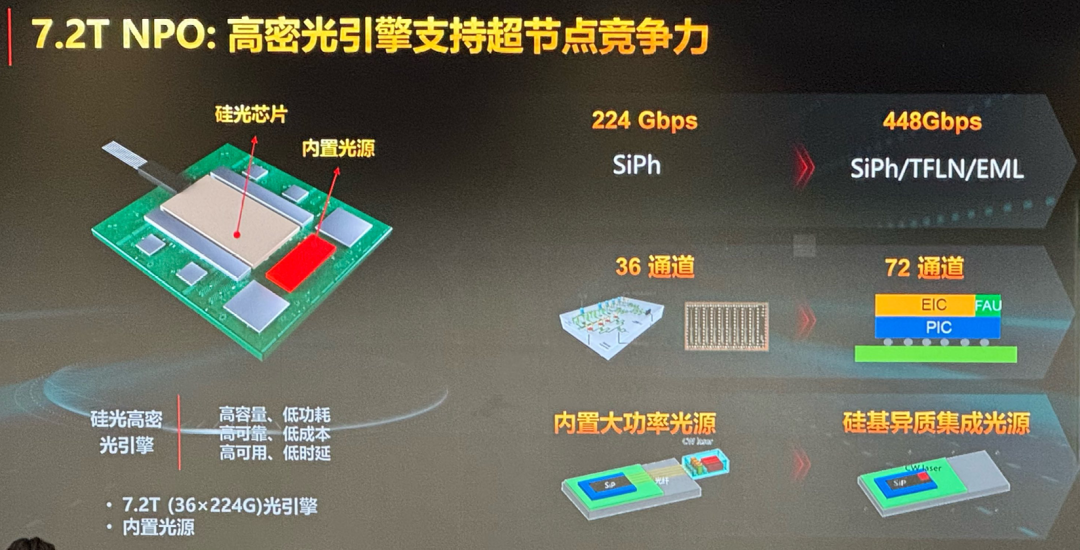
7.2T NPO光引擎:36×224G配置,总带宽达7.2T,采用Hi-ONE内置光源架构——这是海思押注万卡超节点的关键一步,海思内置光源选用InAsGaAs量子阱材料,具有三大优势特性::
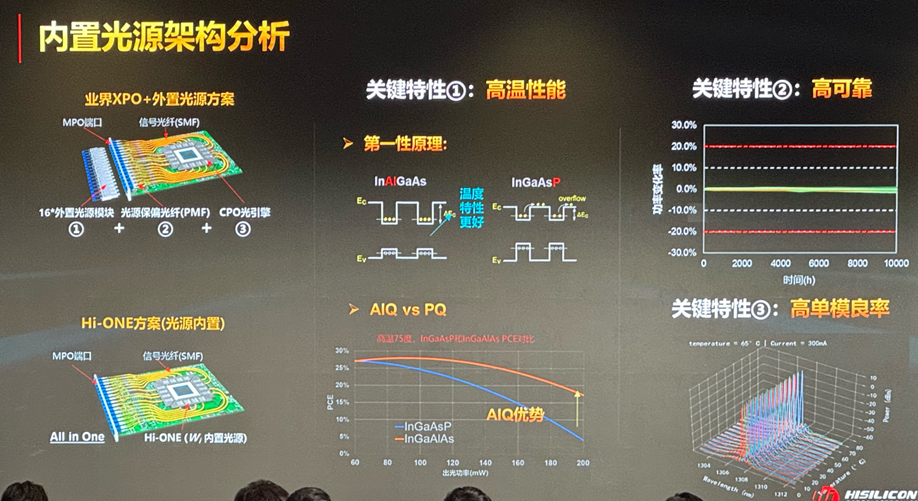
- 高温性能更优:InGaAlAs 材料温度特性优于传统 InGaAsP,高温下功率衰减小;
- 可靠性更高:数千小时长期工作下功率变化率更稳定,海思实测数据:1万个小时的功率变化<±10% ;
- 单模良率更高:75℃高温下 PCE(光电转换效率)对比传统方案有显著优势。
下一代路线:面向16T以上,两条腿走路
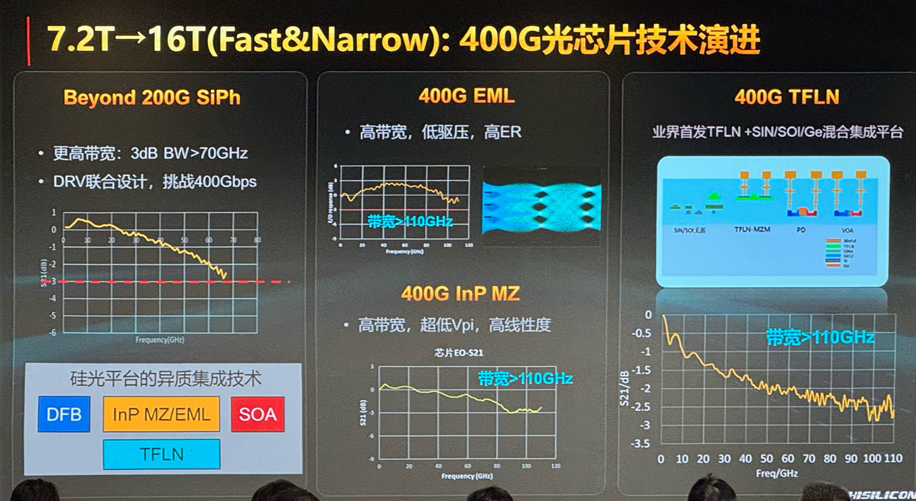
Fast & Narrow路线:攻坚400G 单通道速率,包括400G EML(高带宽、低驱动电压、高消光比)、400G InP MZ(调制带宽突破110GHz)、400G TFLN(业界首发TFLN+SiN/SOI/Ge混合集成平台,具备超低半波电压和高线性度),以及调制器3dB带宽突破70GHz的硅光方案。
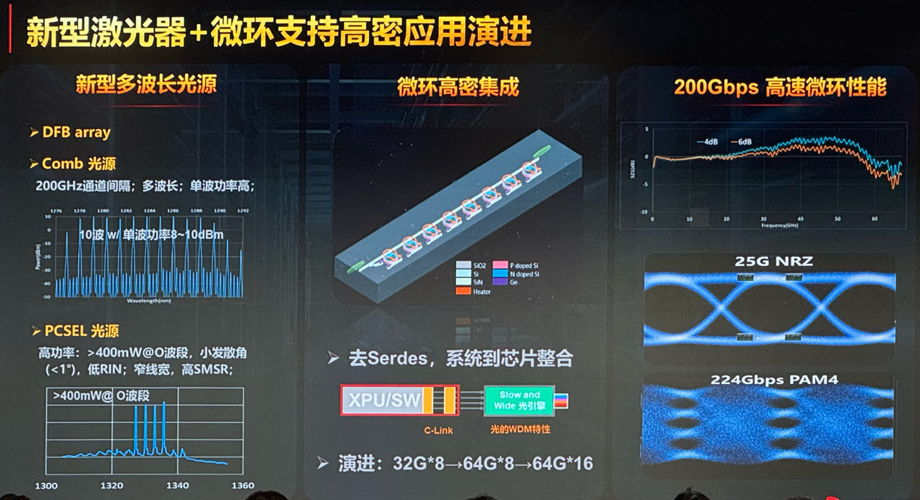
Slow & Wide路线:追求极致能效与密度,核心是高调制效率的MRM微环调制器、新型多波长光源(DFB阵列、Comb梳状光源、PCSEL光源)、微环高密集成、光电合封,以及"去Serdes"的系统到芯片深度整合。其中Comb光源可做到200GHz通道间隔、单波功率8~10dBm;PCSEL光源在O波段输出功率超过400mW,发散角小于1度,具备低RIN、窄线宽特性。
一条路线把单通道速率往极限推,一条路线把单位功耗的带宽密度往极限推——最后谁能跑出来,不取决于实验室指标,而取决于超节点实际部署场景下四个FOM的综合表现。
总结
海思这次分享的价值不只是"又发了几颗芯片",而是给出了一套观察AI光互联演进的判断框架:
第一,看场景:是Scale Up超节点内部,还是Scale Out跨集群?前者更看重密度和时延,后者更看重距离和成本。
第二,看四指标:带宽密度、比特功耗、传输距离、时延,四项是不是均衡优化,而不是单点激进。
第三,看材料-器件-模块是否闭环:光芯片、电芯片、封装、模块是否联合设计,这决定了FOM能不能真正兑现到系统级。
第四,看路线选择:Fast & Narrow还是Slow & Wide,本质是单通道速率博弈还是能效密度博弈,对应不同的集群规模和成本结构。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-15,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号