同一套 AI 模型,凭什么别人用比你强 25%?秘密全在这一步。。。

同一套 AI 模型,凭什么别人用比你强 25%?秘密全在这一步。。。
小机学AI智能体
发布于 2026-09-16 20:41:39
发布于 2026-09-16 20:41:39
同一套AI模型凭什么别人用比你强25%秘密全在这一步封面
最近有个问题困扰了我很久:
我明明用的是同一个 AI 模型,同一份代码,同一个任务。
但身边有些人的产出质量,好像就是比我高一截。
我以为是他们的 Prompt 写得好。
后来发现,不是。
一个实测数据,直接把这件事说透了
评测机构 Endor Labs 做了一个测试。
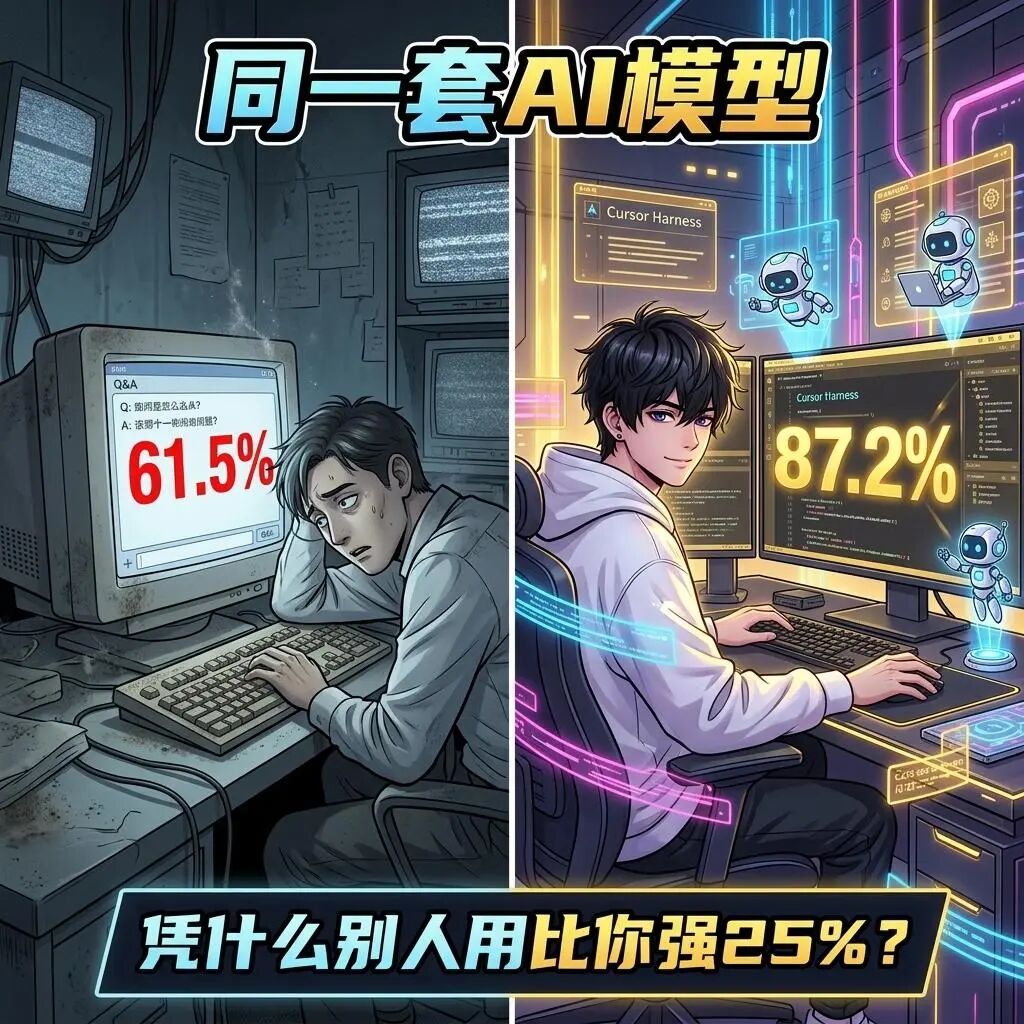
他们拿同一个 GPT-5.5 模型,放进两种不同的"开发框架"里跑,看代码生成的功能正确率。
结果让我盯着屏幕看了好一会儿:
- 原始环境(Codex):61.5%
- Cursor 驾驭框架:87.2%
同一个模型,同一份测试。
差距:25.7 个百分点。
(表情包预留位:《功夫》里那个掉了满地的叉烧包,然后淡定说"哦"的那个眼神)、 的图像结果
这不是小差距,这是在实际生产环境里能不能交付和能不能用的生死分水岭。
然后 Anthropic 的 Opus 4.7,在 Claude Code 框架里跑出了 87.2%,放进 Cursor 框架,直接到了 91.1%。
结论就一句话:
决定你 AI 上限的,不是模型,是框架。
什么叫"驾驭框架(Harness)"?
OpenRouter评测报道:模型在不同驾驭框架下性能差异截图
这个词听起来玄,但用人话说就是:
你给 AI 搭建的工作台有多好,它就能发挥多高。
一个工人拿着最好的工具,放在一片荒地上,他能做什么?
把他放进一个配置完整、分工明确、材料齐备的现代化工厂呢?
两个场景,同一个工人,结果天差地别。
框架就是那个工厂。
具体来说,驾驭框架有三根核心柱子:
第一根柱子:上下文记忆沙箱
普通人用 AI 的姿势是:每次打开一个新对话,然后开始扯淡。
AI 不知道你的项目背景,不知道你用的技术栈,不知道你的代码规范,不知道你上次踩过什么坑。
每次都是从零开始。
那 25% 的差距,有一大半就这么白白损耗掉了。
怎么补?
在项目根目录建一个规则文件:
- Cursor 用户:
.cursorrules - Claude Code 用户:
CLAUDE.md - 通用 AI 工作流:自定义
System Prompt或项目级AGENTS.md
把你的技术栈、代码风格、禁止行为、完成标准全写进去。
这就是你给 AI 准备的"工厂规章制度",它会一直存在,每次对话都携带。
从此之后,AI 知道它在哪里、要干什么、干到什么程度算完。
第二根柱子:验证闭环
这是框架和普通对话最本质的区别。
普通用法:
我问,AI 答,我复制粘贴,发现不对,再去问。
框架用法:
我给任务,AI 执行,AI 自己跑测试,AI 看结果,AI 自己改,直到满足我设的完成标准,然后才把结果交给我。
这两种用法的差距,不在 AI 的智力,在于你有没有给它关上那个验证的闭环。
最简单的验证闭环,就是在你的任务末尾加上这一行:
完成后运行 npm test,确保所有测试用例通过,有 FAIL 自行修复,全绿后再告诉我。就这一行,能把你跟 AI 的来回对话从 10 轮压缩到 2 轮。
我在深圳做全栈开发的时候,把这个逻辑用到了几乎所有的开发任务里。
节省的时间,我用来喝茶、看花、想下一步要做什么。
第三根柱子:任务拆解分工
很多人习惯把一个大任务一次性丢给 AI。
"帮我做一个完整的出海落地页,要有首页、产品介绍、用户案例、定价方案、底部联系……"
AI 会做,但做出来的东西有多少你能直接用?
顶级框架的用法是:
规划(Planner)和执行(Executor)分离。
先让 AI 以"规划者"身份把任务拆解成 N 个子任务,每个子任务有明确的输入、输出、完成标准。
然后再让 AI 按顺序一个个执行,每执行一个,你验收一个。
听起来麻烦?实际上更快。
因为你不再需要在 AI 交出一大堆混乱结果之后,花两倍的时间去 debug 和改方向。
方向对了,执行才有价值。
我把这套逻辑用在了哪里?
我在深圳做的每一个自研项目,都是靠这三根柱子撑起来的。
.cursorrules 是我的"项目宪法"——里面写清楚技术栈、命名规范、禁止修改的核心代码、每次任务的验证命令。
验证闭环是我的"品控线"——让 AI 跑测试,不过不收。
任务拆解是我的"施工图"——每次开工前先让 AI 把任务画成蓝图,再一砖一瓦地建。
一个人,用这套框架,做出了以前需要三四个人才能做完的项目。
不是吹。
这是框架的力量,不是我有多牛。
最后说一句
以后不要再问"GPT-5 和 Claude 哪个好"了。
这个问题的正确问法是:
"我有没有给我的 AI 搭好能让它发挥真实水平的工作台?"
25% 的差距就藏在这里。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-29,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号