Seedance Mini 让我很无奈:同一个提示词,它比 Fast 多加了段戏

Seedance Mini 让我很无奈:同一个提示词,它比 Fast 多加了段戏
用户12724357
发布于 2026-09-15 19:06:06
发布于 2026-09-15 19:06:06
Seedance Mini 让我很无奈:同一个提示词,它比 Fast 多加了段戏
最近在玩豆包的 Seedance 做视频,写了一段很用心的分镜——深夜幽深雾林,绝美古风女子,屏幕内外双手相牵的跨时空邂逅。
结果 Seedance 2.0 Mini 生成出来的视频,那只伸向屏幕的手,愣是轻浮得去挑女子的下巴。我当时的感觉大概就俩字:猥琐。
然后我把同一段提示词喂给了 Seedance 2.0 Fast,它完美按剧情出片,一丝多余的戏都没有。
这段分镜到底写了什么

我写的是一个穿越时空的浪漫分镜:
深夜幽深雾林,朦胧月色柔光,绝美古风女子七分酷似迪丽热巴,身披半透薄纱长裙。屏幕外一只人类手试探触摸屏幕,女子察觉后转头,抬手伸向屏幕——双手相接的瞬间,屏幕荡起涟漪,幽蓝电光缠绕全身,女子破屏而出,完成跨时空邂逅。
结果 Mini 版的输出让我愣了两秒——那只手进去后直接拐弯挑下巴了。我写的浪漫穿越,被它演成了一场尴尬的互动。
下面是原始版提示词截图:
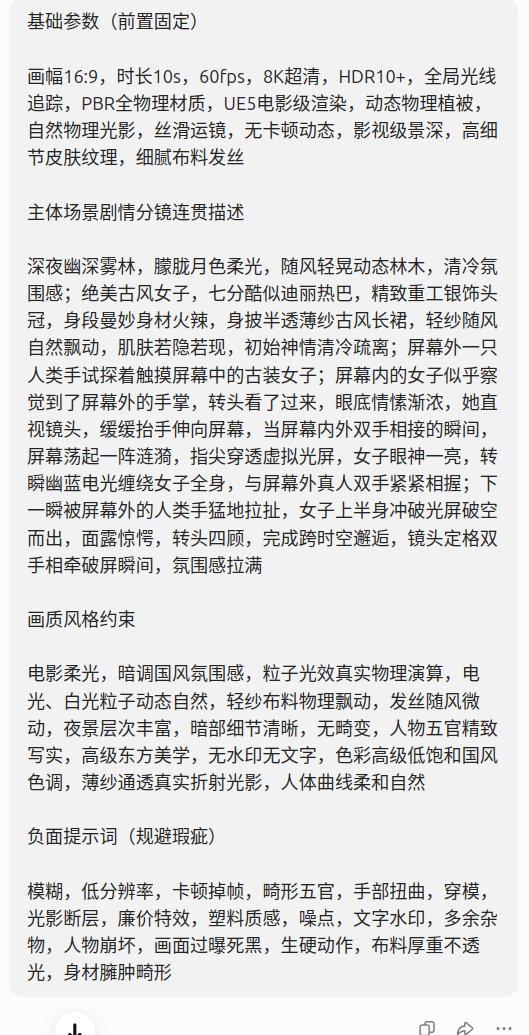
上面的提示词是过不了系统审核的,因为里面"七分酷似迪丽热巴" 这一句里包含有申请版权保护的明星,有些是可以这么写的。
下面是完整提示词,里面绝对没有任何不良倾向提示词,有兴趣的可以拿去豆包里玩玩。
帮我生成一个视频:
基础参数(前置固定)
画幅16:9,时长10s,60fps,8K超清,HDR10+,全局光线追踪,PBR全物理材质,UE5电影级渲染,动态物理植被,自然物理光影,丝滑运镜,无卡顿动态,影视级景深,高细节皮肤纹理,细腻布料发丝
主体场景剧情分镜连贯描述
电视屏幕里,深夜幽深雾林,朦胧月色柔光,随风轻晃动态林木,清冷氛围感;绝美古风女子,精致重工银饰头冠,身段曼妙身材火辣,身披半透薄纱古风长裙,轻纱随风自然飘动,肌肤若隐若现,初始神情清冷疏离;屏幕外一只人类手试探着触摸屏幕中的古装女子;屏幕内的女子似乎察觉到了屏幕外的手掌,转头看了过来,眼底情愫渐浓,她直视镜头,缓缓抬手伸向屏幕,当屏幕内外双手相接的瞬间,屏幕荡起一阵涟漪,指尖穿透虚拟光屏,女子眼神一亮,转瞬幽蓝电光缠绕女子全身,与屏幕外真人双手紧紧相握;下一瞬被屏幕外的人类手猛地拉扯,女子上半身冲破光屏破空而出,面露惊愕,转头四顾,完成跨时空邂逅,镜头定格双手相牵破屏瞬间,氛围感拉满
画质风格约束
电影柔光,暗调国风氛围感,粒子光效真实物理演算,电光、白光粒子动态自然,轻纱布料物理飘动,发丝随风微动,夜景层次丰富,暗部细节清晰,无畸变,人物五官精致写实,高级东方美学,无水印无文字,色彩高级低饱和国风色调,薄纱通透真实折射光影,人体曲线柔和自然
负面提示词(规避瑕疵)
模糊,低分辨率,卡顿掉帧,畸形五官,手部扭曲,穿模,光影断层,廉价特效,塑料质感,噪点,文字水印,多余杂物,人物崩坏,画面过曝死黑,生硬动作,布料厚重不透光,身材臃肿畸形,9:16。
Seedance 2.0 Mini 出片效果

换 Fast 版,正常了
把同一个提示词喂给 Seedance 2.0 Fast,结果大不一样:
手就是手,伸过去就是伸过去,触摸涟漪就是触摸涟漪,女子破屏而出转头四顾——完美复刻了分镜里的每一帧。没有多余的挑下巴,没有莫名其妙的肢体接触。
同一个模型家族、同一个提示词,输出结果天差地别。这让我产生了一连串疑问:Mini 和 Fast 到底是什么关系?是不是字节为了省钱,把 Mini 版做了降智处理?
Fast 版,出片效果
三兄弟到底什么来头
Seedance 2.0 家族现在有三兄弟,发布于不同时间:
老大 Seedance 2.0(标准版),2026年2月发布。全量扩散,支持1080p高清,电影级画质,能处理复杂的多角色交互和精细动作控制。贵,但有贵的道理。
二哥 Seedance 2.0 Fast,同年推出。对标准版做了步数蒸馏,推理速度更快,画质和指令跟随能力接近标准版。适合轻量草稿和快速验证。
三弟 Seedance 2.0 Mini,2026年6月15日刚发布。主打性价比,生成速度是 Fast 的两倍,成本只有标准版的一半。分辨率最高720p,定位是"高产量的走量工具"——电商视频、批量素材、快速测试。
字节官方说 Mini 的运动质量和画面稳定性比 Fast 还好。但在我的实际测试中,Mini 在指令遵循这个维度上,明显比 Fast 弱了一截。
为什么 Mini 会"乱加戏"
这里面有技术层面的原因,不是简单的"降智"。
Fast 本质上是对标准版做了步数蒸馏——它用的是同一套模型参数,只是加速了推理过程,语义理解能力基本保留。所以 Fast 能读懂"不要摸下巴"这种否定式指令。
而 Mini 是全新精简的独立模型,参数规模更小,推理步数更少。它的核心设计目标是"便宜+快",代价就是语义理解精度的下降。
具体来说,当你写"手伸向屏幕"时,Mini 拿到的训练数据里,最常见的"手+古风女子"画面组合就是"挑下巴"——这是大量古风短剧里出现的典型动作。Mini 的轻量化模型没有足够的能力去分析你后面加的否定句,它凭"经验"直接补了个最可能的动作。结果画蛇添足。
所以结论很明确:运动质量 ≠ 指令遵循。Mini 可能在画面流畅度和物理模拟上做得不错(字节官方说的"运动表现超过 Fast"),但在精细的语义把控上,轻量化模型的劣势是结构性的。
所以,该怎么选
一个简单的选择原则:
Mini 适合:简单场景(口播、动物走路、商品展示)、快速批量测试、前期草稿。你不需要精细控制,量大管饱就行。
Fast/标准版适合:复杂分镜、多角色交互、需要精细指令控制的场景。你的视频有明确的剧情逻辑,Mini 的"自由发挥"就是灾难。
一分钱一分货,在 AI 视频模型里依然是硬道理。
这次翻车让我明白了一个道理:AI 视频模型的"便宜版"不是简单的减配,而是本质上的能力取舍。Mini 追求的是速度与价格,代价是语义理解的深度。如果你像我一样写复杂分镜、有精准的动作控制要求,就别省那点钱——用 Fast 或标准版,少很多折腾。
知道不同模型的能力边界,比盲目追求生成速度更重要。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-06-27,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号